CTBench:华为等评估电信运维智能体,揭示大模型“答对答案却无证据”
CTBench: Evaluating Troubleshooting Capabilities of AI Agents in Realistic Telecom Network Operations
在自动化网络运维(NetO&M)领域,大语言模型(LLM)驱动的智能体(Agent)正被寄予厚望。从日常的接口抖动排查、策略漂移检测,到复杂的跨层故障定位与路径恢复,业界普遍期待具备工具调用与多步推理能力的 AI 系统能够大幅降低网络工程师的运维负担。然而,现有的通用智能体评测甚至部分网络专项基准,往往在一个高度理想化的环境中进行测试:全拓扑可见、单厂商设备、标准化的调用接口,以及只关注最终输出是否与标签字符串匹配的评测准则。
ArXiv URL:https://arxiv.org/abs/2608.12002v1
真实电信网络的严苛环境与这种实验室设定存在巨大断层。电信级网络本质上是一个部分可观测、多厂商设备共存、跨层故障级联传播的复杂动态系统。针对这一脱节现状,来自华为技术有限公司与伦敦玛丽女王大学的研究团队提出了专门针对电信网络排障能力的智能体基准评测集 CTBench。
这项包含 234 个由一线电信专家深度构建与验证的任务评测揭示了一个耐人寻味且值得警惕的现实:当前最前沿的智能体组合在简单的端点识别上表现亮眼,但在核心的根因分析(RCA)任务上普遍乏力;更致命的是,哪怕智能体碰巧输出了正确的故障原因或恢复路径,其推理执行轨迹中也往往完全缺乏专家级的关键排障证据。这种“蒙对答案却没有证据支撑”的现象,直接击中了严苛电信生产环境中最为敏感的可靠性红线。
电信运维不是问答题,而是一场多步假设检验
要理解传统评估方法的局限,必须先拆解一名资深网络工程师在排查故障时的真实认知过程。面对突发的业务降级,工程师拿到的初始信息往往只是泛化的告警或模糊的现象描述,而非结构化的全局视图。
工程师必须首先在脑海中建立拓扑与协议层面的故障假设,进而向特定网络节点下发合规的排障命令,随后解析杂乱的多厂商命令行回显(CLI Output)。在这个过程中,他们需要剔除下行级联引起的伴生告警,锁定未被直接暴露的潜在根因,最终给出具备因果链条的诊断结论与业务路径修复策略。这是一个典型的序列交互与非完全信息博弈过程。
以往的大模型评估体系在此类场景中暴露出三大致命盲区。
其一是完全可观测性假设。不少基准预先将所有路由表项、配置上下文和遥测数据塞入模型的 Prompt 中,跳过了工程师最耗费精力的“主动勘测与证据采集”环节。
其二是忽视多厂商与设备异构性。现网环境充斥着华为、思科、瞻博等多家设备商以及路由器、交换机、防火墙、安全网关等不同设备类型,各自的命令行语法、状态码和告警语义差异极大,通用模型很难无缝适配。
其三是仅依赖结果导向的评测指标。在通信运维场景下,不可解释的“正确结果”与错误结果一样危险。如果一个智能体给出了正确的故障端口,但其交互轨迹显示它从未查询过该端口的物理状态或链路层协议报文,那么该诊断在工程实践中便毫无采信价值,盲目执行甚至可能引发次生业务震荡。
针对这些痛点,CTBench 确立了以“证据落地”(Evidence-Grounded)为核心的评估哲学,致力于评测智能体是否真正表现得像一名合格的电信排障专家。
CTBench 的任务建模与专家级严苛构建
为了还原高保真的工业级挑战,CTBench 将网络运维提炼为两类核心运维任务家族:根因分析(Root Cause Analysis, RCA)与路径还原(Path Restoration)。
在交互形式上,评测环境被建模为一个交互式沙箱 $\mathcal{E}\tau$。给定任务指令 $q\tau$($\tau \in {\mathrm{RCA}, \mathrm{Path}}$),智能体 $\pi_\theta$ 根据历史动作与观测记录 $h_{t-1}$,自主决定下一步执行动作 $a_t$,例如执行一条受限的设备巡检命令或查询特定的遥测指标。沙箱环境返回对应的实时回显 $o_t$,包含配置参数、接口状态、路由策略条目或命令报错信息。整个交互形成完整的决策轨迹 $\mathcal{T}(q_\tau) = (q_\tau, a_1, o_1, \dots, a_T, o_T)$,模型需在此基础上解码出最终答案 $\hat{y}_\tau$。
两类任务在输出标准上均遵循极其严格的工业规范:
对于 RCA 根因分析任务,智能体最终输出的目标不是一段自由文本,而是一个标准化的根因三元组集合:
\[y_{\mathrm{RCA}}^* = \{(n_i, o_i, c_i)\}_{i=1}^m\]其中 $n_i$ 代表受影响的网络节点,$o_i$ 代表具体的故障对象(如特定物理接口、BGP 路由实例、ACL 规则、NAT 转换策略或 VPN 实例),$c_i$ 则是标准化的故障类型标签。
对于路径还原任务,智能体必须从零散的转发表项与连接关系中,重建从源端到宿端的完整转发路径元素序列:
\[y_{\mathrm{Path}}^* = \{p_1, p_2, \dots, p_k\}\]支撑这套基准的数据集并非通过自动化合成,而是经历了高度密集的人工专家深度介入。研究团队邀请了 15 位平均从业年限长达 20 年的资深电信技术专家,从现网沉淀的海量真实故障案例中进行脱敏、抽象与复现,最终固化为 234 个高价值任务(包含 126 个 RCA 任务与 108 个路径还原任务)。
更为关键的是,研究团队引入了独立的第三方专家进行双盲验证。验证专家在不可见标准答案与故障设定的情况下,自主进行命令行交互排障。数据显示,人类资深专家在路径还原任务上的准确率达到 $92.6\%$,在 RCA 任务上的准确率为 $56.4\%$,完成单个任务的耗时通常在 40 到 60 分钟之间。这一人类 baseline 的确立,不仅从物理层面证明了任务设计的逻辑自洽与可解性,也为衡量大模型的排障段位提供了参照锚点。
不止看答案:证据链追踪与多维元数据建模
CTBench 区别于以往评测基准的最显著特征,在于其引入了黄金证据步(Golden Evidence Steps)机制与全维度的难度元数据体系。
每个任务在构建时,专家均梳理出解决该问题必不可少的关键排障动作集合:
\[\mathcal{A}^*(q_\tau) = \{a_1^*, a_2^*, \dots, a_{T^*}^*\}\]对于 RCA 任务,黄金动作明确定义了定位并论证根因所需的关键状态检查;对于路径还原,黄金动作则覆盖端点可达性验证、跳步邻接关系检查、路由选路判定以及隧道状态验证。
在自动评估流程中,系统不仅比对最终答案集合与真实标签的交并比(IoU),更会通过 F1 分数严格检验智能体的动作轨迹 $\hat{\mathcal{A}}$ 是否命中了这些黄金证据步。只有当智能体在正确的设备上执行了正确的探测命令并获得了对应回显,该步骤才被认定为有效覆盖。
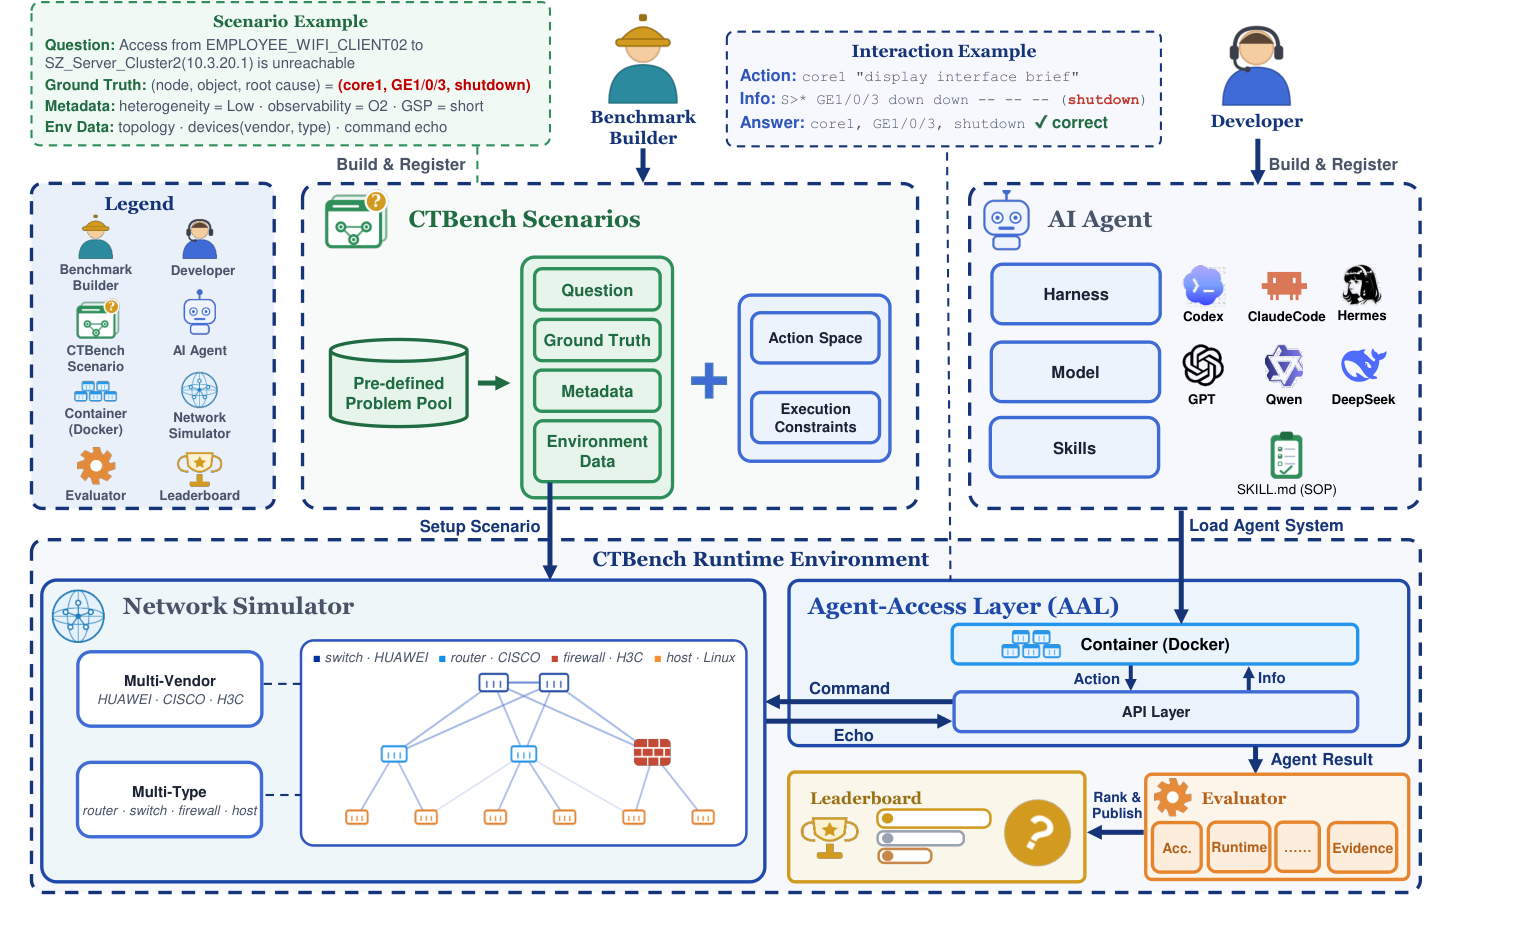
为了精准解构智能体在不同运维边界下的能力短板,CTBench 为每个任务打上了高度结构化的元数据标签:
-
证据可观测性(Observability, $O_1$ 与 $O_2$):区分故障证据是否能通过直接诊断命令一步获取($O_1$),抑或必须通过多跳节点间接观测综合推演($O_2$)。
-
根因类别划分(C1 至 C5):将电信故障拆解为硬件/物理层故障、接口与链路层故障、路由与交换控制面故障、安全与业务策略故障、以及网络服务管理配置故障。
-
因果与结构复杂度:量化多根因数量 $N_r$、故障传播链长度 $N_c$、多路径分支数 $N_{\rm path}$,以及涵盖控制面、转发面、冗余容灾协议交织的协议复杂度 $N_p$。
-
网络异构度($h_L$):统计场景中跨越的不同设备厂商数 $N_v$ 与设备类型数 $N_d$。
这套元数据将单一的正确率指标,拆解为透视智能体在复杂网络拓扑中认知机理的透镜。
实验评测:大模型在电信排障中的能力真相
研究团队选取了业内顶尖的五组智能体骨架(Agent Harness)与基座模型组合开展了全面评测,涵盖 Codex+GPT-5.5、ClaudeCode+Qwen3.7-Plus、以及结合专业电信微调与通用推理模型的 HermesAgent 方案(搭配 DeepSeek-V4-Pro、Qwen3.7-Max 与 TelecomGPT-R1)。所有模型均在相同受控沙箱中执行盲测,评估结果揭示了诸多违反直觉的现象。
在宏观能力表现上,所有被测智能体在路径还原任务上的适应性均显著优于根因分析任务。以综合表现最强的 Codex+GPT-5.5 为例,其在路径定位(Path-Loc)指标上取得了极高分数,能够敏锐捕捉到端到端的源宿两端。然而在根因分析任务中,模型遭遇了全面阻击。
一个普遍存在的认知鸿沟是:智能体在识别故障类型(RCA-ID)上的表现,普遍远好于定位具体受损对象(RCA-Loc)。例如,Codex+GPT-5.5 的根因类别识别准确率达到 $66.83\%$,但具体到定位“哪台设备的哪个接口或哪条路由策略”时,分数直接滑落至 $52.9\%$;HermesAgent+Qwen3.7-Max 的表现更为悬殊,类型识别达到 $52.38\%$,而对象级定位暴跌至 $37.59\%$。模型似乎具备通过全局上下文“猜出”大致发生了路由震荡或策略丢包的语意感知,但当需要结合拓扑精确指认具体物理实体时,模型便失去了方向感。
更为严峻的发现来自证据链的断裂。评测显示,高任务成功率与高质量排障证据之间并不存在绝对关联。在路径还原任务中,Codex+GPT-5.5 虽然取得了最高的综合还原率,但其路径证据采集得分(Path-Evidence)仅有 $47.84\%$。HermesAgent 与 DeepSeek-V4-Pro 的组合虽然展现出优异的端点锁定能力,但其路径还原的宏观 IoU 与关键证据重合度却明显脱节。
这意味着,现阶段的智能体往往在仅收集了零散甚至片面信息的情况下,便仓促跳向结论,借助强大的上下文联想能力“脑补”出了答案。在工业运维中,这种跳跃式诊断缺乏确凿的依据链,一旦推行自动化下发,极易因误诊导致大面积网络中断。
而在细分故障类别(C1 至 C5)的雷达图分析中,各模型的性能分布呈现出极其剧烈的非均匀塌陷。所有智能体在 C2(路由与控制面基础故障)上均取得了相对稳定的诊断效果,这是由于公开语料中存在大量关于 OSPF、BGP 配置与路由收敛的通用知识。
但在面对 C1(物理层与接口状态故障)时,所有模型的准确率均发生断崖式暴跌,普遍徘徊在 $0.00\%$ 至 $10.71\%$ 的极低区间。这反映出 LLM 在处理诸如接口物理衰减、双工错配、CRC 校验错包累积等与底层硬件遥测紧密相关的状态时,存在严重的语义盲区。此外,除 Codex+GPT-5.5 外,其余模型在面对 C3(安全策略与访问控制)任务时准确率全线挂零,表明现网 ACL 过滤规则与安全策略的高阶因果推演对开源模型仍然是极难逾越的鸿沟。
成本陷阱与环境扰动的双重考验
在评测中,研究团队还记录了智能体的交互轮数、执行延迟以及输入输出的 Token 消耗,从而评估智能体的运维经济性。数据表明,巨大的计算开销并不能线性兑现为更强的排障能力。
以 ClaudeCode+Qwen3.7-Plus 为例,该组合在交互中消耗了极其庞大的交互轮数和上下文 Token,但最终取得的定位精度与任务完成度,反而明显逊色于交互更为克制的 Codex+GPT-5.5。更进一步的对比显示,HermesAgent+Qwen3.7-Max 在部分路径任务上的表现略优于 HermesAgent+DeepSeek-V4-Pro,但付出的代价是翻倍的延迟与 Token 成本。在讲求秒级响应与低开销的现网监控场景中,这种缺乏终止控制的“盲目翻查”无疑是不可接受的。
为了探究底层环境特征对智能体认知机理的扰动,研究对任务元数据与表现衰减进行了归因分析。
在部分可观测性(Partial Observability)的考验下,智能体展现出明显的认知失调。以 ClaudeCode+Qwen3.7-Plus 的测试数据为例:当任务从完全可观测($O_1$)切换至必须间接推演的部分可观测($O_2$)状态时,任务准确率从 $20.56\%$ 降至 $15.79\%$,对象级定位能力腰斩($37.02\%$ 降至 $17.14\%$),根因识别率更从 $42.92\%$ 跌至 $16.22\%$。
耐人寻味的是,在此过程中,该智能体的证据覆盖率(Evidence Coverage)不仅没有下降,反而从 $38.29\%$ 反常上升至 $62.20\%$。这一背离现象揭示出当前 Agent 的典型困境:面对隐藏在深处的故障点,模型为了维持反思推理,开始大量、盲目地下发各种间接查询命令,抓取了大量不相干的观测信息(导致证据集覆盖数字表面上升),但其内在的认知中枢完全丧失了从这些杂乱、稀疏的间接信号中提炼因果脉络的能力,最终导致诊断准确率的全面崩盘。
在网络异构性(Heterogeneity)方面,冲击同样显著。当拓扑环境从单厂商、单类型设备(低异构度)跃迁至多厂商互联、多种专用网元混合部署(高异构度)时,该智能体的路径还原准确率直接从 $29.31\%$ 坠落至 $4.00\%$,路径重构 IoU 从 $68.58\%$ 骤降至 $35.05\%$。当不同的 CLI 交互规范、各异的命令回显格式与割裂的配置逻辑混合交织在一起时,通用大模型的上下文对齐机制迅速过载,跨节点、跨厂商的因果状态追踪彻底中断。
迈向真正可信的网络运维智能体
CTBench 的发布并非为了对各类商业大模型或智能体架构进行简单的跑分排名,其真正价值在于为电信网络与人工智能的交叉研究划定了清晰的现实边界。
这项评测明确传递出一个信号:在高度讲求责任链条的专业工程领域,仅仅依据最终输出判定 Agent 能力的时代已经结束。一个优秀的电信智能体,不能只做一个会给结论的“黑盒占卜师”,而必须成为一个每一步探查都具备明确意图、逻辑链条严密且经得起实证检验的数字工程师。
面对部分可观测性下的因果推演障碍、底层硬件及物理接口的状态盲区,以及多厂商混合环境下的语义混淆,未来的技术突破显然不能单纯依赖扩大参数规模或增加上下文窗口。如何让模型内化多层网络协议的深层因果拓扑图,如何构建具备先验剪枝能力的领域专用排障规划器,以及如何在策略层建立“无证据不可下发”的严谨自省机制,将是真正推动 AI Agent 走向运营商核心机房的关键技术演进方向。