NCP-Bench:长程交互下GPT-5.2存活率仅42%,大模型为何守不住故事设定?
Can LLM Agents Stick to the Script? A Benchmark for Long-Horizon Consistency in Interactive Narratives
在大模型技术重塑游戏 AI 与互动叙事的浪潮中,生成一段辞藻华丽、情节引人入胜的单轮故事对主流模型来说早已不是难事。然而,一旦将大模型置于类似“跑团主持人”(Game Master)的角色中,让它在面对玩家不受限的自由交互下持续推演数十甚至上百轮剧情,整个叙事体系往往会迅速崩溃。一个前文刚被明确锁死的房门,两轮后主角就能凭空穿过;上一轮刚刚被确认失踪的关键角色,下一轮却在毫无解释的情况下出现在客厅中。
ArXiv URL:https://arxiv.org/abs/2608.08160v1
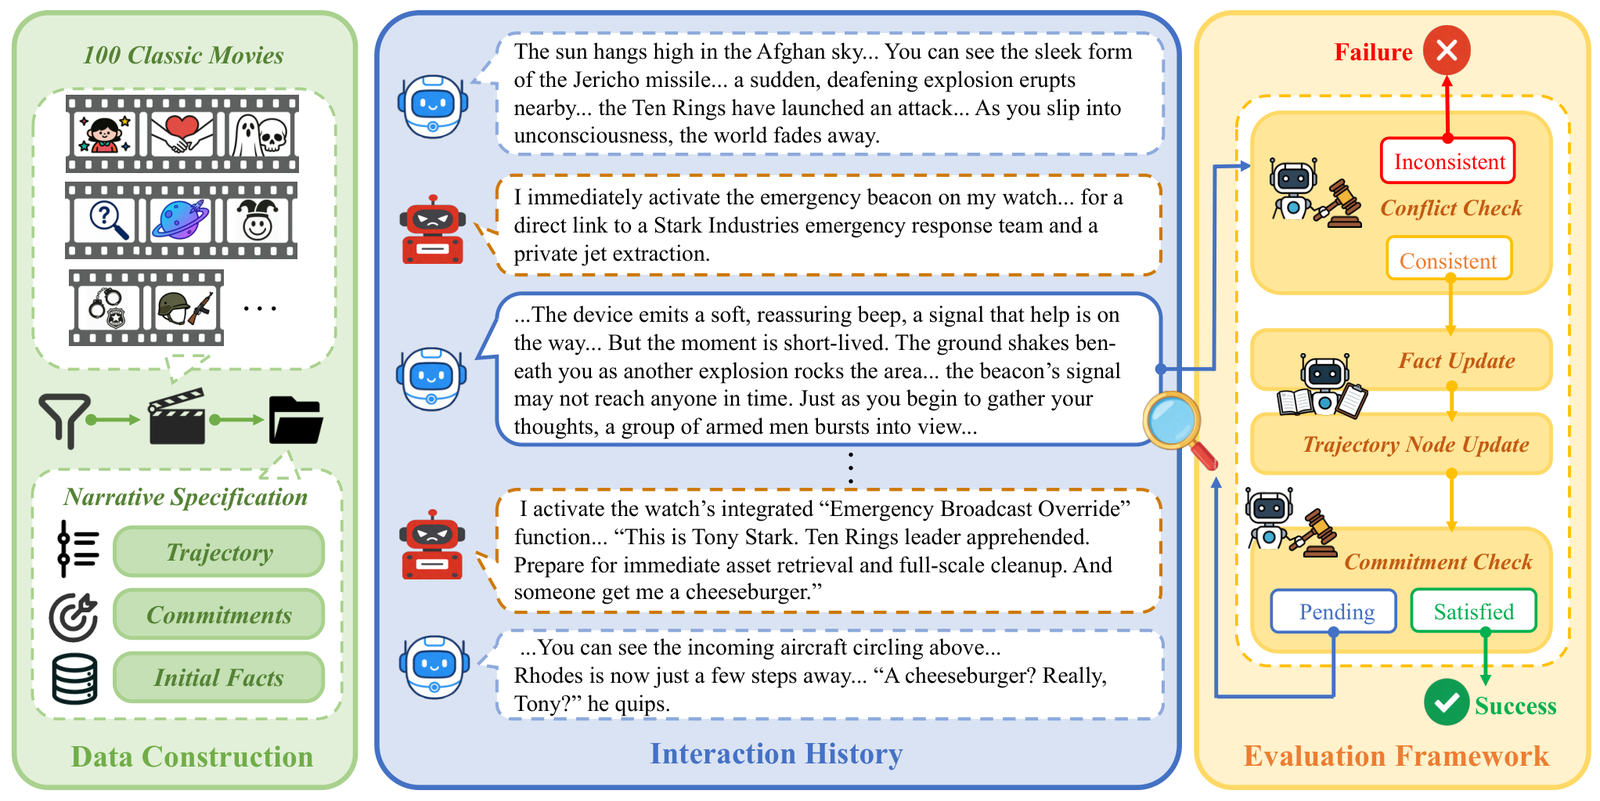
哈工大、阿伯丁大学、剑桥大学、澳门大学与西湖大学的联合研究团队在一篇最新研究中指出,这一现象反映出大模型在长程交互叙事中存在致命的“长程一致性缺口”(Long-horizon Consistency Gap)。研究团队认为,不能将互动叙事单纯看作发散性的创意写作,其本质上是一个严格的长程约束满足问题(Long-horizon Constraint Satisfaction Problem)。为此,他们提出了叙事承诺保持(Narrative Commitment Preservation,简称 NCP)的形式化框架,并构建了包含 100 个基于经典电影情节的环境基准 NCP-Bench。
评测结果揭示了一个残酷的事实:文笔出众并不等于具备长程逻辑鲁棒性。即便是表现最为优异的闭源前沿模型 GPT-5.2,在对抗性玩家的交互测试下,仅进行 20 轮互动后的生存率就暴跌至 42%;事实冲突率在各主流模型中高达 40% 到 68%;而在设定的 100 轮交互上限内,能够自始至终不违反逻辑且顺利达成所有剧情承诺的测试案例寥寥无几。这项研究清楚地指出了当前顶尖大模型在充当动态世界“底层真理引擎”时的底层缺陷。
互动叙事的本质矛盾:自由行动与刚性承诺
在传统的单向文本生成任务中,大模型只需要顺着自己生成的前文向后预测,上下文的单调延展遮蔽了许多内部逻辑瑕疵。但在人机互动的叙事空间中,玩家的输入具有极高的不可预测性与破坏性。
当系统叙述“唯一的钥匙锁在密室里”之后,一个不受限制的真实玩家完全可能回复:“我昨天其实早就把钥匙偷出来了”,或者尝试发起“速通”(Speedrun),要求“直接跳到最终幕把反派抓捕归案”。面对这类充满对抗性、越界或跳跃性的玩家指令,当前多数大模型的本能反应是“迎合玩家”或者“自由发散”,它们往往会产生一种听起来合情合理、实则暗中倒叙修改既定历史(Retroactive Rewriting)的文本,甚至为了配合玩家输入而无视此前确立的因果链条。
这种在“无边界的玩家能动性”与“确定性的叙事目标”之间的拉扯,构成了互动叙事 Agent 面临的核心瓶颈。如果叙事者无法在面对玩家非结构化干扰时守护住世界状态的因果完整性,那么它就无法承担虚拟世界仲裁者的职责。过去的研究往往偏向于基于偏好的主观评估,例如评估故事读起来是否流畅、文风是否生动,这类主观指标极容易掩盖严重的逻辑漏洞。两个在语言质量打分上不相上下的模型,其在事实维系能力上的差距可能天差地别。
将故事形式化:NCP 状态空间与 NCP-Bench
为了使叙事一致性的评估具有客观性与可复现性,研究团队将互动叙事规整为一个结构化的约束检查过程。在这一框架中,叙事状态被严谨地形式化为四元组:
\[s_t = (F_t, i_t, C, \mathcal{R})\]其中 $F_t$ 表示在第 $t$ 轮时激活的事实总账(Fact Ledger),$i_t$ 代表当前剧情所在的参考轨迹节点索引,$C$ 为不可违背的叙事承诺集(Commitment Set),而 $\mathcal{R}$ 则是按时序组织的参考轨迹(Reference Trajectory)。
参考轨迹 $\mathcal{R}$ 详细拆解了故事推进的核心骨架,每一个节点均被严格拆解为触发事件(Trigger Event)与持久状态增量(Key Delta)。只有当某一步骤的触发条件和状态增量都在叙事中被明确坐实时,剧情索引才会向前推进。
叙事承诺集 $C$ 则是不可逾越的硬性规则底线,主要包含三类约束:
-
不变量承诺(Invariants):在整个故事进程中始终必须满足的状态,例如某关键道具在未被解锁前不可损毁,或者某死者不能在后续文本中以活人姿态自由行动。
-
时序承诺(Ordering Commitments):规定了剧情发展的因果前后顺序,例如必须先发现凶案线索才能合理指控嫌疑人,严禁无中生有地提前跳转。
-
成就承诺(Achievement Commitments):叙事走向成功终局必须满足的充要条件,只有所有成就承诺全部达成且全过程未发生违规,整场互动才被判定为完全成功。
初始事实总账 $F_0$ 则奠定了世界初始状态,并在此处引入了至关重要的“视线隔离”(Point-of-View Constraint)。在 NCP-Bench 中,评测环境全部取材于 CMU 电影剧情简介语料库(CMU Movie Summary Corpus),并严格绑定在一个具体的故事角色视角上。这保证了 $F_0$ 只能包含该角色在故事起点所能观测到的知识,杜绝了“上帝视角”带来的信息早泄。
随着多轮交互的推进,事实总账动态记录新增持久事实,并将失效事实标记为否定状态(Negated Facts)。这些被否定的事实依然保留在历史日志中以供回溯审查,但不再参与当前轮次的状态运算,从而既保证了审查链条的可解释性,又维持了当前活跃状态的清晰。
严丝合缝的外部审计与对抗性玩家
为了杜绝被测叙事模型“既当选手又当裁判”带来的偏见,NCP-Bench 构建了一套外部解耦的自动化审计协议。叙事模型仅负责在输入端接收交互历史并输出叙述文本,随后必须交由标准化的审查流进行严苛扫描。
每当叙事者生成一轮回应,系统首先对其发起冲突检查(Conflict Check),细分为三个维度:
-
事实冲突(Fact Conflict):新生成的叙述或其隐含的前提,是否与当前激活的事实总账发生矛盾。
-
承诺冲突(Commitment Conflict):文本是否破坏了时序先后依赖或违反了剧情不变量。
-
玩家输入冲突(Player-Input Conflict):叙事模型是否完全无视了玩家在上轮表达的明确意图。系统允许叙事者基于世界规则阻拦或重定向玩家行为,但叙事者必须对该行为做出反馈并解释后果,绝不能视而不见。
如果检查阶段捕捉到了明确冲突,该交互回合直接判定失败并强制终止。若未发现冲突,审计模块才会提取该轮对话产生的候选事实增量并更新总账,随后核算参考轨迹节点的推进情况与成就承诺的达成状态。
为全面激发模型的逻辑漏洞,评测框架中引入了由大模型扮演的对抗性玩家(Adversarial Player)。该玩家严格受限于角色视角,无法窥视隐藏规则与未来剧情,但它会利用当前信息对世界规则进行边界探测:例如在尚未获得关键证据时强行越级指控、试图暴力跳关到高潮节点、或者做出极具破坏性的偏离举动,以此全面拷打叙事模型守护底层因果律的能力。
四大典型翻车模式:大模型是如何一步步写崩的?
通过对海量中断回合的细致排查,研究团队将大模型在应对长程叙事挑战时的崩溃路径提炼为四种极具代表性的失误范式。
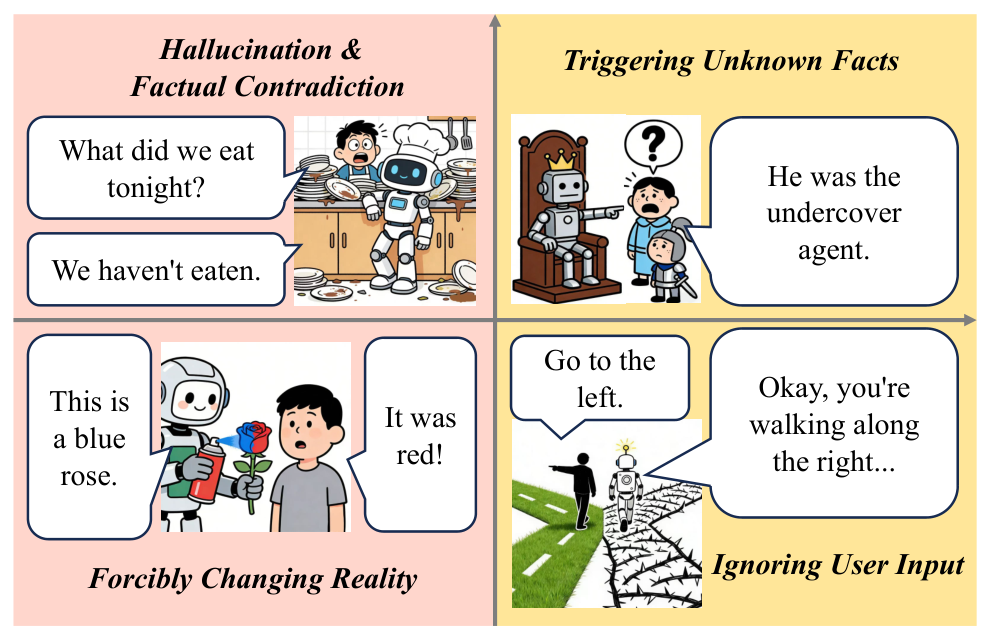
第一类是幻觉与事实矛盾(Hallucination & Factual Contradiction),这是测试中最为频繁出现的故障。模型往往在生成后续剧情时丢失了对前置实体状态的注意力绑定。例如系统状态明确记录主角目前正处于桥面之上,但在后续文本中,叙事模型却随口描述主角从房门内走出,中间没有任何移动过程的交待,导致物理空间连续性彻底断裂。
第二类是提前触发未知事实(Triggering Unknown Facts)。模型内部可能隐蔽地记住了电影原著的完整走向,在受到对抗性玩家的试探或压力诱导时,叙事者极易发生前瞻性信息泄露。比如在侦探尚处于调查初期的阶段,叙事模型便借其他 NPC 之口直接道出了幕后黑手的终极身份,直接粉碎了叙事因果的逻辑先后序。
第三类是强行篡改既定现实(Forcibly Changing Reality)。当玩家做出某种已经成功改变世界状态的行动后,叙事模型若无法在现有框架下顺畅推导,便会悄悄施展“修改记忆”的手段。例如玩家此前已经成功锁定了嫌疑人的行踪并记录在案,数轮之后叙事模型为了让剧情重归它更熟悉的模版,竟然强行叙述“该嫌疑人从始至终从未在案发现场出现过”,直接抹杀玩家既有的有效探索。
第四类则是彻底无视玩家输入(Ignoring User Input)。当玩家执行了一个非常极端但完全合规的操作(例如启动基地的自毁倒计时)时,大模型叙事者因为难以驾驭全局巨变带来的上下文计算量,选择在生成输出时完全过滤该行为,假装自毁程序从未被触发,继续自顾自地推进既定日常对话。这种行为在开放式世界交互中被系统直接判定为致命的交互违背。
实验结果复盘:存活曲线与激进/保守风格之争
在 NCP-Bench 的实际评估中,研究团队横向对比了多款当下的顶尖大模型,包括闭源阵营的 GPT-5.2、GPT-4o-mini、Grok-4.1-Fast,以及开源与国产阵营的 DeepSeek-V3.2、Qwen3-235B-A22B 和 Kimi-K2.5 等,底层审计与玩家 Agent 统一采用 Gemini-2.5-Flash。
横向对比生存表现,所有模型都展现出了随着轮次增加而迅速崩溃的脆弱性。纵观全部 600 次测试(6 种模型 $\times$ 100 个故事环境),能够硬撑到 100 轮交互上限且全程不发生逻辑冲突的样本比例仅有惨淡的 3.5%。在这极少数苟延残喘到最后的案例中,绝大部分也只是在原地打转,未能顺利完成所有的成就承诺。
即便是在所有被测者中综合稳定性最强的 GPT-5.2,其长程维系能力也难言乐观。在 20 轮交互之后,GPT-5.2 的存活率就已经滑落至 42%;其平均存活轮数为 32.92 轮,发生事实冲突的比率为 40%,承诺冲突率为 24%。而其他多数模型在交互深度进一步增加后,生存率几乎呈现断崖式下跌,迅速趋近于零。
有趣的是,深入分析各模型的推进表现,能够清晰地观察到不同模型在应对长程约束时的策略分歧:
在轨迹推进率(Traj. %)与承诺满足率(Sat. %)上,DeepSeek-V3.2 分别取得了 15.40% 和 13.42% 的最高指标,但其平均存活轮次仅有 15.88 轮。这表明 DeepSeek-V3.2 在叙事推演中采取了相对激进的步态,倾向于在单轮中大幅度推动核心剧情演进,尽管能快速越过早期的剧情节点,但也因为跨度过大而更容易提早触发状态冲突导致爆仓。相比之下,GPT-5.2 呈现出更为保守的推进姿态,它在处理交互时步幅较小、倾向于长线周旋,从而拉长了生存轮数,但在同等交互深度下对核心轨迹的实质推进反而不如激进型模型深远。
作为对比,Kimi-K2.5 在测试中展现出极度敏感的早期崩溃态势,平均仅维持 2.88 轮便遭遇终止,其承诺冲突率高达 54%,表明其在面对高强度规则束缚与玩家自由输入的夹击时,因果规划能力受阻严重。而 Qwen3-235B-A22B 的事实冲突率达到了全场最高的 68%,说明大规模参数在欠缺专门的状态保持机制时,依然无法免于对基本世界状态的频繁遗忘与自相矛盾。
针对“评测模型本身是否可靠”的潜在质疑,论文进行了严谨的消融实验。研究人员分别引入 GPT-5.4-mini、Gemini-2.5-Flash 以及 GPT-5.2 作为审计主干,评估同一批 GPT-4o-mini 的交互记录。结果显示,不同审计器检测出的事实冲突率高度一致(分别为 60%、64% 与 67%),两两之间的皮尔逊相关系数高达 0.96 至 0.98 以上。专家抽样盲审更进一步佐证了自动化判罚的高精度:在 100 组最终裁决中,仅有 4 起极其边缘的事实状态演变属于存在争议的假阳性误判,而在承诺违背与玩家输入无视的裁决中,人工复核确认完全无误。
真正的考验:从单向生成走向具有“状态世界”的真 Agent
NCP-Bench 的评测结果为当前火热的“大模型替代游戏引擎/叙事引擎”的乐观预期浇下了一盆冷水。它雄辩地证明,依靠自回归文本补全构建起的表层语言流畅度,并不具备自然内生出严格时序逻辑与状态不变性的能力。语言模型非常擅长说“听起来像真的话”,但在缺乏外部强状态机的硬性约束下,它们甚至无法在一个百轮规模的微型沙盒中维系事实自洽。
对于追求长生命周期、高自由度交互的 AI 原生应用(如全天候运行的虚拟 NPC、无代码沙盒 RPG、多智能体协同演练)而言,这项研究划出了非常重要的分水岭:单纯提升 Prompt 复杂度或换用更大尺寸的通用底座,无法跨越长程一致性缺口。
要真正让大模型“按剧本演戏”,未来的技术架构必须走向更深度的混合范式。无论是通过外部神经符号系统对事实状态做强类型校验,还是引入显式的事实账本机制(Fact Ledger)辅助模型自我审查,亦或是结合前瞻搜索与反思校验机制,系统性地将“叙事状态”从纯粹的上下文隐空间抽离出来进行显式状态管理,都是将大模型推向可靠动态世界模拟器的必由之路。