DelegSearchBench:解耦Deep Search能力,调用搜索不等于智能
Delegation Intelligence in Deep Search: A Controllable Framework for Disentangled Capability Diagnosis
在大模型技术从“单轮对话生成”迈向“自主智能体(Agent)”的演进过程中,深度搜索(Deep Search)被普遍视为最具落地价值的方向之一。从 OpenAI 的 Deep Research 到各大厂商相继推出的自主调研助手,大模型不再仅仅扮演一个坐拥海量静态参数的答题者,而是开始像人类分析师一样,在互联网中自主导航、多轮检索、比对证据并提炼结论。
ArXiv URL:https://arxiv.org/abs/2607.23524v1
然而,现阶段对深度搜索 Agent 的评估体系存在一个根深蒂固的问题:绝大多数基准测试仅仅关注“最终答案是否正确”这一端到端的指标。如果一个模型输出了正确答案,评测者无从得知它是因为本身记住了事实、还是运气好检索到了直接答案、抑或是真正通过严谨的决策链完成了验证;反之,若给出了错误答案,人们也难以厘清是外部搜索引擎的索引质量太差、模型长文本阅读能力不足,还是模型在根本不该停止检索时盲目做出了结论。这种紧耦合的评估方式,将检索后端、上下文理解与决策规划搅成了一团乱麻。
针对这一痛点,来自腾讯、中国人民大学及中国科学院大学的研究团队在论文《Delegation Intelligence in Deep Search: A Controllable Framework for Disentangled Capability Diagnosis》中指出了一个核心论断:在深度搜索场景下,模型的智力水平不应仅仅看它最终答对了没有,而应取决于它是否具备“委派智能(Delegation Intelligence)”——即准确感知自身信息不足,并严谨决定何时、如何将信息获取委派给搜索工具的元认知能力。
为了解开端到端准确率的迷雾,研究团队构建了一套基于文档逆向工程的可控数据生成管线,并推出了评测基准 DelegSearchBench。这项研究首次将深度搜索能力严格拆解为独立的维度进行受控实验,其结果揭示了诸多被传统榜单掩盖的模型缺陷:频繁调用搜索并不等于更智能,面对缺失信息,当前主流大模型往往在“盲目自信提前作答”与“疯狂检索却无法提炼有效证据”之间剧烈摇摆。
为什么端到端准确率正在掩盖真实缺陷?
传统的多跳问答(Multi-hop QA)基准,如 HotpotQA 或 MuSiQue,大多基于维基百科构建,逻辑虽然严格,但早已大量渗透进主流模型的预训练语料中。为了更贴近真实环境,近年来的 GAIA、BrowseComp 等 Agent 基准引入了开放网络浏览和复杂任务执行,将评估推向了动态网络世界。然而,这类开放环境评测引入了巨大的外部不确定性。网页的实时变动、商业搜索引擎的排名算法波动、API 调用的偶然失败,都会显著干扰最终评测结果。
更为致命的是,端到端指标无法诊断模型的底层决策机制。深度搜索的核心难点其实包含两个截然不同却又交织在一起的阶段:第一阶段是认知决策,模型必须评估手头已有的线索是否足以支撑结论,何时该停、何时该搜、该用什么关键词去搜;第二阶段是综合与验证,模型必须在海量嘈杂、甚至存在恶意误导的文本中,辨析哪篇文档更具权威性、哪个版本时效最新,并在跨文档冲突时去伪存真。
当现有的评测只抓取最后的答案输出时,模型很可能会利用参数记忆“作弊”直接回答,或者在检索逻辑完全混乱的情况下靠随机采样的片汤话蒙混过关。这导致学术界和工业界常常被各大排行榜上漂亮的成功率所迷惑,一旦将系统部署到复杂的专业垂直场景,Agent 就会立刻暴露出严重的幻觉、死循环或对干扰信息的极度脆弱。
委派智能:Deep Search的核心元能力
为了从根源上确立诊断标准,论文正式提出了委派智能(Delegation Intelligence)的概念。在深层信息搜寻场景中,模型不应被预设为盲目开启检索的无脑搬运工,检索工具实质上是一种需要权衡调度的外部认知资源。委派智能正是衡量模型在开放环境中能否自主评估信息需求、合理选择认知路径并严格审查信息来源的元认知能力。
研究团队进一步将这种能力解耦为两个互补的子维度:
-
搜索决策制定(Search Decision-Making):衡量模型能否敏锐感知到当前证据的匮乏,并在必要时主动发起搜索、准确构造查询语句(Query)以弥补信息缺口。这一维度的核心在于“知不知道自己不知道”。
-
信息综合与验证(Information Synthesis & Verification):衡量模型在拿到文档之后的信息加工品质。当输入包含多个来源、充斥着过时信息、非官方传闻或内部矛盾时,模型能否准确识别权威出处、识破看似合理的干扰项,并最终推导出可靠结论。
只要评测环境中仍然存在不可控的外部网络检索,这两个维度就无法被真正拆开。因此,评测框架必须能够在完全掌控文本构成的环境下,像化学实验一样精准控制变量:既要给出真实的噪声背景,又要对“何为金标证据”、“何为恶意干扰项”拥有绝对的掌控权。
逆向工程生成管线:将评测环境变成可控沙盒
为了实现细粒度的解耦诊断,研究团队没有采用传统的“先写问题再找答案”模式,而是研发了一套基于真实高质量文档逆向工程的可控合成管线(Controllable Synthesis Pipeline)。
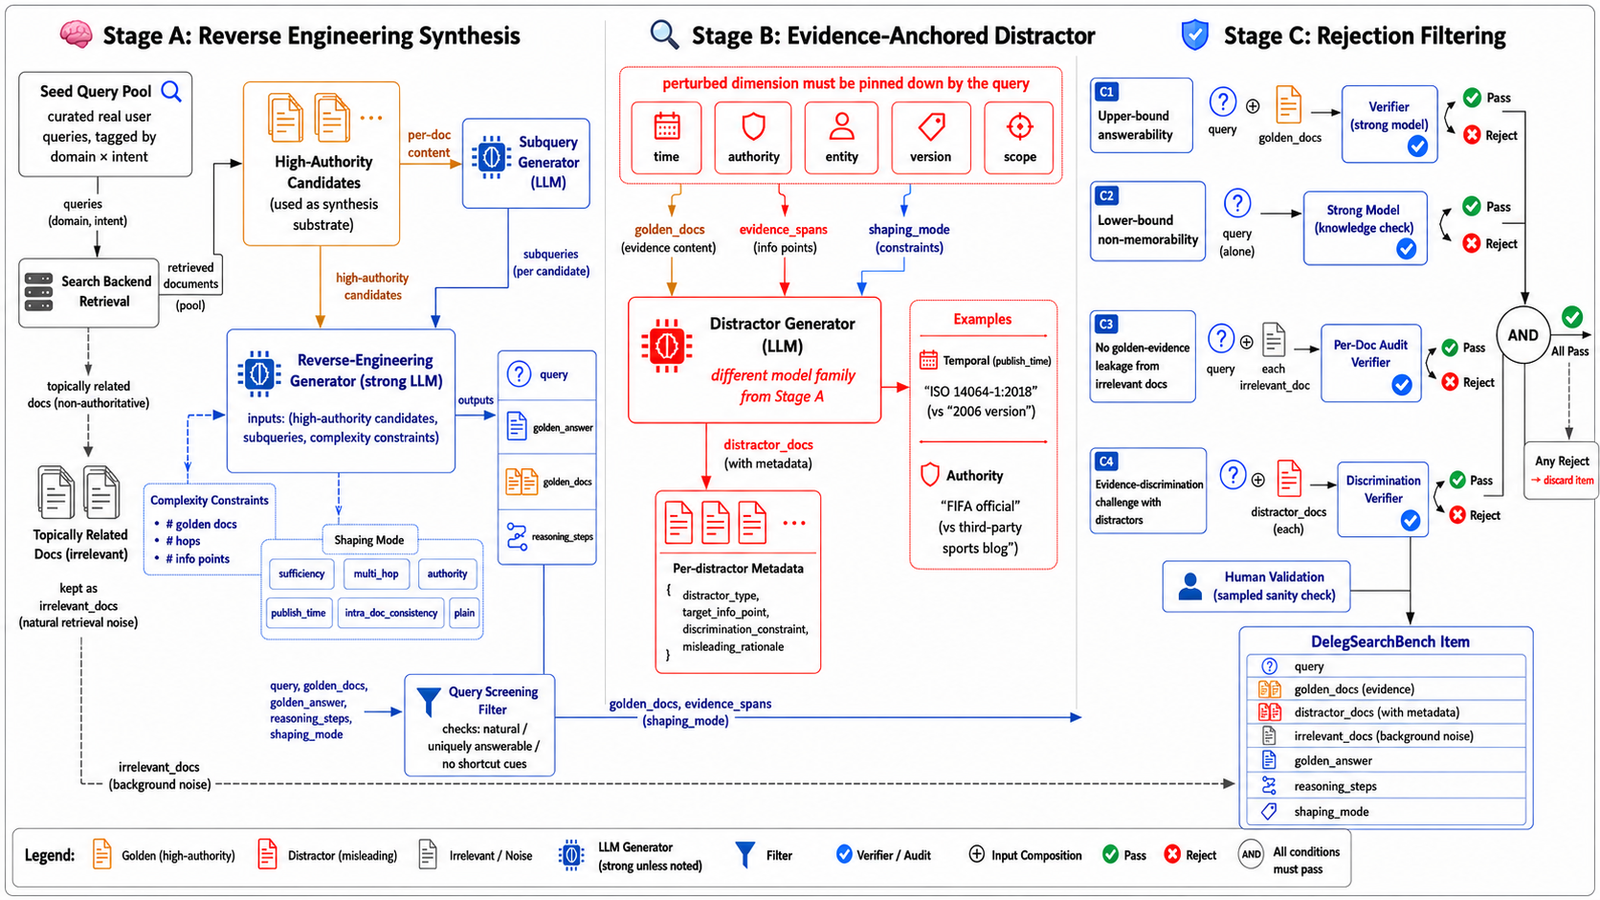
如上图所示,整套管线的巧妙之处在于“以终为始”,在任务构建之前,系统的评测设计者就已经拥有了关于目标答案及其证据链的完整全知视角(Evidential Hindsight)。管线主要分为三个阶段:
-
阶段 A:逆向工程合成(Reverse Engineering Synthesis):管线从真实用户的高质量种子查询出发,检索并筛选出权威的真实文档。随后,算法根据设定的认知能力模式,逆向推导并生成出必须依赖这些文档才能回答的复杂问题。论文针对六种不同的能力模式进行了专门塑造,包括跨多篇文档平行汇聚的“证据充分性(sufficiency)”、环环相扣的“多跳推理(multi_hop)”、依据域名与站名甄别可靠性的“权威性判断(authority)”、考量发布日期的“时效性校验(publish_time)”、排查文本自相矛盾的“文档内一致性(intra_doc_consistency)”,以及作为对照组的常规模式(plain)。
-
阶段 B:证据锚定干扰项生成(Evidence-Anchored Distractor):单纯保留不相关的检索结果虽然能模拟自然噪声,但难以衡量模型的抗恶意欺骗能力。阶段 B 引入了与生成模型不同体系的 LLM,专门针对金标证据在特定维度上进行精准扰动。例如,如果问题严格限定了“根据 ISO 14064-1:2018 标准”,系统会刻意构造基于 2006 年旧版标准的干扰文档;如果问题明确要求“根据国际足联官方统计”,系统就会生成一篇观点相反但来自非官方第三方博客的干扰文章。这种干扰项在关键词上高度吻合,能轻易骗过浅层语义匹配,唯有在证据维度上进行严密校验才能被识破。
-
阶段 C:多重拒绝过滤(Rejection Filtering):合成样本随后必须通过严苛的多阶段自动化拒绝采样,确保无参考资料时模型无法仅凭参数记忆回答(Non-memorability)、提供金标文档时能够稳定回答(Answerability),以及干扰项确实具有欺骗性但不会推翻原答案(Adversarial Validity)。最后辅以分层的抽样人工审查,将有缺陷的数据彻底剔除。
基于这一管线,研究人员构建了包含 429 个精心打磨样本的 DelegSearchBench,并设计了两种互斥的评估实验设置。
实验剖析一:信息完备时,模型为何依然会“看走眼”?
在设置 I(Setting I)中,评测环境向模型提供了回答问题所需的全部金标文档、干扰文档和自然噪声文档,但禁用了搜索工具。这一设定的目的非常纯粹:剥离所有检索环节的不确定性,专门考察模型的“信息综合与验证”能力。为了深入探究长文本处理机制,测试还设置了三种证据摆放位置:将金标文档放在最前面(golden_first)、夹杂在噪声正中间(golden_mid)以及放在最后面(golden_last),并同时记录了单次生成的 Pass@1 与三次采样的 Pass@3。
测试覆盖了包括 Claude 系列、DeepSeek 系列、豆包及混元在内的代表性前沿模型,实验数据展现出了几个极其显著的共同特征:
首先,模型的全文本综合推理能力表现出强烈的“模式依赖性(Mode-Dependent)”。在涉及简单的多文档聚合时表现尚可的模型,在面对“权威性识别”或“时效性判定”时往往会出现大幅度的排名洗牌。这意味着现实世界中的信息甄别并不是一种单一维度的、均质的长文本理解能力,而是由多个高度专业化的推理子能力组合而成的。目前没有任何一个主流模型能够在所有干扰模式下均保持绝对优势。
其次,“迷失在中间(Lost in the Middle)”效应依然是一道坚固的物理屏障。即使所有金标文档都已原封不动地提供在上下文窗口内,绝大多数模型依然对证据出现的位置极其敏感。实验显示,绝大多数模型的得分在 golden_first 条件下达到顶峰,而在 golden_mid 条件下出现急剧下滑。当金标证据被大量高混淆度的干扰文档包裹在上下文深处时,模型提取有效信息的能力出现了最大的退化。这一现象在无需检索的静态长文本中依然如此严重,直接证实了这一缺陷是当前注意力机制与上下文表征架构的内生缺陷,而非传统观点认为的“检索后重排序算法导致的偶发误差”。
最后,单次表现与多次采样之间存在巨大的稳定性裂隙。在全模式下,各模型的 Pass@3 成绩均大幅领先于 Pass@1。这看似是一个“多采样几次就能提高性能”的积极信号,但从智能体可靠性的角度来看,却是一个巨大的隐患。Pass@1 与 Pass@3 之间的显著鸿沟,暴露出模型在面对复杂长上下文时,其证据定位路径和内在逻辑推理链条具有很强的随机性与脆弱性。对于一个需要稳定执行关键任务的 Deep Search Agent 而言,面对同样的输入上下文,如果不能形成稳定收敛的决策路径,其工程可用性将大打折扣。
实验剖析二:信息缺失时,模型到底会不会主动求索?
如果说设置 I 考验的是模型作为“分析师”的阅读审读水准,那么设置 II(Setting II)考验的则是模型作为“探求者”的元认知觉悟。
在设置 II 中,评测环境故意从初始上下文中扣留了一到多篇核心金标文档,使得仅凭手头资料在客观上“绝对不可能推导出完整答案”。同时,初始上下文中保留了全量的干扰文档和不相关背景,并向模型开放了搜索工具。为了防止开放网络带来不确定变量,系统将搜索范围严格限制在当前题目所属的完整文档池内,模型输入检索词后,系统返回基于该词检索出的 Top-$k$ 结果。
这一设置对模型的考验极其严酷且逼真:模型必须首先读懂现有材料,意识到“信息不够”,抵制住直接猜答案的冲动,果断调用搜索工具;其次,它必须精准提炼出到底缺了什么,生成具有针对性的检索词;最后,它还要将新搜出的结果与原本残缺、嘈杂的上下文拼图严密拼合在一起。
实验结果戏剧性地揭示了当前大模型在“委派智能”上的两极化溃败:
第一类严重缺陷是认知盲目自信,导致提前作答(Premature Answering)。在必须依赖外部检索才能补全拼图的任务中,相当一部分模型表现出了顽固的直接回答倾向(Direct Answer Rate 居高不下)。以部分高参数量推理模型为例,即使关键信息被完全物理抽离,模型仍然倾向于根据手头残缺的信息和自身参数记忆强行脑补,最终输出看似言之成理、实则胡说八道的错误答案。这表明模型在长文本状态下极度缺乏对其“知识边界”的校准能力。
第二类缺陷则是频繁盲目委派,工具调用与信息融合严重脱节。与盲目抢答相反,另一些模型(例如混元测试版本)展现出了极高的搜索倾向,几乎每题必搜,看似非常积极。然而,深入分析其检索结果的命中率(Hit@Search)以及搜索后的正确转化率(Correct@Search)就会发现,高频的搜索调用并未带来预期的准确率提升。这些模型虽然知道“要用工具”,但要么无法准确构造反映信息缺口的搜索语句导致搜不回关键文档,要么在搜回正确文档后,被原有的干扰噪声带偏,无法完成最终的逻辑收敛。
在整个测试中,仅有少数模型(如 Claude-3.5/Sonnet 体系及同类高阶模型)在多跳与证据充分性测试中展现出了相对均衡的委派能力:在多跳推理模式下保持适度的检索唤起率,并能够维持超过 80% 的最终准确率。这进一步验证了论文的论点:调用搜索只是形式,懂得在何时何处精准委派,才是深度搜索智能的实质。
对未来智能体系统构建的技术启示
DelegSearchBench 所揭示的这套诊断逻辑,实际上打破了当前学术界与工业界对 Deep Search 系统的一种简单化幻想——即只要给一个基础推理能力不错的大模型套上“Search API + ReAct 提示词循环”,就能自动涌现出高水平的深度调研系统。
论文的实验数据指明了未来构建高可靠 Agent 系统的几个核心改进方向:
-
将“信息匮乏感知”作为独立的后训练目标。以往的强化学习或指令微调主要奖励“给出一个漂亮的答案”,这种对输出完整性的单向激励,恰恰是诱导模型在上下文信息不足时依然“抢答”的元凶。未来的训练数据必须显式构造包含不完整证据链的负例,惩罚强行作答,重奖“在意识到条件不足时发起探询”的决策行为。
-
重构长文本与检索信息的交叉注意力机制。实验表明,即使把正确的补充文档检索回来塞进 Prompt,模型也经常因为严重的中间位置衰减(Lost in the Middle)而对刚刚搜到的证据视而不见。Deep Search 系统的工程架构不能只是简单粗暴地将检索结果往上下文末尾或开头追加,必须在架构层面上实现新旧证据的动态拓扑对齐与去噪重排。
-
从评测“端到端准确”转向评测“决策与推理稳定性”。Pass@1 与 Pass@3 的显著断层告诫开发者,单次评估的高分可能掩盖了模型决策路径的内在混沌。一个高可靠的商用系统,其决策轨迹必须在面对随机扰动时具备收敛性。评测基准应当逐步引入像 DelegSearchBench 这样的受控诊断沙盒,将工具调用的精准度、证据不足时的拒答率、干扰项下的鲁棒性纳入综合指标体系。
这项研究不仅为深度搜索能力的评测提供了一套可复用的逆向工程方法论,更厘清了 Agent 技术发展的本质逻辑:大模型走向真正自主的第一步,并不是展现它无所不知,而是坦然看清自己所拥有的局限,并在正确的时间,把求索的触角精准伸向外部世界。