ERR+:奖赏推理“熵降”,字节新框架提点8.7%且Token缩减20%
ERR+: Sequential Entropy Resolution for Efficient and Decisive LLM Reasoning
在大模型推理能力的演进路径中,强化学习与可验证奖励(RLVR,Reinforcement Learning with Verifiable Rewards)已然成为催生强推理模型的核心引擎。从 DeepSeek-R1 到各大实验室的最新尝试,模型依靠在 <think> 标签内展开冗长、曲折的思维链(Chain-of-Thought),攻克了一道又一道数学和代码难题。然而,这种依赖最终答案正确与否给予二元奖励(0/1 判定)的训练范式,正遭遇一道天花板:它只在乎终点,几乎无法对思考过程的质量提供细粒度引导。
ArXiv URL:https://arxiv.org/abs/2608.28771v1
当模型在同一个问题上采样出多条均能得出正确答案的思维链时,群组相对策略优化(如 GRPO)在正确样本间的方差趋近于零。模型无法区分到底哪一条路径更加清晰高效,进而滋生了大量的推理废话和低效循环。以往研究试图通过惩罚输出长度或强行压低 Token 级熵(Entropy)来压缩思维链,但这类操作往往直接伤及推理的核心——压制高熵 Token,等于扼杀了模型在关键分岔点上的探索能力,导致准确率大幅下滑。
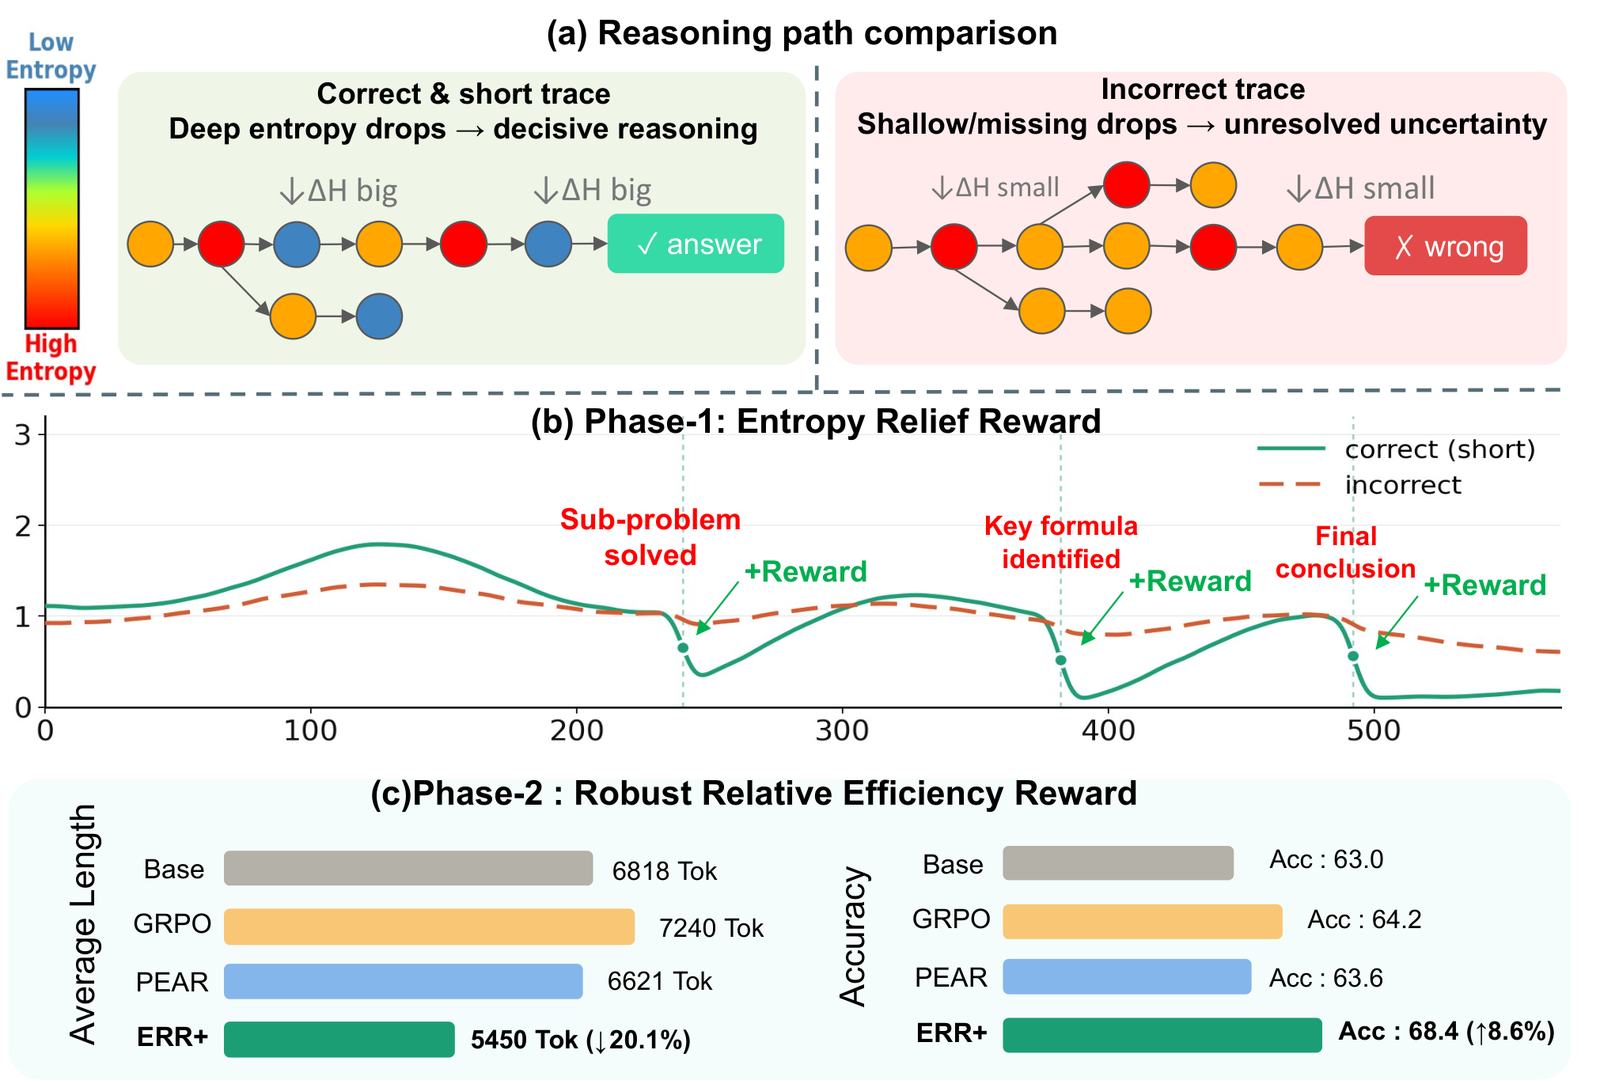
针对这一两难困境,字节跳动与华东师范大学的研究团队提出了全新框架 ERR+。与以往试图压制熵的做法不同,ERR+ 敏锐地捕捉到一个全新现象:真正优质且正确的推理链,并不是从头到尾保持低熵,而是在探索之后发生频繁且剧烈的“熵降”(Entropy Drop)。研究团队基于此构建了两阶段强化学习框架:第一阶段通过熵释放奖励(Entropy Relief Reward,ERR)奖赏模型从迷茫走向确定的“释怀”时刻;第二阶段引入抗噪相对效率奖励(Robust Relative Efficiency Reward,RRER),自适应消除无效冗余。在 DeepSeek-R1-Distill-Qwen-1.5B 上,ERR+ 实现了在响应长度缩减 20% 的同时,准确率绝对提升 8.7%,成功解耦了推理精度与思维链长度之间的负相关魔咒。
迷茫不是坏事,关键是要有“顿悟”
在自回归生成的每一步,模型预测下一个 Token 的概率分布都会对应一个香农熵(Shannon Entropy)。简单来说,熵值越高,意味着模型当前越举棋不定、存在多种可能分支;熵值极低,则意味着模型胸有成竹,后续推导高度确定。
以往针对强化学习推理机制的研究表明,序列中熵值最高的前 20% 节点(被称为决策分叉点 Forking Tokens)实际上承担了绝大部分的模型学习增量。如果像传统方法那样在整个思考阶段施加全局熵惩罚,就等于直接抹杀了模型在分岔路口停下来思考、尝试不同分支的自由。
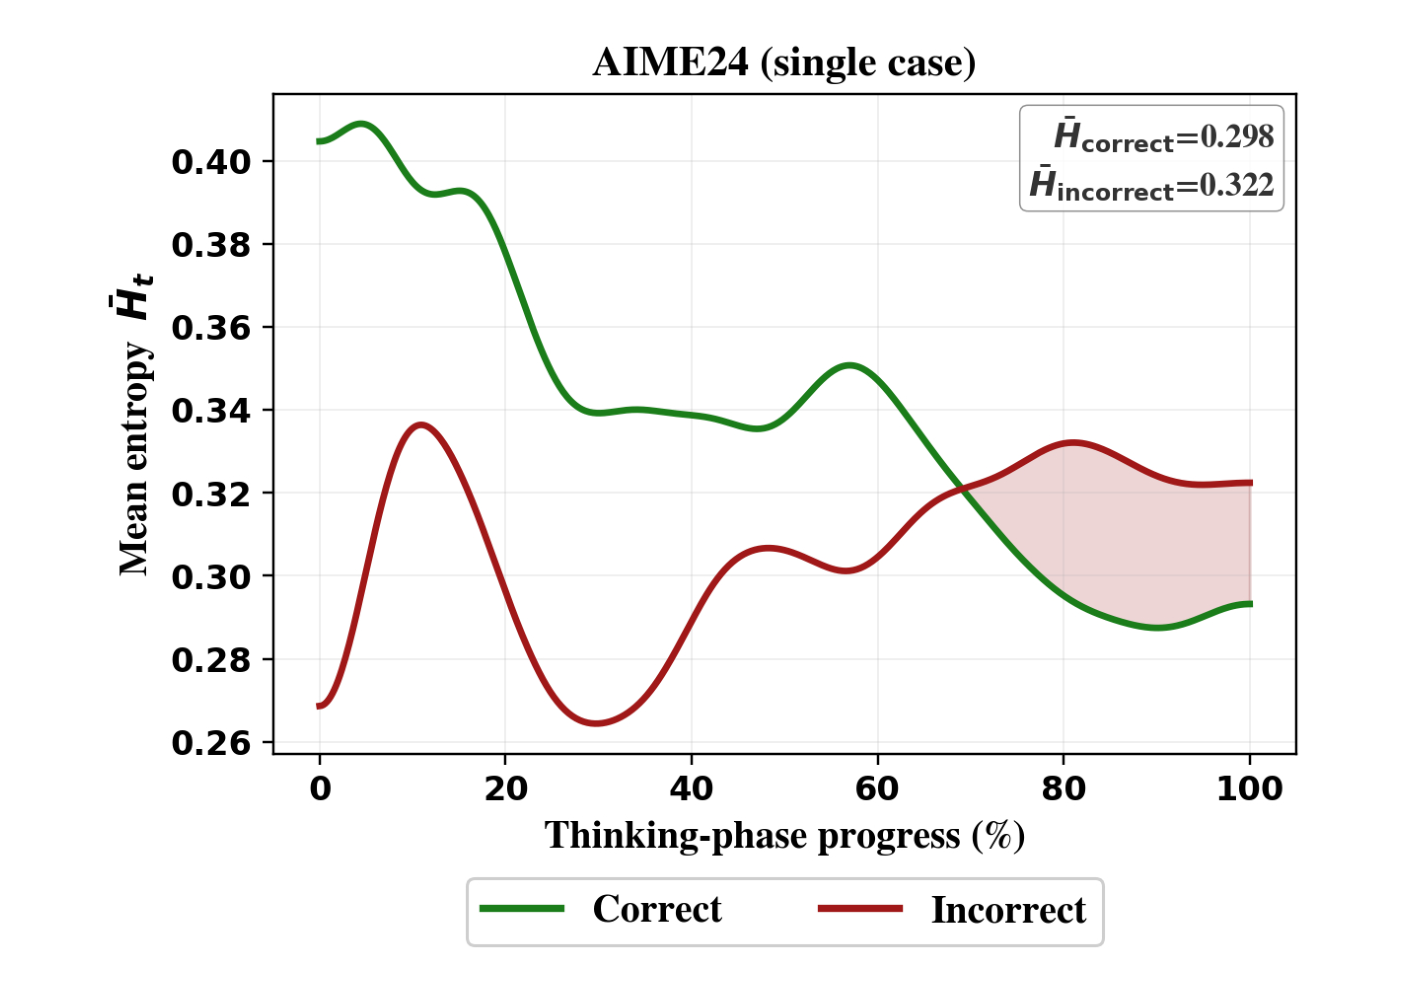
字节跳动的研究团队换了一个切入角度:问题不在于绝对熵的高低,而在于熵的动态变化过程。他们对主流模型在 AIME24 等高难度数学题上的解题轨迹进行了微观剖析。
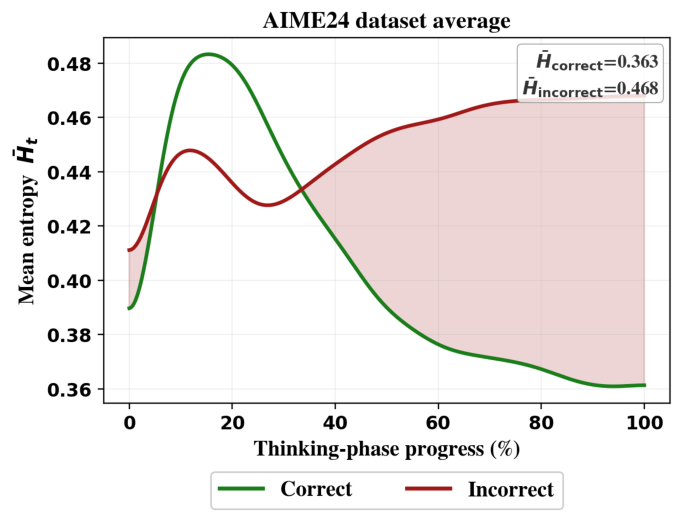
从上方的单用例跟踪图与宏观聚合图可以清晰地观察到一种普遍模式:
在同一道题的解题过程中,最终回答正确的思维链(图中蓝线)在前期同样会经历高熵的探索阶段,但一旦突破关键假设或找到解题公式,其熵值便会呈现断崖式下跌,展现出果断且坚定的承诺状态;反观最终回答错误的思维链(图中红线),虽然也经历了高熵的漫游,但由于始终未能理清逻辑脉络,其熵值会长期在高位震荡徘徊,直到思考结束也未能形成逻辑闭环。
这一实验事实揭示了高质量推理的本质特征:优秀的思考并非盲目自信,而是“在探索中寻找确定性”。正确的逻辑突破必然伴随着不确定性的消除,即 Token 级别的显著熵降。
ERR+:两阶段解耦的高效推理框架
将上述观察转化为强化学习奖励信号,并不能简单地把熵降数值加总。如果只是单纯累加每一步的熵降量,策略模型很快就会学会“水字数”——通过故意拉长推理篇幅来累积更多局部的熵降跳变。为了从根本上规避这一隐患,ERR+ 构建了一套精密的两阶段驱动体系。
第一阶段:奖赏关键突破的 ERR
在第一阶段,模型专注于形成高质量、有决断力的推理结构。对于思考阶段的第 $t$ 个 Token,其熵降增量定义为:
\[r_t = \max(\mathcal{H}_{t-1} - \mathcal{H}_t - \epsilon, \; 0)\]其中 $\epsilon$ 为过滤微小数值扰动的阈值。为了彻底遏制模型通过堆砌长度刷取分数的投机倾向,整个思维链的熵释放得分并没有采用线性平均,而是采用了亚线性的对数归一化:
\[\mathrm{ERR}(y) = \frac{\sum_{t=2}^{T_k} r_t}{\log(T_k + 1)}\]这里 $T_k$ 为思维链标签 </think> 结束前的位置。对数归一化是一项极其精巧的设计。线性归一化(除以 $T_k$)要求模型在整条链条上维持恒定密度的熵降,这对于真正需要长程试错的复杂难题极不公平;而完全不归一化又会鼓励无限膨胀。对数函数的亚线性增长特征,恰好使得模型在拉长思维链时面临边际递减的门槛,既允许它为了解开难题进行必要的探索,又倒逼每一次拉长都必须兑现具有里程碑意义的重大逻辑突破。
此外,ERR 得分严格与最终答案的二元正确性挂钩。只有当最终答案核验正确时,累积熵降才能折算成增量奖励;如果最终结论错误,该项奖励直接清零。这确保了强化学习优化器不会盲目奖励“看似自信、实则荒谬”的胡言乱语。
第二阶段:自适应题感压缩的 RRER
当第一阶段训练充分,模型的解题逻辑已经形成了清晰的“探索-收敛”骨架后,第二阶段顺势介入,启动抗噪相对效率奖励(RRER)。
以往的长度惩罚往往采用固定的长度上限或全局步长惩罚,这种“一刀切”的做法忽视了题目的固有难度——小学奥数题本该在 500 个 Token 内解决,而复杂的奥林匹克竞赛题写满 8000 个 Token 也是合情合理的。RRER 的解决思路是“群体自适应对比”:利用当前 Query 在同批次 Rollout 中采样出的多条候选回复的平均长度 $\mu_L$ 作为这道题内在难度的隐式代理。
对于第 $i$ 条回复,RRER 计算其在群组内的长度 $z$-score:
\[z_i = \frac{L_i - \mu_L}{\sigma_L + \varepsilon}\]并通过双曲正切函数实现平滑饱和:
\[\lambda_i = \tanh(-\gamma z_i)\]如果某条回复在得出正确答案的前提下比同组绝大多数候选更加简练,它将获得可观的正向效率奖励;反之,若在群组平均线之后冗余延展,则会被施加惩罚。双曲正切函数的设计避免了长尾异常值对梯度的破坏,赋予了该信号极佳的鲁棒性。
为什么必须分阶段:定理 1 揭示的梯度内积冲突
很多算法设计者可能会产生疑问:既然 ERR 和 RRER 各有千秋,为什么不从初始阶段就将二者直接相加,联合优化?
ERR+ 的作者团队从理论上给出了严格证明。在论文的核心定理(Theorem 1)中,作者证明了在训练初始阶段,第一阶段的目标梯度 $g_1(\theta)$ 与第二阶段的长度目标梯度 $g_2(\theta)$ 之间存在必然的内积冲突:
\[\langle g_1(\theta), \, g_2(\theta) \rangle \le -C \cdot \rho(\theta)\]其中 $\rho(\theta)$ 代表处于“探索中途”(Mid-Exploration,即 Token 熵高于平均水平但尚未触发大幅熵降)的比例。
直观地理解,在模型尚未学会如何正确解决问题的早期阶段,大量高熵的探索性片段是后续达成逻辑突破所必须依赖的上下文依托。如果在此时强行施加长度抑制梯度 $g_2$,优化器最容易走上的捷径就是直接删减这些尚处于迷茫状态的高熵片段。然而,一旦抹杀了探索的前置条件,紧随其后的熵降突破就根本无法发生,从而对第一阶段的目标 $\mathcal{L}_1$ 产生剧烈反噬。
而在第一阶段训练收敛后,这种冲突便迎刃而解。实验监测显示,在初始阶段,两个目标的梯度余弦相似度低至 $-0.45$,呈现强烈的对抗状态;当第一阶段训练完成后,模型内部形成了坚实的解题路径,此时梯度余弦迅速回升至 $-0.05$,在第二阶段结束时更达到 $+0.02$。此时第二阶段所剥离的,纯粹是逻辑闭环之后残留的无意义重复和低熵低效废话,真正实现了“去粗取精”而不伤筋动骨。
实验评测:打破准确率与长度的互斥天花板
为了全面检验 ERR+ 的真实效能,研究团队在开源强化学习框架 verl 上展开了严密实验,覆盖 DeepSeek-R1-Distill-Qwen-1.5B、7B 以及 Qwen3-4B、8B 等四种主流基座,基准测试包括 GSM8K、MATH-500、AIME24、AMC23 以及跨领域的 MMLU-STEM。
核心基准对比
在 DeepSeek-R1-Distill-Qwen-1.5B 这一高度竞争的基座上,与包括标准 GRPO、强熵基线 DAPO、长度控制算法 LASER 以及直接惩罚熵的 PEAR 等方法的横向对比中,ERR+ 展现出了压倒性的优势:
-
在 Pass@1 综合准确率方面,零样本 Base 表现为 54.4%,标准 GRPO 达到 59.7%,而 ERR+ 冲上了 68.4%,实现了 8.7 个百分点的巨大跨越。即便是搭载在本身更强的 DAPO 优化器上,DAPO+ERR+ 依然在原有基线基础上再涨近 4 个百分点。
-
在生成长度方面,标准 GRPO 在提升正确率的同时,平均推理长度从 4780 个 Token 膨胀到了 6813 个 Token;试图通过压制思考熵来限长的 PEAR 虽然将长度缩短到了 3816 个 Token,但代价是准确率暴跌至 47.9%;而 ERR+ 则在准确率达到峰值的同时,将整体平均长度稳稳控制在 5450 个 Token,相对 GRPO 压缩幅度超过 20%。
这组数据确凿地证明:思维链的膨胀绝非提升精度的唯一代价,结构良好的思考完全可以兼顾敏锐与简练。
消融实验与机制自洽性
消融实验进一步验证了各设计模块的不可替代性:
-
若剔除第一阶段(仅保留 Phase 2 长度控制):模型在 GSM8K 上确实刷出了极短的 1244 个 Token,但全局平均准确率相较完整 ERR+ 暴跌了 5.5%。过早的长度压缩在模型尚未建构起稳固的逻辑结构前,粗暴斩断了探索链条。
-
若剔除第二阶段(仅保留 Phase 1 熵降奖励):虽然模型准确率表现依然强劲(66.8%),但其平均长度比完整 ERR+ 多出 21.5%,证明模型在掌握解题能力后确实需要外部效率信号来冲洗冗余。
-
若采用联合训练($R_1 + R_2$ 并行):验证了定理 1 的预测,联合训练的平均准确率仅有 62.6%,大幅落后于两阶段串行训练的 68.4%,长度也失控增加。
探针检测:是否存在“奖励破解”(Reward Hacking)?
在强化学习中,直接对中间代理信号施加奖励最令人担忧的隐患是模型学会“钻空子”——比如模型是否会故意生成锯齿状交替的 Token(人为制造先升熵、再降熵的虚假循环)来骗取 ERR 奖励?
研究团队设计了专门的探针检测,重点监测了两个敏感指标:全序列中熵上升总量与熵下降总量的比值(Up/Drop),以及每条思维链中熵变化方向的翻转次数(Sign Change)。实验数据表明,在整个 ERR+ 训练过程中,Up/Drop 比值自始至终稳定在接近 1.0 的自然平稳状态,而熵变化的翻转次数不仅没有飙升,反而呈现出单调递减的趋势。这直接击碎了算法投机的质疑:模型并未发展出人造震荡的作弊技巧,它所获得的奖励完全来源于那些在攻克子问题、确立核心定理时真实发生的果断收敛。
思考与未来演进
ERR+ 的成功给当前的大模型推理强化学习社区带来了深层启发。长期以来,关于思维链是“越长越好”还是“压缩至上”的争论未曾停歇。ERR+ 从信息论视角给出了更为通透的回答:长度不是原罪,毫无进展的迷茫漫游才是;探索也不应被扼杀,但每一次探索都应当奔着“收敛与确认”而去。
利用模型自回归分布内在蕴含的 Token 级熵,开发者无需额外引入开销昂贵的过程监督奖励模型(PRM),就能在仅有终点答案判定的弱监督设定下,榨取出近乎中间步验证的高价值信号。这种即插即用、零推理额外开销的特性,让 ERR+ 在工业界落地时具备极高吸引力。
当然,正如作者在局限性中所探讨的那样,数学和逻辑领域的严格可验证性使得这一框架得以完美运转。如何将“从混乱走向笃定”的熵动力学推广到开放域问答、创意写作或多智能体博弈等缺乏标准真值的复杂场景,依然是一片充满机遇的广阔蓝海。但至少在逻辑推理的战场上,ERR+ 已经指明了一个清晰的方向:别再盲目压制模型的纠结,给它探索的自由,并在它灵光乍现、豁然开朗的瞬间,给予最慷慨的奖赏。