DrawAI:两阶段Agent重构静态图像,39项指标测评13款前沿模型
DrawAI: Agentic Benchmark and Workflow for Making Raster Images Editable
当前多模态大模型和文生图工具能够以极高分辨率合成复杂的科研插图、演讲幻灯片、信息图表以及思维导图。但在实际工作流中,这类生成结果往往面临着“只能看、不能改”的尴尬境地。扩散模型或多模态智能体输出的通常是光栅化位图(Raster Image),文字、线条、排版层级和背景被硬生生压缩进同一张像素画布。用户哪怕只是想修正一个拼写错误、调整一根连线的起点,或是复用其中的一个示意图标,也无法直接在画布上拖拽修改,往往只能选择人工重新绘制,或是重新输入 Prompt 抽卡,面临前序满意区域被不可控篡改的风险。
ArXiv URL:https://arxiv.org/abs/2608.00548
从静态像素画布中重新抽离出结构化、可独立编辑的原生对象,这一任务被称为“图像到可编辑重构”(Image-to-Editable Reconstruction)。该任务的核心痛点在于保真度(Fidelity)与可编辑性(Editability)之间存在不可调和的拉扯。如果只是追求视觉上的分毫不差,模型完全可以把原图当作背景贴图直接嵌入,但这会让可编辑性归零;反之,若强行把图像切碎成成百上千个矢量微元,往往又会破坏排版语义、导致文字走样或丢失视觉质感。
为了系统性攻关这一难题,研究团队提出了 DrawAI 框架,构建了一套覆盖四大视觉资产领域、结合确定性规则与多模态大模型裁判的综合评测基准 DrawAI-Bench,并设计了将感知规划与代码执行拆解的两阶段智能体工作流 DrawAI-Flow。研究团队对 13 款主流多模态模型以及 5 种不同的 Agent Harness(智能体运行宿主框架)进行了全方位压力测试,系统揭示了如何将一张扁平的位图真正还原为可供人类自由修改的 SVG 与 PPTX 资产。
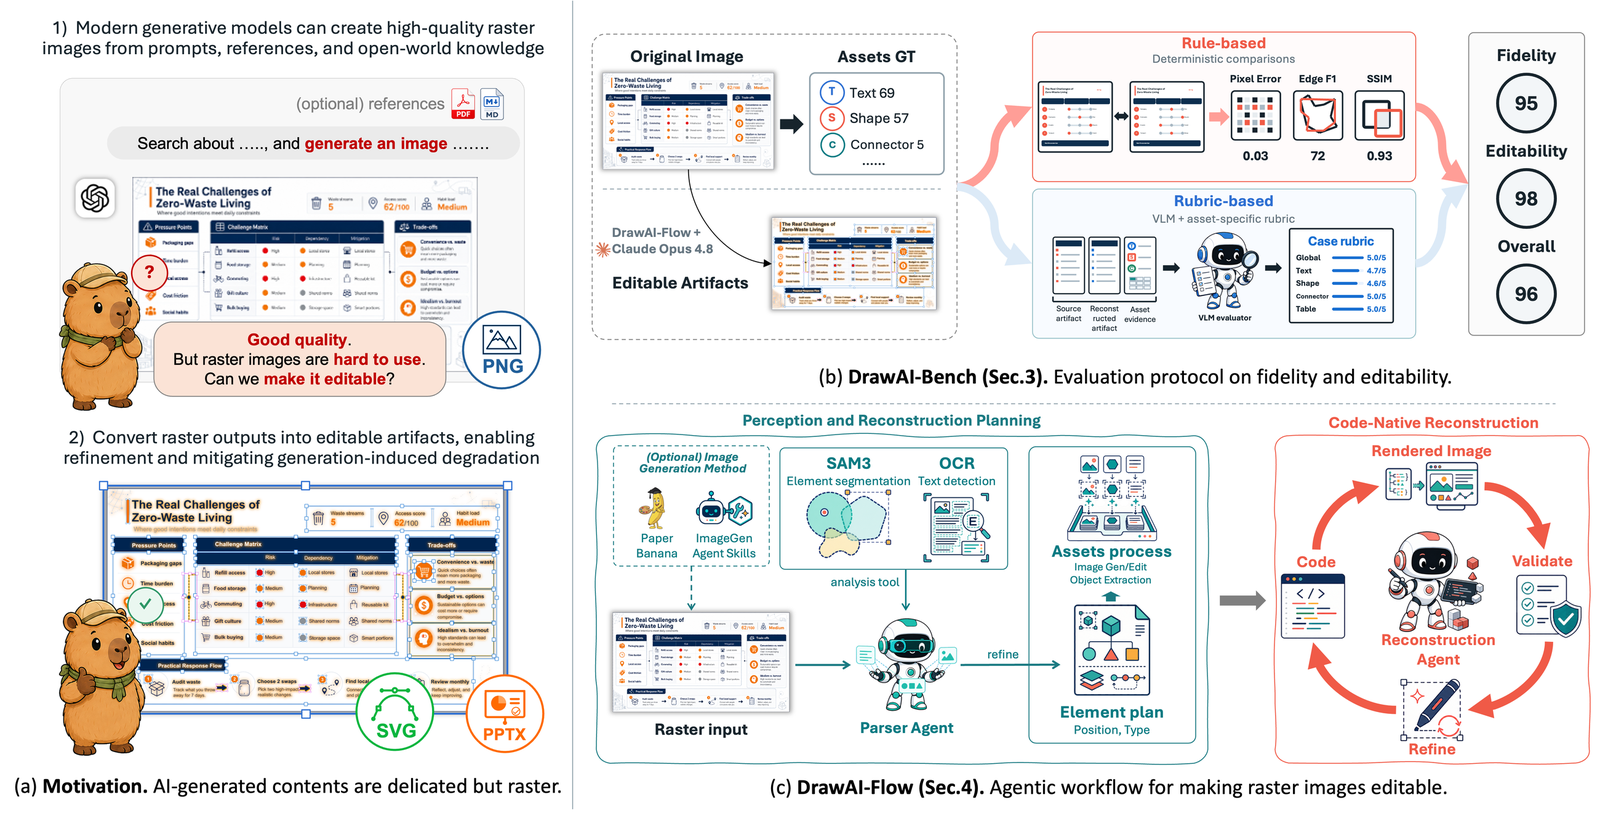
从死像素到原生排版:重构任务的真实困境
图像到可编辑重构的目标,是输入任意高分辨率位图后,输出一份具有明确层次拓扑的结构化资产(如原生 SVG 或 PowerPoint 文件)。这一产物必须在确定性渲染引擎下展现出与原图高度一致的视觉表象,同时内部各个组件(文本框、箭头、形状、表格单元格)必须保持独立,允许人类用户在常规排版软件中直接选中并修改。
传统计算机视觉管线通常将这一过程切分成孤立的单项任务,例如单独的 OCR 识别、公式转 LaTeX、图表代码提取或基于特定算法的边缘矢量追踪。这种分散的处理方式无法理解复杂的综合排版语义。例如一张复杂的科研流程图,既包含数学符号,又包含带箭头的状态转移路径,还嵌套着从其他实验截取过来的位图照片。传统工具要么格式崩溃,要么丢失结构之间的连带逻辑。
直接使用端到端的多模态大模型直接生成整份 SVG 源码或 PPTX 二进制脚本,在实操中同样会遇到难以克服的瓶颈。大语言模型在单次长上下文输出中,极易将图像的高层语义感知与底层语法排版代码的编写细节混淆。模型一旦在某个排版坐标或闭合标签上出现轻微偏差,就可能引发渲染黑屏,且在没有视觉反馈的环境下根本无法自我修正。这也是为什么重构任务必须引入能够自主调用工具、执行代码并进行视觉复核的 Agentic(智能体)机制。
兼顾视觉与操作:包含 39 项指标的 DrawAI-Bench
要解决重构问题,首要前提是建立科学的评估标准。过去的图形评估往往陷入两个极端:计算机视觉偏好 SSIM、PSNR 等像素级相似度,但在重构场景下,一张直接把原图贴在底层的大图可以轻松获得满分;而传统的代码评估只看语法能否通过编译,忽略了渲染后排版是否错位、语义连接是否断裂。
针对这一矛盾,研究团队建立了覆盖科学图表(Scientific Figures)、演示幻灯片(Presentation Slides)、学术海报(Posters)与示意图解(Diagrams)四大领域的评测集 DrawAI-Bench。这四个领域分别对应了信息高密型陈述、图文混合排版、艺术视觉传达以及强拓扑逻辑关联,兼顾了人类真实设计资产与 AI 自动生成图像。所有图像均由人工专家联合标注,明确划定文本、图像、公式、形状、连线和表格六大类资产的精确轮廓与语义层级。
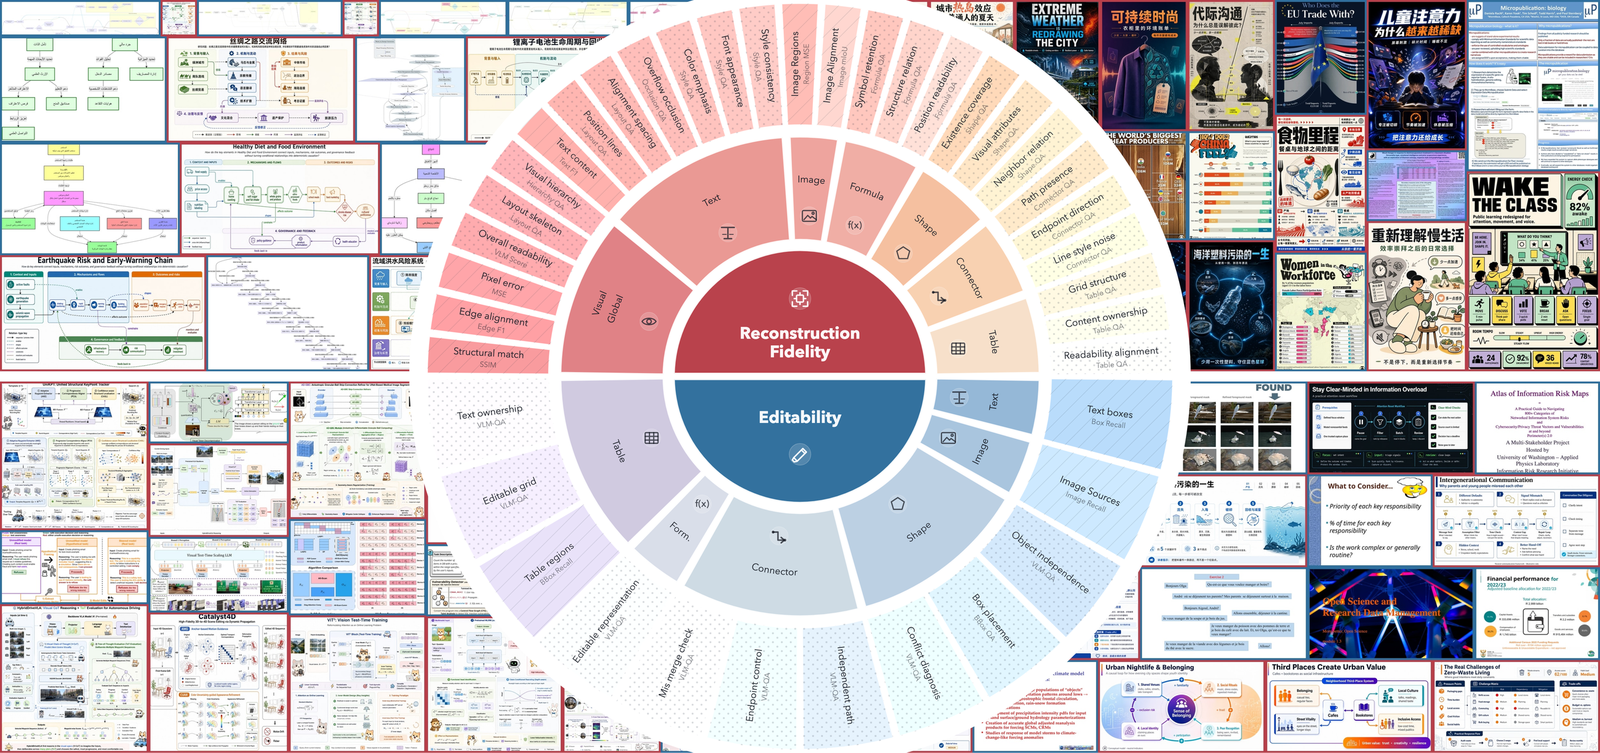
DrawAI-Bench 摒弃了单一的相似度打分方式,构建了一套包含 39 项细分指标的混合评估体系(Hybrid Evaluation Protocol),涵盖两大核心维度:
-
保真度(Fidelity):分为全局与特定资产两个层面。全局层面衡量整体排版对齐度、边缘对齐、可读性与视觉层级;特定资产层面则精细检测文本内容完整性、公式结构还原、连线起止准确度、形状色彩与位置对应。
-
可编辑性(Editability):直击重构资产的拓扑底层。它检测文字是否被还原为可输入的光标文本框而非轮廓路径、连线是否具有可拉伸端点、几何图形是否保留标准向量属性、表格是否具有规整的网格行列结构。
在评测手段上,基准对具有确定性几何或字符对应关系的属性(如文字识别准确率、独立对象边界框交并比)采用 9 项规则算法进行精确计算;而对于视觉层级协调性、艺术风格贴合度等主观性较强的属性,则通过针对特定资产定制的视觉语言提示词,交由多模态裁判模型(以 GPT-5.6 Sol Ultra 为主核)完成 30 项基于标尺(Rubric-based)的审视打分。
在人类专家验证实验中,五位拥有多年排版和矢量图编辑经验的专家对 200 份重构样本进行了交叉双盲盲评。专家间的一致性系数(Krippendorff’s $\alpha$)落在 0.66 至 0.78 之间,而裁判大模型的判定结果与专家共识取得了 80.1% 至 93.3% 的极高精确吻合率。将重构资产导出为原生 PPTX 后的实际人手操作可用性打分,与 DrawAI-Bench 综合得分的相关系数(Spearman’s $\rho$)高达 0.94。这充分证明该基准不仅具备严密的量化信度,更真正击中了用户在下游软件中实际编辑的核心体验。
DrawAI-Flow:解析规划与代码迭代的解耦协同
在明确了评测标尺后,研究团队深入剖析了大模型在重构过程中频频崩溃的根本原因:感知与生成在单阶段中混杂在一起,导致模型既当“侦探”又当“泥瓦匠”。为此,研究所提出的 DrawAI-Flow 采用了专门的两阶段解耦范式。
第一阶段是解析与规划(Parsing and Planning)。面对输入的静态图像,系统首先调用感知模型基座生成初步线索,利用 SAM3 提供细粒度区域分割候选,同时配合 PP-OCRv5 进行高精度的文字探测与行提取。由于原始分割通常极其碎片化,甚至存在重叠或遗漏,此时 Parser Agent 介入,统筹全局视角对候选集进行空间去重、语义对齐和边界修正。
更为关键的是,Parser Agent 会在这一步输出一份详尽的重构策略规划清单。智能体在此显式决定每种视觉元素的重构路线:对于文本、基本形状和数学公式,强制指定采用原生代码基元重新绘制;对于自然风景、复杂纹理照片,则采用局部高保真切片;针对需要独立分层的前景主体,自动挂载 BRIA RMBG-2.0 进行高精度去背景抠图;若局部出现遮挡或残缺,则调度图像生成模型(如 GPT-Image-2)进行上下文感知的内容补全与重绘。这种显式规划机制,直接在策略层锁定了保真度与可编辑性的边界,消除了端到端模型的盲目性。
第二阶段是代码化图像重构(Image-as-Code Reconstruction)。在这一阶段,Reconstruction Agent 并不直接向文本流里倾倒成千上万行无序的 XML 标签,而是将视觉重构转化为面向对象的图形代码编写任务。代码被天然作为一种功能模块化、语法可解释且支持局部修改的强大中间表示(Intermediate Representation)。
Reconstruction Agent 依照规划清单构建可执行程序,随后进入“编写—渲染—校验—修正”(Code-Render-Validate-Revise)的迭代闭环,单任务上限支持 5 轮演进。在每一轮循环中,本地运行环境会即时渲染出当前的 SVG 矢量图,并与输入位图逐层比对,自动诊断结构位置、色彩风格和文字排版方面的几何与语义差异。校验器随后向智能体提供精准的差异反馈,引导其仅针对局部代码片段实施 Patch 级差量修改。这种按需微调模式大幅降低了全量重新输出带来的冗余 Token 消耗,彻底规避了因长代码单点语法错误导致全图报废的级联风险。
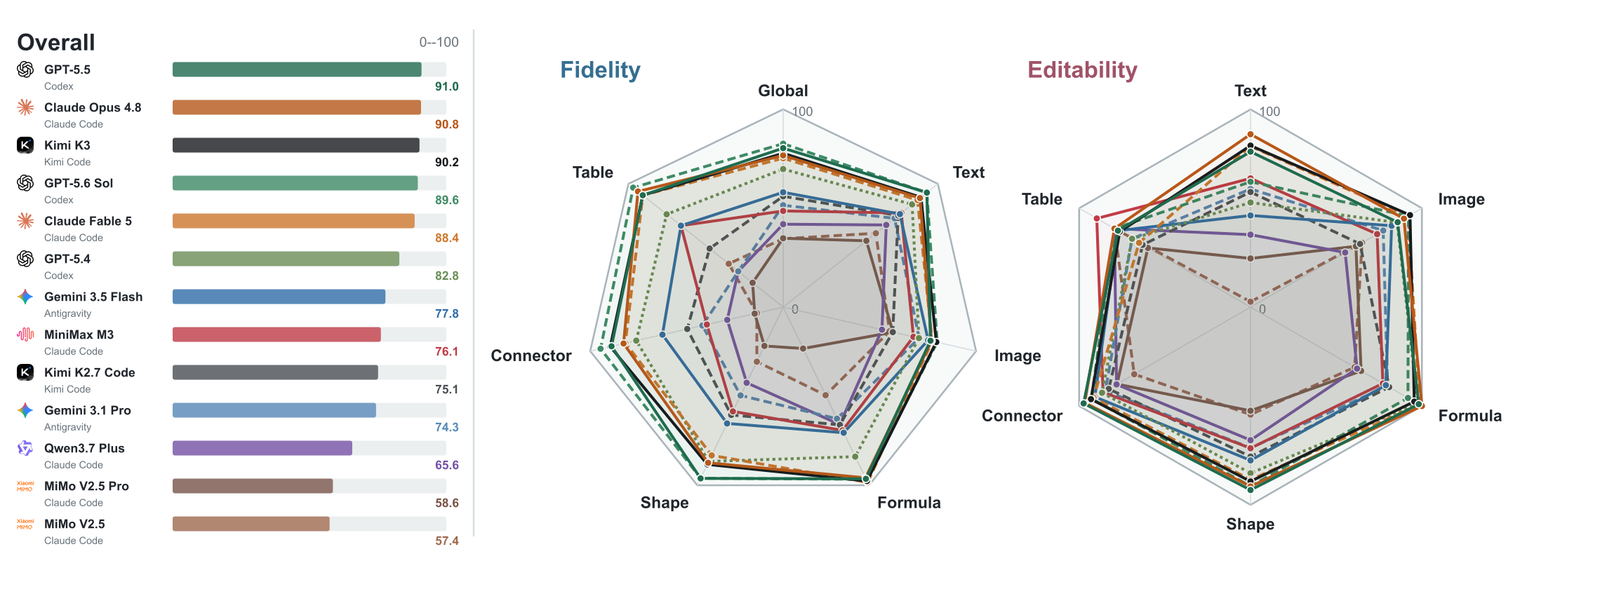
十三款模型大摸底:模型与 Harness 的组合效应
利用 DrawAI-Bench 与 DrawAI-Flow,研究人员对来自 OpenAI、Anthropic、Google、阿里巴巴、MiniMax、月之暗面以及小米等 7 家机构的 13 款前沿多模态大模型展开了系统性评测。为了考察模型本体能力与外围环境设计的各自权重,实验还引入了 Codex、OpenHands、Claude Code、Kimi Code 以及 Antigravity 共 5 种不同的执行框架(Agent Harness),并设置了仅提供原始指令的 Simple Baseline 作为对照。
实验数据揭示出了一系列极具技术价值的行业洞见:
重构质量极其依赖“模型—Harness—工作流”的完整生态耦合,而非单纯取决于底层模型的参数规模。在 DrawAI-Flow 工作流的加持下,各款模型的整体可编辑结构得分相较于简单提示词基线均呈现出显著跨越,这证明结构化任务分解对于代码类与排版类多模态合成具有普遍意义。
在顶尖模型的横向对决中,GPT-5.6 Sol、Claude Fable 5 以及 Gemini 3.5 Flash 展现出了极为出色的综合排版与代码编写能力,不仅在规则评测的几何与文本指标上保持领先,在视觉语言标尺评测中也维持了极高的层级美感。在国模型谱系中,Kimi 系列(特别是 Kimi K3 与 Kimi K2.7 Code)以及 Qwen3.7 Plus 在图表要素提取和特定区域的代码构造上展现了极具竞争力的表现,在与专用 Harness(如 Kimi Code 或 Claude Code 协议)适配时,其长程纠错与代码验证效率甚至接近同级别海外旗舰模型。
在领域差异方面,实验清晰暴露了当前视觉智能体在不同图表形态下的能力天花板。对于流程图、脑图等示意图解(Diagrams),得益于结构清晰和几何图元规整,各大模型的重构表现普遍优异,能轻松实现 90% 以上的原生对象复原;但在学术海报(Posters)领域,绝大多数模型的评分均明显走低,海报往往包含高信息密度的非对称网格、艺术字体与多重重叠视觉特效,目前即便是最顶尖的智能体也会在复杂的层叠顺序(Z-index)和跨栏对齐上出现判断失误,这成为专家评审中唯一平均分未达“直接可用”基准线的领域。
此外,Agent Harness(宿主环境)的选择对最终生成品质起到了不可忽视的决定性作用。相同的模型在不同的工具调用接口和交互协议支持下,可编辑性评分可能产生数个百分点的波动。一个能够敏锐捕捉局部终端报错、提供清晰渲染反馈图并具备低延迟局部替换能力的执行宿主,能够大幅解放模型在代码执行闭环中的自我修复潜力。
迈向真正可用的视觉合成下一站
DrawAI 的研究实践指明了视觉内容生成领域正在发生的一场深刻范式转变:纯粹追求逼真像素的“扩散时代”正在与追求拓扑解耦的“代码与对象时代”加速合流。
未来的视觉智能体若想真正渗透进严肃的生产力场景,就不可能永远停留在输出 PNG 画布的阶段。无论是企业汇报中的即时修改、论文图表的快速重组,还是多源视觉数据的再开发,系统都必须具备穿透像素表象、理解排版骨架并反向编译为底层可编辑代码的能力。
DrawAI-Bench 建立的 39 项双维度混合标尺,首次让“生成成果是否便于人类直接修改”拥有了可量化、可复现的评测公理;而 DrawAI-Flow 所验证的“感知粗筛—策略规划—代码化表示—渲染校验闭环”链路,也为工业界攻克复杂图文排版资产的无损结构化迁移提供了极其清晰的工程范式。当图像不再只是一张封死的静态位图,而是一段段被大模型精准驾驭、随调随改的原生代码时,视觉内容的无缝生产与自由交互才真正拉开序幕。