FinPerMA:阿里提出个性化记忆基准,大模型全上下文准确率不足47%
FinPerMA: A Theory-Informed, Event-Grounded Personalized-Memory Benchmark for LLM Agents
在人工智能助手的演进路线中,个性化长程记忆一直被视为通向真正智能体(Agent)的必由之路。无论是在财富管理、私人医疗还是日常助理场景下,用户往往期待模型不仅能在单次交互中对答如流,更能在跨越数月乃至数年的长期交互中,持续跟踪并动态更新针对个人的理解。然而,当前业界对这一能力的衡量往往停留在“静态事实检索”的浅层水平——模型能记住用户的生日或最喜爱的资产,却很难在真实世界的动态变化中调整对用户的认知。
ArXiv URL:https://arxiv.org/abs/2608.04095v1
来自阿里云(Alibaba Cloud)的研究团队针对这一关键痛点推出了全新基准 FinPerMA。该基准针对金融投资这一高风险、高动态的严苛场景,构建了包含 276 个投资者画像、横跨 2020 至 2026 年 97 个真实经济与生活事件的长程轨迹,并衍生出近 3,000 道测试题。其最具冲击力的实验结论在于:当前包括 Claude-Opus-4-8、GPT-5.6-sol、Qwen3.8 等在内的最顶级前沿大模型,在提供完整历史交互上下文(Full-Context)的理想条件下,整体预测准确率最高也仅有 0.47(47%)左右,选择题表现更是全部卡在 39% 以下;更为反直觉的是,目前流行的诸多专用记忆架构(如 Mem0、MemOS 等)在偏好更新测试中反而显著落后于传统的密集检索系统。这项研究不仅揭开了大模型在“动态偏好演化”上的认知短板,也对 Agent 记忆系统的工程设计提出了深刻反思。
事实记住并不等于偏好理解
要衡量一个 Agent 是否真正具备个性化能力,金融咨询是一个绝佳的试验场。一方面,金融决策充满确定性的外部锚点——例如 2020 年新冠疫情引发的市场暴跌、2022 年美联储剧烈加息周期、2023 年硅谷银行暴雷等,这些事件发生的时间、波及的资产以及对投资者心理产生的冲击在现实中都有迹可循。另一方面,金融领域的个性化并非静止不变的标签:一位用户在 2021 年市场繁荣期可能自称是积极进取的成长型投资者,但在经历多次市场下跌甚至裁员减薪后,其实际风险偏好必然发生偏移。如果大模型助理仍然抱着最初设定的静态画像不放,其推荐的资产组合就很可能带来灾难性后果。
以往的个性化记忆评测往往存在两个显著漏洞。其一是任务设计严重偏向事实性记忆(Factual Recall),例如测试模型能否在几十轮对话后记起“用户的猫叫什么名字”,这类测试本质上是长上下文检索匹配,无法衡量复杂的认知状态迁移。其二是评测样本依赖于无约束的 LLM 自我博弈与自由生成,这导致轨迹中出现大量逻辑不自洽与幻觉,且缺乏确凿的真值标准(Ground Truth),最终让记忆评测演变为大模型生成风格的玄学对比。
FinPerMA 的切入点正是“事件驱动下的偏好自适应”(Event-Driven Preference Adaptation)。研究者认为,衡量个性化记忆的核心,不在于系统能把对话文本原封不动地压缩多小,而在于当外部世界发生重大改变、当用户遭遇重大冲击时,系统能否识别出这一变化,并将新的偏好及时合并进对该用户的底层认知状态中。
理论启发的“三层冲击模型”
为了兼顾数据的可审计性与语言的自然度,FinPerMA 摒弃了纯模型端到端的黑盒生成,构建了一套将行为金融学理论与结构化约束紧密结合的“三层冲击模型”(Impact Model)。
该数据生成流水线分为三个严密递进的层级:
第一层是基于行为金融学规则的确定性约束层(Rule-Based ImpactConstraint)。研究团队参考经典投资心理学理论,首先将用户划分为四大行为投资者类型(BIT,包括保守型、随从型、独立型与激进积累型),并结合五大性格特质(Big-Five)、终身经历沉淀与基于符号记忆的参考依赖机制,构建了一组确定性公式。当特定严重程度的外部事件(涵盖宏观利率变化、行业波动到个人失业或继承遗产等 97 个真实事件)作用于该用户时,第一层模块会通过数学规则,严格计算出该用户在此次冲击下风险偏好的允许漂移方向与数值边界,以及可能触发或禁用的认知偏差。
第二层是受控自然语言叙事层(Constrained LLM Narrator)。在获得第一层的严格硬性约束后,大模型被要求在该边界内撰写候选反应。模型必须输出结构化的 JSON 字段,包括偏好微调的三元组(属性、增量、新值)、内生心理独白(必须引用历史记忆锚点)以及触发的具体偏差。大模型在此充当的是受约束的文学表达者,而非随心所欲的规则制定者。
第三层是自动化多轮校验层(Automated Validator with Retry)。系统在此处设立了严格的代码级硬性检查,严格核验生成的偏好漂移方向是否与理论规则一致、变动幅度是否落在规定公差区间内,以及是否存在被禁用的违规偏差。一旦未通过核验,生成流程将启动多达三次的针对性反馈重试;若依然失败,则回退到理论保底模板。
通过这种“理论规则锚定+受限语言生成+硬约束检验”的三层过滤,FinPerMA 成功将 276 个合成投资者的长期互动轨迹冻结下来,形成了一套具备极高审计性与因果可解释性的基准评测语料(v8gold)。
独创的 Post-Shock 检查点
在测试结构上,FinPerMA 确立了三维评测能力:一是记忆忠实度(Memory Fidelity),即对客观事实与历史行为的准确调取;二是偏好推理(Preference Reasoning),即从隐式行为痕迹中归纳出未明说的风险取向;三是情境自适应(Context Adaptation),即在新遭遇的抉择场景中正确运用更新后的偏好。
与这三维能力正交的,是贯穿时间线的四大评测检查点。除了传统的零记忆对照组、时间线推进中测试和引入无关对话的抗干扰测试之外,研究团队提出了核心机制——冲击后检查点(Post-Shock Checkpoint)。
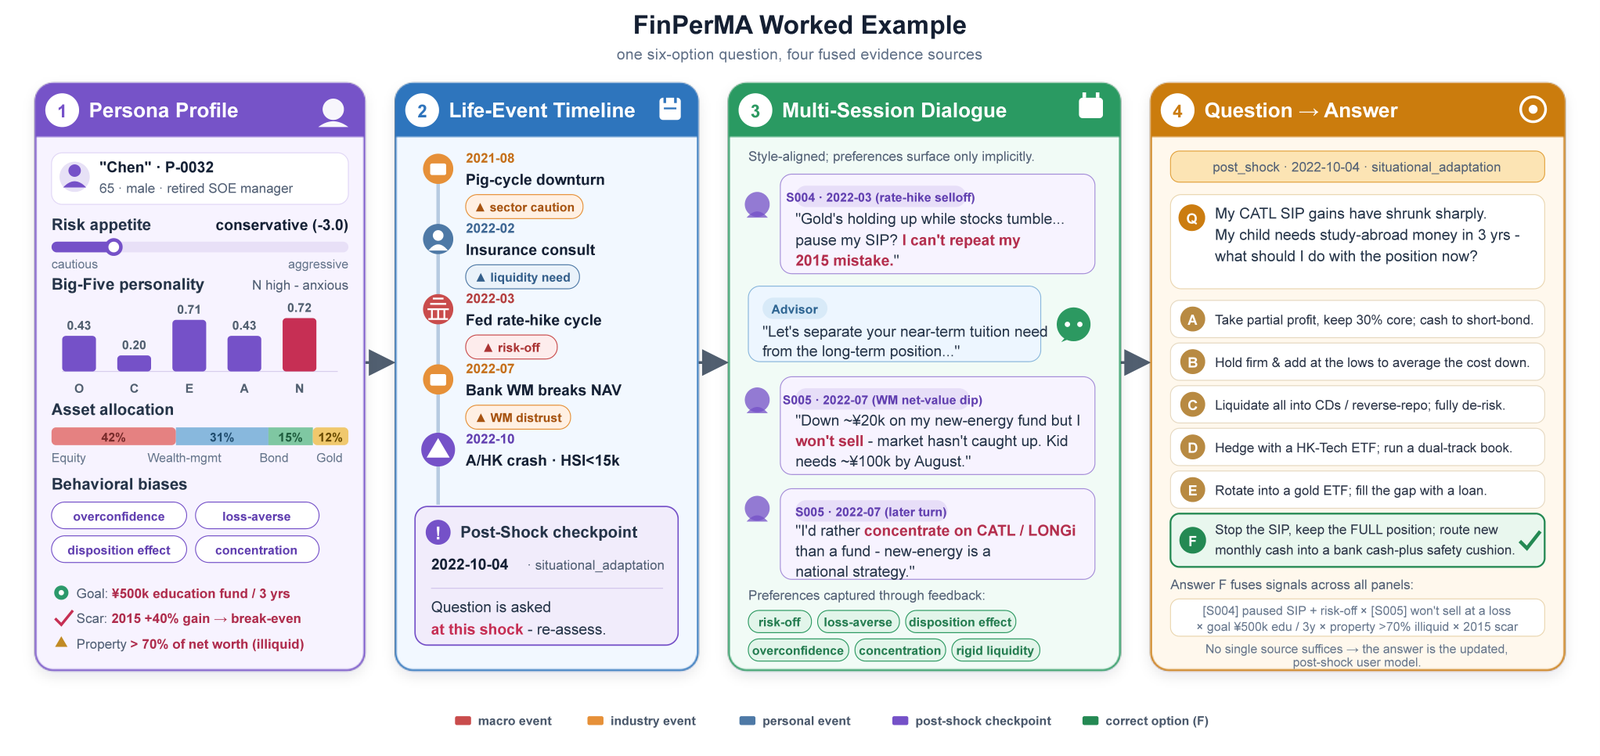
Post-Shock 检查点被专门设置在用户遭遇严重市场或人生震荡之后。在这类题目中,问题往往构建于一个全新的推荐场景,如果模型只记住了用户早期建立的初始画像,它就会做出“看似符合用户设定、实则已严重过时”的错误判断;模型只有成功捕捉到那次关键事件对用户心理防线的重塑,才能选出真正符合当前最新心智模型的决策。上图所示的完整实例展示了这一过程:左侧面板提供了静态画像基线,中上面板展示了贯穿多年的真实经济事件时间线,中下面板展示了多轮隐式交互对话,而右侧面板则设计了具备极高迷惑性的六选一选择题。干扰项在文本长度、表述风格上均与正确答案高度匹配,迫使模型必须结合全部证据链进行深层推理,无法依靠表面字数或虚词套路蒙混过关。
顶级模型全线遇冷:全上下文准确率竟不超 47%
在包含 2,494 道单选选择题与 500 道开放式问答的冻结测试集上,研究团队对 Qwen3.8、Qwen3.7-Max、DeepSeek-V4-Pro、GLM-5.2、GPT-5.6-sol、Gemini-3.1-pro 以及 Claude-Opus-4-8 等当下一线前沿大模型进行了全面摸底。
评测展现出的第一个关键结论是:个性化历史输入能带来显著增益,但当前模型离“解决”该问题极其遥远。在完全不给历史对话的零记忆(no_memory)对照下,所有模型的整体准确率徘徊在 0.18 至 0.27 之间,选择题表现几乎等同于六选一的随机乱猜(0.17~0.26)。当给足全部历史对话作为上下文(full_context)后,模型的准确率普遍提升了 1.5 至 2.4 倍,这证明历史信息确实被有效摄入;然而,即便处于性能顶点的 Qwen3.8,其全上下文综合准确率也仅达到 0.469(46.9%),而没有任何一个模型能在选择题单项上突破 39% 的大关。这一极其低迷的分数表明,现存的前沿基座即便在上下文窗口充足的情况下,面对复杂的长周期心智跟踪依然力不从心。
更细致的分析表明,没有任何一款基座大模型能在所有能力维度上实现全面统治:Claude 在事实回忆与因果推理上拔得头筹,Qwen3.8 在偏好跟踪与情境自适应中领跑,而 Gemini 则在跨领域迁移上更具优势。通用基座的整体跑分优势,无法直接线性平移为更加稳健的个性化长程记忆能力。
为什么专用记忆架构反而输给了朴素检索?
如果说基座大模型的能力天花板尚在预料之中,那么在同一基座(Qwen3.7-Max)下横向对比多种不同记忆框架时,实验得出了更加颠覆工程直觉的现象。
当前业界在构建长记忆 Agent 时,普遍推崇专用记忆系统,如基于抽取与画像构建的 Mem0、操作管理型的 MemOS,以及各类基于摘要机制的 Profile 系统,试图摆脱长文本 Token 消耗过大的困境。然而,FinPerMA 的实测数据给这种技术路线泼了一盆冷水:
-
传统的密集检索与混合检索方案(如基于 BGE-M3 的 bge_rag 或 BM25 的 naive_rag)能够挽回约 88% 的性能差距(即相对无记忆与全上下文差距的恢复比率);
-
相比之下,结构化/画像类的专用记忆系统仅能挽回 54% 至 79% 的差距,在综合准确率上被简单检索全面压制。
这种性能鸿沟在开放式问题和关键节点上表现得尤为剧烈。深入的归因分析揭示了背后残酷的机理:现有的专用记忆框架在进行跨会话整合与信息提炼时,往往对“客观事实”展现出极佳的保真度,却几乎无情地抹杀了潜藏在字里行间的“偏好线索”。
在数据细分中,MemOS 这类系统在事实回忆(Factual Recall)上的准确率可以与全上下文打得有来有回(27.7% 对比 27.1%),但在偏好跟踪(Preference Tracking)维度上直接遭遇滑铁卢(31.9% 对比 52.9%),在偏差识别上同样从 54.0% 暴跌至 32.6%。这是因为摘要算法在抽取信息时,天生更容易将“用户在某年某月购买了某款理财”作为事实记下,而将用户在面对市场剧烈动荡时展现出的犹疑、恐慌情绪、追问频次等非结构化隐式偏好视为冗余废话过滤掉了。
这种缺陷在 Post-Shock(冲击后检查点) 下被成倍放大。在常规的时间线内部,全上下文与 Mem0 的差距仅有 8 个百分点(53.4% 对比 45.4%);但一旦来到外部环境剧变、迫切需要覆写旧有心智模型的 Post-Shock 节点,二者的差距瞬间拉大到 13 个百分点(51.9% 对比 38.9%)。专用记忆系统因为过早地将用户固化为一个结构化的陈旧标签,在面对冲击事件带来的剧烈状态转移时,无法调取出原汁原味的对话细节,最终导致认知更新严重滞后。
当然,结构化记忆并非一无是处。在 Token 消耗效率上,专用记忆系统展现出了极致的工程经济性。BGE 检索仅需 1.4k Token 就能达到全上下文 12.8k 接近 88% 的效果,而 Mem0 的单次查询 Token 消耗更低,具备最高的单 Token 准确率转化收益。但在当前这个追求高精度与安全可控的决策领域,低成本的代价是丧失了对用户深层心理演变的敏锐感知。
刻板印象陷阱与对未来 Agent 架构的启示
除了偏好丢失问题,FinPerMA 还揭示了一个隐藏在所有前沿模型深处的共性弱点:对“反典型画像”(Anti-typical Personas)的泛化崩溃。
在实际生活中,许多投资者的性格与行为并非教科书式的标准画像。比如一个在问卷测试中风险承受力极低、平日表现极度保守的人,可能会因为早年在科技行业尝到甜头,而在某一个特定赛道上表现出高度激进的非典型重仓倾向。实验发现,当面对这类与社会常规模板冲突的“反典型用户”时,所有参评大模型的准确率普遍出现了 4.5 到 11.2 个百分点的断崖式下跌。
对错误选项归因的“指纹分析”表明,模型的前三大主要错误根源分别是:直接回落到无记忆的默认先验(Zero-memory default)、基于单一孤立信号过度推断(Single-signal over-inference),以及时间维度的错位混淆(Temporal misalignment),这三者合计构成了约 66% 的错误来源。当历史证据庞杂且存在内在张力时,大模型展现出了强烈的“偷懒”倾向——它宁愿依赖预训练阶段学到的群体刻板印象去猜答案,也不愿通过检索和比对具体上下文,让个性化的反常识事实去覆写通用的刻板认知。
FinPerMA 的测试结果为下一代大模型个性化记忆系统的构建指明了极其务实的演进路径:
-
摒弃单一维度的黑盒文本摘要:简单的 LLM 摘要会迅速抹杀细微的偏好信号与情绪线索。未来的长期记忆系统必须采用混合架构,明确区分“稳定的静态属性”(如合规限制、基础偏好)与“易变的心智状态”(如经历冲击后的即时风险容忍度),并对每一处状态变更赋予严密的时间戳索引。
-
原始对话切片与抽象标签的协同召回:仅存储抽取后的标签是致命的。系统必须在保留结构化心智模型的同时,保留支持该模型发生转移的原生对话上下文证据链。当面临重大事件决策时,必须通过检索唤醒当时对话的原貌,而不是仅凭一个压缩后的二阶摘要进行模糊决策。
-
引入抗刻板印象的主动校验机制:针对反典型画像的普遍失效,Agent 记忆模块需要在决策闭环中加入自我对抗审核——明确检验当前的推荐依据究竟是来自针对该特定用户的独特历史证据,还是仅仅滑向了模型参数内在的通用群体模板。
FinPerMA 的价值,不仅在于给行业提供了一个包含近三千道硬核测试题的评测基准,更在于它用确凿的数据打破了“长上下文和高频摘要已解决 Agent 记忆问题”的虚假繁荣。在构建真正具备长期共情与连续适应能力的 AI 助手的道路上,大模型才刚刚跨过事实检索的起点,而如何捕捉人类在真实世界波澜中的偏好流变,依然是一个远未被攻克的艰难命题。