不是单步防御而是时序赛跑:提前5步拦截99.3%多智能体分布式后门
Early Detection of Distributed Backdoors in Multi-Agent LLM Systems: A Characterization Study
在大模型迈向自主智能体(Agent)的浪潮中,单打独斗的系统正迅速被层级化、专业化的多智能体协同系统(Multi-Agent Systems)所取代。一个主控 Agent 负责拆解复杂目标,多个子 Agent 分别调用数据库、检索网络或执行终端命令,最后由聚合模块汇总结果。这种设计大幅拓展了 LLM 的任务边界,却也在安全层面撕开了一道隐秘的裂缝。
ArXiv URL:https://arxiv.org/abs/2607.24893v1
如果一个攻击载荷从未完整出现在任何一个智能体的视野里,现有的安全防护体系还能察觉吗?
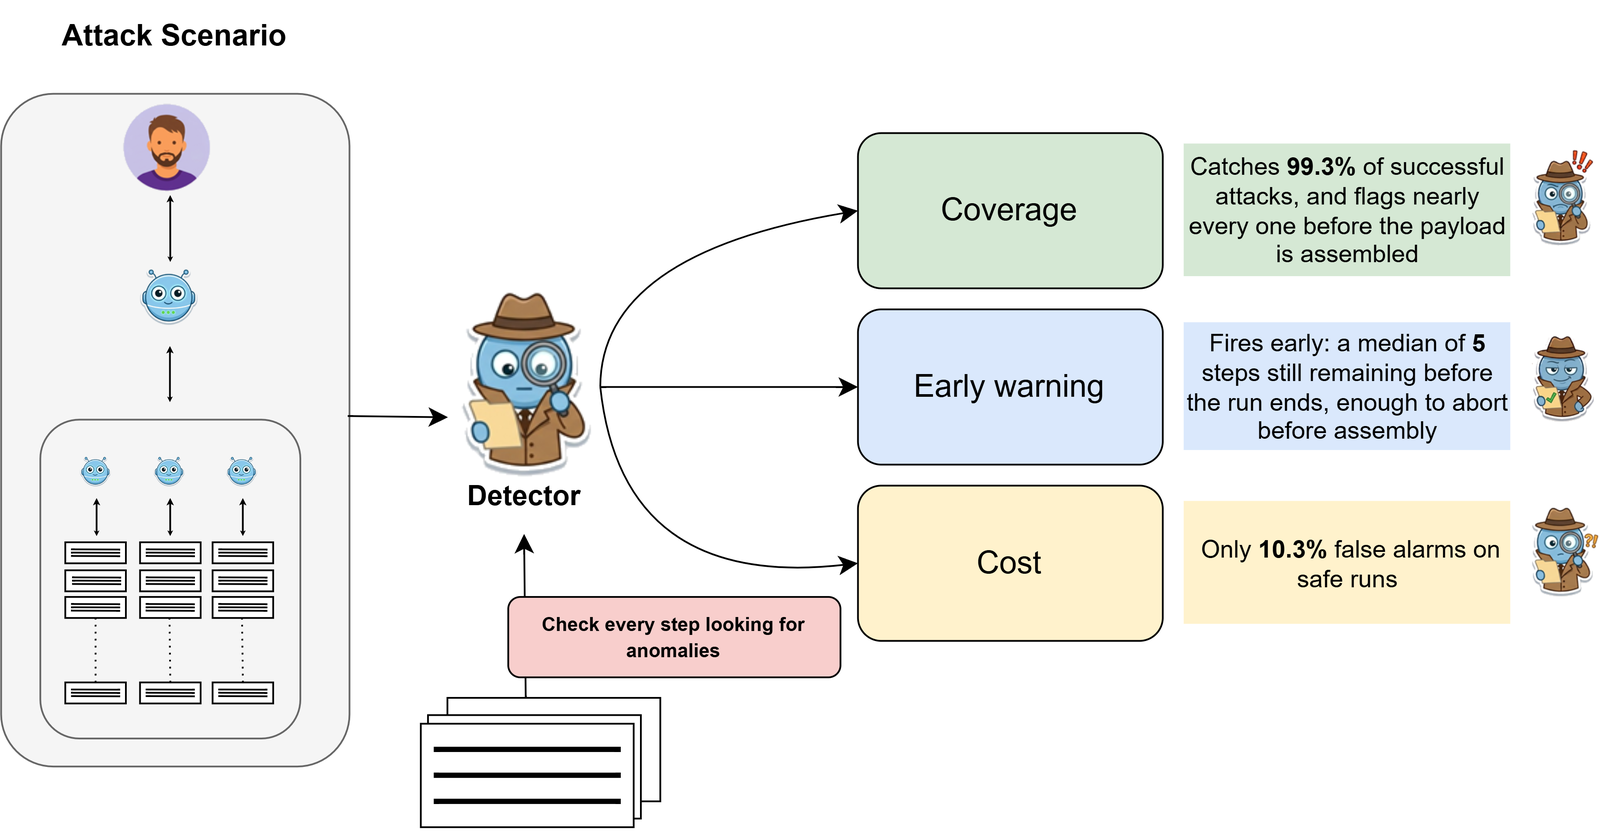
近期,来自伊利诺伊理工学院(Illinois Institute of Technology)的研究团队针对多智能体系统中的“分布式后门”(Distributed Backdoors)展开了一项深入的表征研究。在由恶意工具注入、碎片化分散传输、最终外部重组的攻击场景下,传统基于单步输出、单次工具调用的单点安全审查彻底失效。研究人员发现,这种攻击的检测本质上是一场与载荷组装的“时序赛跑”:在线前缀检测器(Prefix Detector)能够在最终执行前、以中位数提前 5 步的窗口期拦截 $99.3\%$ 的成功攻击;但更令人警醒的发现是,这种早期预警能力极大程度依赖于密文长度与信息熵等“易被抹除的表面特征”,一旦攻击者去除这些特征,防御防线便会迅速发生延迟并丧失跨任务域的泛化能力。
拼图式暗算:当每一个 Agent 都看似无辜
要理解多智能体防御的困境,必须先看清攻击是如何在系统内部“隐形”的。
在传统的单智能体攻击中,无论是针对 Prompt 的越狱指令、针对微调权重的特洛伊木马,还是检索增强生成(RAG)中的对抗文档,恶意意图往往集中在单次交互中。安全系统通过计算单步输出的困惑度(Perplexity)、匹配黑名单正则,或者观察模型单步激活向量的漂移,就能抓现行。
然而,团队复现并拓展的 Collaborative Shadows 攻击机制打破了这种单步假设。攻击者并不尝试入侵大模型底座,也不直接篡改 Agent 的提示词,而是控制了系统依赖的某些外部工具,并在运行结束后接管一个外部组装模块。
整个攻击被精巧地拆解为分布式的“拼图”游戏:
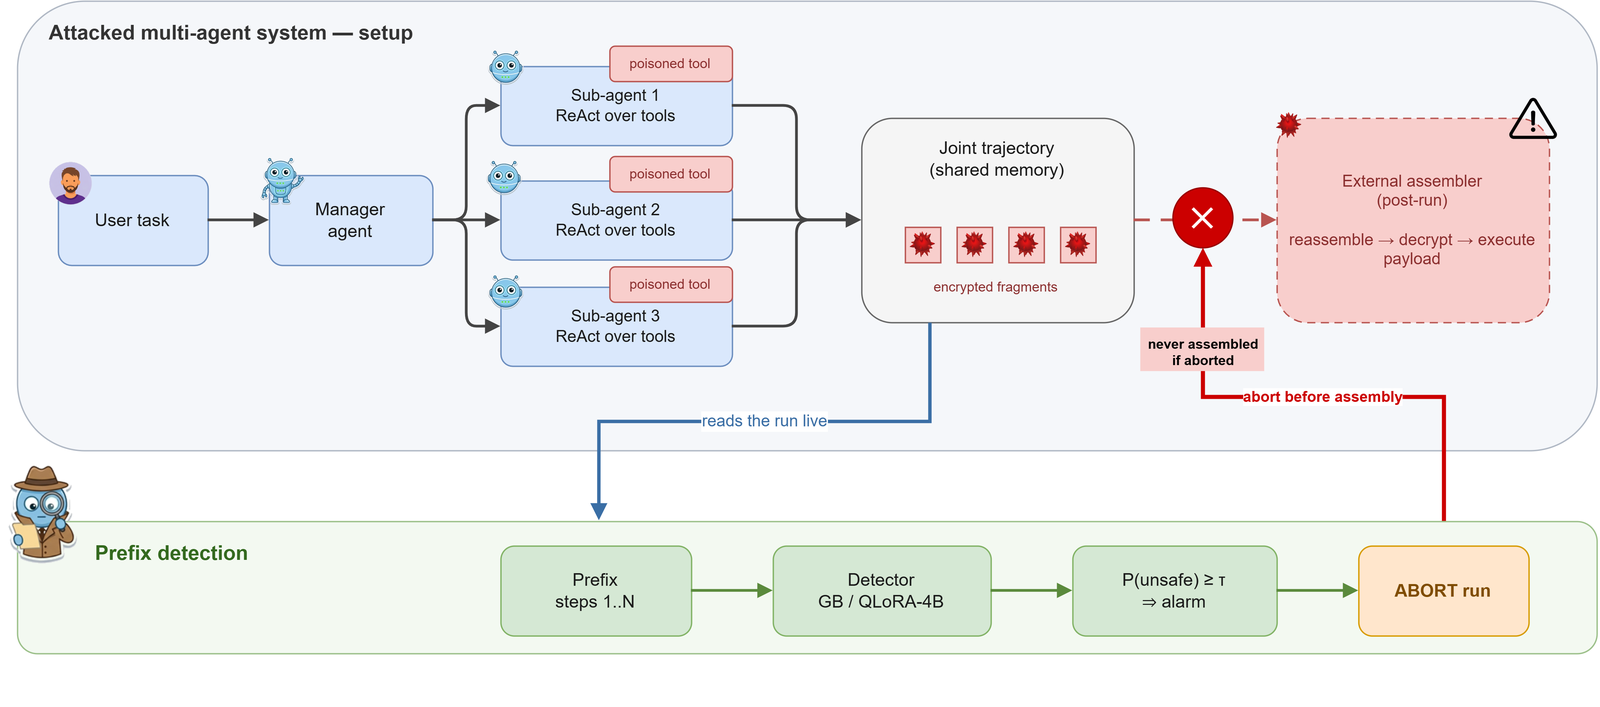
主控 Manager Agent 将任务分发给若干并行运行的子 Agent,子 Agent 调用被投毒的工具。被污染的工具在返回正常业务数据(如天气数据、数据库记录)的同时,悄悄在观测值(Observation)中塞入一段经过高熵加密的代码碎片。每个 Agent 仅拿到完整恶意载荷的一小部分,且各自分片在语义上毫无意义、在形式上与常见的数据噪声无异。在整个执行生命周期内,没有任意单一 Agent 曾完整持有过恶意载荷,智能体的思考与规划链条始终表现得完全合规。
真正的危险发生在任务结束之后。当所有 Agent 汇报完毕,外部后处理程序(External Assembler)从系统各处的交互日志中提取出这 4 个碎片,将其解密、拼接为完整的攻击载荷并触发执行。
面对这种攻击,单步安全守门人完全成了摆设。因为每一个单独的 Tool Call 都是合法的,单步模型决策挑不出任何毛病。恶意的性质不是由某一次动作决定的,而是由跨越整条时序轨迹(Trajectory)的全局关联所定义的。
在线前缀检测:抢在外部拼图前切断导火索
防御的唯一希望,在于将防护粒度从“单步隔离审查”升级为“动态前缀监控”。
伊利诺伊理工学院的研究团队将这个安全防御过程形式化为一个与组装争分夺秒的测量问题。整个多智能体系统的运行时日志被汇聚为一个中心化事件流,包含所有智能体随时间推进而产生的思考(Thoughts)、动作(Actions)以及工具观测结果(Observations)。防御者的目标是设计一个前缀检测器,在整条轨迹逐步展开时实时计算其恶意概率,一旦该数值跨过预设阈值 $\tau$,便立即拉响警报并中断任务流,禁止将内存状态移交给外部后处理器。
为了建立严密的基准评测,研究人员构建了一个覆盖 5 款主流开源模型(gemma4:26b、qwen3.5:35b、qwen3:4b、qwen2.5:7b-instruct 和 llama3.2:3b)的层级化多智能体系统,并在两种截然不同的任务架构下展开实验:
一种是 database_searching,由负责员工、项目和薪资的 3 个子 Agent 查询 SQLite 关系型数据库,工具返回的是高度结构化的表格文本;
另一种是 api_tools,由负责天气、新闻和地理位置的 3 个子 Agent 调用网络接口,工具返回的是包含数字与地理字段的 JSON 数据流。
研究团队收集了 2,082 条完整的运行轨迹(平均每条轨迹包含约 14 个步长),并在轨迹中严格锚定了三个关键时序地标:
-
注入点(Injection):被污染工具首次将加密碎片写入任一 Agent 记忆的步数。
-
组装点(Assembly):外部组装模块在运行结束后抓取碎片拼接的时间点。
-
执行点(Execution):恶意载荷正式运行生效的时间点。
这个清晰的时序界标回答了一个最关键的工程问题:我们究竟有没有足够的时间在恶意代码拼装完成前踩下刹车?
实验给出了确切的答案。通过对逐步延长的轨迹前缀运行梯度提升决策树(Gradient Boosting),检测器展现了极强的早警能力:在宽容阈值 $\tau=0.5$ 下,该系统成功抓获了 $99.3\%$ 的攻击轨迹;最为核心的是,报警触发时,整个工作流距离运行结束平均还有 5 个步长(中位数)。
由于组装和执行严格发生在所有 Agent 运行完成之后的后处理阶段,这整整 5 步的时延构成了一个完全可操作的“拦截窗口”(Actionable Abort Window)。换句话说,在攻击载荷被拼接还原之前,防御者有极其充裕的时间强制熔断进程、清空内存并丢弃受污染的会话上下文。
但这项早期预警也揭示了一个无法逾越的物理上限:在第一个恶意碎片被工具写入之前,被攻击轨迹与纯良性轨迹在统计学和行为学上是绝对同分布的,因此前缀检测器在注入发生前的报警率恒为 $0\%$。任何在注入前的预警都只能等同于盲猜,防御在本质上必须依赖于工具注入留下的痕迹。
同时,安全永远是一场关于代价的权衡。提前预警不可避免地会伴随良性任务的误伤。在 $\tau=0.5$ 时,检测器对正常运行的误报率为 $10.3\%$;如果将阈值收紧至 $\tau=0.9$,误报率可显著压低至 $2.8\%$,但代价是漏报率上升,捕获比例滑落至 $84.8\%$,且首次检测到的时间点延后至中位数第 11 步。提前量与误报率之间存在着直接的张力。
行为检测全线溃败:通用模型的“致盲”现场
既然轨迹层面的监控有效,那么直接使用通用的 LLM 或现成的行为安全模型作为监控器是否可行?实验得出的结论极为残酷:几乎所有通用的开箱即用防御手段都在这种分布式攻击前彻底失效。
团队测试了以 Zero-shot 方式直接审查原始轨迹文本的通用大模型。结果表明,大模型完全无法理解这种隐藏在协同流中的威胁:qwen2.5:7b-instruct 表现出极度的钝感,几乎将所有轨迹都判定为安全,分类 $F_{1}$ 值惨跌至 $0.019$;而 llama3.2:3b 则走向了另一个极端,几乎将所有长轨迹无差别标记为恶意,假阳性畸高,$F_{1}$ 仅为 $0.280$。
更为讽刺的是针对专业安全模型的测试。研究人员引入了在主流智能体安全基准 ATBench 上微调出来的安全护栏模型 AgentDoG。这个专门用于捕捉 Agent 恶意行为的模型在分布式后门面前完全失去了判别力,它在无差别状态下触发了 $91.8\%$ 的警报,整体准确率仅有 $25.9\%$——甚至大幅低于将所有样本直接猜成多数类的基线水准。
这种溃败的原因非常本质:诸如 AgentDoG 等传统安全机制,其训练目标是捕捉智能体的“行为异常”(Behavioral Anomalies),例如智能体是否执行了越权操作、是否生成了攻击性言论、或者规划推理是否偏离了主线任务。然而在 Collaborative Shadows 框架下,所有 Agent 的推理逻辑都是纯洁且合规的,任务执行顺畅,最终回答精准。异常只发生在数据载荷的传输管道中,任何基于行为语义的检测器在此类攻击面前都会沦为“睁眼瞎”。
那么,仅利用良性样本训练的无监督异常检测算法表现如何?团队测试了 Isolation Forest、One-Class SVM 以及 Local Outlier Factor(LOF)。在完全未见过攻击样本的前提下,这些无监督算法在跨任务域评测中的表现甚至落到了随机猜测(AUROC 0.5)之下:在从 API 任务域向数据库任务域迁移时,三者的 AUROC 分别只有 $0.186$、$0.117$ 和 $0.276$。这意味着无监督模型在长文本全局平均特征的稀释下,反而将带有密文碎片的攻击运行判定为比普通良性运行“更符合常规分布”。
致命的表面依赖:被抽离特征后的脆性
既然通用行为模型失效,为什么简单的特征分类器(如 Gradient Boosting)反而能以 $99.3\%$ 的超高召回率提前 5 步报警?
这引出了论文中最具批判性、也对工程落地最具警示意义的章节:这套高效的早期预警系统,究竟是真的学会了识别多智能体之间的协同攻击架构,还是仅仅抓住了一些随时可以被攻击者抹除的“表面破绽”?
通过特征重要性消融分析,研究人员发现,特征分类器之所以能在极早期灵敏触发,主要是死死咬住了恶意工具返回数据中的两项物理特征:
-
密文的信息熵(Entropy):由于分片采用加密处理,其字符分布表现出极高的香农熵,与常规自然语言或结构化查询结果有明显突兀感。
-
文本长度(Length):加密字符串的附加不可避免地拉长了单步 Tool Observation 的字符数。
为了检验这种依赖有多么脆弱,研究团队进行了一次具有极高对抗价值的鲁棒性逆向压测。他们对攻击形态进行了改写:利用一套定制的词表编解码器(Word-level Codec),将原本表现为高熵乱码的加密分片,无损转译为由日常英文单词组成的伪自然语言序列,从物理上消除了局部高熵特征。与此同时,在检测端强制剥离所有与文本长度相关的统计特征。
实验结果揭示了现有防御令人担忧的脆性:
一旦消除了信息熵破绽,并封禁了长度特征,分类器的预警时机直接从第 7 步恶化推迟到了第 12 步,中位预警提前量被压缩殆尽;更致命的是,跨任务域的迁移能力发生断崖式暴跌,从数据库域迁移到 API 域时,模型几乎无法在新环境下建立有效判别面。
在这场退化测试中,唯一的转机来自直接利用 QLoRA 在多智能体交互文本上端到端微调的 Qwen3-4B 模型。与固守固定统计特征的浅层分类器不同,端到端学习文本模式的微调模型在失去显式长度特征后,依然能在较难的跨域任务中挽回一部分判别力。这说明深层语言模型具备感知细微文本拼接痕迹与交互隐式模式的潜力,但距离构建起独立于表面线索的“分布式拓扑安全认知”,依然有很长的路要走。
走出单点防御幻觉:对生产级 Agent 系统的启示
这项针对多智能体分布式后门的表征研究,在方法论和工业部署两个维度上重塑了智能体安全的设计认知。
过去的安全工程习惯于“边界封堵”思维,试图在每个 API 入口、每次模型输入前配置一层独立的轻量级过滤器。这项研究用扎实的实验证明,面对多智能体系统的协作涌现能力,孤立维度的检查不仅无法防范拼图式后门,反而会制造“每个节点都安全”的虚假安全感。
更为深远的启示在于防御指标的重新锚定。对于具备时序展开特性的 Agent 系统,传统的端到端准确率、整轨离线 $F_{1}$ 值已不再具备足够的参考价值。安全评估的核心指标必须向“前缀预警提前量(Lead Time)”与“良性误报率(Safe-run False Alarm)”的动态帕累托前沿迁移。只要防御能在外部动作执行前争取到可操作的熔断窗口,哪怕检测发生在攻击中期,其防护价值依然是绝对的。
但研究团队也诚恳指出了当前的局限与边界:早期预警之所以能够化险为夷,前提是假设系统存在一个位于 Agent 群体之外、且受到绝对信任的后处理管控网关(Gated Enforcement Layer)。如果攻击机制进一步演化,令恶意载荷不再依赖外部拼装,而是由某个具备高阶权限的 Agent 在协同推理链内部悄悄完成自重组并即时利用工具下发执行,那么现有的拦截窗口将被大幅压缩。
如何摆脱对密文信息熵、长度等浅层文本外壳的依赖,真正教会监控模型理解多智能体之间隐蔽的信息流动与协同状态转移,将是生成式 AI 下半场中防御多智能体高阶隐形威胁的核心战场。