ESTR:用熵缩放驯服异步RL脱靶偏差,提速2.6倍且效果比肩同步GRPO
Deconstructing Off-Policy Ratios: Entropy-Scaled Trust Regions for Asynchronous Reinforcement Learning
在大模型后训练(Post-training)向长链条推理与复杂智能体(Agent)演进的进程中,强化学习(RL)的算力瓶颈愈发突出。传统的同步强化学习(如同步 GRPO)中,策略模型的采样生成与梯度反传是串行交替进行的。长程任务动辄包含数千甚至上万个 Token 的多轮交互与工具调用,这导致计算节点在等待生成时产生大量流水线气泡,昂贵的 GPU 集群算力利用率低下。
ArXiv URL:https://arxiv.org/abs/2607.22186
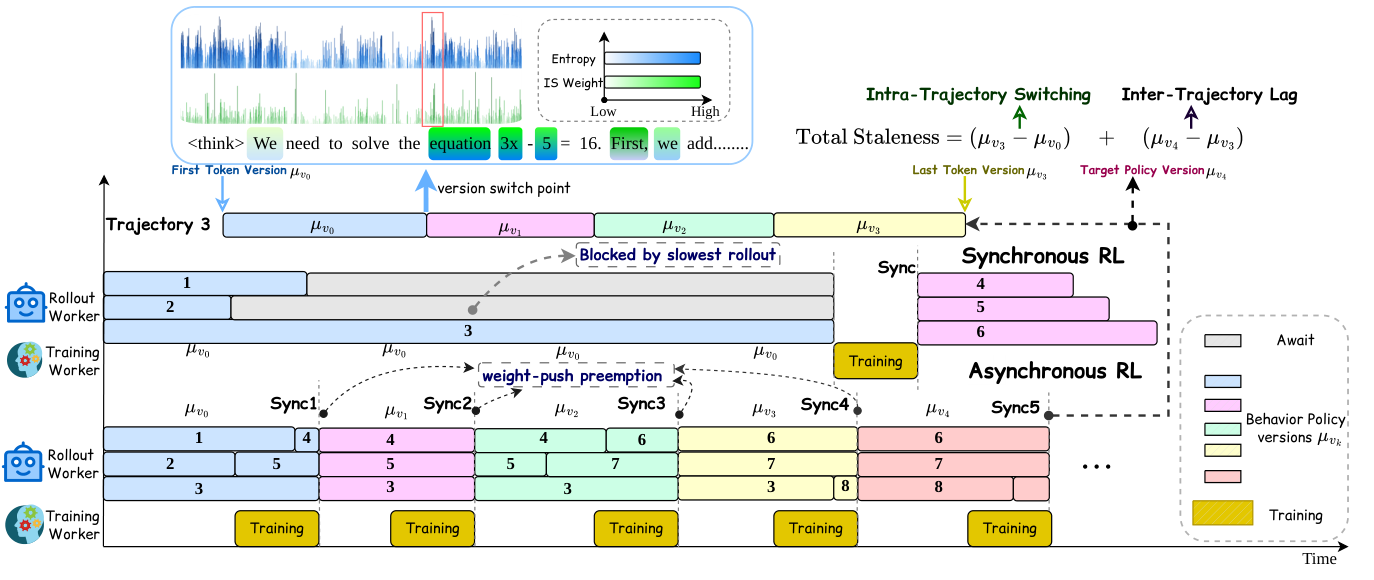
为了彻底消除等待气泡,工业界与前沿研究正在加速转向异步强化学习(Asynchronous RL):轨迹生成与参数优化被解耦到不同的节点池中并行推进。这种并行化虽然能将训练吞吐量提升数倍,却破坏了在策略(On-policy)学习的核心假设。当优化器更新参数时,采样端送来的样本往往来自几个版本之前的旧策略;更棘手的是,在单次极长的多轮采样过程中,模型参数可能已被更新过多次,导致一条生成轨迹内交织着不同版本的权重。这种严重的策略脱靶(Off-policy)与版本撕裂,极易注入高方差的错误梯度,引发不可逆的策略崩溃(Policy Collapse)。
以往针对异步 RL 不稳定的解决方案,多集中在对重要性采样比率(Importance Sampling Ratio)进行固定区间的硬截断或掩码剔除(如 IcePop、KPop 等)。这项最新研究指出,重要性比率的天然波动幅度在本质上由 Token 的局部熵(Entropy)决定。对所有位置一刀切地采用固定阈值,会导致模型在确定性极高的低熵位置放行被放大的数值噪声,而在充满可能性的高熵位置扼杀模型探索未知的有效更新。为此,研究者提出了熵缩放信任域(Entropy-Scaled Trust Region,简称 ESTR),根据每个 Token 位置的局部熵自适应地伸缩信任边界。在 BrowseComp-Plus 长程检索智能体与 AIME 高难度数学推理等基准上,ESTR 不仅彻底解决了异步训练的崩溃隐患,更在训练吞吐量相比同步 GRPO 提速 2.6 倍的前提下,实现了不分伯仲甚至更优的任务准确率。
一刀切阈值的失效根源:重要性比率与熵的天然绑定
现有稳定异步 RL 的主流思路,通常依赖对重要性采样比率 $r_t = \pi_\theta(y_t \mid s_t) / \mu_t(y_t \mid s_t)$ 进行监控。如果其对数比率 $\lvert \delta_t \rvert = \lvert \log r_t \rvert$ 超出预设的固定常数范围,就将该 Token 截断或直接置零掩码。这种设计隐含了一个未经审视的假设:比率的大小纯粹反映了策略漂移的严重程度,因此阈值可以在整个序列乃至不同生成状态间全局共享。
然而,对真实模型采样分布的细致拆解推翻了这一假设。通过在大规模长程轨迹上统计对数重要性比率 $\lvert \delta_t \rvert$ 与行为策略熵 $H_t$ 的联合分布,作者发现二者之间存在着严格的统计相关性。在局部 Logit 扰动模型下,对数重要性比率的二阶条件矩近似正比于局部熵的大小:
\[\mathbb{E}[\delta_t^2 \mid H_t \in \mathcal{B}] \approx a_t H_t\]这意味着重要性比率的方差并非位置同质的(Homoscedastic),而是随着当前预测状态的不确定性动态变化的(Heteroscedastic)。这一特性在异步训练的动态环境下催生了截然相反的两类现象。
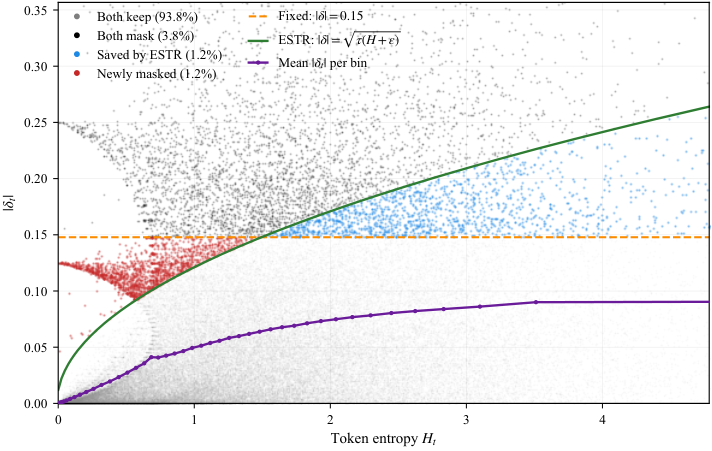
第一种现象出现在高确定性的低熵区域。当模型对某个 Token 极其笃定时,词表内绝大部分候选词的采样概率趋近于零。在实际训练中,硬件浮点精度差异、推理量化引擎与训练框架之间的微小系统差距,会产生极轻微的 Logit 扰动 $\xi$。对于一个输出概率极小的尾部候选 Token,其比率方差与 $1/q^2$ 同阶:
\[\mathbb{E}[\delta_t^2 \mid q] \propto \frac{1-q}{q} \xrightarrow[q\to 0]{} \infty\]当概率 $q \to 0$ 时,局部二元熵 $H(q) \to 0$,但该比率的期望方差却会发散。换言之,在几乎没有信息增量的低熵位置,极其微小的数值扰动都会被倒数关系数倍放大,形成数值巨大的离群比率。这些离群值本质上只是浮点与系统差异催生的伪采样噪声,与模型真实的策略漂移无关。采用全局固定截断阈值的方法,很容易在这些低熵点将虚假的大比率视为“合法”,进而让带有高方差的无意义噪声梯度污染优化过程。
第二种现象则发生在高熵区域,并与异步环境特有的时序现象深度绑定。
轨迹内版本切换:被误杀的合法探索
在传统的异步强化学习理论探讨中,学术界通常将“过时性(Staleness)”简单理解为轨迹级的时间滞后。研究者一般假设一条完整的生成轨迹来自某一个相对固定的旧权重版本,当前正在优化的网络则处于最新版本。然而在长上下文、多轮工具交互的复杂 Agent 场景中,单条样本的生成时间可能持续数十秒乃至更长。
在此期间,参数优化器一直在高频迭代。这就导致单个生成任务在执行中途,其底层权重可能已被同步更新了数次。作者将这种异步总延迟分解为两个正交维度:
\[\Delta^{\mathrm{intra}} \triangleq v_{\mathrm{last}} - v_{\mathrm{first}}, \qquad \Delta^{\mathrm{inter}} \triangleq v_{\mathrm{tgt}} - v_{\mathrm{last}}\]其中 $\Delta^{\mathrm{inter}}$ 是传统的轨迹间滞后,而 $\Delta^{\mathrm{intra}}$ 则是此前极少被形式化讨论的轨迹内版本切换(Intra-trajectory Version Switching)。当推理引擎在生成第 $t$ 个 Token 瞬间拉取了最新权重,模型对后续走向的理解会骤然发生阶跃。这种中途换脑的过程,会在版本切换点处同时引发局部熵 $H_t$ 与对数比率 $\lvert \delta_t \rvert$ 的同步激增。
从强化学习的角度来看,这种由权重更新所触发的高熵大比率,恰恰是策略模型在面对未知分支时的关键探索信号。此时模型正在尝试评估新策略相对于旧策略的优势区间。但传统的固定截断阈值由于无法识别这一物理过程,只会机械地判定该位置的比率偏离过大,直接通过掩码将这些 Token 的梯度抹除。
这就构成了一个致命的结构性错位:基于固定大小的截断机制,在低熵处毫无防备地吸纳了被数值放大的采样噪音,却在高熵处粗暴地扼杀了模型依赖中途参数更新所驱动的合法探索行为。
ESTR:构建与熵动态适配的二阶置信域
认识到重要性比率的自然波动包络线是由局部熵决定的之后,解决方案的技术路径变得十分清晰:不再对原始偏差设置固定预算,而是将偏差约束在其自身的自然尺度之内。
在策略空间中,当优化目标 $\pi_\theta$ 与行为策略 $\mu_t$ 相对接近时,每个 Token 上的 KL 散度可以通过二阶泰勒展开近似表示为对数比率平方的期望:
\[D_{\mathrm{KL}}(\mu_t \,\|\, \pi_\theta) \approx \frac{1}{2}\,\mathbb{E}_{v\sim\mu_t}\left[\delta_t(v)^2\right]\]这意味着,为离线策略设置置信域,本质上是在约束对数比率的二阶矩。既然已知二阶矩在自然状态下正比于局部熵,即 $\mathbb{E}[\delta_t^2] \approx \sigma_t^2 H_t$,那么一个统计上自洽的置信域,就必须利用局部尺度因子 $\nu_t \triangleq H_t + \epsilon$(其中 $\epsilon > 0$ 为防止除零与数值溢出的平滑项)对原始偏差进行标准化:
\[z_t \triangleq \frac{\delta_t}{\sqrt{H_t + \epsilon}}\]经过局部熵标准化后,归一化偏差的方差将在全序列范围内恒定在 $\sigma_t^2$ 左右,消除了由于位置状态不同而带来的异方差干扰。基于此,ESTR 定义了熵缩放评分(Entropy-Scaled Score):
\[S_t \triangleq \frac{\delta_t^2}{H_t + \epsilon}\]当且仅当 $S_t \le \tau$($\tau$ 为给定的容忍预算)时,该 Token 才会参与梯度的反向传播。将其还原到原始比率的尺度上,等价于为每个 Token 动态施加了一个随熵变动的非线性接受边界:
\[\lvert \delta_t \rvert \le \sqrt{\tau(H_t + \epsilon)}\]这个极简的解析边界展现了优异的自适应行为:
在低熵区($H_t \to 0$),接受边界收紧至极狭窄的阈值 $\sqrt{\tau \epsilon}$,前述因为极低概率放大而产生的浮点与采样噪声会被严厉阻截;而在高熵区($H_t$ 较大),接受边界随着熵的增大平滑扩张,为轨迹内权重切换激发的探索性偏差留出充足的容纳空间。
在工程实现上,ESTR 的优势同样突出。与那些需要多次前向推理重新构建行为策略、或者需要修改底层通信协议以实时捕获版本切换信号的复杂方案相比,ESTR 只需要在生成端前向计算时直接读取当前 Token 的熵值。这仅仅增加了一次原地张量运算,完全不引入额外的网络通信,也不需要辅助前向传递,具备极高的部署友好度。
其最终的优化目标与策略梯度形式保持了与标准 PPO/GRPO 目标的高度兼容性:
\[\mathcal{L}_{\mathrm{ESTR}}(\theta) = -\,\mathbb{E}\left[\frac{1}{\sum_{i=1}^G \lvert o_i \rvert}\sum_{i=1}^G \sum_{t=1}^{\lvert o_i \rvert} M_{i,t} \cdot \min\left(r_{i,t} A_{i,t},\ \mathrm{clip}(r_{i,t}, 1-\epsilon_{\mathrm{low}}, 1+\epsilon_{\mathrm{high}}) A_{i,t}\right)\right]\]其中 $M_{i,t} = \mathbf{1}[S_{i,t} \le \tau]$ 为掩码指示变量,$A_{i,t}$ 为分组归一化优势值。
复杂智能体与多轮推理任务上的全面验证
为了检验 ESTR 在长程时序和高强度异步环境下的稳健性,研究团队在两大极具挑战性的场景中开展了系统实验:
-
长程多轮工具交互任务:包括基于 Qwen3-30B-A3B 的 BrowseComp-Plus 深度检索智能体,以及基于 Qwen2.5-7B 的多轮 GSM8K 具身计算环境。在这类任务中,交互步数多、Token 序列长,轨迹内版本切换延迟 $\Delta^{\mathrm{intra}}$ 显著增大。
-
高难度数学推理任务:在 DAPO-Math 上基于 Qwen2.5-7B 进行训练,并在 AIME 2024、2025、2026 等具有极高难度的竞赛级题目上评估泛化能力。
基线模型涵盖了无任何防护的原始异步训练(Vanilla Async)、基于固定比率区间的截断方案 IcePop,以及基于双向二元 KL 散度的 KPop,同时以无流水线气泡损失的同步 GRPO(Sync GRPO)作为性能上限参照。
在 BrowseComp-Plus 智能体检索评测中,纯异步训练因严重的策略偏离迅速陷入停滞;IcePop 与 KPop 虽延缓了崩溃,但因误杀高熵探索,最终验证集准确率分别停留在 34.9% 与 33.6%。而 ESTR 凭借动态置信域,最终取得了 37.34% 的 avg@1 成绩,不仅大幅超越现有异步基线,更是直接追平了同步训练的 37.10%。在多轮 GSM8K 任务中,所有常规异步方案在数百步之内全线崩溃,而 ESTR 依然保持了极平稳的上升曲线,最终取得 95.69% 的准确率。
在 AIME 竞赛数学基准的横向测试中,ESTR 展现出了更深刻的特性。其不仅取得了 17.04 的 avg@4(同步 GRPO 为 17.54),更在衡量解题探索多样性的 pass@4 指标上达到了 28.38%,超越了同步基准的 27.68%。这直接证实了研究者的理论推导:在高熵分支处保留符合物理规律的脱靶探索,能够切实转化为模型更宽广的解空间覆盖度,而不是带来无序的数值振荡。
为什么 ESTR 能用更少的掩码带来更高的稳定性?
为了进一步探究 ESTR 的底层生效机制,作者追踪了训练全流程中各方法的 Token 丢弃比例(Masked Fraction $\rho_{\mathrm{mask}}$)与重要性比率的实际离群方差。
监控数据呈现出一个看似反直觉但极为精妙的对比:
固定阈值基线(如 IcePop)为了维持系统不崩,被迫丢弃了大量的 Token。在训练中后期,其掩码比例一度居高不下,然而剩余 Token 的对数比率方差依然呈现系统性向上漂移的趋势。这表明,固定阈值由于放行了低熵区的离群噪声,即便大量剔除样本,也未能真正收敛梯度的二阶矩。
相比之下,ESTR 剔除的 Token 数量比固定阈值基线少了一个数量级。ESTR 仅精准地剔除了极低比例的有害离群点,却在整个训练周期内将重要性比率的方差压制在最低且最平稳的水平上。换句话说,ESTR 证明了先前的方案在“过度抑制模型更新”的同时,却并没有防住真正致命的噪声源;而通过熵标准化的度量,模型可以用最小的样本损耗代价,达成最坚固的二阶置信约束。
在针对滞后参数的压力测试中,作者分别将轨迹内切换步数 $\Delta^{\mathrm{intra}}$ 扩展至 9、将轨迹间滞后 $\Delta^{\mathrm{inter}}$ 扩展至 30。在所有极端过时场景下,ESTR 均未发生崩溃,指标随着滞后的增大呈现极其平滑的缓慢下降,显示出了对恶劣异步通信环境的强韧适应力。
零额外开销实现 2.6 倍算力加速
异步强化学习的根本初衷是提升算力吞吐。在相同的硬件资源池(H800 GPU 集群)与相同并行配置下,同步 GRPO 由于严重的生成等待,显卡计算核心存在明显的空置周期。
ESTR 通过完全解耦生成集群与训练集群,将单 GPU 的生成吞吐量大幅拉升,每步迭代的墙钟时间缩短了 62%,在 DAPO-Math 任务上取得了相对同步训练 2.6倍的端到端吞吐加速。
更关键的是,这一加速完全没有附带常见的“精度折损税”。以往在分布式系统设计中,异步往往意味着向弱精度妥协,以速度换效果;而 ESTR 在整个推理到梯度的管道中,仅仅多做了一次标量级别的局部熵除法,就彻底抹平了异步化带来的策略偏离负效应,在加速 2.6 倍的同时做到了性能完全对齐同步基线。
从工程与算法演进的角度来看,这项工作重新界定了强化学习在长程 LLM / Agent 场景下的脱靶优化问题。策略是否偏离、是否可信,从来不是一个脱离上下文状态的绝对数值大小,而是必须与模型当前的认知不确定性(熵)共同度量。随着 Agent 任务的交互步长向成百上千轮不断演进,生成环境的异步化将成为基础设施的标配;ESTR 这种基于第一性原理推导出的轻量动态置信域范式,无疑为超大规模分布式强化学习训练提供了一条坚实而优雅的基础路径。