OAT:以粗到细有序Token重构机器人接口,60余项任务验证对数级推理
Ordered Action Tokens for Visuomotor Policy Learning
在视觉语言动作模型(VLA)与端到端机器人策略的演进中,如何将连续的高维动作块(Action Chunk)映射为模型可处理的离散表示,一直是一个被低估却至关重要的核心命题。语言模型之所以能高效预测文本,很大程度上依赖于设计良好的子词分词器(Tokenizer);但在具身控制领域,动作分词器(Action Tokenizer)的设计长期陷入了各种权衡妥协:要么生成数百个 Token 导致自回归推理延迟过高,要么依赖频域压缩导致策略采样出的非法序列根本无法解回连续控制,要么虽有高压缩率却缺乏时序与语义层级,无法给策略提供有效的学习归纳偏置。
ArXiv URL:https://arxiv.org/abs/2607.21670
针对这一瓶颈,研究者们提出了 OAT(Ordered Action Tokenization,有序动作离散化)。OAT 的核心洞察在于,一个优秀的机器人动作分词器不能仅仅充当离线的无损压缩工具,而必须成为深度契合策略生成与监督特性的“交互接口”。该研究提炼出动作离散化的三项核心诉求——高压缩率(High Compression)、全空间可解码性(Total Decodability) 以及 有序结构(Ordered Token Space),并通过引入 Register Transformer、有限标量量化(FSQ)以及前缀嵌套丢弃(Nested Dropout)机制,首次将这三项特性完整统一。
实验表明,OAT 不仅在纯重建质量上表现出色,更在跨越轻量级 Transformer 策略到大型 VLA 模型(如 PaliGemma2、Qwen-VL 系列)的 60 余项仿真与真实世界操作任务中全面超越现有分词基线。其支持的 2 的幂次分块生成策略,更将自回归生成策略的调用次数从传统的线性级别压缩至对数级别,为具身智能的高效推理与协同训练提供了全新的基础范式。
动作离散化的“不可能三角”与现有方案的缺陷
在基于动作块预测(Action Chunking)的连续控制中,策略在每个决策步需要输出一个长度为 $H_a$、维度为 $D_a$ 的动作序列 $A = a_{1:H_a} \in \mathbb{R}^{H_a \times D_a}$。由于连续分布建模存在多模态坍缩与训练不稳定的挑战,业界广泛倾向于使用分词器 $\mathcal{T}$ 将连续动作切片量化为有限字典 $\mathcal{V}$ 内的离散序列 $T_{1:H_l}$,并在推理时通过逆映射 $\mathcal{T}^{-1}$ 解码回连续控制量。
然而,现有分词技术在充当策略接口时往往各存短板,难以同时满足实际部署中的三项核心准则:
-
高压缩率(High Compression):如果分词序列长度 $H_l$ 过大,自回归策略需要串行预测数十甚至数百步,这不仅会导致严重的推断延迟,还会大幅增加误差累积的概率。
-
全空间可解码性(Total Decodability):由于下游策略通过概率分布采样生成 Token,模型输出任意可能不在训练分布内的离散序列都是不可避免的。一个合格的分词器必须保证字典空间内的任意组合序列,都能被稳定解码为符合执行器动力学约束的连续动作块,绝不能出现解码崩溃或维度不匹配。
-
有序结构(Ordered Token Space):自然动作本身具备由粗到细(Coarse-to-fine)的时空层次。若前序 Token 能够代表宏观的运动骨架,而后序 Token 仅负责修正细微残差,下游策略便能享有高度灵活的推理预算(Anytime Inference),并能在早期预测中专注于全局轨迹的规划。
回顾主流技术路线,最早广泛采用的逐维分箱法(Per-dimension Binning,如 RT 系列)将每个时间步的每个动作维度独立离散化,虽然满足完全可解码,但序列长度直接膨胀至 $H_a \times D_a$。在控制视界稍微拉长的情况下,自回归策略的计算开销与延迟便难以承受,且人为硬编码的关节排序完全割裂了动作的时空全局关联。
基于频域离散化与字节对编码的方案(如 FAST)利用离散余弦变换将动作映射到频域,再通过 BPE 压缩高频组合,虽然实现了从低频到高频的排序并提高了压缩率,但 BPE 的拼接规则导致逆解码变成了“偏函数”:策略一旦采样出不符合特定语法树的离散组合,就无法还原为固定维度的控制矩阵,在闭环交互中极易因非法解码而失败。
至于以 QueST 或 ACodec 为代表的学习型隐空间离散化方法,虽然采用矢量量化(VQ-VAE)或标量量化压短了序列长度,但在设计上仅把离线重建均方误差(MSE)作为单一优化目标。其离散潜码在时间与语义维度上是无序散布的,前几个 Token 无法单独解码为有物理意义的轨迹,下游策略在自回归预测时无法享受粗到细的归纳偏置。
+------------------+------------------+---------------------+-------------------+


| 分词方案         | 高压缩率 (Rate)  | 完全可解码 (Total)  | 语义有序性 (Order)|

+------------------+------------------+---------------------+-------------------+


| 逐维分箱 (Bin)   | ❌ 长度爆炸      | ✔️ 完全解映射       | ❌ 人工坐标硬切   |
| 频域BPE (FAST)   | ✔️ 词表自适应    | ❌ 语法错误即崩溃   | ✔️ 频域天然排序   |
| 隐式量化 (QueST) | ✔️ 潜码紧凑      | ✔️ 映射至潜空间     | ❌ 无粗细分层     |
| 本文方案 (OAT)   | ✔️ 极限对数压缩  | ✔️ 全词表映射保障   | ✔️ 前缀粗到细表征 |

+------------------+------------------+---------------------+-------------------+
OAT 的架构设计:自编码器与有限标量量化
为打破上述矛盾,OAT 采用了基于 Transformer 的对称自编码器结构,其由编码器 $E_\phi$、离散量化瓶颈以及解码器 $D_\theta$ 组成。
在编码阶段,连续动作块 $a_{1:H_a}$ 与一组可学习的 Register Tokens $r_{1:H_l}$ 共同输入编码器。Register Tokens 的数量直接决定了离散动作序列的目标长度 $H_l$。通过 Transformer 内部的注意力交互,这组固定数量的寄存器隐变量能够跨时间步主动聚合整段轨迹的时间动力学与全局特征,彻底摆脱了动作步长与关节维度对 Token 长度的刚性绑架。
在离散瓶颈的设计上,OAT 放弃了容易出现码本崩溃(Codebook Collapse)且需要复杂重置策略的传统矢量量化(VQ),转向了有限标量量化(Finite Scalar Quantization, FSQ)。FSQ 通过将连续向量投影到固定的超立方体网格并执行简单的舍入截断,将隐状态直接映射为离散整数索引。这一机制不仅训练极为平稳,更关键的是赋予了 OAT 严格的全空间可解码性:无论下游策略预测出何种离散组合,其索引均能严密对应到 FSQ 的网格点,解码器均能无缝将其投射回连续控制动作,杜绝了策略生成死锁的风险。
前缀驱动训练:将粗到细的控制偏置写入潜空间
光有紧凑且可解码的架构,还不足以让 Token 自发呈现出“粗粒度在前、细粒度在后”的时空秩序。OAT 最具启发性的设计在于其提出的有序前缀训练机制(Ordered Prefix Training)。
在传统自编码器的训练中,解码器总是接收完整的潜在表示。而 OAT 引入了受信息论源编码启发的嵌套丢弃(Nested Dropout)策略。在每个训练批次中,算法从预定义的预算集合 $\mathcal{K} = {1, 2, 4, \dots, H_l}$ 中随机采样一个有效前缀长度 $K$。对于序列中 $K$ 之后的其余位置,全部替换为一个全局共享的可学习掩码标记 $\langle \mathtt{MASK} \rangle$:
\[\widetilde{T}^{(K)}_{1:H_l} = T_{1:K} \oplus \langle \mathtt{MASK} \rangle_{K+1:H_l}\]解码器必须且只能依据被截断的前缀 $\widetilde{T}^{(K)}{1:H_l}$,尝试完整重构原始的高维连续动作块 $a{1:H_a}$:
\[\mathcal{L}_{\mathrm{prefix}} = \mathbb{E}_{a, K} \left[ \left\| D_\theta(\widetilde{T}^{(K)}_{1:H_l}) - a_{1:H_a} \right\|_2^2 \right]\]这一简单却极具强制力的目标函数,在信息分配层面引发了深刻的重构:当 $K=1$ 时,唯一的那个 Token 承受了巨大的重构惩罚压力,它被迫去捕获整段轨迹最核心的宏观位移和宏观意图(例如末端执行器的大致移动方向与夹爪的闭合状态);而当预算 $K$ 逐渐增加到 2、4、8 时,后续追加的 Token 则无需重复编码全局轮廓,而是专注于拟合轨迹细节、修正高频残差并提高控制精度。
从经典率失真理论(Rate-Distortion Theory)的角度来看,若用 $\varepsilon(K)$ 表示保留前 $K$ 个 Token 时的预期重构误差,$\Delta_i = \varepsilon(i-1) - \varepsilon(i)$ 代表第 $i$ 个 Token 带来的边际增益,则优化目标等价于最大化边际增益的加权和:
\[\mathbb{E}_K[\varepsilon(K)] = \varepsilon(0) - \sum_{i=1}^{H_l} \Pr(K \ge i) \, \Delta_i\]由于前序 Token 的留存概率 $\Pr(K \ge i)$ 严格单调递减,靠前的 Token 天然被赋予了更高的生存权重,迫使模型将绝大部分高价值控制信息“前置”。这就使得 OAT 在物理层面上具备了自适应预算解码(Anytime Decoding)的特性:在计算资源紧张或需要极低延迟响应时,机械臂只需生成前 1 到 2 个 Token 即可直接解码并执行动作;若时间充裕,则可继续生成后续 Token 以实现精密装配。
策略侧适配:对数级块自回归与协同训练新范式
在下游策略接口的应用中,OAT 展现出了对两种主流具身智能架构的强大赋能能力:自回归动作生成(AR Policies)与多模态模型协同训练(Token Co-training)。
对于自回归控制,传统的 Token-wise 预测受制于时序因果链条,生成 $H_l$ 个 Token 必须调用 $H_l$ 次策略网络。为了突破这一计算瓶颈,OAT 提出了通用的分块自回归调度框架(Block-wise Autoregressive, BAR)。研究人员设计了 $\text{OAT}^{\mathrm{pow2}}$ 变体,将动作 Token 划分为按 2 的幂次递增的块集合(如 1, 2, 4, 8…)。
在编码器自注意力机制中,后一块内的 Register 可以单向关注所有先前的预算块,但同一块内的 Register 之间互不透视。在生成阶段,策略仅需执行一次前向计算,即可并行发射整个新块中的所有 Token。对于一个长度为 $H_l=16$ 的动作切片,传统逐 Token 自回归需要 16 次策略前向传播,而 $\text{OAT}^{\mathrm{pow2}}$ 仅需 5 次调用即可完成完整生成,策略调用复杂度直接从 $O(H_l)$ 骤降至 $O(\log_2 H_l)$,大幅释放了自回归大模型在实时机器人闭环控制中的高频吞吐能力。
而在第二种极具前景的模式——Token 协同训练(Token Co-training, TC) 中,OAT 则扮演了强有力的表征塑造者。在诸如结合了 VLM 骨干与流匹配动作专家(Flow-Matching Action Expert)的架构中,离散动作 Token 并不直接用于生成控制,而是作为辅助交叉熵损失来监督 VLM 的预填充(Prefill)表征:
\[\mathcal{L}_{\mathrm{TC}} = \mathcal{L}_{\mathrm{tok}}(T_{1:H_l} \mid c) + \lambda \mathcal{L}_{\mathrm{flow}}\!\left(a_{1:H_a}, \widetilde{a}^\tau, \tau; \operatorname{sg}(\mathrm{KV}_{\mathrm{VLM}}(c))\right)\]在此结构中,VLM 在处理完环境上下文 $c$(图像、语言和本体感知)后,在零动作历史的条件下直接预测第一个动作 Token。由于 OAT 的第一个 Token 在训练时就被赋予了“单凭自身重构整段轨迹”的严苛任务,这迫使 VLM 在预填充隐状态中提前沉淀出一种具备轨迹全局规划属性(Plan-like Summary)的高阶特征。相比逐维分箱(第一步仅监督单个坐标轴标量)或无序隐空间量化,OAT 提供的这一强语义目标能够显著改善多模态上下文的质量,使下游的连续流匹配专家在动作生成时具备更具前瞻性的宏观引导。
实验评测:跨越 60+ 任务的性能跨越
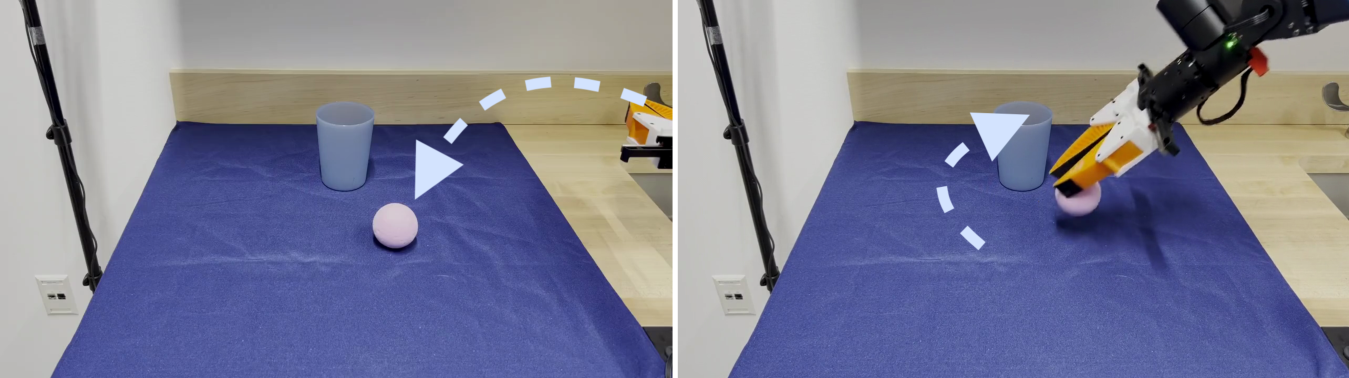
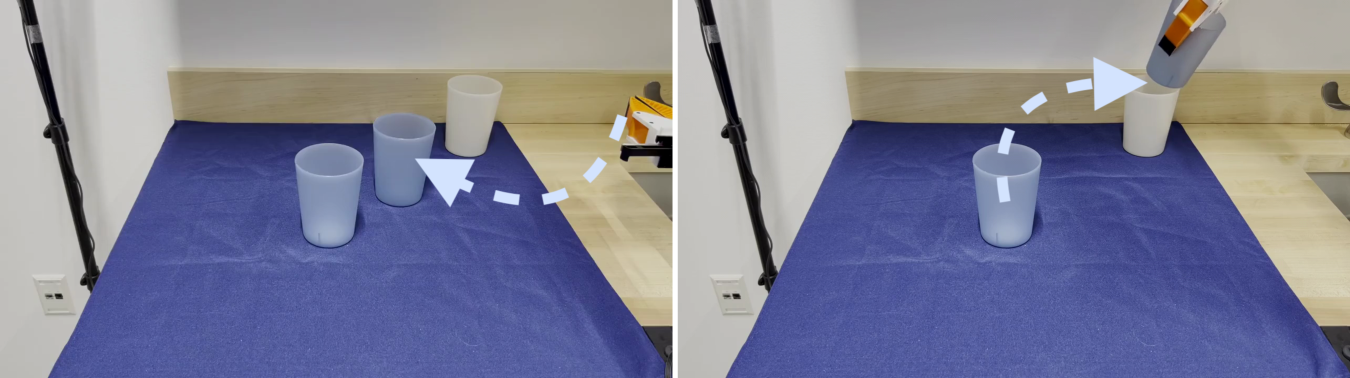
为了全面验证 OAT 的通用性,研究团队构建了涵盖仿真与真实硬件的多层次评测矩阵,包含 LIBERO、RoboMimic、MetaWorld、RoboCasa 及 SimplerEnv 五大主流机器人仿真基准,并在真实的单臂 ARX-5 操作平台上验证了小球拾取放置与精密叠杯任务,总任务数超过 60 项。
在轻量级策略实验中,固定网络骨干与超参数设置,对比了 Bin、FAST、QueST 和 ACodec 等分词方案。由于 FAST 在轻量级网络输出分布略有偏移时频繁触发无效语法错误,导致机械臂时常陷入静止状态;而 Bin 方案在长预测视界下因序列过长导致策略学习极其缓慢。相比之下,OAT 在所有仿真与真实任务中展现出了最高的平均胜率与最低的平均排名。
更令人惊叹的是其自适应预算的表现:即使在极端资源受限下仅生成前缀 $\text{OAT}_1$(仅用 1 个离散 Token 代表整个轨迹块),机械臂依然能在轻量级任务中完成大部分粗糙移动与粗抓取;当预算放宽至 4 到 8 个 Token 时,控制精度与抓取成功率已迅速逼近甚至超越使用全量 Token 的其他基线。这充分印证了有序前缀训练对粗粒度与细粒度信息的精准解耦。
在大视觉语言模型(VLM)尺度上,研究团队基于 PaliGemma2 和 Qwen-VL 骨干,分别测试了自回归(AR)生成与协同训练(TC)下的表现:
-
自回归生成表现:在 SimplerEnv 与 LIBERO 等严苛评测中,$\text{OAT}^{\mathrm{pow2}}$ 表现尤为亮眼。它不仅取得了优于传统密集分箱与频域压缩的闭环成功率,还将策略推理步数大幅压低。在相同的推理延迟预算下,基于 OAT 的 VLM 策略能够以翻倍的频率进行重新规划,显著改善了机器人在面对动态扰动时的恢复能力。
-
协同训练加成:当使用 OAT 的离散 Token 监督 VLM 的预填充上下文时,流匹配动作专家的控制表现得到了系统性跃升。消融分析证实,这一收益的核心正来源于 OAT 首个 Token 的“全局轨迹规划”监督信号。将首个 Token 替换为普通的分类标记或逐维标量后,策略的最终表现均出现显著下滑,证明了动作级规划表征在多模态对齐中的独特价值。
结语与对未来具身模型的启示
OAT(Ordered Action Tokenization)的研究表明,在迈向通用机器人大模型的道路上,动作离散化绝不能被简单视为经典信号处理或孤立的图像自编码器复刻。一个合格的具身接口,必须同时在信息压缩、数学上的全空间鲁棒解码、以及时空控制语义的层次化排列三个维度上协同发力。
通过将 FSQ 与嵌套前缀机制结合,OAT 巧妙地在统一的框架内解决了长程自回归延迟过高与生成鲁棒性不足的痛点,并顺带解锁了自适应预算推理与高效对数块生成的全新特性。这一工作不仅为当前火热的 VLA 策略研发提供了一个即插即用、稳定高效的分词工具底座,更为未来探索更大规模、支持高频低延迟闭环控制的具身智能基础设施提供了清晰的方法论指引。