ODYSSE:剧集级策略优化破局模糊需求,让Agent学会个性化推理
ODYSSE: Episode-wise Policy Optimization for Personalized Agentic Reasoning
当大语言模型驱动的多模态智能体(GUI Agent)走出封闭基准,进入真实的手机与网页交互环境时,一个致命的假设正在被打破:真实的人类用户从来不会给出毫无歧义的精确指令。
ArXiv URL:https://arxiv.org/abs/2607.25369v1
现有的智能体训练大多建立在明确、甚至是“喂到嘴边”的指令上。如果用户要求“在地图上查找位于美洲大道 1335 号的纽约中城希尔顿酒店”,现有的视觉智能体可以轻而易举地完成关键字输入、点击和定位。然而,真实场景下的交互完全是另一番景象。用户更常抛出的只有寥寥数语,例如“我下周要去纽约,有什么酒店推荐?”此时,任务并不存在唯一的标准答案,其背后是一个庞大、开放的解空间,智能体必须在多轮操作中探寻用户潜在的偏好,将模糊的需求逐步收敛为具体选择。
面对这种“个性化智能体推理”(Personalized Agentic Reasoning)挑战,格里菲斯大学与昆士兰大学的研究团队提出了强化微调框架 ODYSSE,其核心是面向整段交互轨迹的强化学习算法 ESPO(Episode-wise Policy Optimization,剧集级策略优化)。该框架不再将交互割裂为互不相关的单一动作,也不仅仅依靠最终结果提供稀疏奖励,而是将整条交互剧集作为优化基元,通过创新的“用户思维链”(Chain-of-User-Thought, COUT)奖励机制,让智能体真正学会如何在上游操作中积累线索,并指导下游的个性化决策。
从被动执行到个性化推理:传统优化的两重困境
为了理解为什么现有 Agent 在个性化场景下频频失效,需要重新审视智能体在复杂图形界面(GUI)中的决策逻辑。在一个标准的数字助手任务中,从接收模糊指令到完成个性化交付,通常需要跨越多个异质阶段:先是在界面上进行浏览、筛选和翻页等基础操作;随后在观察环境反馈的同时推测用户的真实偏好;最后在聚合出的候选池中做出符合偏好的推荐。
这一连串行为具有两个显著特征:极长的行动跨度(Long Action Horizons)与强烈的跨步骤依赖(Strong Cross-Step Dependencies)。然而,当前主流的强化学习对齐方法在这类任务上陷入了两个极端。
一种是仅依赖最终结果的稀疏监督(Outcome-based Supervision)。这种方式只在智能体给出最终推荐时判定成败。但在长达十几步乃至几十步的多轮交互中,中间步骤缺乏明确约束,容易导致信用分配(Credit Assignment)严重失真。智能体不仅容易在中途迷失方向,还常常学会寻找捷径或侥幸蒙对结果,完全丧失了稳健的探索轨迹。
另一种是单步独立优化(Step-wise Optimization)。许多基于强化学习可验证奖励(RLVR)的研究倾向于为每个单独动作(如某一次点击或输入)提供即时反馈。这种假设的前提是“每一步都可以独立优化”,但在个性化推理中,这种假设被彻底打破了。用户第 3 步在界面上的筛选动作,其合理性往往取决于第 1 步的初始意图,同时它又决定了第 15 步的个性化推荐能否成功。如果强行把每一步当成孤立样本输入策略模型,跨步骤的意图演变链条就会被生生割裂,智能体便无法学会“为了后续的推荐而在前期搜集关键证据”。
ESPO:以剧集为核心的策略优化机制
为了克服上述两重困境,研究团队在流行的分组相对策略优化(GRPO)基础上,构建了面向完整剧集(Episode)的策略优化算法 ESPO。与直接套用 GRPO 处理单步 Token 或单步动作不同,ESPO 维持了整段交互历史的完整性,并从三个互相关联的层次重构了奖励和优势估计。
1. 异质动作空间的阶段可验证奖励
交互轨迹中的不同步骤承担着完全不同的职责。如果对所有步骤施加同质化的奖励信号,模型很难明确具体的优化方向。ESPO 将交互动作划分为三个关键阶段,并分别赋予形式化的可验证奖励:
-
GUI 任务执行阶段:评估智能体与环境交互的规范性与准确性。奖励函数 $R_{\mathrm{GUI\text{-}accuracy}}$ 会细化检查动作类型(如点击、滚动、输入)与动作参数(如点击坐标、输入文本)。当类型与参数全部正确时给予正向奖励,仅类型正确时给予折衷反馈,而参数错误则施加惩罚,以保证交互底座的可靠性。
-
意图预测阶段:当智能体在探索过程中尝试总结或推断当前用户的潜在需求时,ESPO 会提取智能体预测的意图文本,并与真实意图计算语义余弦相似度。只有当动作类型正确且语义相似度超过设定阈值 $\tau$ 时,$Intent_{\mathrm{acc}}$ 才会激活。
-
个性化决策阶段:在最终的候选池推荐中,ESPO 采用严格的双重判定标准。对于每一个推荐步骤,智能体给出的动作类型和具体目标项必须与真实用户偏好完全重合,才能获得正向奖励 $R_{\mathrm{dec\text{-}accuracy}}$,否则判定为失败并扣分。
此外,ESPO 为所有动作步骤统一配置了格式奖励 $R_{\mathrm{format}}$,确保智能体严格遵循结构化的输出规范。
2. 用户思维链(COUT)奖励:双向依赖的意图锚定
如果仅有上述各阶段的单步奖励,智能体依然只是在离散地执行任务,缺乏全局规划。为了度量一整段交互是否连贯地将模糊需求解码为个性化需求,ESPO 提出了“用户思维链”(Chain-of-User-Thought, COUT)奖励机制。
COUT 奖励通过两个门控机制来建立上游证据与下游决策之间的双向依赖:
首先是 GUI 行动门控(GUI-action gate)$\phi$。该门控通过非线性函数对前期所有 GUI 交互的准确度进行归一化汇总,它反映了智能体推断意图时所依据的前置上下文是否真实可信。如果前面的操作完全是乱点一气,那么即便偶然猜对了意图,该门控也会将置信度大幅压缩。
其次是 决策门控(Decision gate)$\psi$。该门控统计下游个性化决策阶段的准确度,它用来衡量推断出的用户意图是否真正转化为了高质量的最终决策。
基于这两个门控,整段剧集的 COUT 奖励定义为:
\[R_{\mathrm{COUT}}^{(i)} = \phi_{i} \cdot Intent_{\mathrm{acc}} + \psi_{i} \cdot Intent_{\mathrm{acc}}\]公式的第一项代表意图置信度(Intent Confidence),即上游行为对意图推断的支撑力度;第二项代表意图贡献度(Intent Contribution),即意图推断对下游推荐成功的实际贡献。只有当前期交互扎实、意图预测准确、且最终决策正确时,整个交互剧集才能获得最大化的 COUT 回报。
3. 剧集级优势估计与策略更新
得到剧集级奖励后,如何将其合理分配给轨迹中的每一个动作?这正是 ESPO 的核心机制所在。
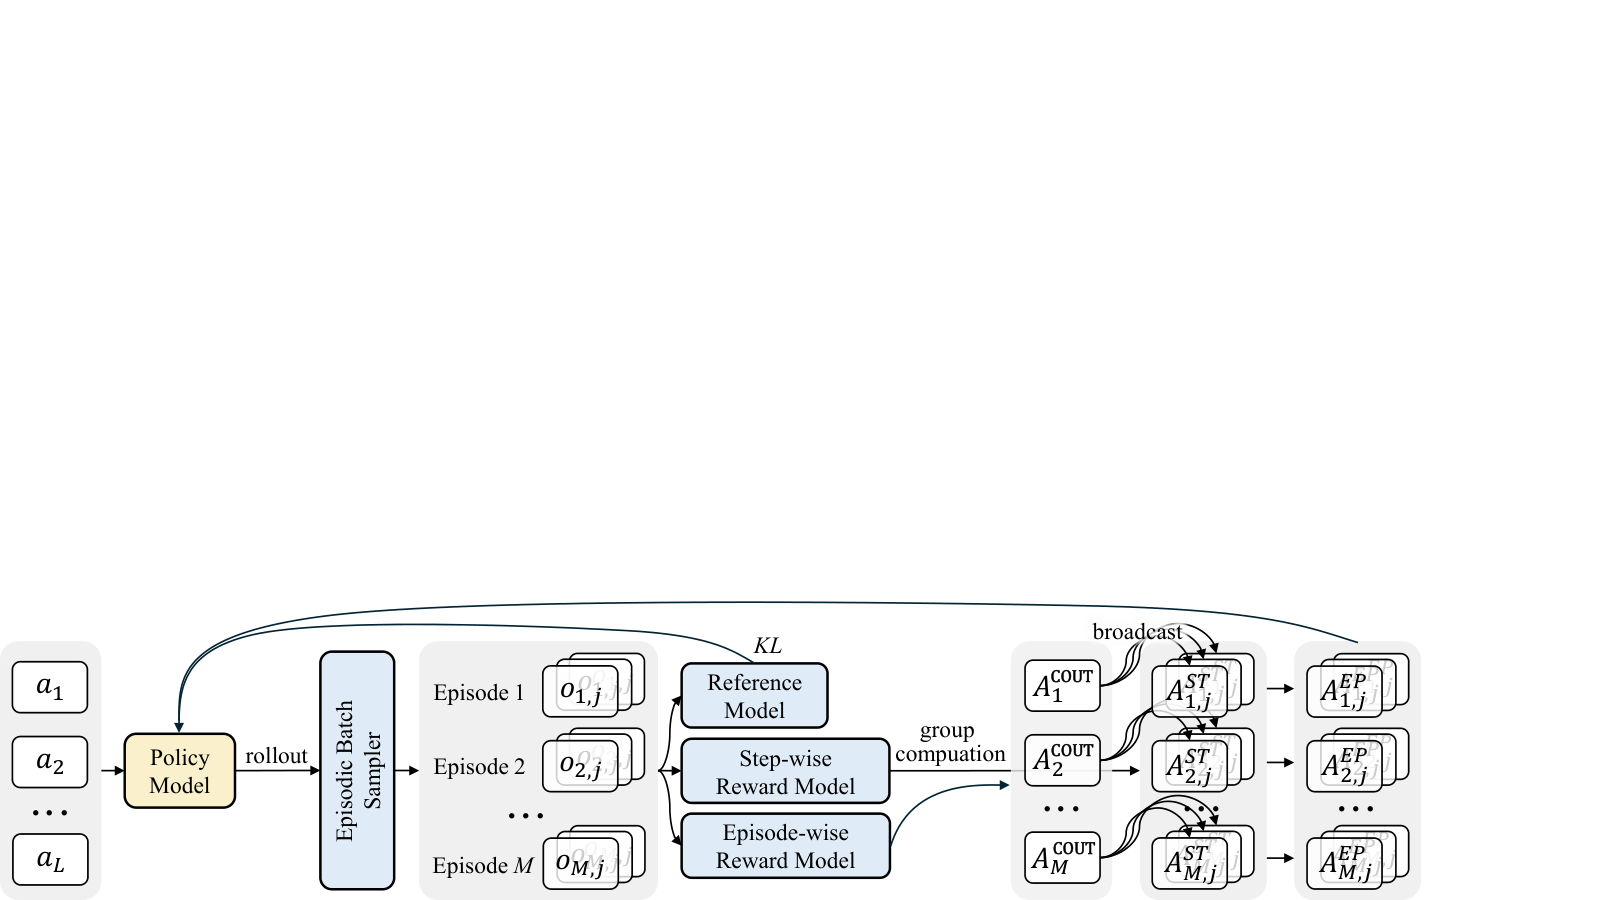
对于剧集 $e_i$ 中的任意一步动作 $a_j$,在采样的 $G$ 个候选生成序列中,ESPO 首先计算其局部的单步相对优势 $A_{\mathrm{step\text{-}wise}}(a_{j,g})$。这一部分沿袭了 GRPO 在当前单步状态下的相对比较优势,能够为特定操作提供细粒度反馈。随后,ESPO 将整段轨迹计算得到的全局 $R_{\mathrm{COUT}}^{(i)}$ 广播给该剧集内的每一个动作步,生成全局剧集优势 $A_{\mathrm{COUT}}(e_i)$。
两者的加权融合构成了最终的剧集级优势:
\[A_{\mathrm{episode\text{-}wise}}^{(i,j,g)} = A_{\mathrm{step\text{-}wise}}(a_{j,g}) + w \cdot A_{\mathrm{COUT}}(e_i)\]通过这一机制,全局的个性化意图对齐信号被平滑注入到每一个局部的操作中。当智能体在第 2 步点击某个过滤按钮时,它所获得的梯度更新不仅仅取决于“这个按钮点得对不对”,还取决于“这次点击是否帮助最终的个性化推荐取得了成功”。
在策略更新层面,ESPO 沿用了带有重要性采样的裁剪目标函数,结合 KL 散度约束,促使策略网络在保留稳定探索的同时,向着整段轨迹收益最高的方向演进。
保证因果链条:剧集级批采样器设计
在传统的强化学习微调框架中,为了最大化吞吐效率并消除数据相关性,采样器通常会在回放缓冲区中将所有步骤打散、随机洗牌(Shuffle),然后按固定大小拼接成 mini-batch。
然而,这种在传统强化学习中习以为常的操作,对于 ESPO 却是灾难性的。一旦时间步被打碎,分散在不同批次中,门控函数就无法实时获取同属于一个剧集的上下游动作统计,COUT 奖励便无法计算,跨步骤的时序依赖也会被彻底切断。
为了在工程实现上支撑 ESPO,ODYSSE 配套设计了剧集级批采样器(Episodic Batch Sampler)。该采样器将每个完整的交互剧集视为最小的不可分割采样单元。在批次构建阶段,采样器首先依据剧集唯一标识符,将属于同一轨迹的所有动作聚合在一起,并严格保留它们的原始时序关系;随机洗牌的操作仅在不同剧集之间进行。这种设计确保了计算图在展开前向与反向传播时,完整的上下文因果链条完好无损,使得长达十几步的全局强化学习得以稳定收敛。
为什么 SFT 在个性化场景下彻底失效?
研究团队在包含真实机票预订、商品选购等复杂长交互场景的 SmartSpot 基准上进行了系统评测。该基准平均每个任务包含约 17 个连续步骤,涵盖从基础搜索、浏览候选池到多目标推荐的全流程。
在以 Qwen2.5-VL-3B 为底座的对比实验中,一个非常引人深思的现象浮出水面:单纯依靠监督微调(SFT)几乎无法让 Agent 获得任何真正的个性化决策能力。
实验数据显示,仅进行 SFT 冷启动训练的变体,虽然能够学会输出符合 JSON 或格式要求的文本标记,但在元素定位准确率(Element Accuracy)和最终推荐准确率(Recommendation Accuracy)上几乎全部归零。即便将训练预算全部投入 SFT、大幅增加训练轮次(All SFT 变体),模型在底层的界面点击和操作匹配上有所提升,但在最终的推荐准确率上依然停留在零点。
这揭示了 SFT 在智能体认知层面的局限性:纯粹的局部模仿学习只能教会模型“在看到特定屏幕时模仿特定的点击动作”,但它根本无法理解跨越多个步骤的意图演变逻辑。每一步的局部交叉熵损失只能监督下一个 Token 的概率分布,无法建模“为了第 17 步的个性化决策而在第 2 步进行针对性探索”的延迟反馈逻辑。
与之形成鲜明对比的是,在经过 SFT 冷启动后引入 ESPO 强化微调的完整 ODYSSE 框架,在底层操作指标与高层个性化推荐指标上均取得了大幅突破。尤其是在 SFT 完全无法攻克的推荐准确率上,ODYSSE 展现出了明确的跨越式增长。这表明,对于依赖长程交互与偏好收敛的任务,强化学习不是可有可无的微调点缀,而是帮助智能体建立跨步骤证据链和决策逻辑的根本前提。
对未来智能体架构的启示
从研究视角来看,ODYSSE 与 ESPO 的价值不仅在于刷新了特定基准的分数,更在于为长程智能体系统的优化提供了一个清晰的范式演进信号:
-
脱离“明确指令”的温室:未来的个人助理智能体不可能等待人类输入完美无缺的代码或提示词。能够在模糊需求中感知不确定性、主动通过环境交互收集信息并动态对齐偏好,是衡量下一代 Agent 智能密度的核心尺度。
-
摆脱离散单步优化的狭隘视角:在具备复杂因果依赖的长任务中,盲目套用基于单步 Token 的 RLVR 很容易陷入局部最优甚至奖励黑客行为。将整段轨迹作为认知单元、让下游目标反哺上游探索的“剧集级”优化思路,为复杂长链条任务的信用分配提供了更符合人类认知直觉的解法。
当多模态基础模型本身的视觉定位与单步指令理解已经趋于成熟,智能体真正拉开差距的赛场,正在全面转向这种能够在多轮动态交互中抽丝剥茧、精准捕捉人类个性化意图的长程推理能力。