NeuRoute:用Logit引导神经路由,十亿级向量单机不到1小时建完索引!
NeuRoute: Logit-Guided Neural Routing for Billion-Scale Vector Search with Sub-Hour Index Construction
在海量高维向量检索(Approximate Nearest Neighbor, ANN)的工业实践中,工程师们往往面临一个残酷的工程权衡:想要高召回和低延迟,通常得依靠基于图的索引(如 HNSW、DiskANN)或精细调优的倒排量化索引(如 IVF-PQ、OPQ)。然而,一旦数据规模迈向十亿(Billion-scale)级别,这些主流方案的构建成本便会陡增。动辄数十小时的全局聚类、沉重的磁盘 I/O 交互以及极度复杂的超参数调优,常常让索引的冷启动与定期重构成为系统运维的噩梦。
ArXiv URL:https://arxiv.org/abs/2608.15438v1
哈希(Hashing)原本是解决这一困境的最轻量路径。二进制编码存储极小、计算极快,能以极低代价将海量向量分发到不同的哈希桶中。但在十亿级规模下,传统哈希几乎从未真正成为可靠的工业级路由方案:由于汉明空间的粗粒度划分,跨桶检索往往只能依靠盲目的“汉明半径”层层外扩,检索范围迅速失控;更致命的是,常规哈希在将浮点特征二值化为 0 和 1 的那一刻,彻底丢弃了连续激活值(logits),抹平了所有“置信度”与“不确定性”信息。
针对这一长期存在的系统瓶颈,来自阿肯色大学小石城分校(University of Arkansas at Little Rock)的研究团队提出了 NeuRoute。这项工作没有试图将哈希打造成终极检索工具,而是退后一步,将短二进制哈希编码重构为一种极高效的“神经路由原语”。通过在轻量神经网络的输出 logits 中提取不确定性信号,NeuRoute 实现了按需探测高价值哈希桶,并配合桶内轻量聚类与动态早停机制,彻底打破了十亿级向量检索的构建与查询瓶颈。在 BigANN-1B 和 Deep1B-1B 两个十亿级基准数据集上,NeuRoute 在单节点环境下将端到端建索时间压缩至 1 小时以内,同时在 90.3% 高召回率下取得了远超传统量化方案的吞吐表现。
传统哈希的困境与神经路由的新定位
要理解 NeuRoute 的突破,必须先看清当前十亿级向量检索的两大阵营所面临的现实阻碍。
第一类是以 IVF-PQ 为代表的量化与倒排文件体系。这类方法依赖在整个十亿级数据集上进行全局 $k$-means 聚类来生成成千上万个粗聚类中心(Centroids)。在海量样本和高维度交织下,全局聚类的收敛极为耗时,且随着数据分布的动态漂移,常常出现桶大小严重失衡的长尾问题。第二类则是图索引及其磁盘混合架构(如 DiskANN)。尽管它们在查询延迟和召回率上表现卓越,但全图构建时的内存开销、随机访存压力和维护成本极高,单节点在短时间内很难完成全量重构。
哈希之所以长期处于劣势,根源在于其“候选集爆炸”与“缺乏预算控制”。以往的哈希方法通常只关注如何通过监督或无监督学习生成更保真的二进制码,但在检索阶段,依然依靠固定的汉明半径(例如半径为 0、1、2)逐层向外搜索相邻桶。这种离散扩展方式存在极大的盲目性:同一个汉明距离下的两个相邻桶,其包含真实近邻的概率可能天差地别;而在二值化截断过程中,神经网络原本输出的连续激活值被直接丢弃,查询向量到底是“毫不犹豫地被判定为 1”还是“在阈值边缘徘徊”,系统完全无从得知。
NeuRoute 的核心立意正是扭转这一被动局面。作者团队认为,短二进制编码本身就具备超轻量、低内存、天然分桶的优秀系统属性,完全不应苛求它一步到位完成精确排序;只要为它补全“不确定性度量”,短哈希就能变成一个极低成本的自适应路由层。在路由过滤出极小规模的高价值候选后,再交由原始特征进行全精度精排(Exact Refinement),便能形成一条兼顾极速建索与高吞吐的全新通路。
选择性相似度保持:摆脱离线挖矿的极速编码器
作为神经路由的第一步,NeuRoute 需要训练一个结构轻巧的神经网络编码器 $E(\cdot)$,将原始高维向量(维度为 $E_{\text{dim}}$)映射到低维连续潜在空间(维度为 $L_{\text{dim}}$),进而量化为短二进制地址。
以往的深度哈希模型往往陷入一个误区:试图让全量数据在低维空间中完全重构原始的高维几何拓扑。为此,许多方案不得不进行昂贵的离线负样本挖掘(Hard Negative Mining)或构建全量样本近邻图,导致数据预处理时间甚至超过了索引构建本身。
NeuRoute 采用了更为实用的设计哲学:近似近邻检索本质上只需要区分“极近的邻居”和“较远的背景”,对相隔甚远的向量之间微小的距离变化完全不敏感。基于此,研究提出了选择性相似度保持损失(Selective Similarity-Preservation Loss, $L_{\text{sim}}$):
\[L_{\text{sim}}=\frac{1}{\mathrm{sum}(\mathrm{Mask})}\sum_{i=1}^{B}\sum_{j=1}^{B}\mathrm{Mask}_{ij}\Big(\mathbf{S}_{\text{lat}}(i,j)-\gamma\rho\cdot\mathbf{S}_{\text{emb}}(i,j)\Big)^{2}\]其中 $\mathbf{S}{\text{emb}}(i,j)$ 与 $\mathbf{S}{\text{lat}}(i,j)$ 分别代表样本对在原始嵌入空间与潜在低维空间的欧氏距离。关键在于掩码矩阵 $\mathrm{Mask}_{ij}$ 的设计:
\[\mathrm{Mask}(i,j)=\begin{cases}1,&i\neq j\ \text{and}\ \bigl(\mathbf{S}_{\text{emb}}(i,j)\leq\tau_{\text{emb}}\ \ \text{or}\ \ \mathbf{S}_{\text{lat}}(i,j)\leq\gamma\rho\,\tau_{\text{emb}}\bigr),\\[4.0pt] 0,&\text{otherwise.}\end{cases}\]这个条件掩码使得损失函数只约束那些在原始空间足够近、或者在当前潜在空间被错误拉得太近的样本对。更重要的是,这一阈值与掩码计算完全在 Mini-batch 内部实时完成(on-the-fly),完全不需要任何离线构建的近邻图或跨批次样本对维护。
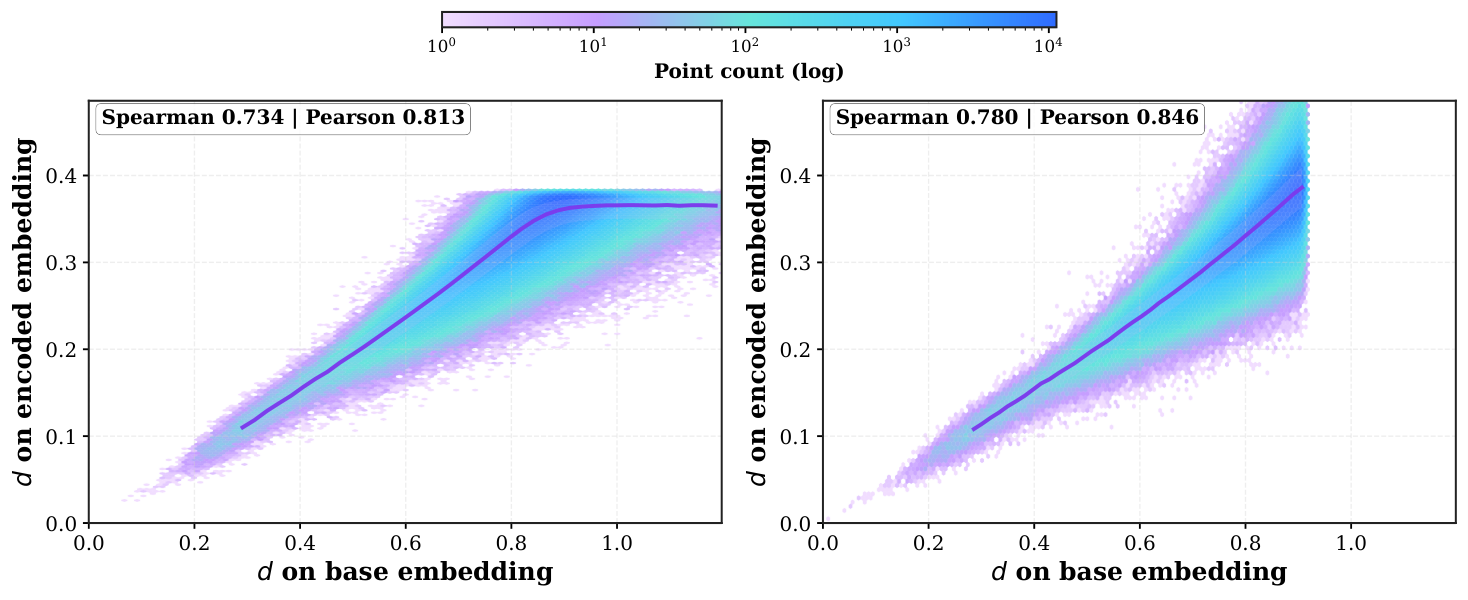
从距离诊断图中可以清晰观察到,不论是对潜在空间采样还是对基空间采样,编码后的潜在距离与原始基空间距离都呈现出极强的单调递增趋势。虽然远距离样本对在潜在空间中出现了轻微的饱和现象,但这恰恰符合设计初衷——在强力压缩维度的同时,牢牢锁定了近邻几何结构的相对顺序,为后续的路由决策提供了扎实的距离单调性保障。
桶内低维聚类:几分钟化解候选集膨胀
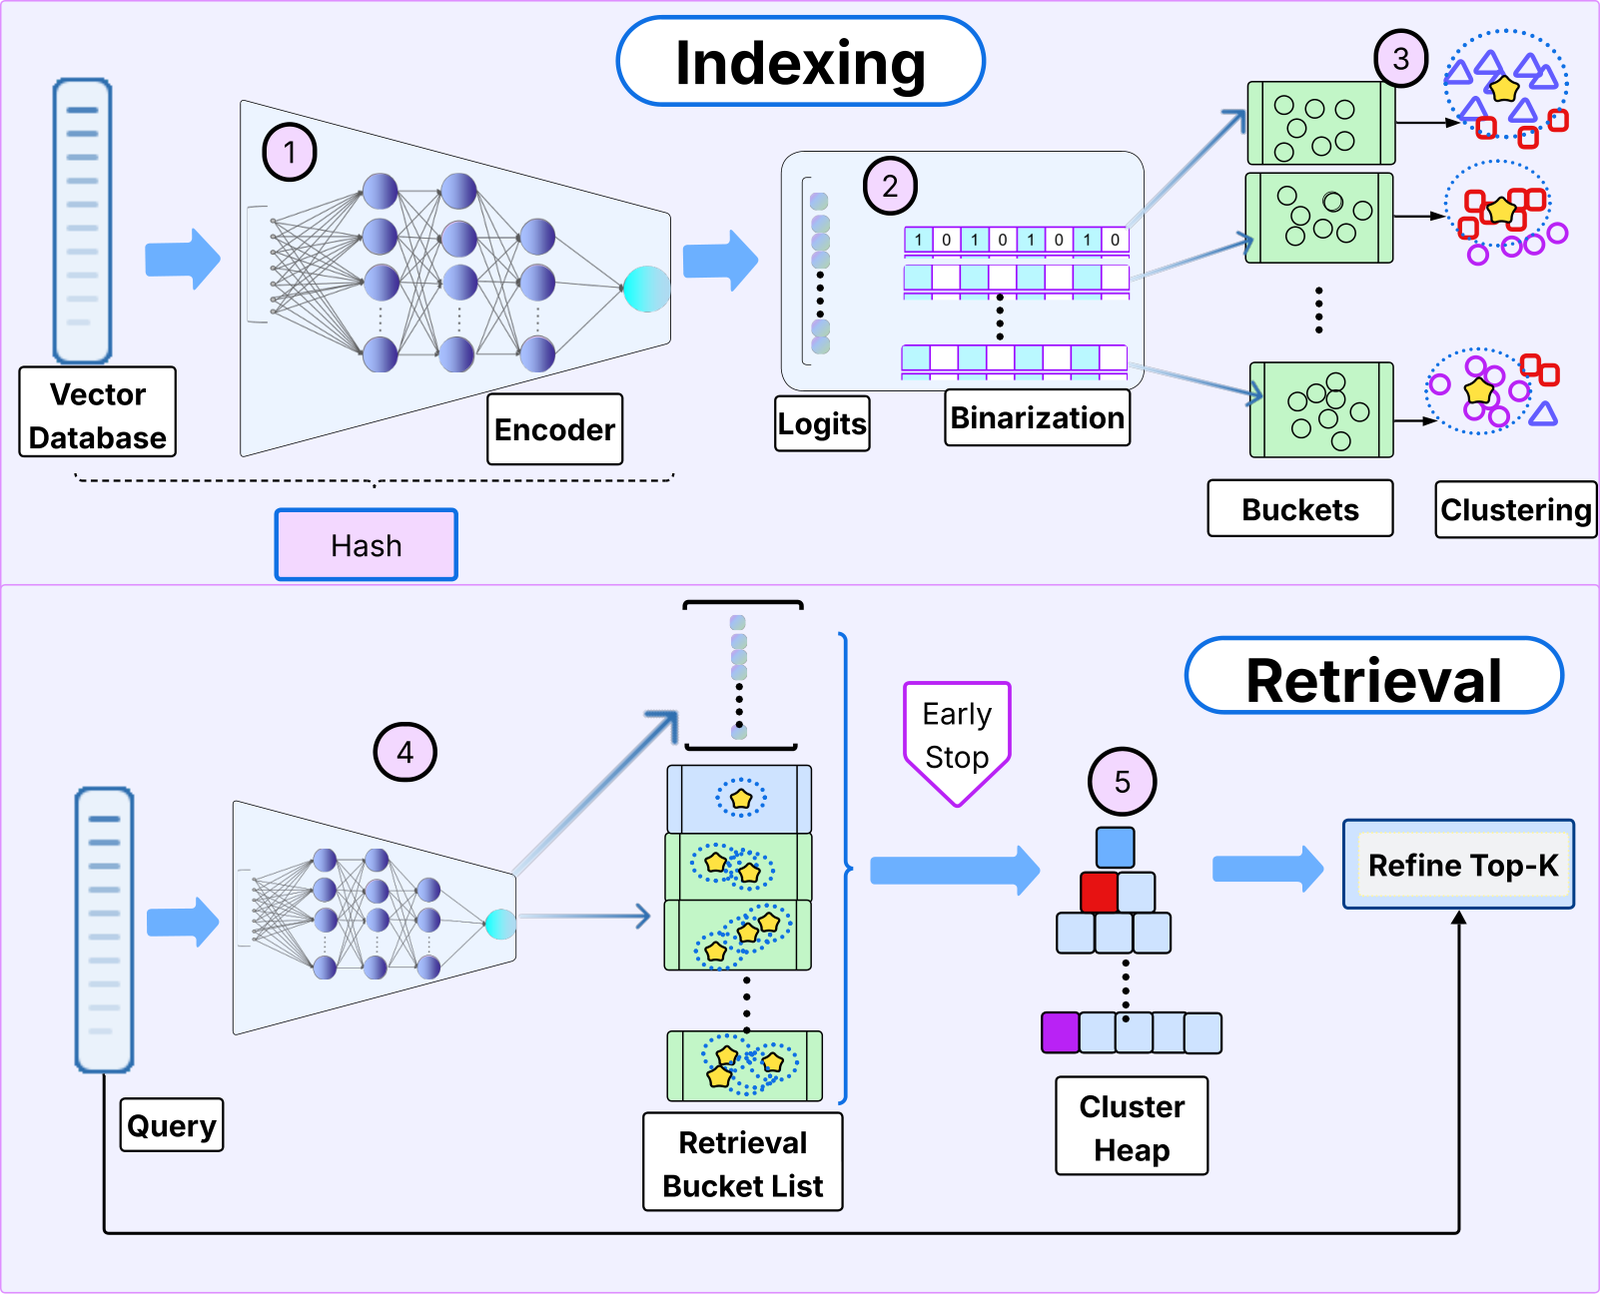
得到编码器后,NeuRoute 对每个维度的激活值计算中位数阈值 $\tau_j$ 进行二值化切分,以此生成每个向量的基哈希地址并分入对应的桶。但随之而来的是一个系统层面的严峻挑战:十亿级数据映射到较短的哈希编码时,单个非空桶内的向量数量仍然可能十分庞大。如果在查询时直接把整个桶内的所有向量都塞进精排阶段计算原始全精度距离,系统吞吐仍会被高昂的精排计算压垮。
针对该问题,NeuRoute 给出了一个极为巧妙的解法:桶内局部聚类(Bucket-Local Clustering)。
与传统 IVF-PQ 在十亿条原始高维向量上硬抗全局大 $k$-means 完全不同,NeuRoute 的聚类操作具有两个决定性的系统优势:
-
维度极低:聚类并不是在原始的高维空间(如 96 维或 128 维)进行,而是在经过编码器压缩后的极低维潜在空间($L_{\text{dim}}$)中执行;
-
完全解耦与局部化:聚类被严格限制在各个哈希桶内部独立发生。对于每个非空桶 $B$,系统根据其容量自适应计算局部聚类中心数量 $K_B = \lceil \lvert B \rvert / t \rceil$($t$ 为目标聚类容量)。对于微型桶直接视作单一聚类,中大型桶则通过 $k$-means++ 初始化并运行极少轮次的快速 Lloyd 迭代。
这一设计在工程上带来了质的飞跃。在 BigANN-1B 数据集上,该聚类步骤在单节点上仅仅花费了 380 秒(约 6.3 分钟),在 Deep1B-1B 上也仅用了 614 秒。但正是这几分钟的低维局部聚类,在索引构建阶段为每个桶预先建立了细粒度的结构屏障。实测表明,在相同 Recall@10 表现下,桶内聚类直接将端到端检索吞吐提升了最高 4.57 倍,并将后续需要全精度精排的候选向量数量压缩了最高 4.68 倍。这种“在低维局部空间用极小代价做预整理,换取查询时海量计算规避”的思路,展现出极强的系统工程智慧。
Logit 引导与校准早停:掌控计算预算的查询引擎
当索引组织完毕,真正的挑战留给了在线查询阶段:如何在毫秒级的严苛预算下,决定探索哪些桶、探测哪些中心、何时果断终止?
NeuRoute 在此充分挖掘了神经网络尚未二值化前的连续激活值——Logits。对于查询向量 $q$,其在潜在空间各维度上的激活值 $\ell_q[j]$ 与阈值 $\tau_j$ 之间的偏离程度被定义为偏差分数(Deviation Score):
\[\delta_q[j] = \vert{}\ell_q[j] - \tau_j\vert{}\]这个看似简单的偏差分数蕴含着极高的信息量:如果 $\delta_q[j]$ 极大,意味着该维度属于确定性极强的“安全位”,翻转该位几乎不可能带来真正的近邻;相反,如果 $\delta_q[j]$ 趋近于 0,说明查询正好落在此维度的判定边界附近,只要轻微扰动便可能跨越到隔壁桶。
NeuRoute 利用动态规划发生器,优先挑选出最不稳定的前 $L_{\text{sel}}$ 个维度,并按照位翻转的累积代价对候选哈希地址进行动态分组与优先级排序。查询过程不再受制于机械的汉明半径,而是由 Logits 驱动的置信度引领,优先探查那些收益最高的相邻桶。
随后,系统进入聚类中心阶段的筛选(Centroid-Stage Selection),并部署了两道精密的防护锁:
-
校准距离门控(Calibrated Centroid Gating):系统在离线阶段基于验证集预先拟合出一条数据驱动的单调分段线性裕度曲线 $\mathcal{M}(x)$。在遍历各桶的局部聚类中心时,若某个中心与查询的距离超过了“当前已见最优距离 + 动态裕度”,该中心及其辖下的所有向量就会被立即丢弃,绝不流入后续阶段。
-
堆质量驱动的早停(Heap-Quality Early Stopping):系统内部维持着一个候选优先堆。随着高优先级桶的中心被依次处理,系统持续监测堆顶元素的质量演变。一旦新探查的聚类中心已无法对当前堆构成有效置换,或者边际收益跌破阈值,算法会立即中断对后续低优先级哈希桶的扫描。
经由此番层层阻击,流向最终精排(Exact Refinement)阶段的候选向量已经被压缩至极度紧凑的范围。整个检索流水线用 C++ 配合 CSR(Compressed Sparse Row)内存紧凑布局原生实现,向量距离核函数充分利用 SIMD 并行加速,将计算预算牢牢控制在毫秒以内。
十亿级实测:打破“慢构建”宿命的高效检索
为了检验这一套设计的实际效能,NeuRoute 在通用的标准十亿级基准 BigANN-1B(10 亿 128 维向量)与 Deep1B-1B(10 亿 96 维向量)上进行了严苛的单节点评测。
在索引构建耗时上,NeuRoute 交出了一份令人瞩目的成绩单。在典型的单台机器资源下,包括轻量神经网络训练、潜在编码推理、构建二进制倒排索引以及在潜在空间完成桶内聚类,整个端到端(End-to-End)的全流程在 BigANN-1B 上仅耗时 0.82 小时,在 Deep1B-1B 上仅耗时 0.93 小时。作为对比,传统的十亿级图索引往往需要数小时乃至数十小时的离线计算,工业级调优的 IVF-PQ 变体光是收敛全量量化器和完成倒排落盘也往往动辄数小时。NeuRoute 首次在十亿规模下证明了“单机 1 小时内全量重建高性能索引”的可行性。
在在线检索性能方面,NeuRoute 彻底摆脱了传统哈希“召回惨淡”的刻板印象。在 BigANN-1B 上,NeuRoute 在吞吐量达到 2,414 QPS 的极速状态下,取得了高达 90.3% 的 Recall@10。在同等的高精度召回水准下,NeuRoute 的端到端查询速度是工业界强力基线 OPQ+IVF-PQ (refine) 的 1.7 倍。
消融实验进一步证实了各个系统组件的贡献度。在引入堆质量驱动的早停机制后,系统在几乎没有损失召回率的前提下,直接换来了 1.5 倍至 1.7 倍的 QPS 净增益;而桶内低维聚类的引入,更是一举化解了单桶向量堆积引发的精排拥堵,带来了数倍的算力节约。
总结与工程启示
从本质上看,NeuRoute 代表了大规模向量检索领域一种清晰的务实思潮:不再迷信单一数据结构或单一大模型的“全能表现”,而是依据现代硬件与系统运行规律进行分层治理。
这项工作给工程界带来了三点极具价值的启示:
-
哈希的真正归宿是粗粒度神经路由:在十亿乃至百亿级检索中,强求哈希编码直接输出高质量 Top-$k$ 往往事倍功半。将其退行一步作为极速、紧凑的路由前置层,能以极小的内存占用替代传统笨重的第一级倒排网格。
-
拒绝盲目二值化,善用模型的内部信号:神经网络不仅输出结果,还输出了置信度分布。在进入离散世界之前,Logits 所携带的边缘不确定性是系统进行自适应探索(Adaptive Probing)最天然、最廉价的度量衡。
-
分阶段降维与局部治理是兼顾建索速度的关键:避免在全量原始高维数据上硬抗全局聚类与全图构建。把高难度几何对齐前置到轻量网络内部,把聚类下放到低维潜在空间的独立局部桶内,才能彻底释放建索流水线的并行潜力,实现十亿级索引的高频重建。
在检索增强生成(RAG)、多模态大模型底座和实时风控推荐对向量更新频率要求越来越苛刻的今天,NeuRoute 展现出的“单机亚小时建索”能力,无疑为下一代轻量化、高可用的海量向量检索系统提供了一条极具工业落地潜力的实现范式。