MathForm:知识检索+验证迭代,8B小模型形式化准确率反超32B
MathForm: Scaling Mathematical Autoformalization with Knowledge Retrieval and Verification-Guided Refinement
大模型形式化定理证明(Formal Theorem Proving)在过去一年中突飞猛进,从 AlphaProof 到 DeepSeek-Prover-V2,机器在 Lean 4 等形式化语言环境中展现出了极高的求解上限。然而,整个技术链条正面临一个严峻的前提瓶颈:形式化训练数据极度匮乏。人类历史上绝大部分高价值数学知识都以自然语言写在论文、专著和教科书中,要将这些非结构化文本大规模翻译为机器可验证的 Lean 4 代码,即“自动形式化”(Autoformalization),成了驱动下游证明系统进化的核心引擎。
ArXiv URL:https://arxiv.org/abs/2608.14221v1
当前的自动形式化方案普遍陷入了一种“两难困局”。一方面,主流方案将翻译完全寄托于大模型的内部参数化记忆,但 Lean 4 的核心库 Mathlib 体系庞大、抽象层次极高且版本持续演进,单纯依赖参数记忆极易产生幻觉,虚构不存在的引理或类型;另一方面,在合成形式化数据时,业界多采用“单次生成加事后过滤”(Best-of-$N$)策略,只有通过或拒绝两个极端,系统缺乏诊断与纠错机制,导致生成上限被锁死在模型的单次推理能力之内。
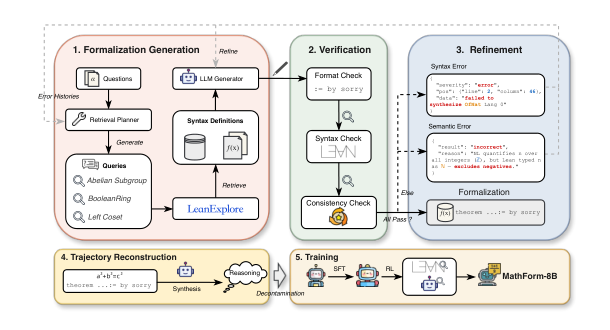
为了打破这一僵局,来自面壁智能(ModelBest)与清华大学的研究团队提出了 MathForm 框架。该研究彻底颠覆了“一次性黑盒翻译”的旧范式,将自动形式化重构为“检索规划—编译器诊断—语义一致性校验—多轮修正”的闭环系统。利用这一流程,团队合成了包含约 36.7 万条高质量样本的 Lean 4 数据集 FormalVerse。在此基础上,通过监督微调与强化学习训练出的 MathForm-8B,在六大主流基准测试上以 88.06% 的语法通过率和 72.37% 的语义一致率,全面超越了此前参数量达 32B 的专有形式化大模型。
为什么单纯“翻译”搞不定形式化数学?
把一段自然语言数学命题翻译成 Lean 4 代码,难度远高于通用的代码生成。通常意义下的代码只要逻辑闭环、通过编译器即可;但在形式化数学中,一个看似完美的 Lean 4 命题即使能够 100% 编译通过,也极可能在数学意义上彻底“跑偏”。
最常见的失败模式在于隐式约束的丢失与类型的误配。例如在抽象代数中,自然语言常写“设 $R$ 是一个环”,而在 Mathlib 中,环根据性质被拆解在复杂的类型类层次结构(Typeclass Hierarchy)之中,模型稍有不慎就会丢掉交换律假设,或者把群作用的定义引用成另一个不兼容的结构。更致命的是条件强化的幻觉:模型为了让命题在形式系统里自洽,往往会在输出时悄悄加上更强的预设条件,甚至在结论中偷换概念。
以往的自动化数据构建流程主要依赖 Best-of-$N$ 采样。这种做法本质上是在模型既有的单次输出概率分布里“撞大运”。判别器(无论是编译器还是打分模型)只能给出 0 或 1 的二元裁决,既无法指出哪一个量词放反了位置,也无法指导生成器针对性地修复。这直接导致现有的形式化数据集严重偏科,绝大多数集中在初高中数论或初等代数竞赛题,一旦面对前沿的交换代数、同调代数或代数几何,单次采样成功率几乎断崖式下跌归零。
MathForm 核心机制:闭环检索与验证引导的精细打磨
针对上述痛点,MathForm 提出了一个包含“知识外挂”与“细粒度纠错”的闭环架构。整套流程分为两个相互强化的阶段:高质量数据合成引擎,以及随后的模型单次生成能力蒸馏。
在数据合成阶段,系统并不强求模型在单次前向传播中同时完成信息检索、概念对齐与代码编写,而是解耦为检索规划器(Retrieval Planner)与形式化生成器(Formalization Generator)。面对输入的自然语言命题,检索规划器首先对其数学对象、依赖关系与类型约束进行语义解构,主动判断是否需要外部知识;若需要,则通过 LeanExplore 对 Mathlib 发起精准检索,调取 Top-2 最相关的标准定义、定理和现有形式化片段。生成器随后结合原始命题与检索结果写出候选 Lean 4 代码。这一设计使系统摆脱了对参数记忆的死记硬背,显著降低了命名和类型幻觉。
紧接着,生成的代码进入多轮验证打磨循环。这一过程包含两道严苛的关卡:
第一道是 Lean 4 编译器诊断。如果代码报错,编译器报出的语法错误、未定义符号或类型不匹配信息会被直接提取为结构化反馈。
第二道是语义一致性校验(Consistency Check)。即使代码顺利通过编译,系统仍会调用大语言模型(论文中采用 QwQ-32B)作为语义裁判,逐行比对自然语言原命题与生成的 Lean 4 命题,重点审查六类致命缺陷:遗漏先决条件、强化或弱化条件、量词顺序颠倒、引入冗余约束、数学对象概念错位、结论不一致。
一旦两道关卡中的任意一项未通过,系统就会将具体的错误信息连同原始问题打包送入下一轮修正,必要时重新触发 Mathlib 检索。每道题目最多经历三轮迭代,一旦双重验证全部通过便立即终止。
这种自适应的容错修复机制带来了极高的数据回收效率。数据统计表明,在最终保留的高质量形式化代码中,首轮直接通过的仅占 69%,而第二轮和第三轮迭代分别贡献了约 20% 和 11% 的有效数据。这意味着,整整 31% 的高质量形式化样本是原本单次生成策略根本无法获取的高难度数据。系统的上限不再被单次生成的能力所绑架,而是被整套多轮修正工作流大幅拔高。
轨迹重构:摆脱推理模型的“话痨”与跑题
拿到了多轮迭代修补成功的代码,并不能直接作为监督微调(SFT)的训练标签。多轮对话中充斥着编译报错信息、试错片段和检索上下文,信息噪声极大。此外,当前强大的推理大模型在接受指令时往往存在行为惯性——即使系统只要求翻译命题,模型在内部思维链(CoT)中也会不由自主地推演证明策略,甚至尝试将整个定理直接证明出来。这种推理偏离了自动形式化任务的本质,会严重浪费模型的有效上下文。
为了解决这个问题,研究团队引入了轨迹逆向重构(Trajectory Reconstruction)技术。在获得验证无误的 Lean 4 最终代码后,让模型根据“自然语言输入”与“标准形式化输出”,逆向生成一段清晰、结构化的形式化推理轨迹。这段轨迹被严格约束为仅分析数学对象拆解、逻辑结构映射、变量作用域与 Mathlib 隐式类型约束推演,显式剔除任何后续的证明战术(Tactics)和求解步骤。
经过这套清洗与轨迹重构,再剔除与测试集存在 13-gram 重合的数据完成去污染后,团队打造出了包含约 36.7 万个样本的高纯度形式化数据集 FormalVerse。这个数据集涵盖了从经典微积分、线性代数到抽象代数、组合数学的广泛领域。
两阶段对齐:将复杂闭环能力内化为 8B 单次直觉
拥有了 FormalVerse,下一步是如何将这套复杂的“检索—编译—修正”系统级能力,压缩进一个轻量级的 8B 参数模型内部,使其在单次推理时就能展现出高鲁棒性。研究团队设计了平滑的“SFT + RL”两阶段训练范式。
首先,模型以 Qwen3-8B 为基座,在 FormalVerse 上进行全参数监督微调,得到 MathForm-8B-SFT。这一阶段的核心目标是让模型掌握自然语言数学概念与 Mathlib 复杂类型系统的原生映射直觉,学会按照结构化轨迹分解命题。
随后,模型进入强化学习阶段。与许多常见的强化学习依赖启发式打分不同,形式化任务天然具备客观的判别依据。研究团队筛选了约 3,000 道在初期数据合成中未能在 3 轮内通过、但难度适中且表述无歧义的候选难题作为强化学习训练集。算法层面采用了 DAPO(Decoupled Clip and Dynamic Sampling Policy Optimization)策略,奖励函数直接锚定形式化任务的核心红线:
\[r(x, y) = 1 \iff C(y) = 1 \land S(x, y) = 1\]只有当生成的代码 $y$ 既能通过 Lean 4 编译器 $C(y) = 1$,又在语义一致性校验模型判定下与原题完全吻合 $S(x, y) = 1$ 时,才给予奖励值 1,其余情况全部为 0。
这种硬性的联合二元奖励极为严苛,它强迫策略模型不能为了图省事而输出容易编译但语义变形的“空洞命题”,也不能只追求表面语义符合而引入编译报错的虚构语法。在强化学习训练轨迹中,模型在测试集上的平均奖励与高难代数基准 FATE-H 上的通过率呈现高度平行的稳步上扬,这意味着模型真正学到了如何在严谨的语法约束和原题语义之间达成精准平衡。
实验评测:8B 模型跨级击败 32B 专有系统
为了全面检验能力,研究团队在六大权威基准上对 MathForm-8B 进行了极限测试,涵盖初等与竞赛级的 FormalMATH-Lite、ProverBench,组合数学基准 CombiBench,以及代表高阶现代数学的 FATE 矩阵(包含初等抽象代数 FATE-M、高等交换代数 FATE-H、同调代数与代数几何基础 FATE-X)。
评估指标采用严格的 Pass@8,即每个输入采样 8 个候选解,分别统计语法通过率(Syntax Check, SC)和语法与语义双达标的一致性通过率(Consistency Check, CC)。
在综合 6 个基准的宏观平均指标上,MathForm-8B 取得了 88.06% 的 SC 和 72.37% 的 CC。这一成绩大幅刷新了此前由 ReForm-32B 保持的同类专用模型最高纪录(81.61% SC / 68.41% CC)。一个仅有 8B 参数的模型,在严苛的语义一致性指标上反超了 32B 规模的专用强基线 3.96 个百分点,在语法编译率上领先了 6.45 个百分点。
尤其值得关注的是优势集中的领域。在相对成熟、模式化程度较高的竞赛题集(如 FormalMATH-Lite 和 ProverBench)上,各家主流专用模型的分数已经逼近天花板,MathForm-8B 保持微弱领先;但在真正考验对 Mathlib 深度依赖的高抽象领域,差距被成倍拉开:
在 FATE-M 上,MathForm-8B 的 CC 通过率达到 97.33%,领先最强基线 6 个百分点;
在 FATE-H(高等代数)上,CC 通过率达到 63.00%,领先最强基线 10 个百分点;
在极度硬核的 FATE-X(同调代数与代数几何)上,CC 通过率达到 37.00%,将此前专有基线死死压制在 25% 以下的局面打破,带来了 12 个百分点的绝对领先。
这种难度越高、领先优势越大的反直觉表现,恰恰印证了 MathForm 核心设计的有效性。抽象代数是公认最需要 Mathlib 庞大类型层级支撑的领域,靠小模型死记硬背参数几乎不可能写对。而 FormalVerse 数据集在合成时就已经通过检索和多轮纠偏打通了这些深水区,并将这种高级形式化经验内化进了 8B 模型的生成分布中。
消融分析:检索与验证并非简单的“1+1”
为了探究系统各个模块的真实贡献,作者在 FATE 系列基准上进行了细致的剥离实验,不仅测试了 120B 规模的模型,还跨模型家族引入了 Qwen3-235B 进行验证。
对比单次直接生成、同等计算预算的单轮采样($N=3$ 的 Best-of-$N$)、仅带检索不迭代、以及仅多轮反馈不检索四种组合,实验呈现出极具启发性的规律:
单纯依靠增加采样次数(Best-of-$N$),对高难抽象题目的提升微乎其微。因为如果底层能力无法理解高阶类型约束,采样 3 次只是把同质化的错误复现了 3 遍。
仅有检索虽然能补充概念,但常常因为局部语法错误折戟在编译阶段;仅有多轮反馈虽然能不断纠错,但缺乏外部真实知识源时,模型极容易在错误的方向上反复无效打补丁。
只有当“知识检索”提供正确的 Mathlib 上下文,与“编译器+语义双重校验反馈”紧密结合时,系统的性能才产生质变。在 FATE 整体平均通过率上,完整 MathForm 流水线相比单次生成,在不同生成基座上分别实现了 22 到 30 个百分点的跳跃式增长,且显著压倒了任何单一组件的提升。
另一个关键实验在于数据集的纯度对比。研究人员将 FormalVerse 与近期公开的 NuminaMath-LEAN、FineLeanCorpus 分别抽取 100K 样本,在完全相同的超参数与模型架构下从零训练 Qwen3-8B。结果发现,三个数据集训练出的模型在编译通过率(SC)上几乎不相上下(均在 77%~78% 附近),但在衡量数学意义是否失真的语义一致率(CC)上,FormalVerse 训练出的模型达到了 60.32%,直接拉开 FineLeanCorpus 13.79 个百分点,超越 NuminaMath-LEAN 达 18.83 个百分点。这一数据揭示了形式化领域的残酷事实:单纯依靠代码能跑通来清洗海量数据,会注入大量“形式正确但题意完全偏离”的伪劣样本;缺乏语义一致性把关的数据飞轮,无法训练出具备真正数学直觉的形式化系统。
总结与展望
MathForm 的工作为形式化数学研究提供了一个极具参考价值的范本:自动形式化的本质不是单纯的端到端语言翻译,而是一个强知识驱动、需要反复验证和自我纠偏的工程闭环。
通过将 Mathlib 知识检索与细粒度反馈注入数据合成回路,MathForm 不仅构建了高质量的 FormalVerse 数据集,更证明了“小模型也可以精通复杂形式化代数”。这套流程打破了以往依赖超大参数量模型进行暴力记忆的路径依赖,为后续更大规模、全自动的数学知识库构建以及自动化定理证明的冷启动,铺平了一条兼顾数据规模与语义真实性的高可行度道路。