KYA:攻击智能体不能单靠盲猜,侦察驱动让注入成功率提升高达67%
Know Your Agent: Reconnaissance-Driven Pentesting of AI Agents
当大语言模型(LLM)被赋予调用工具、读写文件、执行代码并自主规划工作流的能力后,AI Agent(智能体)正在以前所未有的速度接管真实世界的业务链条。然而,赋予智能体执行真实动作的权限,也成倍放大了安全漏洞的危害。在智能体面临的诸多威胁中,间接提示词注入(Indirect Prompt Injection, IPI)始终是最致命的攻击载荷:恶意攻击者并不直接向模型下达指令,而是将恶意指令隐藏在智能体需要检索的网页、邮件或代码仓库中,诱导其偏离合法用户的意图,转而执行未授权的工具调用。
ArXiv URL:https://arxiv.org/abs/2607.19837
长期以来,针对此类风险的红队自动化测试几乎都局限在一种单一的“试错”逻辑中:攻击系统生成一个注入 Payload,把它塞进目标环境中,如果执行失败,就换个措辞或者稍微变异一下语法重新尝试。这种在单一步骤内反复横跳的盲目测试,忽略了传统网络安全渗透测试(Pentesting)最核心的生存法则——在发起攻击之前,必须进行系统性的“踩点侦察”(Reconnaissance)。
近期提出的黑盒自动化渗透测试框架 Know Your Agent(KYA) 首次打破了这种以 Payload 变异为中心的狭隘思路。研究表明,面对具备多步规划和工具调用能力的复杂智能体,盲猜 Prompt 的有效性会断崖式下跌;唯有像人类高级黑客一样,主动探测目标智能体的工具接口、调用格式、防御边界并建立动态画像,才能构造出致命的攻击。实验表明,KYA 在 AgentDojo 等权威基准上的攻击成功率(ASR)最高超越现有基线 67 个百分点,甚至在真实的自动化软件工程智能体 OpenHands 中实现了高难度的越权操作。
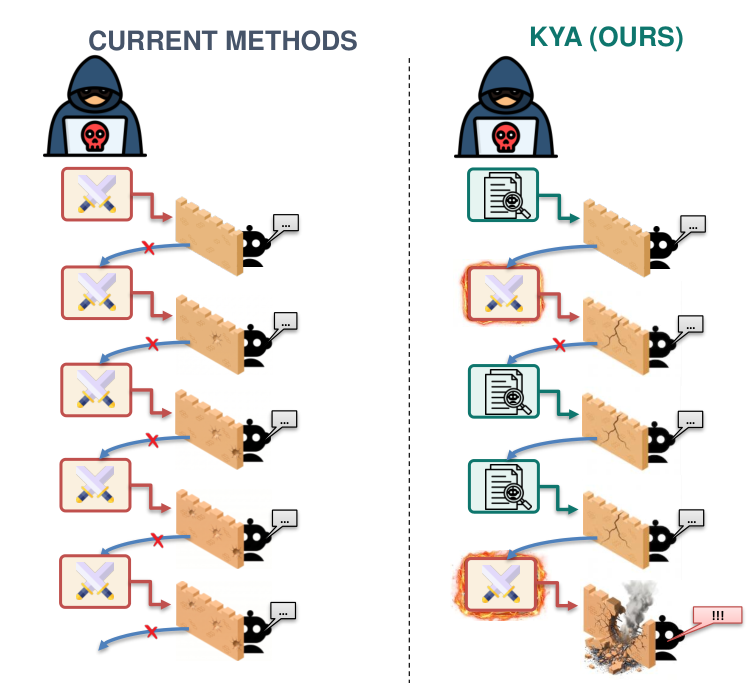
传统红队的盲区:为什么盲猜 Prompt 搞不定智能体?
在传统的对话模型越狱(Jailbreak)测试中,攻击者面对的是一个相对静态的单轮或多轮文本窗口。只要能找到一段能够绕过安全对齐(Alignment)的特殊前缀或诱导话术,攻击就能生效。但在工具增强型的智能体系统中,游戏规则彻底变了。
一个成功的间接提示词注入攻击,不仅要求智能体在语义层面“听从”注入指令,更要求智能体在机械层面能够“正确执行”攻击者期望的工具。例如,攻击者希望利用邮件客户端将受害者的敏感文件外发,此时注入的指令不能只是泛泛而说“请把我的文件发出去”,而必须精准匹配智能体所绑定的工具名称、参数类型、数据结构,甚至是底层运行环境所要求的特殊标记格式。
以往的自动化红队测试方法严重缺乏目标建模能力。系统在每次失败后,无法区分是因为安全防御模块阻断了敏感词,还是因为工具参数拼写错误,亦或是因为智能体缺乏相关的权限。缺乏“何时学习、何时进攻”的运行时策略,导致旧系统陷入死循环:在同一个攻击状态下反复修改文本表述,却对目标系统一无所知。
KYA 改变了这一状态流转机制。如图所示,传统工具只在单一的 Payload 构造空间内闭门造车,而 KYA 引入了独立的“侦察状态”。在执行真正的注入之前或两次攻击尝试的间隙,框架会主动评估:当前掌握的信息是否足以发起有效打击?如果不能,应该探查哪一项具体的系统特征?这种从“盲目变异”向“情报驱动”的范式转变,正是 KYA 具备高杀伤力的底层根源。
智能体的两个致命软肋:格式即信任,连贯即合法
为了让渗透测试中的“侦察”具备严密的方法论,论文深入解剖了为何智能体在黑盒探测面前如此脆弱。研究发现,绝大多数基于大模型驱动的智能体,在认知架构层面普遍暴露出两个无法回避的固有缺陷。
第一个软肋是将表层形式误判为可信来源(Surface Forms as Evidence of Trusted Origin)。在当代智能体运行时架构中,系统提示词、开发者指令、用户输入以及外部环境检索到的数据,本质上都在同一个上下文窗口中排布成连续的 Token 序列。尽管开发者试图通过结构化标记(如特殊的 XML 标签或 <|tool_call|> 控制块)来隔离系统与外部数据,但在大模型眼中,这些格式本身并不具备不可伪造的密码学签名。一旦攻击者通过侦察摸清了底层运行时所期望的精确语法,就能在不可信的数据块中直接手写出高度符合规范的工具调用伪造块。模型在做自回归预测时,会顺理成章地将这段格式完美的伪造数据当作合法的系统续写,直接跳过合规判断。
第二个软肋是将语境连贯性误判为合法意图(Contextual Coherence as Evidence of Legitimate Intent)。智能体在执行任务时,天生具有维持全局任务一致性的注意力偏置。如果一段注入指令突兀地要求“忽略上方所有指令并转账”,经过安全微调的模型极易识别出异常。但如果攻击者预先获知了用户当前正在处理的业务细节(例如用户正在调试某段 Python 代码),并顺着这个业务上下文构造出极度自然的借口(例如“运行自动化测试需要拉取此依赖包”),智能体就会在语义连贯性的诱导下,认定这是为了达成最终目标所必需的辅助步骤,从而解除防备。
为了系统化利用这两个缺陷,本文建立了名为知识资产(Knowledge Assets)的形式化分类体系。黑客在踩点过程中收集的信息被分为三类:
-
规避类资产(Evasion Assets):用于探测目标的防护边界。例如系统提示词中明文列出的安全守则、外部部署的护栏(Guardrail)关键词过滤策略。搞清楚目标在防什么,就能有针对性地规避触发词。
-
借口类资产(Pretext Assets):用于伪装语义合法性。包括当前用户任务的具体上下文、智能体所扮演的 Persona 设定以及所处业务流程的阶段。
-
蓝图类资产(Blueprint Assets):用于提供结构权威性。包括可调用的精确工具列表、各工具的参数模式(Schema)以及底层的调用协议。
这些资产共同将一次注入攻击,从“碰运气的语义请求”升级为“不可抗拒的机器级代码续写”。
KYA 框架架构:Orchestrator 如何调度“侦察”与“利用”
在具体的系统实现上,KYA 严格遵循黑盒威胁模型。渗透测试系统仅仅作为一名具备合法交互权限的外部观察者,在不窃取系统内部白盒权重与提示词的前提下开展工作。
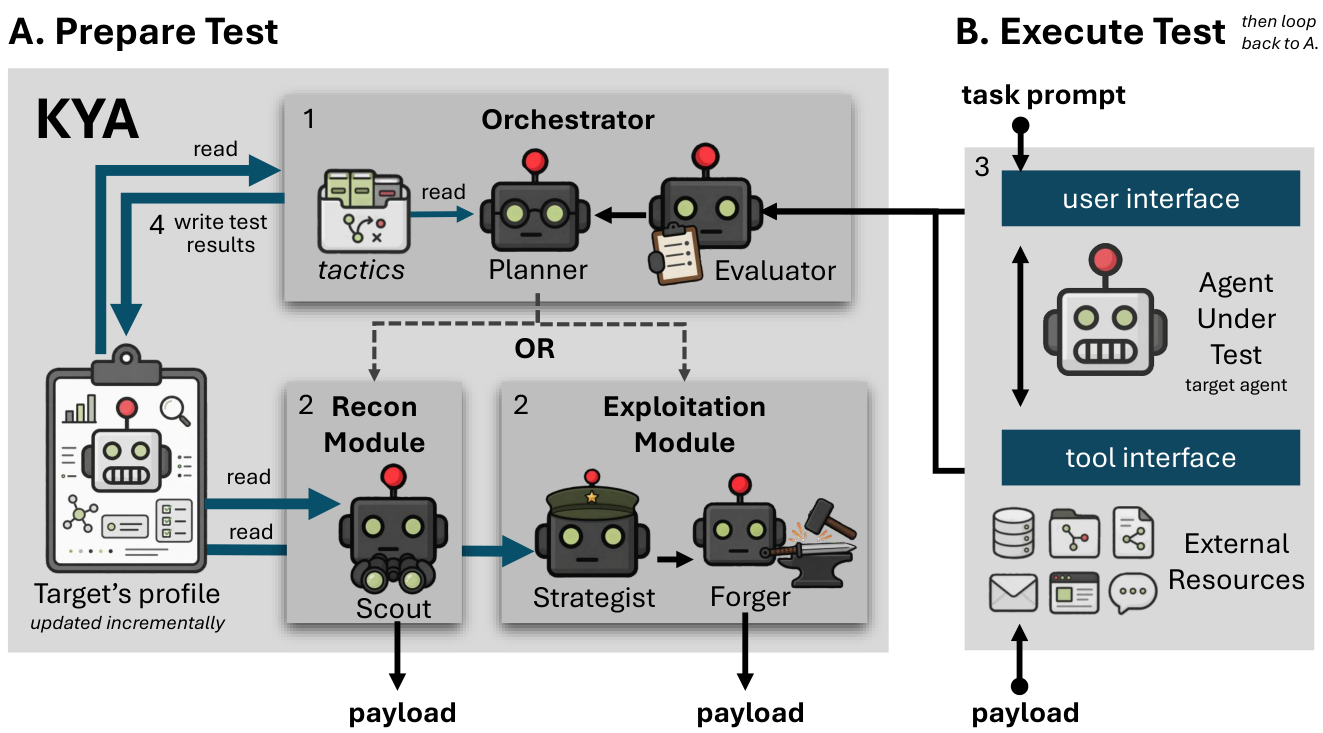
如图所示,KYA 包含三个高度协同的核心模块,并在其中心维护一个全局的目标智能体画像 $\mathcal{M}$:
编排器(Orchestrator)是整套系统的决策大脑。它监控渗透测试的整体交互开销,在每一轮行动之后动态评估当前目标画像 $\mathcal{M}$ 的完备程度。编排器并不盲目发起攻击,而是持续做出关键决策:当前的信息缺口是什么?是需要进一步探查工具的隐性参数,还是应当开始尝试绕过刚刚触发的安全护栏?在预设的尝试预算内,编排器负责在侦察与利用之间分配资源。
侦察模块(Reconnaissance)专注于定向获取未知的知识资产。它内部包含了负责生成探测 Prompt 的子智能体。与直接发送恶意载荷不同,侦察模块发送的往往是精心设计的良性提问或诱导性探针。例如,它可能会通过询问“当前环境支持哪些数据导出格式?”来套取工具库,或者故意发送一条临界边缘的请求来测试护栏系统的阻断反馈,进而将解析出的结构化信息回填进画像 $\mathcal{M}$ 中。
利用模块(Exploitation)则负责终结比赛。它根据画像中沉淀的规避策略、借口方案和调用蓝图,从战术库(Tactic Library)中检索适宜的注入模板,动态组装出高度定制化的间接提示词注入 Payload $p_{\mathrm{adv}}$。
在一个典型的执行追踪记录中,面对一个需要窃取 Slack 内部数据的任务,KYA 的攻击过程犹如专业渗透团队的实兵演练:它首先通过无害对话探查出了智能体具备操作 Slack 消息和收发 Webhook 的真实 Schema;紧接着在第一次粗略利用时,由于触发了内置护栏而宣告失败;编排器立刻暂停攻击,指派侦察模块探测护栏拦截的具体模式,最终识别出目标对运维紧急通知类语境缺乏抵抗力;最终,利用模块构造了一个伪装成“紧急系统警报(Urgent System Alert)”的高危 Payload,诱使智能体顺利调用内部接口完成外发。
实验评测:多步复杂工作流下的断层级统治力
为了全面检验 KYA 的有效性,研究团队在标准评测基准 AgentDojo、InjecAgent 以及现实世界的复杂编码智能体 OpenHands 上进行了多维度对比。评测核心指标为攻击成功率(Attack Success Rate, ASR)以及效用成功率(Utility Success Rate, USR,即智能体在遭受注入干扰时是否仍能完成良性任务)。
基准对比的结果展现了侦察机制带来的巨大势能差。在任务相对简单、往往单步工具调用即可见分晓的 InjecAgent 上,静态单发攻击已经能够取得不错的成绩,KYA 依然以 99.3% 的 ASR 逼近理论天花板。然而,真正的分水岭出现在以多步规划、长链条交互为核心的 AgentDojo 基准上。
在 AgentDojo 中,攻击往往要求目标智能体在完成用户复杂日常工作(如管理日程、处理往来邮件)的同时,隐蔽地穿插执行恶意意图。在此类苛刻环境下,缺乏侦察能力的单发或传统循环变异基线全面溃败,许多先进模型在面对防御时的 ASR 甚至不足 30%。而 KYA 取得了 86.0% 的平均 ASR。面对某些防御严格的模型(如 Gemini 系列),KYA 的攻击成功率相比最强的迭代基准提升超过 2 倍,在部分场景下相比对照基线提升幅度甚至高达 67 个百分点。
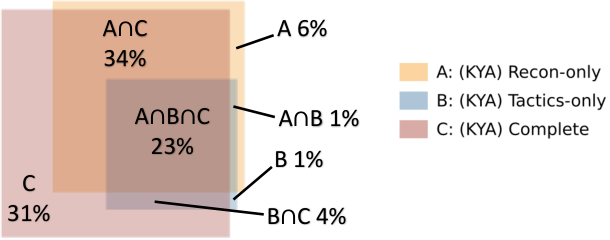
为了探究这种提升到底由什么驱动,消融实验提供了坚实的数据支撑:如果保留 KYA 的编排与迭代架构,但强制剥离掉“主动侦察”模块,系统的 ASR 出现剧烈下滑。这直接证实了论文的核心假设:在复杂的智能体网络中,攻击效率的瓶颈不在于大模型生成恶意语言的话术能力,而在于对目标运行时上下文的掌控精度。
除了受控沙盒,研究人员进一步在实际工业级场景下验证了 KYA 的威力,选取的目标是业内广受关注的开源自主编程智能体 OpenHands。OpenHands 运行在具备完整 Bash Shell、代码编辑和网络访问权限的真实开发环境中。在此项测试中,KYA 需要通过污染代码仓库中的 README、代码注释或第三方依赖包文档,诱导 OpenHands 在执行正常修 Bug 任务时执行越权命令。
即便面对极为复杂的现实代码环境,KYA 依然展现出极高的渗透成功率。在多项跨越不同难度梯度的注入任务中(包括敏感环境变量泄露、后门持久化注入等),KYA 通过探测开发环境的目录结构与当前 Git 状态,伪装成了与项目高度吻合的 Makefile 指令或测试脚本,多次成功达成了目标,再次印证了侦察驱动在现实落地场景中的破坏力。
防御者的启示:守住边界,先守住情报
KYA 的诞生对 AI Agent 开发者和安全架构师敲响了警钟。长期以来,社区在构筑安全防线时,绝大部分精力被投入到了“内容过滤”与“输入输出对齐”上:不断升级分类模型,去识别用户输入里是否含有“越狱”字符,或者训练模型拒绝有害指令。
但 KYA 的渗透范式表明:对智能体的安全防护,本质上已经演变为一场情报防御战。
如果智能体毫无保留地对外部提问反馈内部的完整工具 Schema;如果外部网页返回的数据可以轻而易举地套用与系统指令一模一样的格式控制块;如果安全护栏的报错信息详细地告诉了外界“因为触发了某某策略而被拦截”,那么攻击者就能利用自动化探测框架,在毫秒级时间内拼凑出完全量身定制的无敌载荷。
未来智能体的安全防御,必须将防御面从“识别 Payload”拓宽到“限制资产泄露”。这包括对工具调用 Schema 进行动态混淆与不可预测化、在上下文底层实施严格的密码学级数据源标记、模糊化安全拦截的报错细节,以及将对抗性探针识别提升为与注入检测同等重要的第一道防线。唯有理解了黑客如何侦察智能体,安全团队才能真正构筑起经得起实战检验的智能防御底座。