InMind:直接问倒背如流却频频踩雷?揭秘Agent记忆的隐式关联盲区
Keep It InMind: Benchmarking the Implicit-Association Blind Spot in Agent Memory
如果你直接询问一个搭载了长期记忆系统的 AI 助手:“我对什么食物过敏?”它大概率能一字不差地回答:“坚果。”然而,几周之后,当你兴致勃勃地问它:“能不能给我一个地道的马卡龙烘焙食谱?”这位助手很可能会热情洋溢地列出食材清单,首当其冲的就是杏仁粉——而杏仁正是最典型的树坚果过敏原之一。
ArXiv URL:https://arxiv.org/abs/2607.24368v1
这并非凭空捏造的段子,而是当前所有长期记忆系统面临的系统性溃败。由中国科学技术大学与 Metastone Technology 联合提出的最新研究《Keep It InMind》,揭示了隐藏在几乎所有大模型记忆架构深处的“隐式关联盲区”(Implicit-Association Blind Spot)。
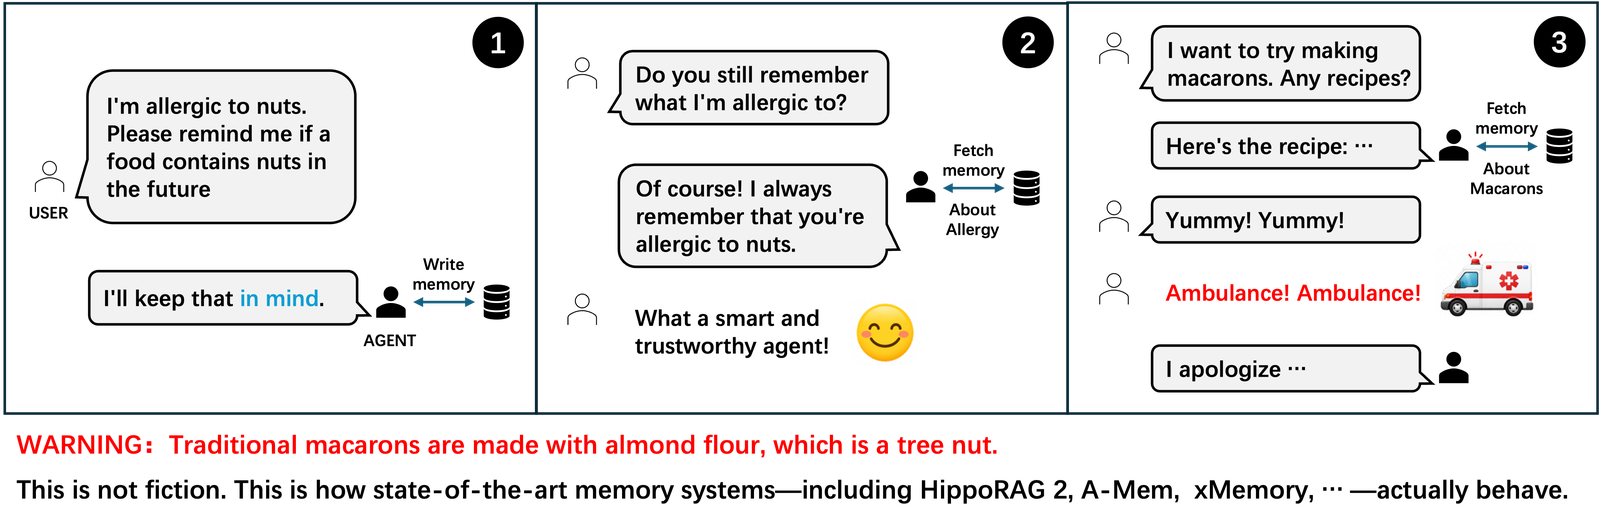
这项研究的核心结论极其鲜明:在他们提出的包含 125 个高保真任务的 InMind 基准上,涵盖向量库、知识图谱与自主 Agent 规划等不同范式的 6 款主流记忆系统,直接询问原始事实时准确率可高达 100%,但在需要借助常识进行隐式关联的实际场景下,应用成功率最高仅有 14.4%。与此同时,如果将关键记忆直接强行塞进上下文窗口,底层模型能够轻松完成 84.0% 的间接推理。这意味着,模型既没有遗忘,也不缺乏常识推理能力,而是现有的检索接口在架构逻辑上就从根源处阻断了正确记忆的浮现。
潜伏在检索式记忆底层的隐性假设
要理解为什么最先进的 Agent 记忆系统会在马卡龙面前翻车,必须重新审视目前主流记忆系统通用的工作流程。
无论具体实现是一个简单的向量数据库、复杂的图数据库,还是支持多轮反思的 Agent 记忆体,系统与记忆的交互形式本质上高度统一:记忆写入模块把用户说过的话提炼成外部存储中的片段,当新的用户提问 $q$ 到来时,系统通过检索函数挑选出一组候选记忆 $\hat{\mathcal{M}} = \mathrm{Retrieve}(\mathcal{M}; q, \theta)$,然后将候选记忆和提问一同送入大语言模型生成回答 $a = \mathrm{LLM}(q, \hat{\mathcal{M}})$。
这个设计范式之所以被整个行业不假思索地采纳,是因为它默认了一条看似不言自明的公理——检索假设(Retrieval Hypothesis):只要某条记忆 $m$ 是回答问题 $q$ 所必需的,那么 $m$ 在某种仅依据 $q$ 计算的相似度度量下,必然与 $q$ 足够接近。
在显式召回的场景下,这个假设完全成立。当用户问“我对什么过敏”时,问题本身就携带了“过敏”这一强检索线索。然而,一旦进入真实生活的决策链条,现实世界充斥着大量“隐式关联”:
-
记忆改变了后续提问的正确答案(坚果过敏意味着不能推荐常规马卡龙);
-
提问本身对该记忆没有任何字面或语义提及(提问只提到了马卡龙);
-
建立二者联系所必需的桥梁知识,完全独立于两次对话之外,只存在于外部世界常识中(马卡龙的正统配方依赖杏仁粉,杏仁属于树坚果)。
这种结构性矛盾注定了检索前置系统的失效。向量检索器把“猫”和“百合花”投射在完全无关的语义空间角落;稀疏检索器找不到任何共享的 Token;即使是图检索器,也只在知识图谱恰好预先构建了对应实体边、且查询主动触发了该实体时才可能工作。
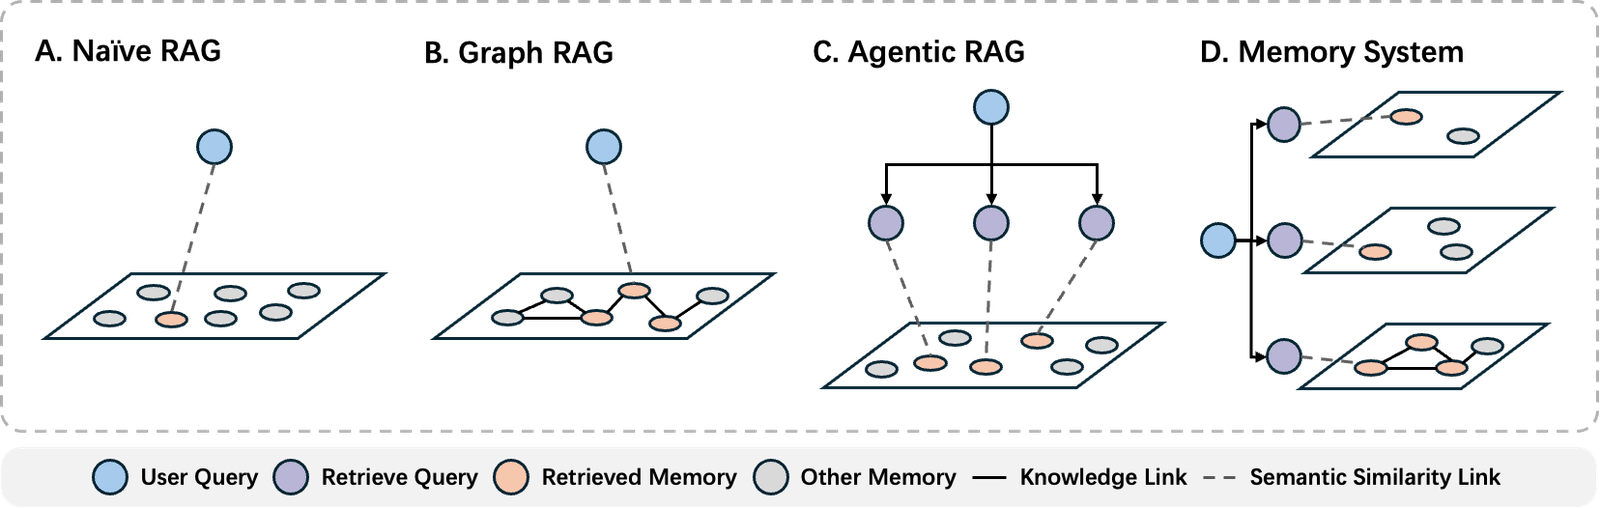
整套架构中最致命的讽刺在于:整个系统中唯一掌握“杏仁是坚果”、“百合对猫有剧毒”等常识的组件是大模型本体,但大模型却被排在检索之后。 检索模块在根本不具备世界知识的前提下,被强行要求去裁决哪些记忆与当前问题“相关”。
InMind:剥离三种混淆变量的精密基准
在现有的长期记忆评估中,当一个 Agent 在间接推理场景中表现糟糕时,研究者通常很难界定失败的根源:究竟是系统在长周期对话中遗忘了事实,还是底层大模型本身过于愚钝、不知道背后的桥梁知识,抑或是记忆明明存在却没能被调取出来?
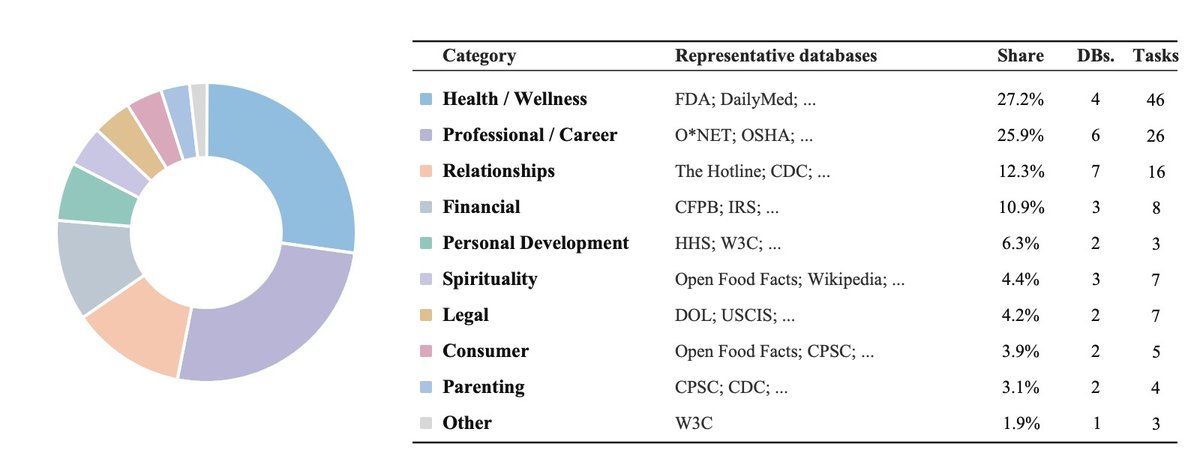
为了把这三个混淆变量彻底剥离,研究团队构建了 InMind 基准。该基准覆盖了个人助理最可能产生关键影响的 10 个现实生活领域,包括食品健康、职业法规、旅行政策、宠物安全等,其中 113 个任务的桥梁知识严格基于公开可查的权威信源(如美国 FDA 过敏指南、OSHA 职业安全条例、USCIS 出入境政策等),确保评价标准不存在主观模糊地带。
为了模拟逼真的长期对话干扰,每一个测试事实被注入到长达 47 个 Session 的真实对话历史(基于 LongMemEval-s)前段,随后让系统经历整整 38 个 Session 的日常闲聊干扰,最后才触发测试。
评估流程被严格拆解为三个互为对照的环节:
首先是直接的简单查询(Naive Query),例如直接问“我的猫叫什么名字/我对什么过敏”,用以检验该事实是否真正被系统写入外存并在长期干扰后依旧存活;
其次是关键的间接查询(Indirect Query),测试系统在面对不含关键词的关联提问时,能否主动调取该事实并纠正决策;
最后是作为理论上限的上下文对照组(In-Context Control),在完全跳过检索模块的前提下,直接把该事实放置在 Prompt 中并抛出间接查询,以此测量大模型在拥有完整信息时调用常识桥梁的真实能力。
此外,研究人员还引入了一个双盲的目标事实召回率(Target Recall)评测:在对间接查询作答时,脱离最终生成的答案文本,直接去审查大模型实际接收到的 Context 窗口内,是否真正包含了那条决定性的目标记忆。
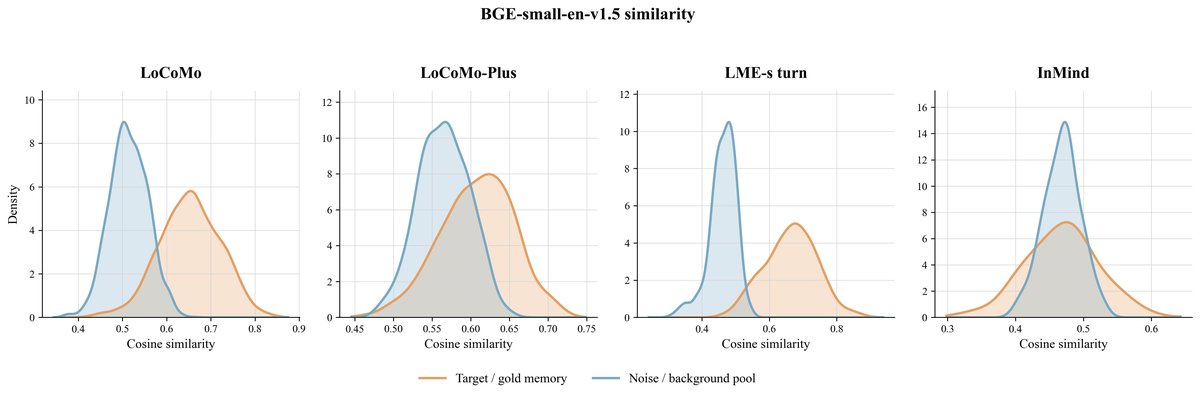
如上图所示,间接查询与目标记忆在向量空间中的相似度,与无关背景噪音的相似度几乎没有显著区分。这种表征层面的天然重叠,直接导致了基于相似度的检索策略在隐式关联任务面前形同虚设。
实验判决:被彻底排除的三大假说
研究团队选取了目前最具代表性的 6 种记忆系统进行全面评测,涵盖向量检索范式(Mem0)、图谱关联范式(HippoRAG 2、A-Mem)、分层状态范式(MemoryOS)以及具备复杂规划与反思能力的 Agentic 范式(A-RAG、xMemory)。实验统一采用 GPT-5-mini 作为后端推理与裁判核心,分别测试了低维轻量嵌入(MiniLM,384维)与高维顶尖嵌入(text-embedding-3-large,3072维)下的表现。
评测结果呈现出一边倒的悬殊落差,并逐一粉碎了过去人们对长期记忆失效的常规猜测。
第一,绝不是大模型推理能力不足。
在 In-Context 对照组中,当目标事实与间接查询同时位于 Context 窗口中时,GPT-5-mini 展现出了极高的常识运用水准,取得了 84.0% 的成功率。五分之四以上的任务中,模型内部蕴含的常识储备足以丝滑地架起“坚果与马卡龙”、“猫与百合花”之间的逻辑跳跃。问题完全出在信息的到达率上,而非模型的理解力。
第二,绝不是记忆在时间跨度中被遗忘。
在简单直接的 Naive 测试中,各大系统的直接召回率表现亮眼,其中 A-Mem 甚至达到了 100.0% 的完美召回,其余系统也普遍处于 80% 至 95% 的高位。这证明写入模块运转正常,长周期的多轮对话干扰并没有冲垮已持久化的数据,记忆系统完全具备“在被明确询问时按图索骥”的存储可靠性。
第三,绝不是单纯依靠增强向量表征就能弥合的问题。
有人可能会寄希望于更强大的 Embedding 模型,认为更高维度的表征能够通过大规模预训练隐式捕获药理学或法律知识。实验数据给出了冷静的回答:将嵌入维度从 384 维暴增 8 倍至 3072 维后,所有系统的目标记忆召回率确实出现了微弱提升(例如 A-Mem 从 2.4% 提升至 12.0%),但端到端的间接应用成功率几乎原地踏步。6 款系统在 3072 维下的最高成绩仅仅停留在 14.4%(MemoryOS),甚至略低于完全无状态的朴素文本分块检索基线 Naive RAG(16.0%)。
这是因为向量表征所捕捉的主要是语言统计共现规律,而决定生活安全与决策底线的规则往往是结构性的药理配伍、跨语境法条或生物毒性,单凭表征空间的连续性,无法填平这道深达 70 个百分点的鸿沟。
第四,更复杂的自主搜索循环同样无法挽救盲目性。
如果单次相似度检索不够,让具备规划能力的 Agent 去反复检索反思是否可行?A-RAG 拥有高达 15 步的动态关键词生成与语义检索预算,然而它在测试中的最终得分仅为 4.8% 与 7.2%,处于全场垫底梯队。
原因在于信息不对称:当用户问出“家里摆百合好看吗”时,Agent 手头的搜索指令依然只能围绕“百合”、“插花”、“家居装饰”展开。如果 Agent 要去检索“用户是否养猫”,它就必须在未看到记忆库内容的前提下,提前未卜先知地假定“百合对猫有毒、对婴儿有害、对某些鸟类致命”这一整套庞大的潜在危害树,并逐一去数据库碰撞验证。这种基于盲猜的试错在算力成本和概率空间上都是难以维系的。
破局点:从“查询时检索”转向“状态路由”
既然沿袭“收到提问 $\to$ 检索记忆 $\to$ 注入上下文”的查询条件化流程注定会撞上隐式盲区的铁墙,那么真正有效的记忆应该以何种形态介入?
研究团队进行了一项极简但具有高度启发性的诊断实验:构建了一个极其朴素的 Always-In-State(常驻状态) 探针。该设计完全不依赖任何运行时检索,仅仅在对话推进过程中,勤勉地维护一个容量有限的结构化用户画像,并确保这些关键画像事实在任何新提问到达之前,就已经常驻在模型的可见上下文窗口之内。
实验结果令人深思:这个甚至称不上完整系统的极简探针,在间接查询任务上的成功率直接从十几分的废墟状态回弹到了 68.8%,直接收复了大部分失地。
这一对比深刻地揭示了未来长期记忆系统的核心演进方向。单纯在检索算法上做文章——无论换用多么昂贵的高维向量、多复杂的图谱遍历还是多冗长的主动搜索——都只是在一条本质受限的死胡同里提高精细度。真正决定 Agent 能否避开灾难性疏漏的关键,在于路由机制(Routing)。
在长程交互中,系统不能把所有信息一视同仁地打碎丢进冷冰冰的外存、指望依靠提问者的词句去唤醒它们。系统必须在信息写入阶段就具备价值预判能力:
-
哪些事实属于不可逾越的“高约束条件”(如过敏体质、慢性病史、核心法律宗教信仰、家有易受害宠物等),它们应当获得特权,被路由并固化到随身携带的常驻可见状态中;
-
哪些事实属于低频、具象的“知识细节”(如去年的机票订单号、某次会议纪要的具体措辞),它们才适合静默在外存中等待显式提问的召回。
当前的记忆架构评测长期存在一种危险的虚假繁荣:用户往往通过“你还记得我喜欢什么吗”这类显式提问去评估一个 AI 伴侣的记忆力,并在得到准确回复后建立起极高的信任;然而在实际生活中,真正能够造成人身危害或决策灾难的,恰恰是“我知道你记得,但我以为你做决策时会把它考虑进去”的隐式断层。
InMind 所撕开的这道隐式关联盲区,明确宣示了单纯以检索为核心的长期记忆范式的天花板。未来的记忆系统不能只是一个等待提问触发的被动数据库,它必须学会将关键记忆前置为一种主动参与决策的环境底色。在实现更加敏锐、懂得何时将关键事实推向常驻状态的路由机制之前,任何号称拥有百万 Token 长期记忆的 Agent,都随时可能在下一个看似平常的马卡龙食谱里,递上一份致命的答卷。