KAP:打破Prompt平铺孤岛,128K上下文KV访问降至5.5%
KAP: Bridging the Knowledge Selection-Runtime Consumption Gap in LLM Systems
在大模型外挂知识库(RAG)或 Agent 推理的典型链路中,前端往往进行了极其昂贵的结构化筛选:通过图检索遍历实体关系、通过重排器计算段落置信度、甚至通过多模态对齐标注出关键图表。然而,一旦这些精心计算的先验知识被“平铺”(Serialize)成一段扁平的文本 Prompt 塞进模型,底层的推理服务引擎就对此一无所知了。
ArXiv URL:https://arxiv.org/abs/2607.24260v1
这就造成了一个极为别扭的系统级瓶颈:前端费尽心机找出了真正起决定性作用的 5% 核心证据,但底层的推理后端(如 vLLM)却只能老老实实把数万甚至十几万 Token 的完整 KV Cache 搬运一遍,在每一次生成循环里承受高昂的显存带宽开销。为了打破这种“前端精挑细选、后端全量硬吃”的割裂状态,来自 QiYuanLab 与北京科技大学的研究团队提出了 KAP(Knowledge Access Planning,知识访问规划)。
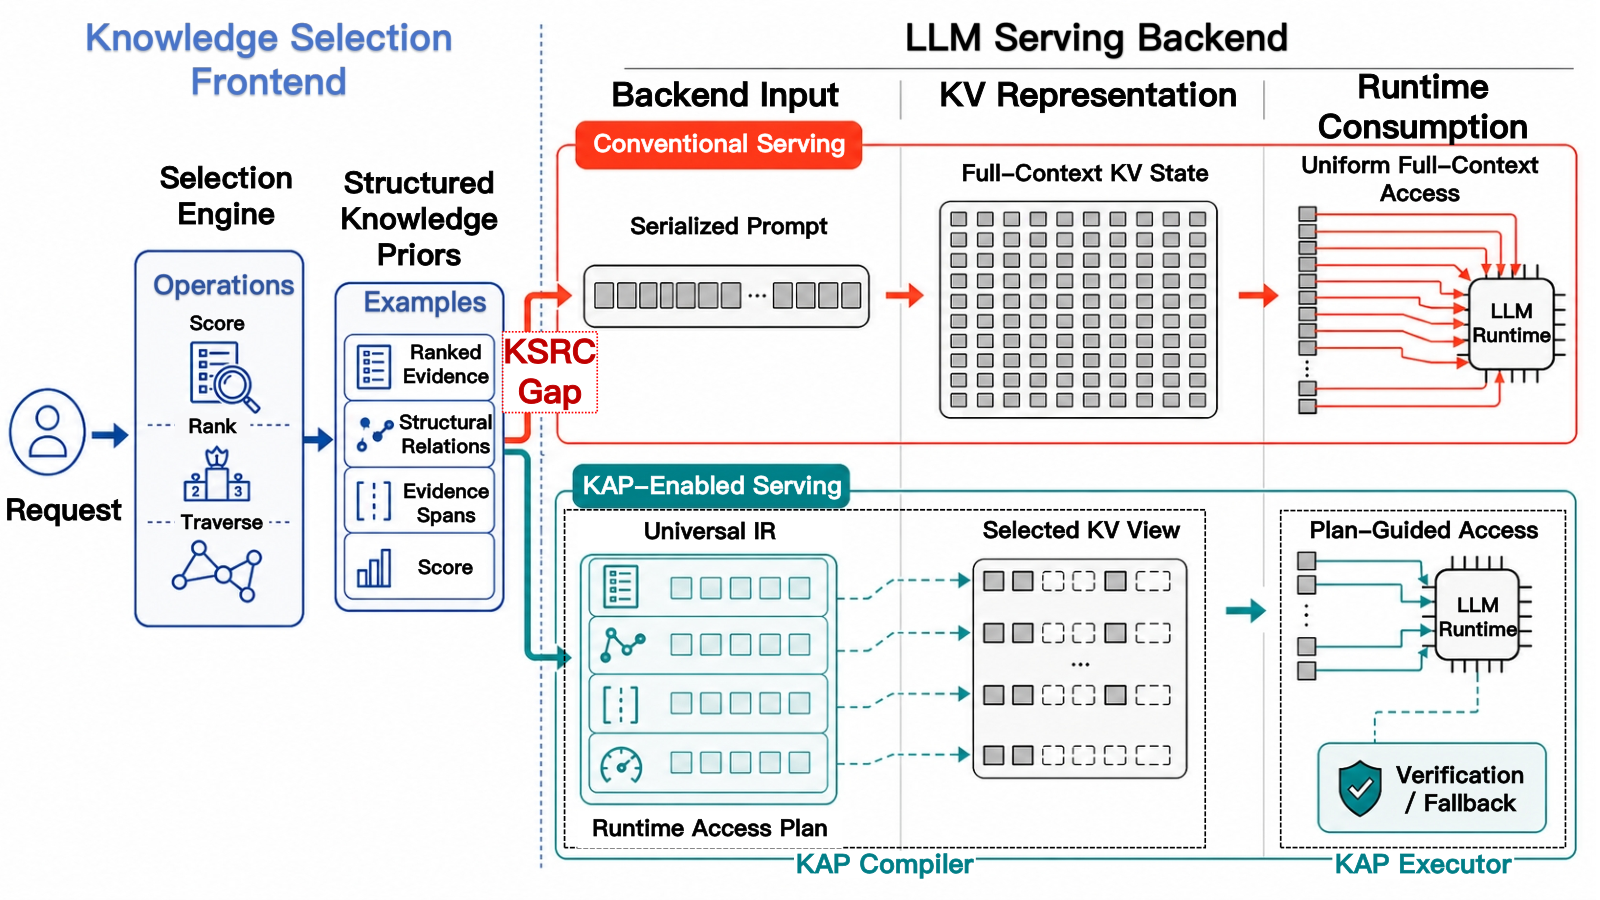
KAP 的核心洞察在于,大模型长上下文推理的物理开销不应该机械地绑定在 Prompt 的序列化长度上,而应当由上游知识的实际需求来驱动。研究团队设计了一套连接前端检索与后端推理的统一中间表示(IR)以及编译器-执行器架构,并在名为 GraphSpec 的具体实现中,将 128K 极端长上下文下的提议期 KV 访问量大幅缩减至原有的 5.5%,不仅实现了 1.19 倍的解码吞吐加速,还严格保证了生成质量不发生回退。
被忽略的“知识选择-运行时消耗”鸿沟
现代长上下文 LLM 系统在面对复杂任务时,通常依赖上游的前端选择系统。例如 GraphRAG 或 HippoRAG 会对海量文档构建知识图谱,通过个性化 PageRank(PPR)计算拓扑关联度,抽取最核心的子图和实体跳数。这些操作本质上是高级的语义规划,前端已经对“哪些证据是核心、哪些信息只是辅助上下文”给出了高度置信的先验评分。
然而,当前的推理系统存在严重的抽象断层。一旦结构化知识被格式化为扁平的自然语言 Prompt,所有的结构化拓扑、权重与证据元数据瞬间灰飞烟灭。后端的自回归解码器接收到的只是一个一维的 Token 序列。
在注意力机制的计算中,无论一个 Token 究竟是处于推理链路核心的实体节点,还是仅仅用来填充上下文的背景修辞,后端的显存控制器都会机械地为它们加载全量的 Key 和 Value 向量。随着上下文窗口从 4K 扩展到 32K、128K 乃至 1M,这种机制导致了显存带宽流量的指数级膨胀。很多实际工程场景中,工程师为了避免线上服务延迟超时,不得不强行丢弃原本有价值的检索上下文,牺牲模型的推理上限来迎合底层的工程约束。这种前端知识选择日益精细、后端运行时执行却粗暴均质化消费的架构脱节,正是论文所定义的 KSRC 鸿沟(Knowledge Selection-Runtime Consumption Gap)。
要弥补这一鸿沟,传统手段往往存在两难抉择:要么在前端激进截断 Prompt,但这容易造成上下文信息永久性丢失并导致幻觉;要么在后端训练专用的稀疏注意力模型或小草稿模型,但这需要重新微调权重,通用性极差。KAP 提出了一条全新路径:不改动模型权重,不破坏原有 Prompt 的完整逻辑语义,纯粹在推理系统的系统抽象层进行重构。
运行时访问计划:让知识成为第一类执行实体
KAP 的核心设计思想,是引入一个通用的系统中间表示——运行时访问计划(Runtime Access Plan)。通过这套 IR,前端输出的高维结构化先验不再只是拼装 Prompt 的“一次性脚手架”,而是被提拔为直接指导底层物理显存访问的一等公民(First-class Artifacts)。
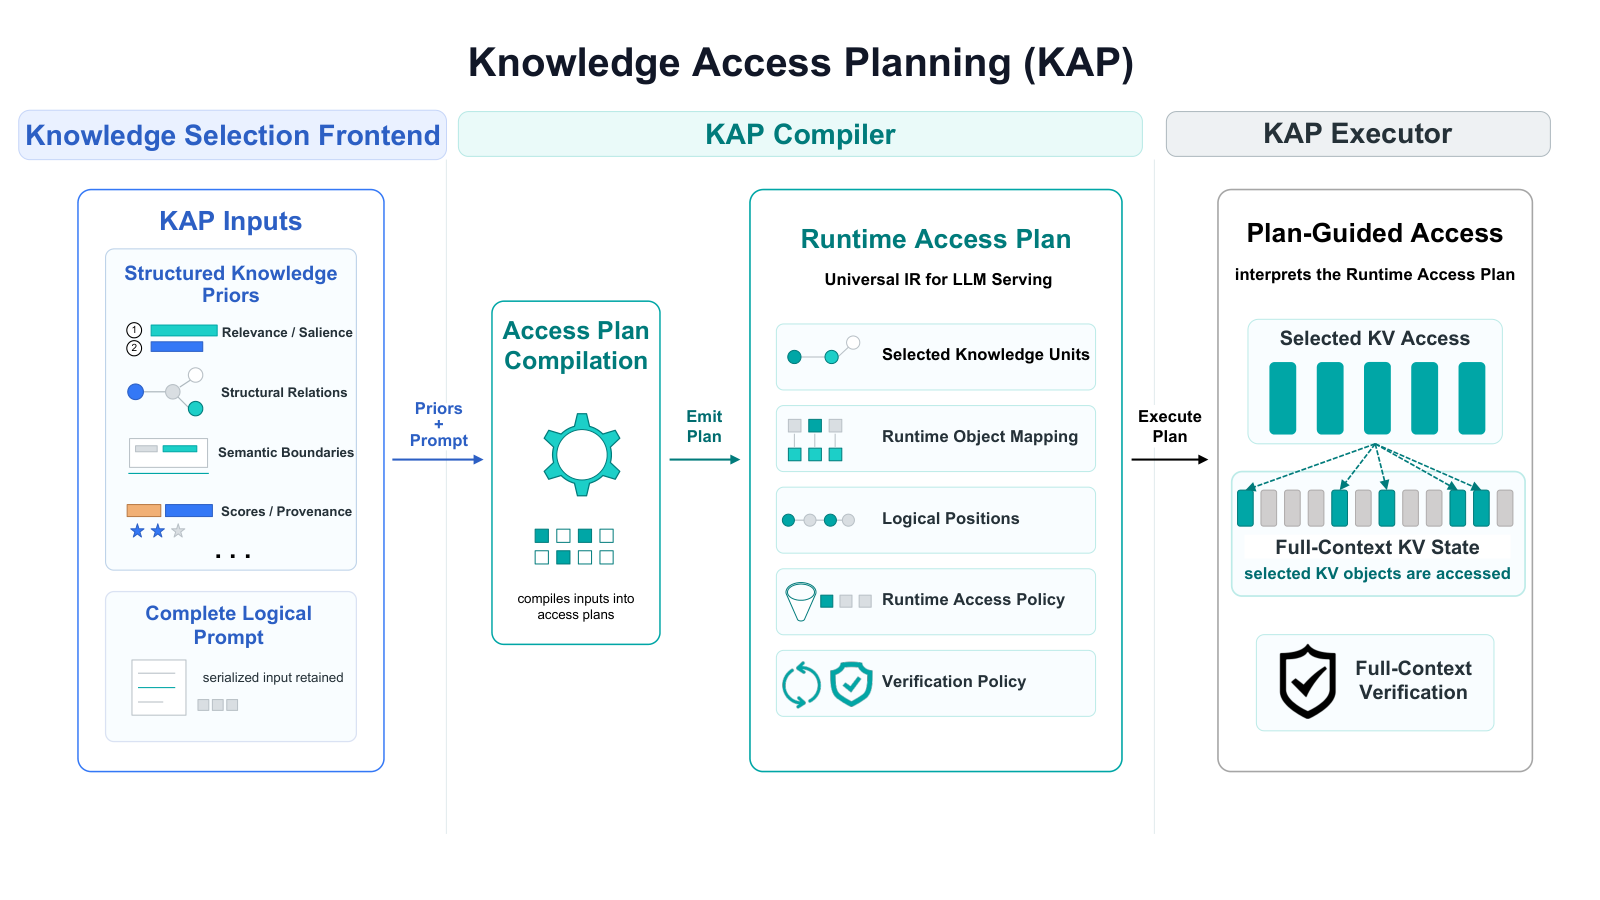
在形式化定义中,一个运行时访问计划被抽象为一个五元组:
\[\mathcal{A} = (U, M, pos, \rho_{\mathrm{access}}, \rho_{\mathrm{verify}})\]其中,$U$ 代表前端筛选出的语义知识单元集合(如段落、图节点、命题);$M$ 是将这些语义单元映射到底层物理运行时对象(如 Paged Attention 中的物理页、Cache 块)的映射表;$pos$ 则严格记录了各单元在原始逻辑 Prompt 中的绝对位置索引;$\rho_{\mathrm{access}}$ 为运行时的稀疏访问策略,指明在生成阶段哪些 KV 块属于高优先级激活区;$\rho_{\mathrm{verify}}$ 则是验证与回退策略,决定了系统在何时需要触发全量验证。
这一 IR 的精妙之处在于它彻底解耦了逻辑上下文语义与物理 KV Cache 访问。在模型的视界里,位置编码与逻辑上下文完整如初,完全没有任何 Token 被永久删减;但在硬件执行的视界里,显存控制器只按照访问计划加载极少数关键物理页。
为了将该计划落地,KAP 构建了经典的编译器-执行器分层体系:
-
KAP 编译器:部署在推理引擎入口,负责将前端传来的结构化元数据与完整 Prompt 进行对齐,根据显存预算挑选最重要的语义块,计算出块表(Block Table)与槽映射(Slot Mapping),最终编译成轻量级的访问计划。
-
KAP 执行器:潜伏在推理引擎的解码循环中,负责解释执行访问计划。它根据 $\rho_{\mathrm{access}}$ 驱动高效的稀疏前向计算,并依据 $\rho_{\mathrm{verify}}$ 在必要时与全量状态对齐,确保生成结果的保真度。
GraphSpec:图检索增强与推理引擎的端到端实现
为了验证 KAP 架构在真实生产系统中的可行性,作者基于业界主流的 Graph-RAG 前端与 vLLM 推进后端,构建了参考实现系统 GraphSpec。
GraphSpec 并没有为了提速而引入额外的轻量草稿小模型,而是采用了一种基于同源大模型的“自推测-全验证”(Self-speculative with Full-context Verification)机制。整个执行过程在逻辑上被拆分为两条协同路径:
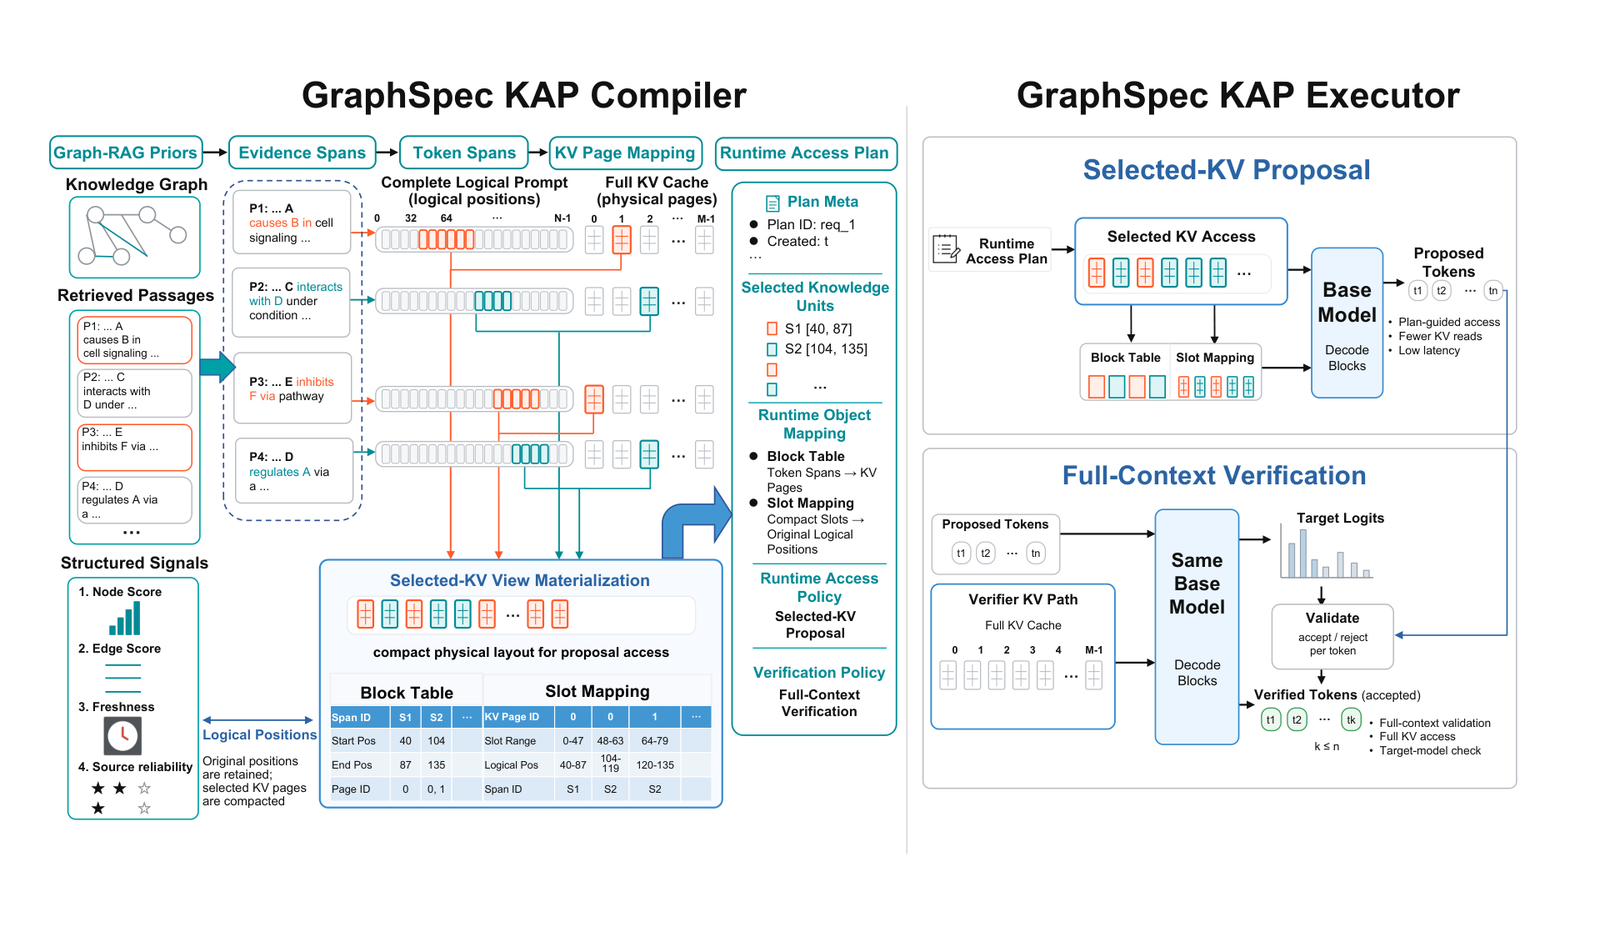
首先是提议阶段(Selected-KV Proposal)。当一个请求到达时,GraphSpec 编译器解析 Graph-RAG 产出的实体相关度与 PPR 拓扑评分,挑选出高置信度的证据跨度,并将其映射为紧凑的物理 KV 页。在生成候选 Token 时,相同的目标大模型(如 32B 模型)只挂载这一份经过紧凑化重组的“Selected-KV 视图”进行单步解码。
由于只加载了少量的 KV 缓存,每一步提议的显存读取带宽需求呈数量级下降,执行速度极快。尤为关键的是,编译器在重组物理页的同时,通过元数据完整保留了这些 Token 在原始长文本中的真实逻辑绝对位置 $pos$。这意味着提议路径输出的 Logits 与完整上下文下的语义分布保持着极高的一致性,并没有因物理显存的稀疏化而产生严重的语义漂移。
其次是全量验证阶段(Full-context Verification)。当提议路径连续生成 $k$ 个候选 Token 后,执行器会切入验证模式。此时系统使用完整的长文本 KV Cache,以并行的方式一次性前向校验这 $k$ 个候选词。其验证窗口输入为:
\[(m, c^{+}, \mathrm{KV}^{\mathrm{full},+}) = \mathcal{V}^{\mathrm{full}}_{\theta}\left(\mathrm{KV}^{\mathrm{full}}, c, \hat{\mathbf{x}}_{1:k}; \rho\right)\]校验通过的连续前缀会被正式提交,且全量 KV 状态在这一步中同步向前推进,无缝纳入已确认的 Token,省去了繁琐的二次状态重构。如果提议质量不佳,系统也可以根据 $\rho_{\mathrm{verify}}$ 策略触发动态回退,直接无损切换回传统的全量解码。整个过程对于底层算子而言,不仅 tensor shape 极其规整稳定,还完全保留了 vLLM 高度优化的 Paged Attention 性能红利。
相边界理论:什么时候稀疏访问能真正带来加速?
在系统工程中,推测执行往往是一把双刃剑:如果候选词的命中率太低,验证阶段的开销反而会吞噬掉提议阶段节省下来的时间。为了给知识访问规划提供严格的理论边界,研究人员建立了显存带宽受限场景下的代价模型,并推导出了相边界(Phase-Boundary)判定条件。
假设完整模型的权重读取开销为 $W_{\mathrm{main}}$,读取完整历史上下文的 KV 开销为 $KV$。引入两个核心规划变量:
-
KV 留存率 $s$:提议路径实际访问的 KV 显存与完整长文本 KV 的比例($s \in (0, 1]$);
-
提议命中率 $h$:提议生成的候选词被全量验证器成功接受的比率($h \in [0, 1]$)。
在单次包含 $k$ 个提议步的周期中,传统全量基线的基准代价为:
\[\mathrm{Cost}_{\mathrm{base}} = (1 + kh)(W_{\mathrm{main}} + KV)\]而在规划执行模式下,系统先付出 $k$ 步轻量提议代价,再付出 1 步全量验证代价:
\[\mathrm{Cost}_{\mathrm{plan}} = k(W_{\mathrm{prop}} + sKV) + (W_{\mathrm{main}} + KV)\]令 $\mathrm{Cost}{\mathrm{plan}} < \mathrm{Cost}{\mathrm{base}}$,在 GraphSpec 这种同模型自推测架构下(即 $W_{\mathrm{prop}} = W_{\mathrm{main}}$),经过代数化简可以得到实现正向加速的临界相边界不等式:
\[(h - s)KV > (1 - h)W_{\mathrm{main}}\]这个简洁的公式给出了极富系统指导意义的洞见:
-
必要条件是 $h > s$。也就是说,提议模型的候选命中率必须严格大于物理 KV 的留存率。如果保留了 30% 的 KV Cache,但候选接受率只有 20%,系统无论如何都会变慢。
-
临界上下文长度。当 $h > s$ 成立时,存在一个临界上下文大小:
\[KV_{\mathrm{crit}} \approx \frac{(1 - h)W_{\mathrm{main}}}{h - s}\]只有当实际上下文长度膨胀至使得 $KV > KV_{\mathrm{crit}}$ 时,节省的显存搬运量才能抵消推测验证的额外计算负荷,系统才会进入“越跑越快”的正加速相。这完美解释了为什么在几百 Token 的短文本下做稀疏提议往往吃力不讨好,而在超长上下文下收益惊人。
128K 极端压力测试下的真实表现
为了验证理论模型与工程实现的有效性,研究团队在 4 块 NVIDIA A800 80GB GPU 上展开了严格的对比实验。目标大模型选用 Qwen3-VL-32B-Instruct,测试基准采用了包含复杂文本、表格与科学图表的多模态长程问答基准 SPIQA,上下文覆盖范围从 4K 逐步扫至 128K 的极限长度。
实验设置了多组对照:除了标准的 Full-context 全量解码基准外,还对比了在 Prompt 端暴力截断物理长度的前端基线,以及不同推测窗口配置下的 GraphSpec。
在 128K 的超长上下文场景下,GraphSpec 展现出了极佳的计算解耦能力:在提议生成路径上,系统实际接触的物理 KV Cache 仅占原始总量的 5.5%。这意味着解码阶段的显存读取压力得到了近乎 18 倍的物理稀释。
在实际吞吐与质量指标上,这一机制带来了显著的工程收益:
-
端到端解码吞吐提升:在 128K 长度下,GraphSpec 带来了 1.19 倍的端到端实际解码吞吐加速。这种加速完全是在不依赖任何小草稿模型、纯靠单一大模型自推测的前提下达成的;
-
回答质量严格对齐:与暴力丢弃长上下文的前端 Prompt 裁剪方法相比,GraphSpec 在 SPIQA 上的多跳推理问答准确率与基准全量解码完全持平。因为全量验证器的存在充当了最终防线,确保了没有任何未经检验的低质量 Token 会被持久化写入输出流;
-
趋势高度拟合相边界:随着上下文长度从 4K 爬升至 128K,系统的加速比呈现出与理论相边界模型高度吻合的单调上升曲线。在短文本阶段,由于 $KV$ 较小,系统处于零收益或轻微负收益的临界边缘;但一旦突破临界点,长文本规模越大,KAP 解耦机制带来的收益就越坚固。
走向“选择-执行协同设计”的下一代长文本架构
KAP 以及 GraphSpec 的探索,在长上下文大模型方兴未艾的今天,提供了一个非常关键的架构反思视角:我们不能指望仅靠堆叠硬件显存带宽或一味拉长物理上下文窗口,来优雅地解决长文本系统的吞吐问题。
如果底层执行系统永远停留在“无脑将所有 Token 视作等权显存对象”的认知水平,那么前置检索系统无论做得多么智能,整套系统的物理扩展性都会被拖入内存墙的泥潭中。KAP 真正改变的,是让上游的语义洞察能够无损穿透 Prompt 边界,下沉为底层的硬件调度指令。
这种“知识选择与底层执行协同设计”(Selection-Execution Co-design)的范式,未来具备极广阔的延展空间。它不仅仅适用于图增强检索场景,对于多轮 Agent 对话中庞大历史记忆的存取、音视频多模态流中大段非关键帧的过滤,都可以编译成统一的运行时访问计划。当大模型的系统软件栈学会了“按需吃知识”,百万级长文本的实时交互与低成本部署才真正有了落地的工程底气。