FlowBlock:免训练波前并行,扩散大模型吞吐提升4倍精度反增
FlowBlock: Wavefront-Parallel Decoding for Self-Correcting Diffusion Language Models
扩散大语言模型(Diffusion LLMs, dLLMs)近年来被视作打破自回归(Auto-Regressive, AR)模型逐 Token 生成瓶颈的重要路线。通过在单次前向传播中对多个掩码位置进行双向去噪,扩散模型展现出了极具吸引力的并行生成潜力。然而,早期的全序列双向去噪方式导致每个时间步都必须刷新整条序列的 Key-Value Cache(KV 缓存),带来了极高的计算开销。为了引入类似自回归模型的确定性前缀缓存,近期的主流工作转向了“分块扩散”(Block-wise Diffusion)范式:模型将生成序列切分为固定长度的连续块,块内利用扩散机制并行生成,块间则沿着时间轴严格串行推进。这种妥协虽然保住了长文本生成的显存与计算可行性,却重新将扩散模型锁死在串行等待的牢笼中——下一个块必须等待前一个块完全去噪并锁定后才能启动。
ArXiv URL:https://arxiv.org/abs/2607.17652v1
华中科技大学与小红书团队在最新论文中提出了名为 FlowBlock 的免训练并行解码框架,从底层打破了这一看似不可逾越的块间串行壁垒。该研究敏锐地指出,在以 LLaDA-2.1 为代表的新一代具备“自我纠错”(Token-to-Token, T2T)能力的扩散语言模型中,块的确定性不再是不可妥协的硬性先决条件,而是一种可以灵活调度的运行时资源。下游文本块并不需要上游提供一个字斟句酌的完美定稿,只要上游给出一个信息充分的“粗糙草稿”,下游即可同步展开去噪;此前因上下文不完整而造成的微小瑕疵,后续完全可以依赖模型原生的 T2T 编辑能力在后续时间步中动态修复。基于该洞见,FlowBlock 设计了门控波前解码与异构波前打包两大核心机制,不仅在完全不修改模型权重的前提下将扩散大模型的吞吐量提升高达 4.01 倍、延迟降低最高 77.1%,甚至还在平均基准测试中实现了 1.3 个百分点的准确率逆势增长。
块间串行的症结与“草稿驱动”的范式转变
要理解 FlowBlock 的突破,需要先审视分块扩散模型面临的双重约束。在典型的分块生成设置中(如 LLaDA-2.0),每个块内部包含固定数量的 Token(如 32 或 64 个)。在处理当前活跃块时,模型对其所有位置进行并行掩码预测;当该块满足置信度阈值判定完全生成后,其 KV 状态被冻结并并入历史前缀缓存,生成指针随即滑动至下一个块。这种设计天然保证了因果一致性与前缀缓存的精确复用,但在宏观执行图上,块与块之间形成了严格的串行依赖图。尤其是在某个块去噪的后半段,绝大多数 Token 已经确定,模型仅仅是在反复迭代极少数低置信度位置,而此时整个下游的计算资源完全处于闲置等待状态。
此前已有工作尝试打破这种串行性。例如同类方案 D2F(Draft-to-Final)选择通过后训练(Post-Training)的方式,对模型进行知识蒸馏,强行训练模型学会“基于不完整的上游上下文去噪下游块”。然而,这种针对特定块结构的微调不仅耗时耗力,而且严重破坏了模型的泛化生成能力,导致基准精度出现大幅滑坡,在实际多请求并发服务场景下更暴露出严重的工程扩展缺陷。
FlowBlock 的切入点则跳出了“修改模型以适应并行”的传统思维,转而挖掘现代自纠错扩散模型自带的内生能力。在传统吸收态扩散模型中,掩码被还原为 Token 是单向且不可逆的(Mask-to-Token, M2T),一旦生成了错误 Token 便永远无法更改。但 LLaDA-2.1 这类模型在预训练与指令微调时引入了 T2T 编辑目标,允许模型不仅能从掩码生成 Token,还能在后续迭代中根据新获得的上下文动态纠正已经生成的 Token。这一特性直接弱化了块与块之间的耦合:下游块的启动,本质上只需要上游提供足够反映语义方向的高概率草稿,并不需要绝对确凿的定稿。上游在持续打磨细节的同时,下游就可以同步启动去噪;上游若在最后几步发生了细微词汇更替,下游借助原生的 T2T 修复通道即可顺畅吸收这些语义扰动。
机制一:门控波前解码与 W 型因果掩码
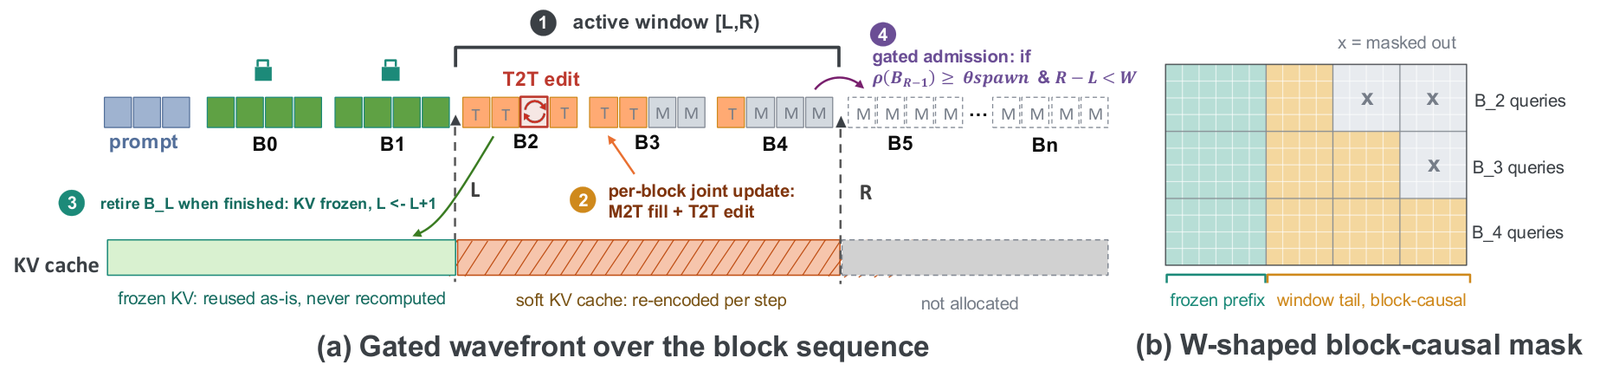
为了将这种“草稿容错”转化为严谨可控的执行流,FlowBlock 提出了门控波前解码(Gated Wavefront Decoding, GWD)。如图 1 所示,GWD 不再像传统方案那样在单步前向传播中仅维护单个活跃块,而是维系一个长度至多为 $W$ 个相邻块的滑动活跃窗口 $[L, R)$。整个窗口跨越多个去噪阶段,构成了一个自左向右动态推进的计算“波前”(Wavefront)。
在波前内部,多个块通过同一次模型前向传播完成联合去噪。但系统面临的第一个关键问题是:下游的新块究竟应当在何时被允许准入(Spawn)到波前中?如果准入过早,上游块处于高比例掩码的混沌状态,下游被迫在缺乏语义指向的噪点中猜测,将导致严重的语义偏离,后续甚至需要耗费更多步数的 T2T 编辑去修补,得不偿失;反之,若准入过晚,波前窗口就退化为了普通的串行分块。
GWD 通过设计基于就绪度的准入门控机制巧妙地解决了这一权衡。系统直接利用前向传播输出的 Logits,对波前最右侧的前沿块 $B_{R-1}$ 统计其已解除掩码且置信度越过阈值 $\tau_{\mathrm{mask}}$ 的 Token 比例 $\rho(B_{R-1})$:
\[\rho(B)\;=\;\frac{\bigl\vert{}\{\,i\in\mathcal{M}_{B}:p_{i}\geq\tau_{\mathrm{mask}}\,\}\bigr\vert{}}{\bigl\vert{}\mathcal{M}_{B}\bigr\vert{}}\]仅当前沿块的就绪度 $\rho(B_{R-1})$ 超过预设门控阈值 $\theta_{\mathrm{spawn}}$,且当前活跃窗口尚未达到最大容量限制($R - L < W$)时,系统才会为下一个全新的全掩码块 $B_R$ 打开准入大门。这一计算完全利用当前步的原生预测概率,无需任何外加神经网络模块,几乎零额外开销。
除了准入机制,GWD 在底层 KV 缓存管理与注意力掩码上的设计同样保证了系统的数学严谨性。为了在并行去噪的同时确保前缀缓存可被精确复用,FlowBlock 构建了一种被称为“W 型块因果注意力掩码”(W-shaped block-causal mask)。在波前窗口内,位于块 $g$ 的 Query Token 可以双向关注该块自身的所有 Token,也可以单向关注波前内部早于它的块($L, \dots, g-1$)以及所有早已固化到前缀缓存中的历史块,但绝对无法查看任何处于其右侧的未来块。
这种因果遮蔽机制带来了一个极其关键的工程特性:处于波前最左端的块 $L$ 在整个窗口内部拥有绝对的单向因果隔离,它的上下文视野与串行解码时完全一致。因此,当块 $L$ 内部的所有 Token 达到收敛标准后,该块即可宣布正式“退休”(Retire)。此时,块 $L$ 的 KV 状态直接就地冻结并入不可变的前缀缓存池,指针 $L$ 向右递增,新的窗口随之右移。整个过程中,已提交的前缀 KV 缓存与通过标准串行重算得到的张量在位级别(bit-identical)完全一致,杜绝了近似缓存累积误差的隐患。
机制二:异构波前打包攻克批处理服务瓶颈
如果仅仅在单序列(Batch Size = 1)下运行,GWD 已经能够跑出显著的流水线加速。然而,将这一算法推广至高吞吐的批处理服务系统(Batched Serving)时,工程界最头疼的“慢请求阻塞”(Straggler Problem)便会暴露无遗。由于各个文本序列的内容复杂度截然不同,某些序列可能 3 步就满足了就绪度门控准入新块,而另一些序列可能需要 8 步;同理,各个序列的块退休节奏也完全不同步。
如果采用朴素的批同步(Batch-Synchronous)机制,强制批次内所有请求共享统一的波前进度,就必须实行“全员满足方可退休”和“最小就绪度方可准入”的木桶策略。这种策略会导致整批请求的步调被最慢的一条序列牢牢卡死,并发规模越大,性能惩罚越严重。而若彻底让每个请求完全异步独立解码,又会导致张量形状频繁抖动,引发严重的 GPU 算子重编译开销与显存碎片化。
为此,FlowBlock 提出了系统层面的第二大创新:异构波前打包(Heterogeneous Wavefront Packing, HWP)。HWP 允许批次中的每个请求 $b$ 独立维护各自的波前边界状态 $(L_b, R_b)$、局部完成标志以及按序提交指针,从逻辑上彻底解绑请求间的时序关联。
在物理张量组织上,HWP 利用了“波前容量上限固定”这一几何特征。设最大波前窗口包含 $W$ 个块,每个块长为 $\mathit{bl}$,则每个请求在任何时刻处于活跃去噪状态的 Token 槽位总数恒定为 $q = W \cdot \mathit{bl}$。即便请求 $A$ 的波前停留在第 2 到第 3 块,而请求 $B$ 的波前已经推进到第 10 到第 11 块,它们各自需要前向计算的活跃 Token 数量完全相同。
系统在每个推理步发起前,根据每个序列当前的绝对偏移量 $o_b = L_b \cdot \mathit{bl}$,通过一行 Gather 操作从各序列中精准抽取长度为 $q$ 的切片:
\[\texttt{qtok}[b] = x\bigl[b,\ o_b+[0..q)\bigr],\quad \texttt{pos}[b] = o_b+[0..q)\]这些切片被瞬间拼装成一个规格极其工整且无须填充的 $[B, q]$ 稠密张量。同时,各个 Token 严格保留其在整条序列中的真实绝对位置编码以计算 RoPE。
在注意力计算阶段,HWP 引入了按行配置的块对角掩码(Per-row block-diagonal mask)。对于任意请求行 $b$,该掩码精确放行属于它自己的绝对前缀区间 $[0, o_b)$ 以及自身波前窗口内的 W 型因果尾部,同时严格遮蔽属于其他批次以及当前序列中过期的中间区域。借助现代硬件上的独立行注意力机制,请求之间实现了结构级的物理隔离,杜绝了跨序列干扰。
在完成前向传播后,最新计算出的活跃 KV 张量通过 Scatter 操作,被直接写回预先分配的大块连续缓存中各自的绝对偏移位置。这种设计带来了一个巨大的系统红利:块的退休提交在显存操作上是完全零拷贝(Zero-cost)的。当最左块收敛退休时,由于其最新的 KV 早就躺在正确的物理内存地址中,系统只需要在逻辑上将该请求的波前偏移量向前推移一个块长即可,不需要发生任何数据搬运或内存规整。
实验评测:速度与精度的反常共振
FlowBlock 的工程实现基于针对扩散大模型深度优化的推理系统 dInfer(底层对接 SGLang),评估基座选用目前开源领域代表性的 MoE 分块扩散模型 LLaDA-2.1-mini。测试覆盖了 GSM8K、MATH500、Minerva-Algebra、ASDiv 四大严谨数学基准,以及 HumanEval、MBPP 及其高强度测试套件 EvalPlus(HumanEval+ / MBPP+)四大代码评测集。
在单批次($B=1$)测试中,FlowBlock 展现出了跨越基准的全面领先。衡量扩散模型硬件无关并行度的核心指标是单次前向生成 Token 数(Tokens Per Forward, TPF)。不具备纠错能力的串行基线 LLaDA-2.0 平均 TPF 仅为 2.99;引入块内 T2T 纠错的 LLaDA-2.1 将该指标推升至 4.62;而 FlowBlock 凭借块间波前的无缝交叠,直接将平均 TPF 拔高到 7.23,相比 LLaDA-2.1 实现了 1.6 倍的纯算法级并行度跃升。
端到端表现上,在生成长度 2048、块长 32 的典型配置下,FlowBlock 相对 LLaDA-2.0 取得了 2.35 倍的端到端每秒生成 Token 速率(Tokens Per Second, TPS)提升(峰值达 3.17 倍),端到端时延降低 54.5%;相对本身已高度优化的 LLaDA-2.1,TPS 依然提升了 1.45 倍(峰值 1.57 倍),时延降低 33.3%。
更为罕见的是准确率表现。在加速解码类算法中,以精度换速度几乎是不可避免的妥协,但 FlowBlock 在全部 8 项评测中的总平均得分达到 87.00 分,比原本的串行基准 LLaDA-2.1 还要高出 1.3 分。细分来看,在对逻辑严密性极度敏感的数学任务中,FlowBlock 与串行基准的差距在 0.2 分以内的统计波动范围内;而在全部 4 项代码任务中,FlowBlock 的 Pass@1 指标全线飘红,实现了 1.3 到 4.9 个百分点的大幅反超。
产生这种“反常提升”的深层机理,源于多块协同去噪对搜索空间的正则化效应。在严格串行解码下,模型在块边界处容易陷入局部最优或产生微小的幻觉偏差,且一旦固化便无从更改;而 FlowBlock 让相邻块在波前内共同经历多次交叉迭代,下游块的存在反向约束并引导了上游临界 Token 的选择,且 T2T 编辑赋予了序列在更长感受野下修正早熟决策的能力,反而促成了更高质量的程序代码合成。
与基于蒸馏后训练的同类并行方法 D2F 相比,优势则呈现为降维打击。D2F 的平均基准得分仅有 70.52 分,落后 FlowBlock 整整 16.5 分;在单批次吞吐上,FlowBlock 达到了 D2F 的 2.37 倍。免训练的动态波前调度不仅在实施上零训练成本,在算法保真度上也彻底击溃了破坏原模型特征分布的后训练微调方案。
高并发扩展与关键参数剖析
高并发下的扩展能力是检验推理系统真正价值的试金石。研究团队将静态批大小从 1 一路扩展至 32 进行吞吐压测。结果显示,FlowBlock 的性能优势随着批处理规模的扩大被进一步放大。在 Minerva-Algebra 数据集上,$B=16$ 时 FlowBlock 的吞吐量达到了 1293 TPS,是 LLaDA-2.1 最佳表现的 2.05 倍;在 HumanEval 上,$B=32$ 时跑出了 1471 TPS 的极速,相比 LLaDA-2.1 的加速比高达 2.95 倍。对比老一代 LLaDA-2.0,在 $B=8$ 时的峰值加速比更是达到了惊人的 4.01 倍,请求平均时延暴跌 77.1%。
这一测试同时暴露了 D2F 在系统设计层面的致命软肋。由于 D2F 未设计能够处理异构块间进度的执行引擎,在并发场景下每 GPU 吞吐量不升反降。在 HumanEval 评测中,D2F 的吞吐量从 $B=1$ 时的 113 TPS 溃缩至 $B=32$ 时的 89 TPS,平均单请求延迟膨胀到 203 秒之巨。此时 FlowBlock 取得了 D2F 整整 16.6 倍的吞吐量,并将延迟压低了 95.8%。
在针对 HWP 打包机制的消融实验中(对比“HWP 异步独立波前”与“批同步锁步波前”),数据直观证明了攻克慢请求阻塞的价值:
-
在 $B=2$ 时,HWP 相比批同步方案即产生 1.46 倍吞吐优势;
-
随着并发增大,长尾效应加剧,优势在 $B=4$、$B=8$、$B=16$ 分别走高至 1.82 倍、2.12 倍和 2.15 倍;
-
即使到 $B=32$ 时,HWP 依旧维系着 1.87 倍的吞吐领先,时延缩减 38%。
在运行超参数敏感度方面,波前窗口大小 $W$ 与准入门控阈值 $\theta_{\mathrm{spawn}}$ 扮演着正交的调节角色。在 GSM8K 基准上以 $B=32$ 扫描参数可见:
-
准入门控 $\theta_{\mathrm{spawn}}$ 决定精度底线:若将门控降至接近无门控状态(如 0.1),下游块在极度混沌的上游环境中早产,准确率会比串行基准跌落 2.0 到 4.0 分;当门控适度收紧至 0.6 时,准确率完美超越串行参考线。
-
窗口大小 $W$ 决定计算算力成本:随着 $W$ 从 2 增大至 5,单次前向传播的 Query 长度成倍放大,导致 TPS 单调递减。综合考量显存、算力与收益,选用 $W=2$ 搭配 $\theta_{\mathrm{spawn}}=0.6$ 构成了最为平稳的工程甜点位,既能在 GSM8K 上斩获 92.62% 的高精度,又能稳拿 918 TPS 的高并发吞吐。
面对更具挑战性的大块长扩展(Block Length 从 32 放大至 64、96、128),FlowBlock 的架构鲁棒性同样突出。当块长拉大到 128 时,串行基准 LLaDA-2.1 由于块内自愈压力剧增,准确率从 92.57% 直线下坠至 77.41%,TPF 也缩水至 3.32;而 FlowBlock 依旧稳稳保持在 5.70 TPF(领先 LLaDA-2.1 达 1.72 倍),准确率高出基线 2.65 分。这充分验证了该架构的核心哲学:获取并行加速应当依赖于将多个适度大小的块进行流水线波前交叠,而非强行将单个块拉大到模型上下文推理能力的极限之外。
结语
长久以来,扩散语言模型在大规模落地服务中始终面临两难选择:要么忍受全序列双向去噪带来的沉重显存负担与平方级计算开销,要么在分块串行推理中无奈割舍并发生成红利。FlowBlock 借由对现代模型 T2T 自我纠错机制的深刻剖析,将过去被视作死板约束的“块终态依赖”重构为一种具备弹性的运行时调度资源。
通过门控波前解码保证算法层面的安全重叠与位级别的前缀缓存一致性,再通过异构波前打包在系统层面压榨 GPU 稠密批处理吞吐,FlowBlock 证明了无需花费高昂代价去重训或蒸馏模型,仅凭优雅的推理系统与注意力调度创新,就能让扩散语言模型在推理速度与生成质量上同时实现跨越式突围。这不仅为自纠错扩散模型的落地部署铺平了高效服务的高速路,也为未来非自回归架构的并行执行系统设计提供了极具启发性的范例。