FigMirror:把大模型电脑操作能力迁移到画图,科研图表风格迁移提升11.4分
FigMirror: Ground It, Code It, Plot It
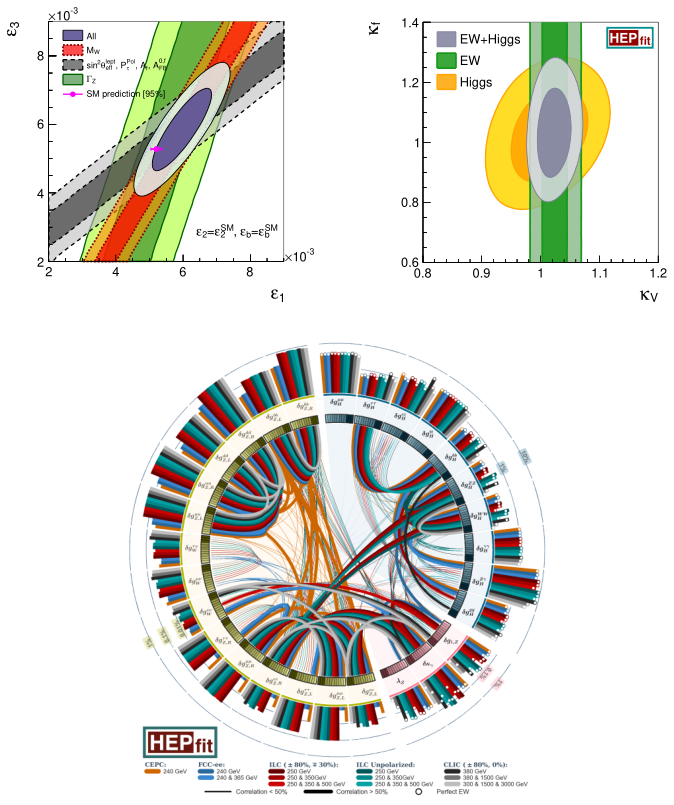
在撰写学术论文时,最耗费心力的环节之一往往不是跑实验,而是打磨信息图表。为了让图表达到顶会或顶刊的视觉质感,研究者们通常会找一篇顶会顶刊的排版范例作为参考图,手工调整子图间距、配色色号、字体粗细、图例边框与坐标轴刻度。最近一年,随着多模态大模型代码生成能力的提升,将图表转化为 Matplotlib 等绘图代码(Chart-to-code)的研究井喷。但几乎现有的所有工作,都陷入了一个微妙的误区:它们把任务定义成了“像素级复现原图”,而科研工作者真正需要的,是在保留参考图视觉风格的前提下,画出自己完全不同的实验数据。
ArXiv URL:https://arxiv.org/abs/2608.28814v1
当数据发生改变时,传统的“像素对比、整图优化”思路立刻崩塌。如果模型只看整张渲染图与参考图的像素差异,它的优化目标就会被参考图自带的数据形状严重误导,甚至把用户的新数据强行往参考图的曲线趋势上靠拢。
来自穆罕默德·本·扎耶德人工智能大学(MBZUAI)等机构的研究团队提出了 FigMirror。这项工作指出了一个长期被忽视的事实:科研图表与操作系统图形界面(GUI)在底层结构上高度同构,都是由代码生成的离散几何元素。FigMirror 巧妙地将现代多模态模型在“电脑操作”(Computer-use)任务中习得的屏幕坐标定位能力,转化为一种名为“具身测量”(Grounded Measurement)的机制。模型不再靠肉眼泛泛估测颜色与尺寸,而是先准确定位元素坐标,再写出简短的 Python 代码精准抓取色号和尺寸数值。配合一套包含检查清单与审查闭环的 Drawer–Reviewer 智能体架构,FigMirror 在专为风格迁移构建的 PlotTwin-Bench 基准上,人工精选子集的综合得分相比最强基线 ChartIR 提升了 11.4 分(从 61.3 跃升至 72.7)。
从“复现一张图”到“解耦数据与风格”
学术界对 Chart-to-code 的研究经历了两个主要阶段。第一阶段是以 ChartLlama 为代表的专用模型微调,模型被投喂大量“图表图片—绘图代码”对,以输出代码所渲染图像与原图的像素差异作为训练信号。第二阶段则是随着通用大模型视觉与推理能力的飞跃,转向推理阶段的多智能体自反思迭代(Self-refinement)。例如 METAL 等方法,让生成智能体写出初始代码,再由审查智能体对比渲染结果与目标原图,不断指出视觉差异并反复修改。
这两种路线在本质上都在解决同一个问题:复刻原图。但真正有应用价值的场景却完全不同。研究者手里有一组新的实验结果,希望复用某篇 Nature 论文中三联柱状图的灰蓝配色调色板、半透明填充纹理和紧凑的子图内边距。在这类需求下,参考图中的折线起伏、柱状高低是必须抛弃的“数据载荷”,而字体族、线条粗细、配色方案、坐标轴刻度朝向才是需要抽取的“风格属性”。
传统视觉大模型在面对这一任务时暴露出致命缺陷。当模型被要求“模仿参考图的样式画一组新数据”时,由于没有显式的解耦机制,模型习惯性地用整图对比的视角去审视草稿。一旦新数据的柱状图比参考图更矮,或者折线图走向相反,基于整图相似度的反思提示词就会产生幻觉,试图把新数据的排版拉向参考图的数据形态。更严重的是,多模态模型直接“看图猜参数”的精度极低:面对一个淡紫色的置信区间半透明填充带,模型盲猜的十六进制色号(Hex Code)往往与真实值相去甚远;面对子图之间的边距,模型也只能在代码里写下一个凭直觉给出的数值。
要完成真正的风格迁移,必须将图表中的数据与风格彻底解耦。解耦的第一步是定位——在参考图中找到承载特定样式的视觉元素;第二步则是精确测量——计算出该元素所使用的绝对属性值。
意外的破局点:借道 Computer-Use 的坐标定位
通用大模型如何获得精准定位图表微小元素的能力?研究团队并没有重新收集数万张科研图表去重新预训练,而是发现了一个现成的能力宝库:近两年快速演进的 Computer-use(智能体操作电脑)技术。
在训练模型操作操作系统桌面或网页浏览器时,模型的首要动作并非直接点击,而是通过屏幕图像输出目标按钮、输入框或菜单项的精确像素坐标 $(x, y) = g(I, e)$。这类模型在海量图形用户界面(GUI)数据上被打磨出了极高的坐标对齐能力。
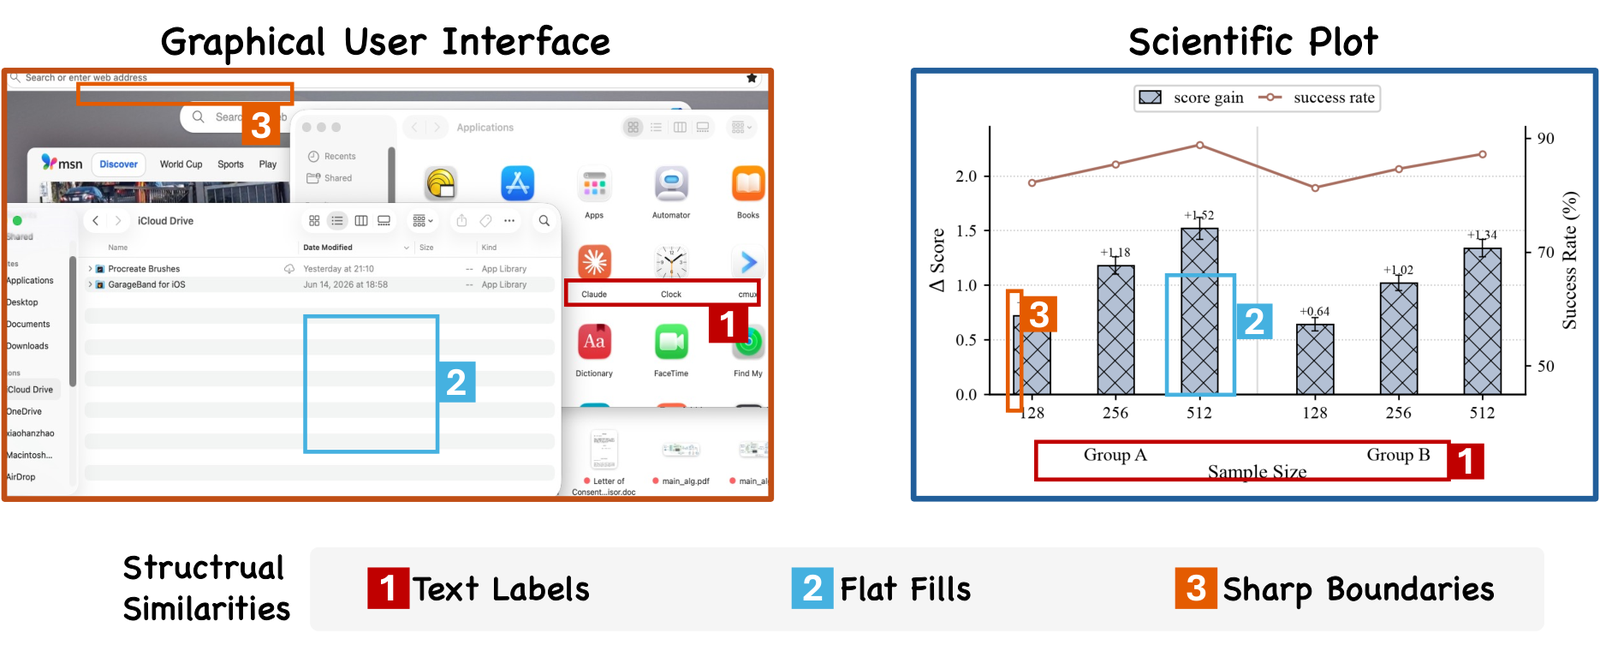
观察科学图表的解剖结构可以发现,图表与 GUI 具有几乎相同的视觉特征:它们都不是自然摄影照片,而是通过底层渲染引擎根据精确指令绘制出来的矢量化或栅格化图像。图表同样由边缘清晰的离散几何图元组成,包含平坦色块填充、规则字体、固定角度的刻度线与图例方块。既然模型能在复杂的电脑桌面上精准定位一个仅有十几个像素宽的“保存”图标,它自然也具备在复杂图表中精准定位特定图例条目、坐标轴次刻度或箱线图胡须须端的能力。
FigMirror 做的关键创新,就是把这种原本用于“执行屏幕点击”的坐标定位能力,重定向为了“执行数值测量”。
具体而言,模型不再泛泛地输出“这幅图使用了深蓝色”,而是首先调用自身的坐标回归能力,指出承载这一样式的区域 $r_a$。在确定区域后,系统并不让大模型肉眼估测属性,而是让模型即时生成一段轻量级 Python 脚本,以编程方式直接读取该裁剪区域的像素阵列:
\[v_a = \rho_a\big(I[r_a]\big)\]如果测量的是颜色,探针脚本会提取该区域平坦填充部分的最常见 RGB 值并转化为十六进制色号;如果测量的是线宽,脚本通过边缘检测计算高对比度过渡带的像素跨度;如果测量的是子图垂直间距,脚本通过投影直方图计算留白高度。这一过程被称为“具身测量”(Grounded Measurement)。它将原本模糊、不可控的视觉主观感受,硬核地转化为了确定性的程序测量。
FigMirror 的双循环闭环架构
有了具身测量作为底层探针,FigMirror 进一步搭建了一套结构化的智能体架构。框架由两大核心角色组成:负责生成代码的 Drawer,以及负责视觉对齐审计的 Reviewer。
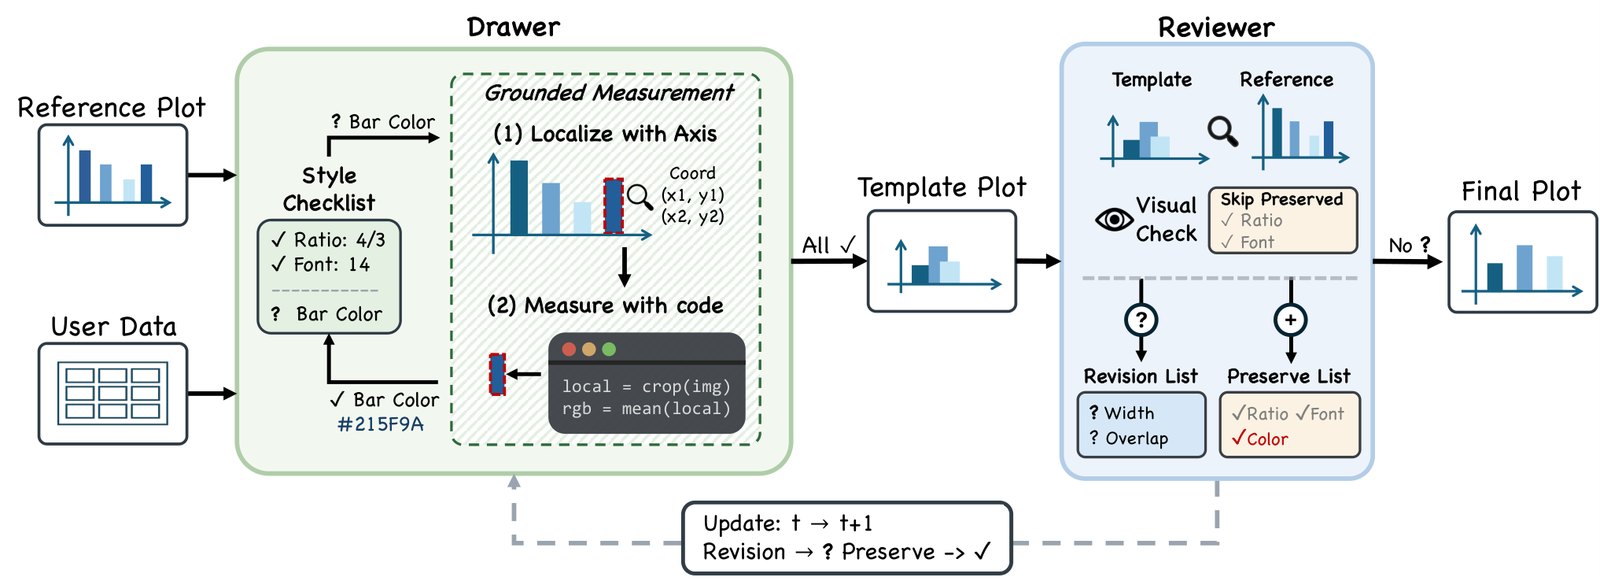
整个执行过程围绕一份动态维护的“风格检查清单”(Style Checklist)展开。清单包含两个集合:待测定的未决属性集 $\mathcal{O}$ 与已测定的确定属性集 $\mathcal{R}$。
在初次运行时,Drawer 接收到参考图后,首先根据预设的样式规范扫描图像,把图表表现出的所有特征实例化为开放条目,例如“柱子主色调”、“误差线末端横杠宽度”、“次级网格线透明度”、“图例背景填充色”等。紧接着,Drawer 遍历未决集 $\mathcal{O}$,对每一项属性执行 Grounded Measurement,定位对应图元并运行微探针脚本,测出确切数值 $v_a$ 后将其移入 $\mathcal{R}$。当所有样式属性全部被数字化解析后,Drawer 结合用户提供的新数据,编写第一版完整的数据绘图脚本,并执行代码渲染出第一版候选图表。
此时,系统进入审查与局部修正阶段。Reviewer 的设计同样避开了“全图盲猜”的陷阱。如果让 Reviewer 仅用自然语言写出“子图左侧太拥挤,柱状图颜色不够深”,代码生成端很难做出精准修改。Reviewer 借用了同样的坐标定位机制,直接在候选图像上画出边界框(Bounding Box),圈出样式存在偏差的具体区域。
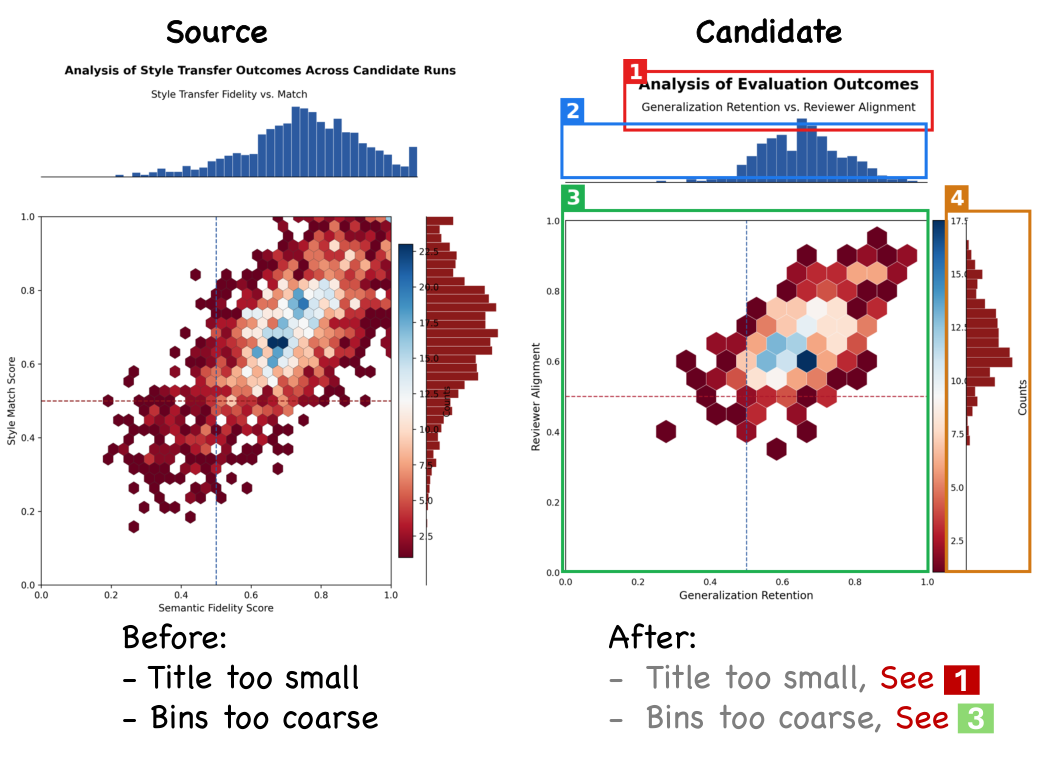
Reviewer 将整幅图的属性划分为两组:需要修改的 Revision List,以及已经完美对齐的 Preserve List。这套路由机制确保了智能体在迭代时不会顾此失彼。在传统的自反思智能体中,模型修复了坐标轴字号,往往会不小心改动上一轮已经调对的柱状间距;而在 FigMirror 中,只有落在 Revision List 里的属性会被重新置回 $\mathcal{O}$ 重新测量与重写,属于 Preserve List 的样式参数则会被强制锁死在代码模板中。当 Reviewer 在某轮迭代中输出的 Revision List 为空时,整个循环终止,生成最终可执行的绘图脚本。
在工程实现上,FigMirror 被打包成了一个独立的 Skill 指令包,无缝加载在 Codex 等智能体代码运行底座上。底座负责提供模型推理、Python 执行沙箱与图片读写接口,FigMirror 则专心编排流程,具备极强的跨平台可移植性。
破除评估盲区:PlotTwin-Bench 与双通道评分
在评估科研图表代码生成时,现有的基准(如 ChartMimic 等)几乎全部围绕“复原重绘”设计。为了建立真正针对“风格迁移”的标准,研究团队构建了 PlotTwin-Bench。
构建该基准的核心原则是:参考图必须具备足够高级的视觉设计与排版复杂度,且其结构很难单纯用几句文本提示词描述清楚。基准的 400 组高质量参考图来自两个渠道:
-
人工精选集(50 组):直接从国际顶会与顶级学术期刊的最新论文中筛选排版精美、结构复杂的图表,由专业人员手工完整复现代码,确保得到绝对对齐且高质量的“图—代码”对。
-
规则增强集(350 组):以 ChartMimic 数据集为骨架,通过大模型重写流水线注入更复杂的视觉元素(多重子图嵌套、双 Y 轴混合、非标准注释标签、渐变或自定义色板),并经过严格的自动与人工多重过滤,剔除平庸样本。
图表涵盖了分组柱状图、多面板折线图、热力图、小提琴图等 12 种主流科研图表类型。
在评测指标设计上,团队指出了纯多模态模型打分的虚高与迟钝。通用 VLM 在给科研图表打分时往往过于宽容,只要图表中都有坐标轴、折线走向大致对齐,就会给出极高的相似度分数,从而严重掩盖不同方法在微观排版上的巨大优劣。为此,PlotTwin-Bench 提出了代码与视觉双通道评测体系(Code & Vision Two-Channel Evaluation)。
代码通道专注于“非默认偏离”(Departures from Default)。大部分科研绘图库都有朴素的默认样式,真正体现论文图表审美的,是作者显式调整的特殊参数集合 $\Delta(I) = {a \mid v_a \neq d_a}$。代码通道直接静态解析生成脚本,逐项检查这些关键偏离属性(如特定的十六进制色号、特定的字体粗细、旋转角度)是否被准确还原,计算出代码匹配分 $S_{\mathrm{code}}$。
视觉通道则聚焦于“代码运行后才会浮现的问题”,例如元素重叠、图例遮挡曲线、文字超出画幅截断、密集刻度未换行等全局渲染缺陷,由大模型充当裁判给出 $S_{\mathrm{vision}}$。最终的综合得分 $S$ 按读者真实审美体验进行加权:
\[S = 0.35 S_{\mathrm{code}} + 0.65 S_{\mathrm{vision}}\]人类盲评实验显示,该自动化综合评分 $S$ 与资深研究者的主观胜率具有高度一致的单调对齐关系,证明了该指标的可靠性。
实验结果:大模型到底赢在哪里?
测试在 PlotTwin-Bench 的 150 个代表性样本(50 个全部人工精选样本 + 100 个增强样本)上展开,统一采用 GPT-5.5 超高推理模式(x-high reasoning effort)作为底层驱动与评测模型,对比了 Plot2Code(单阶段生成)、METAL(基于反馈的图像比对生成)、ChartGalaxy-Prompt 以及 ChartIR(多轮代码修复)四种主流方案。
在人工精选的高难度子集上,FigMirror 斩获了 72.7 的综合得分,以 11.4 分的显著优势击败了此前表现最好的 ChartIR(61.3 分)。在规则增强子集上,FigMirror 同样达到 76.4 分,领先 ChartIR 6.1 分。
更具启发性的是基线模型之间的表现分化。单纯引入多轮迭代并不能保证风格迁移的成功:同样采用多轮审查反馈的 METAL,其实际得分甚至沦落到与单阶段生成的 Plot2Code 相同水平。这一反常现象恰恰验证了前文的判断——METAL 的 Critic 是为“整图复制”设计的,在处理新数据时,全图像素比对机制不断产生错误梯度,把绘图代码硬生生改回参考图的数据形态,反而破坏了原本正确的排版。而 ChartIR 之所以略胜一筹,是因为其修复机制更偏向局部代码修补,受整图数据差异的干扰相对较小。
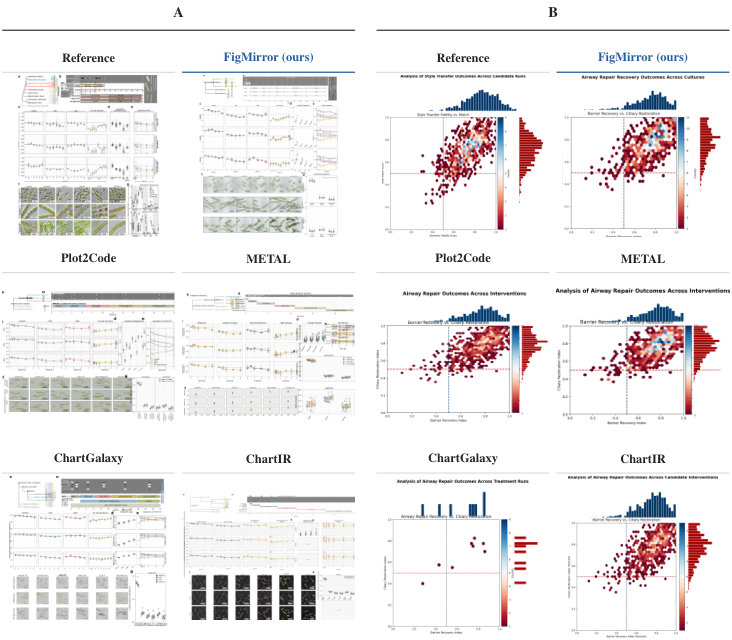
从定性对比中可以直观看到区别。在双子图柱状图与多组散点图的案例中,Plot2Code 和 ChartGalaxy 往往退化到 Matplotlib 的原生配色和粗糙布局,丢失了参考图极具辨识度的低饱和度色彩;METAL 在尝试匹配原图时,由于受到新数据点分布差异的干扰,导致图例被硬性塞进了数据密集区;ChartIR 虽然修补了图例遮挡,但图表内边距与刻度字体依然十分粗糙。唯有 FigMirror 完整复刻了参考图细腻的双栏布局、小刻度朝向、特定的网格透明度,同时精准呈现了完全属于用户自己的新数据。
消融实验进一步剖析了 FigMirror 内部各个组件的真实贡献:
-
移除 Grounded Measurement:当剥离坐标定位微探针、让智能体退化为直接肉眼观察参考图写代码时,综合评分出现断崖式下跌,代码层分数暴跌。这表明大模型所谓的“看图写样式代码”,在缺乏精确物理测量时基本处于模糊猜测状态。
-
移除 Reviewer 闭环:仅保留 Drawer 及其单次测量与自检,综合得分下降约 3 分,主要损失体现在视觉通道上。缺少 Reviewer 的外部局部红框标记,一些微小的标签穿透和子图边距拥挤无法被自发察觉。
-
纯裸跑 Codex 智能体:完全移除 FigMirror 技能包,直接用提示词驱动底座模型,各项指标全面垫底。
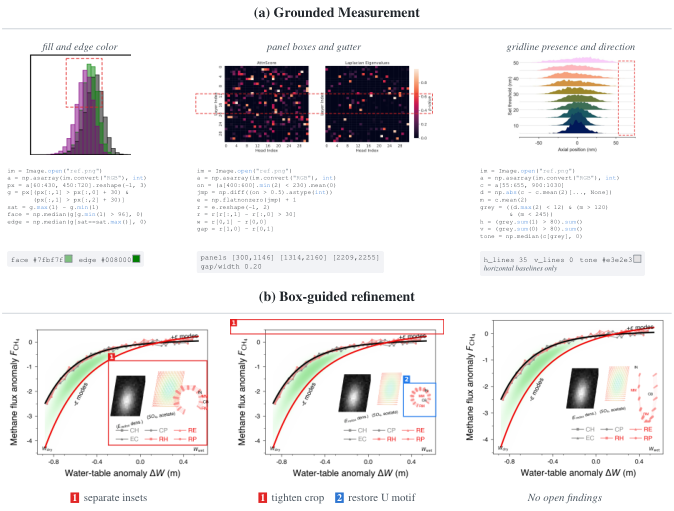
对迭代轮数的探究展现了这套机制的收敛特性。随着迭代轮数从 1 轮增加到 3 轮再到 5 轮,综合得分从 71.8 稳步上升至 74.3。在从第 1 轮到第 3 轮的过程中,代码层得分基本保持稳定,而视觉得分提升了 1.4 分;这意味着前期的属性测量非常稳固,后续的审查迭代主要在集中消灭布局层面的微小重叠。同时,Reviewer 的无状态审计机制(Stateless Audit)展现出了类似于人类画图时的递进审美:在第一轮中,Reviewer 重点圈出了子图重叠这种宏观硬伤;在子图分离后,第二轮审查立刻浮现出次级问题——顶部外边距过大、U 型符号被压缩;第三轮完成微调后,红框彻底归零。因为有 Preserve List 的锁定,后续轮次对微观细节的修补完全没有破坏前一轮已经配准的全局色板。
对科研与智能体交互的延伸思考
FigMirror 给学术界和工程界带来的启发,远不止于“生成更漂亮的 Matplotlib 代码”。
在很多人的直觉中,大模型的 Agent 框架只要赋予其“看图、反思、写代码”的权限,模型就能像人类专家一样自发解决复杂的多模态排版问题。但 FigMirror 的实验结果表明,端到端的通用视觉模型在面对高精度、确定性的任务时,依然存在严重的“浮于表面”问题。把大模型当成全知全能的肉眼审稿人往往会失败,而将大模型降维作为“坐标定位器”,把具体的测量职责交还给一行行确定性的 Python 代码探针(取 RGB、算边缘方差、求像素跨度),反而能够爆发出惊人的工程威力。
这也是大模型工具调用(Tool-use)在多模态理解领域的一种高级范式:不要强求模型在神经权重内部完成亚像素级的连续空间数值推理,而是让模型把任务翻译成能够与数字世界精准交互的物理程序。
随着多模态大模型在 GUI 操控、操作系统自动化领域的不断突破,模型对屏幕图元的坐标感知正在变得极度敏锐。FigMirror 证明了这种为了让 AI 操作浏览器和软件而诞生的 Computer-use 底层能力,可以作为一种通用几何定位先验,反哺到学术绘图、数据可视化乃至工业设计等更为严肃的生产力场景中。让视觉风格从一种模糊的玄学感觉,变成可以被精确定位、精确测量并可程序化迁移的代码资产,这或许才是多模态 Agent 走向真实科研工作流的正确姿态。