EvolvingWorld:让角色与世界双向协同演化,破除长程叙事模拟衰退
EvolvingWorld: An Open-Schema Framework for Co-Evolving Role-Play Agents and World Model in Interactive Literary World
在大语言模型被广泛用于角色扮演(Role-Playing Agent)的今天,大部分智能体系统依然停留在“复刻静态人设”的阶段。无论是与用户聊天的拟人伴侣,还是在多智能体沙盒中走动的小镇居民,系统往往预先填好一张属性表:姓名、性格特质、说话风格、背景故事。在两三轮简短对话中,这种模仿足以让人感到生动自然。然而,一旦把模拟周期拉长到跨越多个章节或场景的长程文学世界,传统系统就会迅速暴露缺陷:角色遭遇重大挫折后依然维持原本的情绪倾向,环境发生了翻天覆地的剧变却对人物动机毫无波及,或者角色状态被粗暴、突兀地修改,导致整条叙事轨迹严重断裂。
ArXiv URL:https://arxiv.org/abs/2607.17250v1
现实与文学叙事中的世界并非单纯的布景板,人物也绝非固定台词的提线木偶。故事的发展本质上是一场角色与世界之间的双向演化(Co-Evolution):角色的行为塑造着周围的物理实体与社会关系,而世界环境的变迁又持续重塑角色的内心信念与行动动机。
针对这一长期被忽视的瓶颈,来自香港科技大学、华中科技大学以及 Lightspeed 等机构的研究团队提出了 EvolvingWorld。这是一个面向交互式文学世界模拟的开放架构(Open-Schema)协同演化框架与基准。该系统摒弃了过去将模拟等同于孤立场景生成的做法,将文学世界交互建模为状态持续更新的长程过程。通过解耦且紧密咬合的 Character Agent 与 World Model,配合涵盖 57 本经典著作、近 14 万个训练样本的数据体系,EvolvingWorld 在长程模拟中显著缓解了性能衰减问题,甚至在画像演化的平滑度上展现出随时间递增的连贯性。
为什么固定槽位无法承载真实的文学模拟?
要理解 EvolvingWorld 的技术路径,首先需要审视既有角色扮演框架的核心痛点。长期以来,多智能体叙事模拟面临着两堵难以逾越的墙:其一是固定模式(Fixed-Schema)的僵化,其二是缺乏精细世界模型支撑的单向更新。
在以往的研究如 BookWorld 或各类沙盒系统中,系统往往预先定义了一组通用的属性槽位,例如“目标”、“当前情绪”或“记忆列表”。然而,文学作品千差万别。福尔摩斯探案小说中关键的追踪线索、推理习惯与法医观察维度,不可能生搬硬套到狄更斯笔下维多利亚时代孤儿的社会阶层依附与生存焦虑中;同样,魔幻现实主义中的超自然规则与政治秩序演化,也无法塞进普通的日常对话槽位里。强制采用固定槽位,不仅丢失了具体文学作品独特的叙事肌理,也限制了智能体对非预设维度的感知。
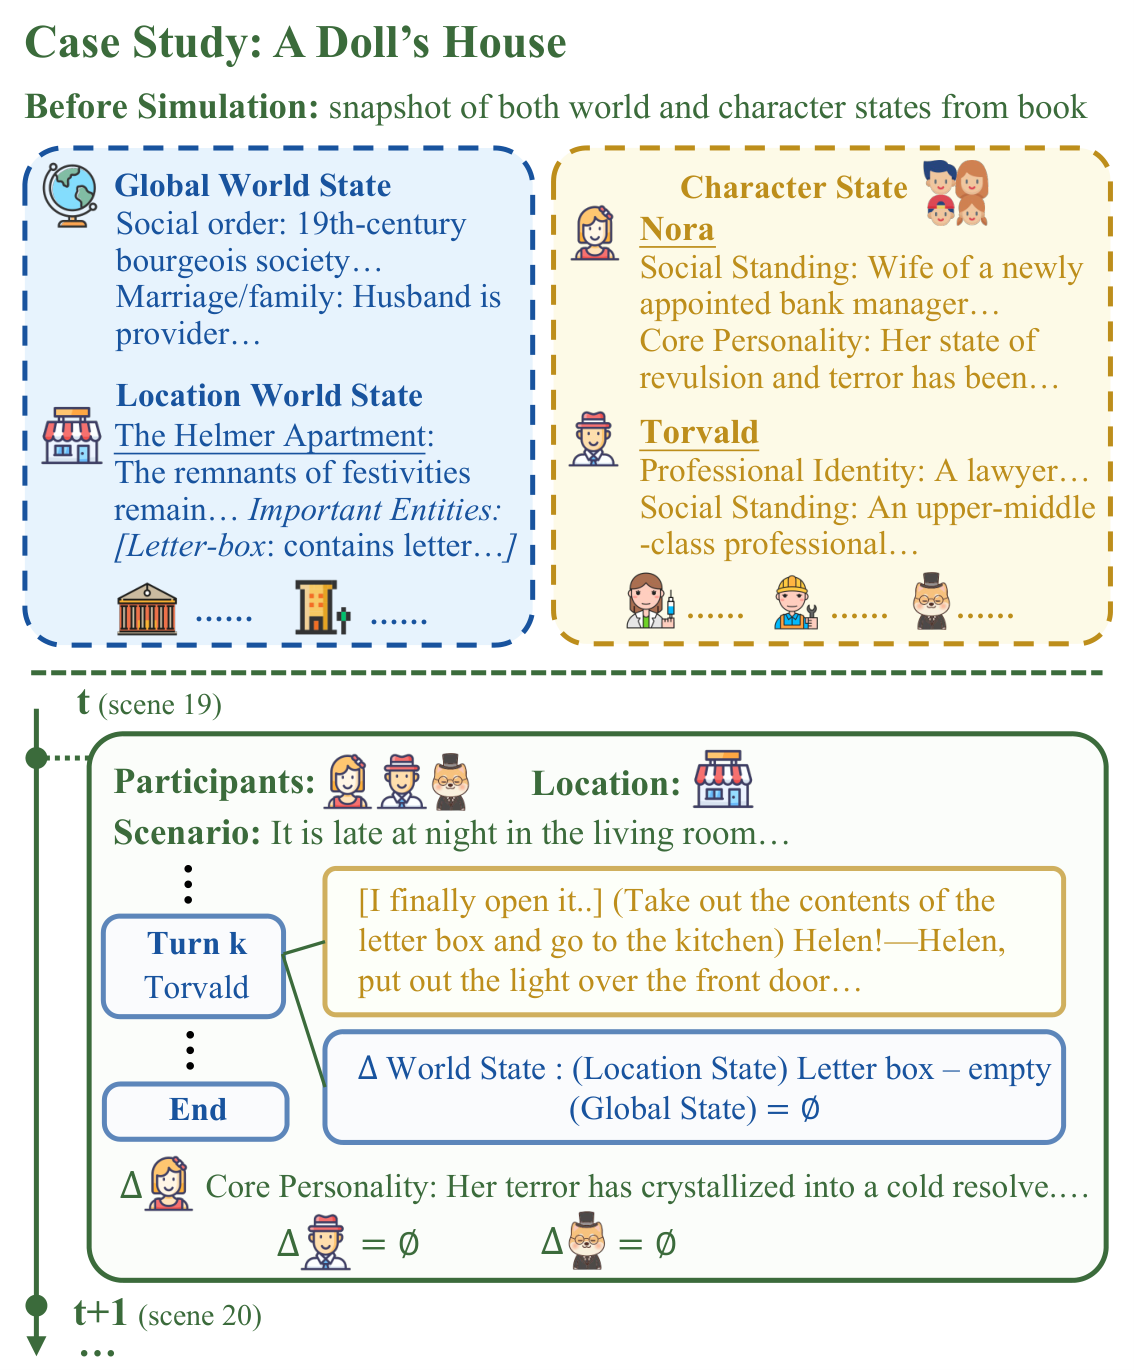
另一个致命弱点在于角色的“突变”与环境的“失真”。在长程交互中,大模型经常因为单次事件就彻底推翻此前的人格特征,产生情绪跳跃(OOC,Out of Character);与此同时,多数系统要么根本没有环境状态维护,要么仅记录几行全局事件,无法下潜到具体地点和实体。当一个角色在一间书房里烧毁了一封信,下一个场景来到该书房的角色理应发现灰烬与失踪的文件,但在缺乏地点与实体级物理状态追踪的系统中,这种长程因果链条通常会直接蒸发。
EvolvingWorld 明确提出,文学世界模拟的目标不应当是机械复读原始书籍,而是在一个给定的故事快照(Snapshot)之后,维持一个扎根于原著、却能由互动驱动且连续演化的动态世界。为此,框架确立了开放架构与角色-世界双向协同的基本原则。
架构解耦:开放画像的智能体与分层世界模型
为了实现这一目标,EvolvingWorld 将模拟系统解耦为两个既各自独立又紧密咬合的模块:Character Agent(角色智能体) 与 World Model(世界模型)。
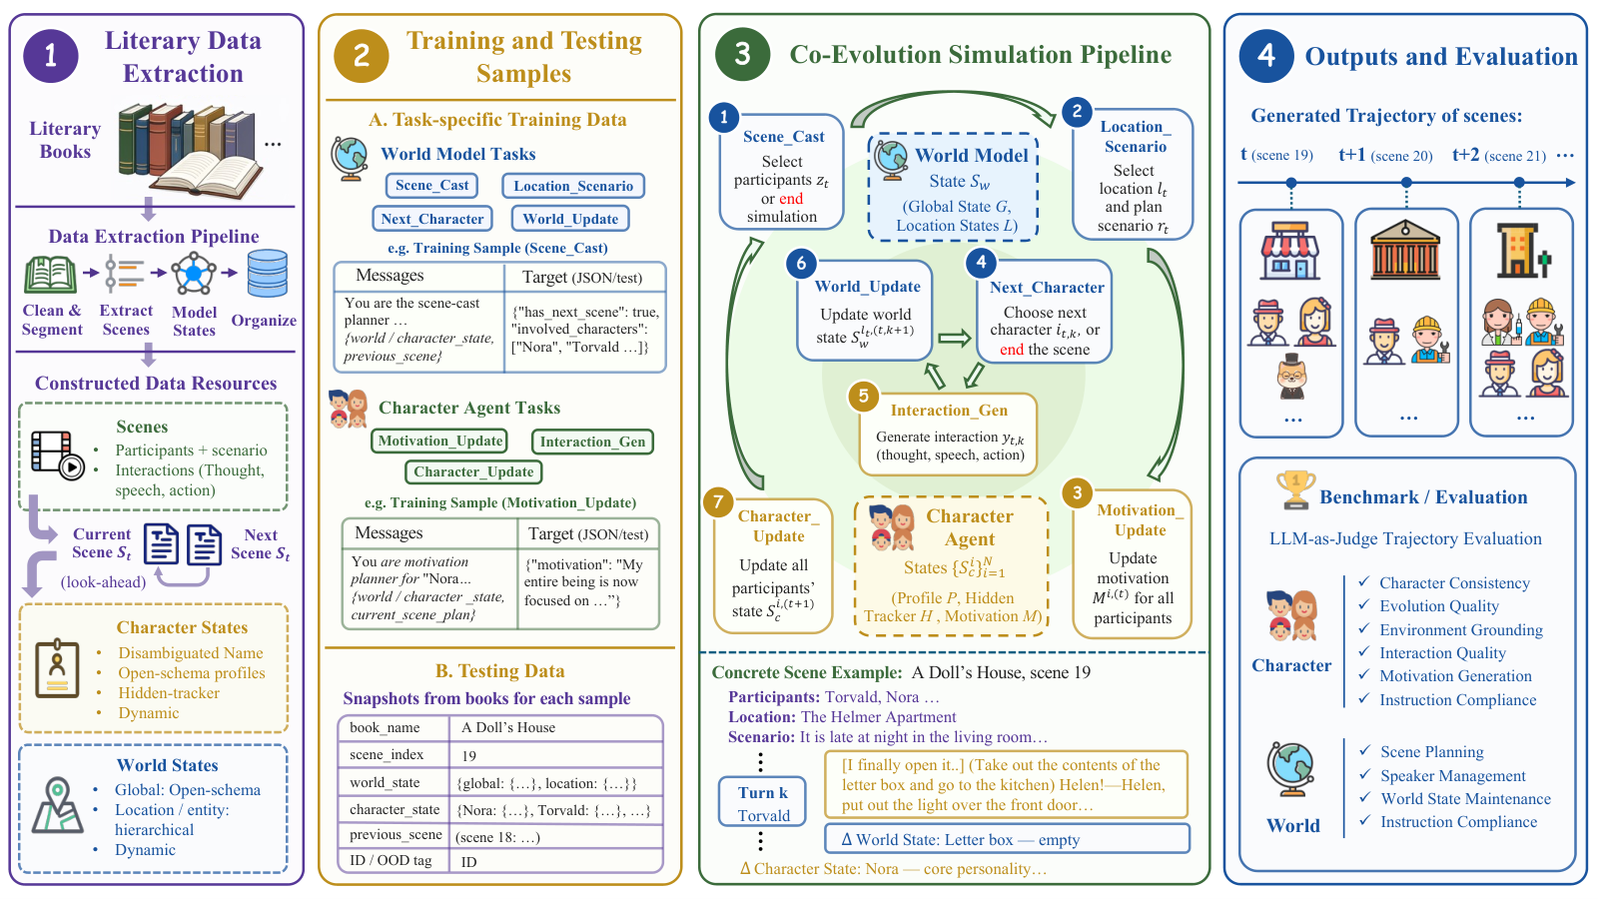
在角色端,系统赋予每个角色一个开放架构的画像(Open-Schema Profile)。构建角色状态时,提示词仅提供参考方向,大模型会根据作品的流派、时代背景与文风,自主选择、合并或派生出专属的属性维度。更关键的设计在于对状态演化“时间尺度”的精确拆解。角色属性的演变速率存在天然差异:瞬时心境可以在一次对话后迅速起伏,但深层的性格特征、道德底线或根深蒂固的人际关系偏见,必须依靠反复出现的微弱信号逐渐沉淀。
如果大模型在每一个单轮交互后都强行改写长期人设,系统就会迅速陷入崩塌。EvolvingWorld 在此引入了一个巧妙的机制——隐藏追踪器(Hidden Tracker)。隐藏追踪器独立于对外呈现的正式画像,专门用于在后台记录尚未积累到质变程度的微弱线索与萌芽线索。只有当隐藏追踪器中积累的证据跨越多个场景达到一定阈值,且与当前维度的可变性(Changeability)相匹配时,系统才会触发正式画像的更新。这种设计构筑了一道缓冲堤坝,兼顾了即时互动的响应性与长线人设的稳固度。
在世界端,World Model 负责统筹叙事推进与物理环境演进,并维护两层状态:全局世界状态(Global World State)与地点及实体级物理状态(Location/Entity-Level State)。全局状态涵盖政治格局、社会制度、宏观历史背景等系统性条件,同样采用开放架构生成;地点状态则具体到特定地点的空间描述以及关键物品的现状。当场景发生转移时,世界模型确保环境的变迁具备物理连续性。
这两个模块的交互构成了闭环。世界模型决定当前场景的发生地点、在场角色以及场景触发原因;角色智能体在特定地点与局部物理条件的约束下展开多轮互动并产生内心独白;互动产生的行为反过来修改该地点的物理与实体状态;最终,场景结束后,角色的隐藏追踪器与画像结合本轮事件完成跨场景更新。
拆解为七项可训练子任务与高质量数据提炼
为了摆脱单纯依赖黑盒商业模型 Prompting 带来的不可控性,研究团队将端到端的模拟过程严格形式化拆解为 7 个可训练子任务(Trainable Tasks)。在任意场景时间步 $t$ 下,这 7 项任务按序运转:
-
场景参与者选择:世界模型根据全局状态与所有角色的当前状态,决定哪些角色应当汇聚在下一个场景;
-
场景初始化:选定发生地点与触发原由,构建具体场景舞台;
-
角色私有目标生成:在场角色根据自身状态与现场环境,产生各自的瞬时目标与心理动机;
-
发言顺序规划:世界模型在场景内部动态仲裁下一轮应由谁做出反应,避免多角色齐声说话的混乱;
-
角色交互生成:选定角色综合自身画像、地点状态与上下文历史,输出包含言语、内心独白及肢体动作的交互内容;
-
局部世界状态更新:世界模型依据刚刚发生的动作,实时修改该地点的物理与实体状态;
-
角色状态更新:场景落幕后,角色综合场景全局过程与环境变化,刷新隐藏追踪器与正式画像。
为了给上述 7 项任务提供可靠的高质量监督信号,研究团队从古登堡计划(Project Gutenberg)中筛选了 57 本严格按时间线推进叙事的经典文学名著。按时间线叙事的特点极为关键:它允许系统在数据提取阶段,将后续章节自然发生的事件作为前向参照证据(Look-Ahead References)。团队借助 Gemini-2.5-Pro 作为提取核心,将整书切块并处理跨块边界,抽取出包含细粒度状态变化的演进数据。最终,该流程转化出 138,596 个有监督微调样本,以及 222 个用于推断评测的测试快照。
这一监督微调数据集将通用指令微调数据集(Tulu3)按 1:1 的比例进行混合训练,从而在注入复杂的长程状态追踪与角色生成能力的同时,避免模型退化通用语言理解能力。实验覆盖了从 4B 到 32B 的多个开源基准模型,包括 Llama-3.1-8B-Instruct、Qwen2.5-7B/14B/32B-Instruct 以及最新的 Qwen3-4B-Instruct。
告别空泛打分:20 项指标的轨迹级评测框架
以往的角色扮演评测大多依赖局部的单轮问答、静态人设问卷(如性格测试),或者仅就语言流畅度进行大模型打分。这类方法完全无法衡量“角色是否合理地成长”、“世界变迁是否符合因果”。
EvolvingWorld 建立了一套轨迹级(Trajectory-Level)的 LLM-as-Judge 评测体系。评测将指标划分为两大族系(CHARACTER 与 WORLD),共覆盖 10 个核心维度与 20 个量化指标,所有指标均归一化至 0–100 分。
在角色维度,评测不仅关注角色在对话中的逼真度,还重点考察“画像演化平滑度(Profile Evolution Smoothness, PES)”、“事件驱动的性格可塑性”以及“私有目标与动作的一致性”;在世界维度,则深入量化“场景连续性与连贯性(Scene Continuity & Coherence, SCC)”、“地点实体状态保真度”以及“宏观因果传递的逻辑性”。
为了防止传统大模型评测中常见的幻觉与打分漂移,系统采用单指标独立评判(Per-Metric Independent Judge)方案,主评测模型选用 Claude-3.5-Sonnet。每个评判 Agent 在打分时仅被喂入与当前指标直接相关的局部轨迹切片与专属评分细则(Rubric),杜绝上下文污染。同时,框架对长程模拟中的非正常中断实施显式惩罚,如果模型因指令遵循失效而导致仿真链条提早崩塌,惩罚机制会直接作用于连贯性与合规性得分,从而倒逼生成质量。
对抗“越走越乱”:长程模拟中的反直觉表现
长程模拟实验揭示了 EvolvingWorld 最核心的价值所在。在基准对比中,最具代表性的长程多智能体文学模拟基准 BookWorld 暴露了明显的长程衰减趋势。
在常规系统里,模拟的轨迹越长,上下文累积的噪音就越多,模型对初始设定的遗忘或过度篡改就越严重。然而,当观察随交互场景步长推移的关键指标走势时,出现了反直觉的对比现象。在衡量人设过渡自然程度的 PES 指标与衡量场景连贯性的 SCC 指标上,BookWorld 呈现出持续走低的恶化态势;但接入 EvolvingWorld 机制的模型不仅在绝对分值上全面压制了传统方案,更在长达数十个场景的演进过程中保持了评分的稳定,其画像演化平滑度甚至伴随模拟深度的增加呈现出轻微上升的趋势。
这一结果有力地印证了系统设计的有效性:结构化的显式状态追踪与隐藏追踪器并不会给生成带来累赘,反而为模型提供了一条稳定的长程锚线。在没有隐藏追踪器的情况下,大模型容易在短视的局部文本中迷失,导致行为反复无常;而有了开放架构的世界模型在实体级别持续锁定事实,角色在任何一个新场景中都有据可循,自然能够演绎出连贯且富有张力的叙事弧线。
同时,对未参与训练的书籍进行的域外(OOD)泛化测试表明,在完全陌生的文学世界与设定规则面前,经过 7 项子任务微调的模型依然能够稳健地提取专属维度、自主演变全局状态并驱动合理的多角色冲突,证明了这套开放架构方法论并不依赖特定书籍的特定背景知识。
局限性与开放世界的未来演变
尽管 EvolvingWorld 为文学世界的持久演化确立了清晰的框架,论文作者也坦承了当前系统存在的局限。最显著的简化在于“客观世界”的单一性设定:在 EvolvingWorld 当前的实现中,世界模型维护着一个所有角色共享的绝对客观事实。
然而在真实的文学作品中,世界往往是主观映射的。不同角色因其立场、认知局限与情感滤镜,对同一物理世界的感知与记忆往往大相径庭:有人视当前环境为避风港,有人视其为牢笼;甚至某个角色会因为记忆偏差,坚信一把凶器在桌子上而非抽屉里。这种“主观心智模型(Theory of Mind)”与“客观世界物理状态”的错位,正是推动高级文学冲突的核心动力。由于为每个角色独立维护一套主观世界模型会呈指数级推高系统计算复杂度,当前系统尚未完全放开这一维度。
另一个现实考量在于数据版权。由于合规限制,基准数据主要基于公有领域的经典名著,暂时未纳入现代长篇网文、互动游戏脚本等强沉浸式文本。不过,这属于数据供给侧的限制,开放架构的技术内核已为扩展到现代游戏 NPC、虚拟社区构建与互动叙事创作扫清了底层结构上的障碍。
文学作品从来不是一具冰冷的标本,它是一个生生不息的动态系统。EvolvingWorld 的尝试表明,大模型角色扮演的发展方向,正在从“像某个人说话”演进为“在一个不断变化的世界中与他人共同生存与蜕变”。这种跳出固定槽位、将角色演化与环境变迁深度耦合的解题思路,无疑为下一代开放世界叙事引擎与长程多智能体系统的构建,提供了扎实的技术基座。