ART:给具身大模型引入即时工具调用,成功率提升超20%且不毁动作
Evolve Vision-Language-Action Model into an Agent with On-the-fly Tool-use
在具身智能的落地过程中,端到端视觉-语言-动作(VLA,Vision-Language-Action)模型一直是学界与产业界寄予厚望的架构。从 Google 的 RT 系列、OpenVLA 到最近备受关注的 $\pi_0$,研究者尝试把多模态感知与高维动作空间融合进单个大模型中,让机械臂根据摄像头画面和自然语言指令直接吐出毫米级的关节控制量。然而,这种端到端的美好设想在真实的物理环境中正遭受严峻挑战:一旦环境光线变暗、摄像头产生轻微抖动、观测视角略微偏移,或者提示词中包含“抓取最远处的杯子”这类需要多步几何空间推理的高层意图,端到端 VLA 模型的执行成功率往往会呈断崖式下跌,甚至直接停滞。
ArXiv URL:https://arxiv.org/abs/2608.14047v1
出现这种脆弱性的根源,在于模型试图用一个连续动作解空间去硬扛所有维度的干扰。如果为了适应暗光或视角变化去重新微调基础大模型,不仅需要采集极为昂贵的高质量示教数据,还极易引发灾难性遗忘,破坏模型原先已经学得很好的连续控制手感。为了打破这一困局,来自星尘智能(Astribot)、云天励飞、聚溪科技、香港中文大学与清华大学的研究团队提出了一种名为 ART(Agentic Robot with Tool-use)的全新工具注入微调框架。
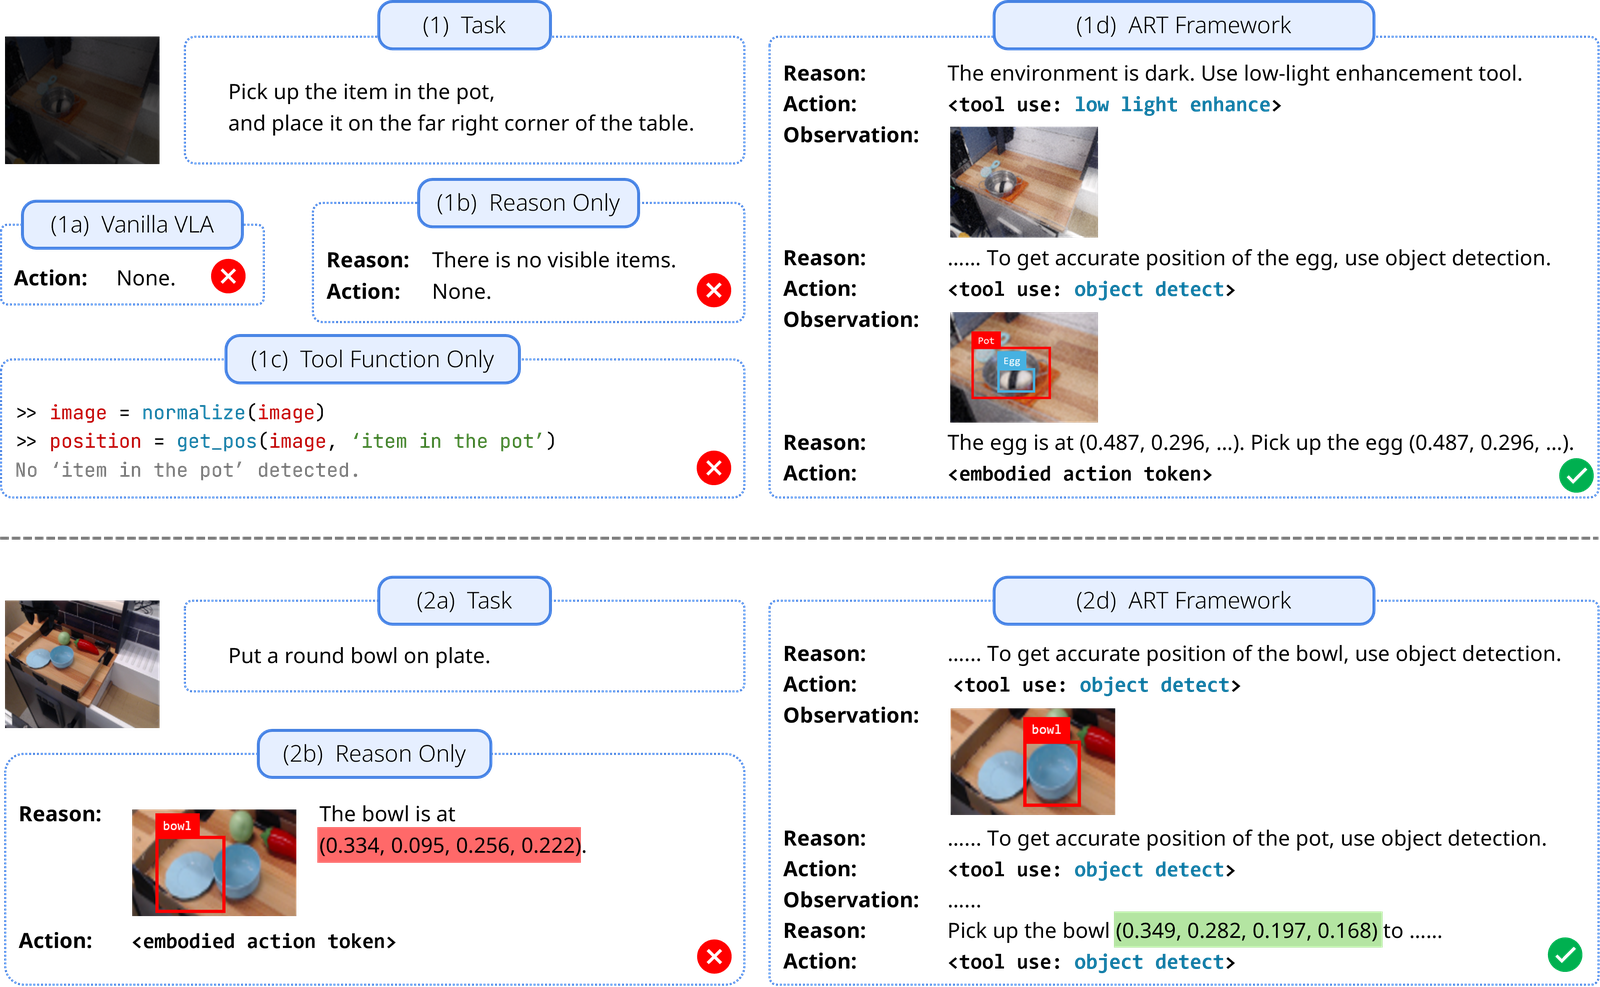
ART 的核心思路非常明确:与其让一个端到端策略网络在黑盒状态下硬解全部视觉噪声和几何推理,不如赋予它像多模态 Agent 那样“即时调用外部工具”(On-the-fly Tool-use)的能力。在遇到低照度时自主调用暗光增强工具,在面对模糊距离指示时调出深度估计模型,在底盘发生位移时自动调用相机云台重置视场。更关键的是,研究团队通过一种非破坏性的双阶段微调与 LoRA 解耦机制,让模型在学会调用工具的同时,完全保留原生的连续动作精度。在仅使用 3 万条合成工具轨迹微调的情况下,ART 在 LIBERO 仿真基准以及 Astribot S1 双臂人形机器人上的平均成功率相比主流基线取得了超过 20% 的大幅提升,在许多原本导致模型彻底失效的极端扰动场景中依然能稳定完成闭环操作。
为什么端到端硬扛会陷入死胡同?
要理解 ART 的价值,首先需要审视当前机器人行为生成的两条技术路线。第一条是经典的模块化行为合成路线,代表工作如 RoboTool、RoboScript 等。这类方案将感知、目标定位和技能执行切分成彼此独立的模块,核心大模型只需扮演规划器角色,按需生成代码或调用预定义的 API。这种解耦固然赋予了系统极强的可解释性与工具扩展性,但由于其底层依赖离散的预定义运动原语,机械臂失去了高频、细腻且灵活的连续控制能力,难以处理复杂的动态接触任务。
另一条路线则是目前处于主流地位的端到端 VLA 方案。这类模型直接将图像 $\boldsymbol{o}_t$ 和语言指令映射为高频动作序列 $\boldsymbol{A}_t$。然而,端到端结构有着极为苛刻的隐性前提:模型默认输入的视觉信号永远清晰无暇,且训练分布必须覆盖各种光照、遮挡、反射和相机机位。一旦现实环境与数据分布稍有偏差,连续动作策略就会迅速发散。近期 LIBERO-Plus 等评估工作已经证实,哪怕只是改变光线明暗或微调机械臂初始摆位,最顶尖的 VLA 模型的任务完成率都会直接骤降到 30% 以下。
以往解决这一问题的常规手段是暴力扩充多任务数据集,或者在输入端引入思维链(ECoT)进行自回归文本推理。但纯文本的思维链并不能实质性修复模糊退化的图像输入;而全参数微调不仅计算成本巨大,还会导致原有的运动技能发生严重漂移。这促使研究团队去思考:能否让连续动作的输出机制保持纯粹,而在感知输入与高层可供性(Affordance)理解层面,允许模型在推理时即时引入专门的视觉与几何工具进行“感知矫正”?这正是 ART 诞生的逻辑起点。
动态解耦架构:离散工具决策与连续动作生成的统一
为了在同一个模型内融合离散的工具调用与高保真动作生成,ART 对 VLA 的优化目标进行了显式分解。标准的 VLA 训练通常是在高质量清晰观测序列 $\boldsymbol{o}{1:T}$ 上最大化真实动作序列的条件似然概率 $P\theta(\boldsymbol{a}{1:T} \mid \boldsymbol{o}{1:T})$。但在实际运行中,输入的观测往往包含退化或不确定性,记为 $\tilde{\boldsymbol{o}}{1:T}$。ART 将联合优化目标分解为两个部分:一个是原本基座模型在增强后清晰输入下输出具身动作的概率分布 $P{\theta,1}(\boldsymbol{a}t \mid \boldsymbol{o}{1:t})$,另一个则是专门用于环境状态推理与工具选择的微调目标 $P_{\theta,2}(\boldsymbol{a}{\mathrm{r},t}, \boldsymbol{a}{\mathrm{t},t} \mid \tilde{\boldsymbol{o}}_{1:t})$。
这里的符号设定展示了机制上的精妙区分:$\boldsymbol{a}{\mathrm{r},t}$ 代表模型输出的离散语言推理 Token,用于阐明为什么当前需要辅助;$\boldsymbol{a}{\mathrm{t},t}$ 则是离散的工具调用向量。因为每个工具在某一时刻只有“激活”与“关闭”两种状态,如果系统预备了包含 $n$ 个工具的工具库 $\mathcal{F}$,那么工具决策动作就可以严格形式化为二进制离散向量 $\boldsymbol{a}_{\mathrm{t},t} \in {0, 1}^n$。
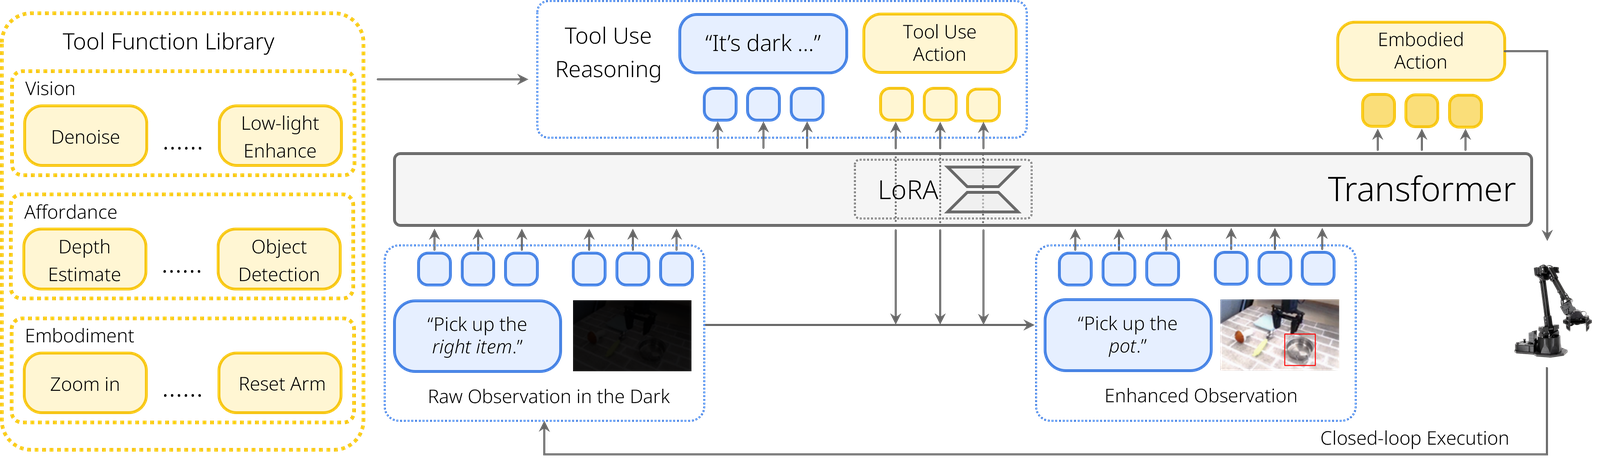
为了把工具决策无缝编排进 Transformer 解码器,研究团队遵循 OpenVLA 与 RT-2 的词表复用经验,把词表末尾的 $N$ 个闲置特殊 Token 映射为工具激活标志。当模型观察到输入画面后,解码器像生成自然语言一样,以自回归方式先吐出推理 Token $\boldsymbol{a}{\mathrm{r},t}$,紧接着吐出对应的工具调用 Token $\boldsymbol{a}{\mathrm{t},t}$。
随之而来的关键工程挑战是:如何确保工具微调不会搞乱底座模型原有的抓取、放置等连续控制权重?ART 采取了一种非破坏性的动态 LoRA 适配机制。在整个训练和部署过程中,原始 VLA 骨干网络(以 30 亿参数的 $\pi_0$-FAST 模型为基座)的参数全部被冻结,唯独给注意力层挂载的专门 LoRA 模块开放梯度。在微调工具决策阶段,模型计算交叉熵损失:
\[\mathcal{L}_{\mathrm{tool}}=-\sum_{t=1}^{T}\log P_{\theta_{\mathrm{L}}}(\boldsymbol{a}_{\mathrm{r},t},\boldsymbol{a}_{\mathrm{t},t}\mid\tilde{\boldsymbol{o}}_{1:t})\]其中 $\theta_{\mathrm{L}}$ 表示 LoRA 模块的专属权重。在完成工具决策并触发外部模块对原始输入 $\tilde{\boldsymbol{o}}t$ 进行矫正后,系统会动态将 LoRA 层的输出置零或屏蔽。随后,增强后的清晰特征被重新馈入已经冻结的基座网络,以原本的连续控制能力计算动作损失 $\mathcal{L}{\mathrm{action}}$。通过这种时序上的门控切换,推理与决策完全依托于轻量适配层,而机械臂底层的连续轨迹生成丝毫不受污染。
此外,为了与现代高性能 VLA 常用的 Action Chunking(动作分块)技术兼容,ART 并不在每一个细粒度的机械臂控制步(如 20Hz 甚至 50Hz)反复触发沉重的外部工具推理。系统被配置为每隔 $H$ 个控制步执行一次工具仲裁。模型一次性推理出未来 $H$ 步内的环境评估与工具调用组合,被选中的工具作用于接下来 $H$ 步的时序观测,从而在保证高频实时响应的同时显著压低了系统算力负载。
三维工具库与高质量合成轨迹构建
有了灵活的调用机制,模型还需要知道在什么情况下该调用什么工具。ART 围绕真实机器人操作中最常遭遇的三大痛点,构建了三类插件工具,并依此构建了名为 AT(Action with Tool)的数据增强闭环:
-
视觉增强工具库(Vision Enhancement):针对弱光、噪点、镜头抖动、曝光过度、运动模糊等 10 种常见传感器异常,集成了成熟的轻量级底层图像处理算法。当机械臂需要在昏暗库房中作业时,模型能够自主识别并唤醒暗光增强工具。
-
可供性增强工具库(Affordance Enhancement):针对自然语言中模糊的空间方位指令,集成了开放词表目标检测算法(如 Grounding DINO)与单目深度估计模块(如 Depth Anything)。当用户下达“把东西放到最靠左的托盘”或“捡起离夹爪最远的积木”时,模型能主动调取深度与边框信息,将高层语义精准锚定在物理像素上。
-
具身状态增强工具库(Embodiment Enhancement):针对机械臂初始关节死锁、基座位置偏移或头顶相机视角偏差等问题,提供了相机变焦、视角转动伺服以及机械臂关节初始位重置的原语指令,使系统具备“自己调整姿势重看一眼”的元认知调节能力。
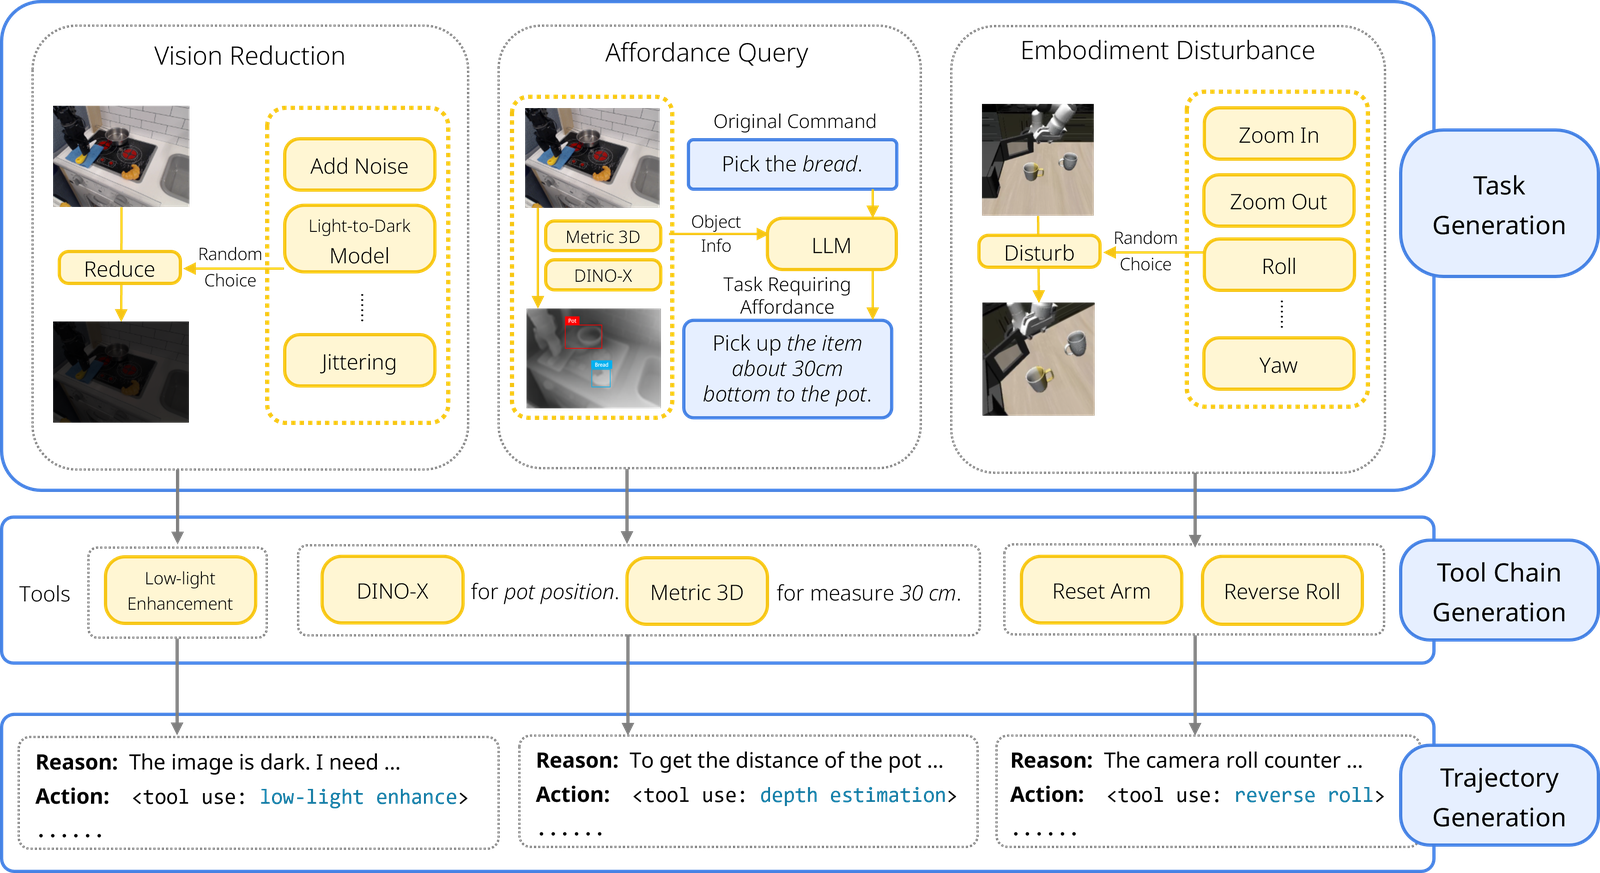
要想让 VLA 学会熟练使用这套工具库,如果全靠人工在真实机器人前摆放道具并逐条标注工具使用时机,成本将无法承受。研究团队提出了一种巧妙的数据反向构建范式,通过三步管道直接从现存的开源机器人数据集(如 LIBERO、Bridge v2 和 DROID)中盘活并衍生出工具使用轨迹:
首先是任务降级与扰动注入(Task Generation)。系统对原始干净轨迹进行自动化“破坏”,在图像上叠加暗光、模糊或噪点滤镜,或者利用 GPT 将原始简单的语言指令(如“拿起杯子”)重写为强依赖相对空间关系的复杂提问(如“拿起离红碗 20 厘米外的杯子”)。
其次是工具链对齐(Tool Chain Generation)。根据注入扰动的类型,自动化算法会确定解决该扰动所需的工具依赖链。例如针对“暗光下定位深处物体”的任务,工具链会自动规划为“暗光增强模块 $\rightarrow$ 深度估计算法”。
最后是长轨迹思维链合成(Trajectory Generation)。利用大型多模态语言模型,以退化输入和对应的工具链为上下文,自动补全详尽的推理思考文本(CoT)。大模型会生成解释当前视觉缺陷原因、阐述为什么选择特定工具以及预测增强后效果的完整思考流。
整套流水线不仅免除了人工二次示教采集的高昂开销,还高效率地构建出了包含 3 万条具备完整工具链推理与连续控制标签的 AT 数据集。相比于动辄耗费数万小时机械臂真实遥操作的传统基线,这 3 万条轨迹的数据规模极小,但信息增量与任务难度却远超纯静态演示。
实验评测:极端扰动下的真实控制表现
为了严谨验证 ART 的有效性,研究人员在 LIBERO 仿真基准平台以及搭载 16 自由度双臂的人形机器人 Astribot S1 上进行了系统性闭环评测。训练设定上,模型在 8 张 A800 GPU 上仅需微调 1 个 Epoch(Batch Size 为 24,初始学习率 $5\times 10^{-5}$,带有 1000 步 Warmup),计算开销极度克制。
在 LIBERO 仿真环境中,研究人员引入了光照剧烈变化、高斯噪点、视角偏移以及精细空间关系描述等复合扰动。在常规整洁数据上表现出色的 OpenVLA 和基础版 $\pi_0$ 模型,在遭遇这些扰动时平均成功率甚至无法维持在 30%。由于视觉特征的严重漂移,基线模型的动作输出层发生了严重的置信度塌陷,机械臂频繁出现晃动、误抓或在半空中僵死不动的问题。
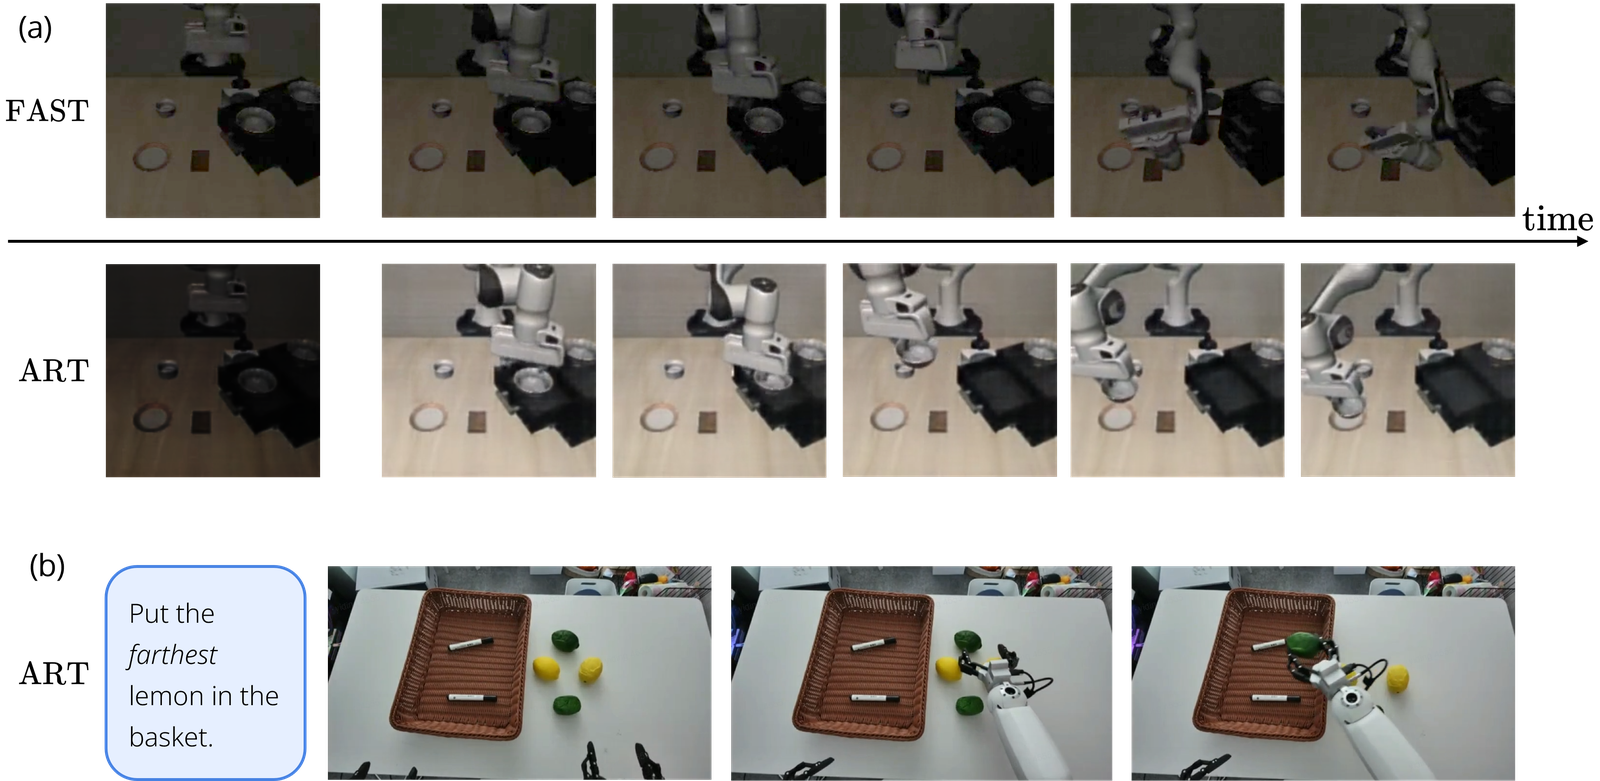
与此形成鲜明对比的是,接入工具库并经过微调的 ART-FAST 模型在仿真环境下的平均任务成功率跃升至 75%。如上方实验轨迹所示,在漆黑无光的弱光场景中,$\pi_0$-FAST 由于看不清桌面物体,末端执行器始终无法对准目标;而 ART 在第一阶段自回归输出中果断激活了视觉增强工具,将提亮除噪后的高信噪比画面回传给被冻结的动作预测头,使机械臂顺畅完成了拾取与放置。在空间可供性推理测试中,当指令包含复杂的相对位置推断时,未装备工具的基座模型完全无法预测出有效的动作 Token,直接进入死锁;ART 则通过主动唤醒目标检测与深度工具圈定目标坐标,迅速恢复了流畅的连续控制。
在真实的 Astribot S1 双臂人形机器人测试中,模型直接面对物理环境中真实灯光阴影、非标摆放位置以及新型容器的泛化挑战。ART 依然取得了 62% 的高成功率,超出主流对照模型 20% 以上。这一结果证明,在 AT 数据集上训练得到的工具决策元能力具有高度的跨域迁移性。更令人信服的消融实验表明,当与仅使用思维链推理(ECoT)但不具备外部工具调用能力的模型相比,纯靠自回归文本“硬想”的基线在遭遇严重视觉扰动时依然无能为力,成功率提升非常有限;只有真正把感知与计算负荷卸载(Offload)到经过验证的专业工具上,动作执行层才能获得坚实的先验支撑。
走向具备“感知元认知”的具身智能
ART 所展示出的技术演进方向,为具身智能走出实验室、进入充满不确定性的开放物理世界提供了一条极为现实的路径。在此之前,整个领域一度陷入了“参数量与无损数据量”的军备竞赛,研究者试图通过拼凑数以百万计的机械臂轨迹,去穷尽现实世界中千变万化的视觉噪点和几何特例,其边际效益递减十分显著。
ART 的实践证明,让端到端大模型学会在遇到困难时“求助于工具”,其系统鲁棒性远胜于要求它自身“无所不能”。将视觉矫正、深度探测等底层基础视觉任务剥离给专业小工具,不仅大幅降低了端到端模型的动作解空间复杂度,还彻底解决了微调过程中的动作灾难性遗忘问题。
从系统工程视角来看,这种基于 LoRA 门控的工具热插拔设计,赋予了具身系统极高的敏捷度。当工业现场或家庭环境中出现新型传感器(例如红外相机或触觉手套)时,开发者无需承受昂贵的全流程重训风险,只需将新模块封装成离散的工具 Token 接入工具池,即可让机械臂迅速掌握新能力。随着大模型在具身实体上的不断演进,懂得何时停顿、何时检查自身感知误差、何时向外部调用专用算子的“Agentic VLA”,或许才是机器人真正迈向全天候自主作业的关键形态。