PowerSlider:微软与康奈尔提出 PTA 解耦,30% 电网限电下推理吞吐提升 1.64 倍
PowerSlider: Exploiting Phase Asymmetry for LLM Serving under Demand Response
大模型集群的算力竞赛,正在以极快的速度撞上物理世界的硬墙——电力供应。美国能源部的预测显示,2023 年至 2028 年间,数据中心的用电量将增长 1.84 到 3.3 倍,而从提交电网接入申请到实际通电的等待时间,中位数已经突破了五年。电网运营商不再无条件承接新增的负荷,而是将电网接入容量与“需求响应(Demand Response)”深度绑定:数据中心必须承诺在电网遭遇高峰负荷或紧急事故时,迅速削减瞬时用电负荷,以此换取优先接入权和容量补贴。
ArXiv URL:https://arxiv.org/abs/2608.21719
这意味着,面向未来的大模型推理集群必须在一个随时间剧烈波动的瞬时功率上限(Time-Varying Power Cap)下运行。然而,现有的大模型推理系统几乎全都在假设静态功率环境,或者仅把节能当作一种总能耗(Energy)优化指标。当真实的电网调度指令在数分钟内将可用功率硬生生砍掉 20% 到 40% 时,传统系统的有效吞吐量(Goodput)往往会发生灾难性雪崩,请求队列迅速击穿服务等级协议(SLO)。
来自康奈尔大学(Cornell University)与微软(Microsoft)的研究团队给出了破局方案。他们在题为《PowerSlider: Exploiting Phase Asymmetry for LLM Serving under Demand Response》的论文中指出,大模型推理管道绝非均质的能耗黑盒:计算密集型的 Prefill 阶段对 GPU 降频极其敏感,吞吐随频率几乎呈线性衰减;而访存密集型的 Decode 阶段在降频至额定频率的 57% 时仍能维持相当的吞吐;若引入当下主流的思考型推理模型,其长思考链更对显存容量与调度施加了严苛约束。基于此,研究团队提出了 PowerSlider 运行时系统,通过将流水线解耦为 Prefill-Think-Answer 三阶段、引入带容忍裕度的 Flex SLO 契约,并借助极速 KKT 在线求解器在毫秒级内完成功率重分配,彻底打破了电网限电与服务质量不可兼得的死结。
为什么说电网限电是大模型推理的全新杀手?
过去关于绿色 AI 或能耗优化的研究,大多将优化目标定为“最小化能耗总量(Energy)”。能耗是功率对时间的积分,系统可以通过任务延期、低峰批处理等手段在宏观时间窗口内完成积分平衡。但需求响应场景施加的约束完全不同:它是电网运营商通过自动化控制系统下发的瞬时功率硬上限 $p_{\max}(t)$。在美国加州 CAISO 或德州 ERCOT 市场中,这种调度指令每 5 分钟甚至以秒级为颗粒度刷新,集群在每一个微小的观测区间内都绝对不允许越界。
面对突如其来的功率削减,传统做法通常只有两类:要么全集群均匀下调 GPU 运行频率(DVFS),要么按照固定的优先级策略直接丢弃低优先级任务。这两种策略在大模型推理负载下都会迅速失灵。
首要原因在于推理各阶段对硬件资源需求的天然不对称性。在标准自回归生成中,Prefill 阶段并行计算提示词的所有 Token,属于高度计算密集型(Compute-Bound),算力直接受制于张量核心的时钟频率。一旦通过 DVFS 压低频率,Prefill 的吞吐便近乎等比例下挫。反观输出生成阶段(Decode),其计算受限于显存带宽(Memory-Bandwidth-Bound),每个 Token 生成都需要从 HBM 完整加载庞大的 KV Cache。在较小的 Batch Size 下,即使将 GPU 频率一路下调至 810 MHz 甚至额定值的 57%,其吞吐曲线依然处于近乎平坦的饱和区。如果对整机统一暴力降频,相当于让 Prefill 阶段白白牺牲了大量宝贵的吞吐,去换取原本可以在 Decode 阶段以极小性能代价省下来的瓦特。
推理模型(如 DeepSeek-R1、OpenAI o1 等)的普及,进一步将这一不对称性推向极致。长思考链(Thinking 阶段)的内部 Token 生成,往往达到最终用户可见回答长度的 10 到 100 倍。这导致 Thinking 阶段不仅受带宽制约,更极度贪婪地侵占显存容量,引发严重的 KV Cache 颠簸与抢占。在电网限电的狭窄功率包络内,任何缺乏阶段隔离的调度都会引发排队时延的组合爆炸。
核心机制:从 PTA 解耦到 Flex 契约
PowerSlider 的设计核心,在于将电网削减下来的功率开销,精确“滑移”并分摊到那些单位瓦特性能损失最小的组件上。系统在硬件控制层与应用层之间搭建了一套三位一体的调度框架。
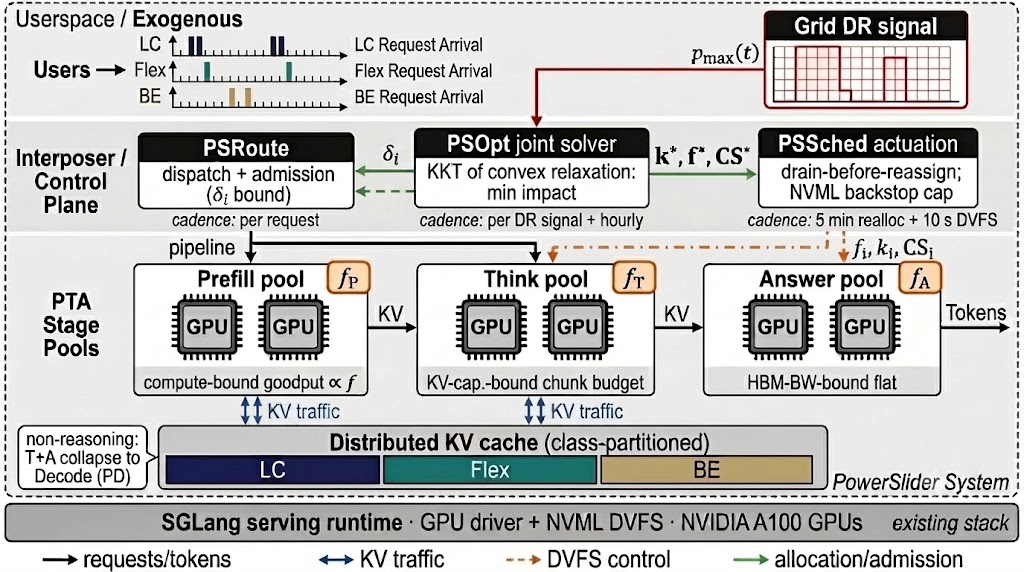
系统首先重塑了推理管道的底层架构,从经典的 Prefill-Decode(PD)两阶段解耦演进为 Prefill-Think-Answer(PTA)三阶段解耦。在物理集群中,PTA 将 GPU 划分为三个独立的资源池,分别承载输入处理(P)、内部推理思考(T)和最终输出呈现(A)。三个资源池通过网络传输 KV Cache,彼此拥有完全独立的显钟控制域($f_{\mathrm{P}}, f_{\mathrm{T}}, f_{\mathrm{A}}$)以及显存 Chunk Size 配置。这样做的工程收益十分直接:Thinking 阶段的长序列被锁在独立的 T 节点池中,不再与 A 节点争抢宝贵的显存块,使 T 实例的批处理容量直接提升了 44%;更关键的是,它向外部调度器显式暴露了三个阶段各自独立的 DVFS 调节旋钮。
为了让底层有合法的空间去利用这种阶段不对称性,PowerSlider 在上层重构了服务等级协议,提出了 Flex SLO 契约 $(\alpha_c, \rho_c)$。现实业务中,并非所有请求都要求毫秒不差的严苛响应。Flex 契约允许集群在电网发生需求响应事件时,将特定柔性请求的基准延迟 $L_c$ 适度放宽至 $\alpha_c L_c$,但在整个事件期间,这种降级发生的概率不得超过 $\rho_c$:
\[\Pr[\,L_c(t) > \alpha_c L_c\,] \leq \rho_c\]这种设计极其巧妙地将用户端可容忍的弹性,转化为了可供底层优化算法自由调度的数学资源。系统推导出了平滑的性能影响边界,使得请求降级不再是系统过载后的不可控溃散,而是变成了系统在功率受限时主动借用的“缓冲垫”。
在决策核心层,PSOpt 引擎负责实时接管整个集群的算力分配。每当电网下发新的功率上限 $p_{\max}(t)$ 时,PSOpt 都会建立一个以最小化整体服务违约影响为目标的约束优化问题,并利用 Karush-Kuhn-Tucker(KKT)条件进行在线求解。推导表明,各阶段降频的最优降序具有严格的数学单调性:限电发生时,系统首先压低 Answer 阶段的频率,将其推入带宽瓶颈下的平坦吞吐区;若功率依然不足,再适度降低 Thinking 阶段的频率;只有在极端深度限电下,才会动用 Latency-Critical(LC)等级的 Prefill 频率。KKT 求解器在松弛空间中解出连续解后,在不到 7.7 毫秒内即可将其投影至离散的 GPU 节点数、硬件 DVFS 挡位与显存分块等级上,确保控制平面响应速度远远快于电网波动的周期。
降幅 30% 仍稳如磐石:性能评测解析
为了验证系统在真实高负荷场景下的表现,研究团队在 DGX-A100 和 GH200 硬件集群以及大规模离散事件仿真器中,重放了工业级生产流量轨迹,并横向对比了 Uniform(均匀降频)、POLCA(优先级感知 DVFS)、SplitWise(阶段感知 DVFS)、DynamoLLM+ 以及 SLOs-Serve+ 等五种主流基线。
最核心的端到端评测结果表明,在面对 5% 到 20% 这一电网需求响应最常见的标准削减区间时,PowerSlider 几乎将性能损失降到了“免费”的程度——对于非长推理模型负载,即便遭遇 60% 的断崖式功率削减,PowerSlider 依然保持了 100% 的有效在线吞吐量。而在高负载、大并发的长链推理负载下,当集群面临 30% 的功率硬削减时,最强基线系统的在线有效吞吐量已经跌落至 47.6%,而 PowerSlider 依然能够维持 78.3% 的高位吞吐,实现了 1.64 倍 的性能优势。
不仅是吞吐总量,长尾延迟指标的对比更为惊人。在 60% 深度限电的极端测试下,传统均匀降频系统的 Prefill 吞吐直接腰斩,由于新请求的涌入速度远大于计算处理速度,请求队列发生无限堆积,尾部延迟(P90 TTLT)迅速攀升到 750 秒以上,延迟恶化幅度高达 12 到 18 倍。而 PowerSlider 凭借严谨的准入控制与精细化的能耗转移,在 60% 限电下将关键请求的端到端耗时牢牢锁定在额定水平的 1.1 到 1.3 倍以内,将原本致命的功率挤压平滑消化为柔性请求内部受控的细微波动。
在对加州真实电网紧急事故日(CAISO Grid-Emergency Day)的 24 小时全景回放测试中,外部可用功率在负荷低谷期被硬性压缩至额定值的 0.41 倍。在这一波巨大的电网冲击波下,由于无法自适应解耦与动态迁移,所有基线系统在低谷期的有效吞吐全线击穿,纷纷崩溃至 0% 到 6.6% 之间,并在事故过后数小时内深陷长队列泥潭无法恢复。相反,PowerSlider 不仅全程严格贴合电网功率约束红线,更在功率最低谷时奇迹般保住了 54% 的有效吞吐,全天平均有效吞吐率高达 98% 以上。
消融实验揭示的系统启示
为什么单一技术无法应对电网限电?论文的消融实验(Ablation Study)给出了清晰的机制解释。当研究团队在 PowerSlider 中分别剔除 KKT 求解器(-KKT)、PTA 解耦(-PTA)或柔性契约(-Flex)时,系统在 30% 限电下的 P90 时延分别剧烈反弹了 59% 到 101% 不等。实验揭示了一个清晰的分水岭:
-
在 0% 到 20% 的轻中度限电区间,性能主要取决于功率分配算法的精准度,KKT 求解器依靠精细的边际收益微调即可主导大局;
-
当限电深度超过 30%,进入深水区时,系统的瓶颈立刻由“功率分配”演变为“显存隔离与容量利用”,此时 PTA 对长长思考链的物理隔离以及 Flex 契约释放的业务裕度,成为了阻止系统排队崩塌的决定性支柱。
这项研究为蓬勃发展的 AI 算力基建提供了极具实操价值的方向。它证明了现代大模型系统并不一定是被动的电力吞噬者,其天然复杂的计算-访存双重特性中蕴含着巨大的弹性空间。只要通过合理的阶段解耦、协议重构与微秒级数学求解,完全可以将曾经僵化脆断的 AI 推理集群,改造为能够从容配合电网潮汐呼吸的高弹性可控负荷。在电力短缺日益制约大模型规模化落地的当下,这种深入硬件微架构与软件运行时底层的阶段不对称挖掘,无疑具有深远的工程借鉴意义。