SimpleOPD:跨分词器在线蒸馏,数学证明提升21.2分超Gemini
SimpleOPD: Simple Tokenizer-Agnostic On-Policy Distillation for Long-Context Reasoning
在当前大语言模型的后训练进程中,提升复杂长链推理(Long Chain-of-Thought)能力几乎成为了各大实验室竞相攻坚的核心战场。无论是 OpenAI 的 o1 系列还是各类在国际数学奥赛(IMO)中斩获金牌水平的顶级系统,往往依赖数万甚至十万 Token 级别的严密推导演绎。然而,将这类长上下文推理专家的深厚能力迁移到更轻量、计算资源更友好的短上下文模型上,一直是一道充满工程陷阱的技术难题。
ArXiv URL:https://arxiv.org/abs/2608.14277v1
常规的有监督微调(SFT)极易造成学生模型死记硬背长轨迹,不仅泛化表现堪忧,还会遭遇严重的能力遗忘。在线策略蒸馏(On-Policy Distillation,简称 OPD)原本提供了一种极具潜力的替代路径:由学生模型自主生成解答轨迹,再由教师模型在学生自己的策略分布上提供密集的 Token 级别打分与监督。但当工业界尝试用长上下文专家(如支持 100K 级自然语言证明的 SU-01)去蒸馏通用短上下文小模型时,OPD 框架却频频遭遇严重崩溃:不同模型家族之间存在天然的分词器(Tokenizer)不兼容;长上下文教师倾向于无节制地展开思考,导致学生模型推理长度急剧爆炸、终止符被压制、频繁出现上下文截断,最终训练彻底失稳。
来自上海人工智能实验室(Shanghai Artificial Intelligence Laboratory)等机构的研究团队提出了全新的蒸馏框架 SimpleOPD。该方法抛弃了过去强行对齐异构词表的繁复手段,直接在原始文本空间中对齐完全一致的字符跨度,同时通过“特殊终止符优势遮蔽”与“学生参考 KL 正则化”两大机制,彻底锁死了推理长度爆炸的风险。实验显示,经由 SimpleOPD 蒸馏后,Intern-S2-Preview 在权威自然语言数学证明评测 ProofBench 上的得分实现了从 34.0 到 55.2 的跨越,大幅提升 21.2 分,不仅超越了 Gemini-2.5-Pro,更逼近了 DeepSeek-V3.2-Speciale 的水平;同时,这种证明能力的迁移甚至外溢到了未参与训练的高难度前沿物理与通用科学评测中。
长推理蒸馏为何在传统路径上频频翻车?
在线策略蒸馏的核心逻辑在于最小化学生模型与教师模型在学生生成样本上的反向 KL 散度(Reverse KL Divergence)。这要求对学生输出的每一个 Token,都能从教师模型获取其对应的条件对数概率。在同构模型之间(例如同一架构、同一分词器的模型间蒸馏),这套机制运行得相当顺畅。但一旦跨越模型家族,或者直面长短上下文的鸿沟,问题就会迅速暴露。
首要障碍在于分词器的异构性。现代大模型所采用的分词方案千差万别:Qwen 家族主要采用特定的 Byte-level BPE 分词器,Gemma 系列基于 SentencePiece,GLM 则拥有另一套独立的词表与切词逻辑。对于同一句包含大量数学符号的推导文本,不同分词器切分出来的 Token 数量、边界截断甚至字符包含关系大相径庭。过去一些跨词表研究试图训练词表映射矩阵,或者强行将一个模型的 Token 概率重新投影到另一个模型的词表空间上,这些方案不仅计算开销高昂,更会在严谨的数学推导语境中引入严重的语义扭曲和概率失真。
更为隐蔽且致命的问题,是长上下文教师带来的策略分布错配与长度失控。长上下文推理模型(如本研究所采用的教师模型 SU-01)拥有在极长窗口内展开数十万 Token 思考的能力,其输出策略往往表现出对深层展开、反复推演的偏好。当学生模型尝试生成一个解答,并用教师模型来指导时,教师给出的概率反馈往往会严重惩罚早早收尾的行为。
实验监控清楚地揭示了这一退化过程:在直接采用原生 OPD 蒸馏时,学生模型的平均响应长度几乎呈直线飙升,短短几个训练步后,输出窗口便被迅速耗尽,截断率(Truncation Rate)和无意义重复率(Repetition Rate)同步激增。更关键的是,诸如 </think>(结束思考)和 <|im_end|>(结束整个生成)等结构性终止符的出现概率被教师的对数概率强行打压。学生模型逐渐“丧失了完结一句话的能力”,最终生成的全是被截断的半成品,致使在线策略探索彻底崩溃。
共享文本空间对齐:抛弃复杂投影的极简解法
面对异构分词器的鸿沟,SimpleOPD 并没有试图去建立复杂的词表概率映射网络,而是回归到了自然语言最底层的物理载体——原始文本字符串。
当学生模型基于自身分词器生成一个由 Token 序列构成的解答文本时,这段解答可以通过确定性的解码映射为唯一的字符跨度序列。教师模型并不直接读取学生的分词序列,而是直接接收这段由学生生成的原始文本,并使用教师自身的原生分词器对其重新切词。
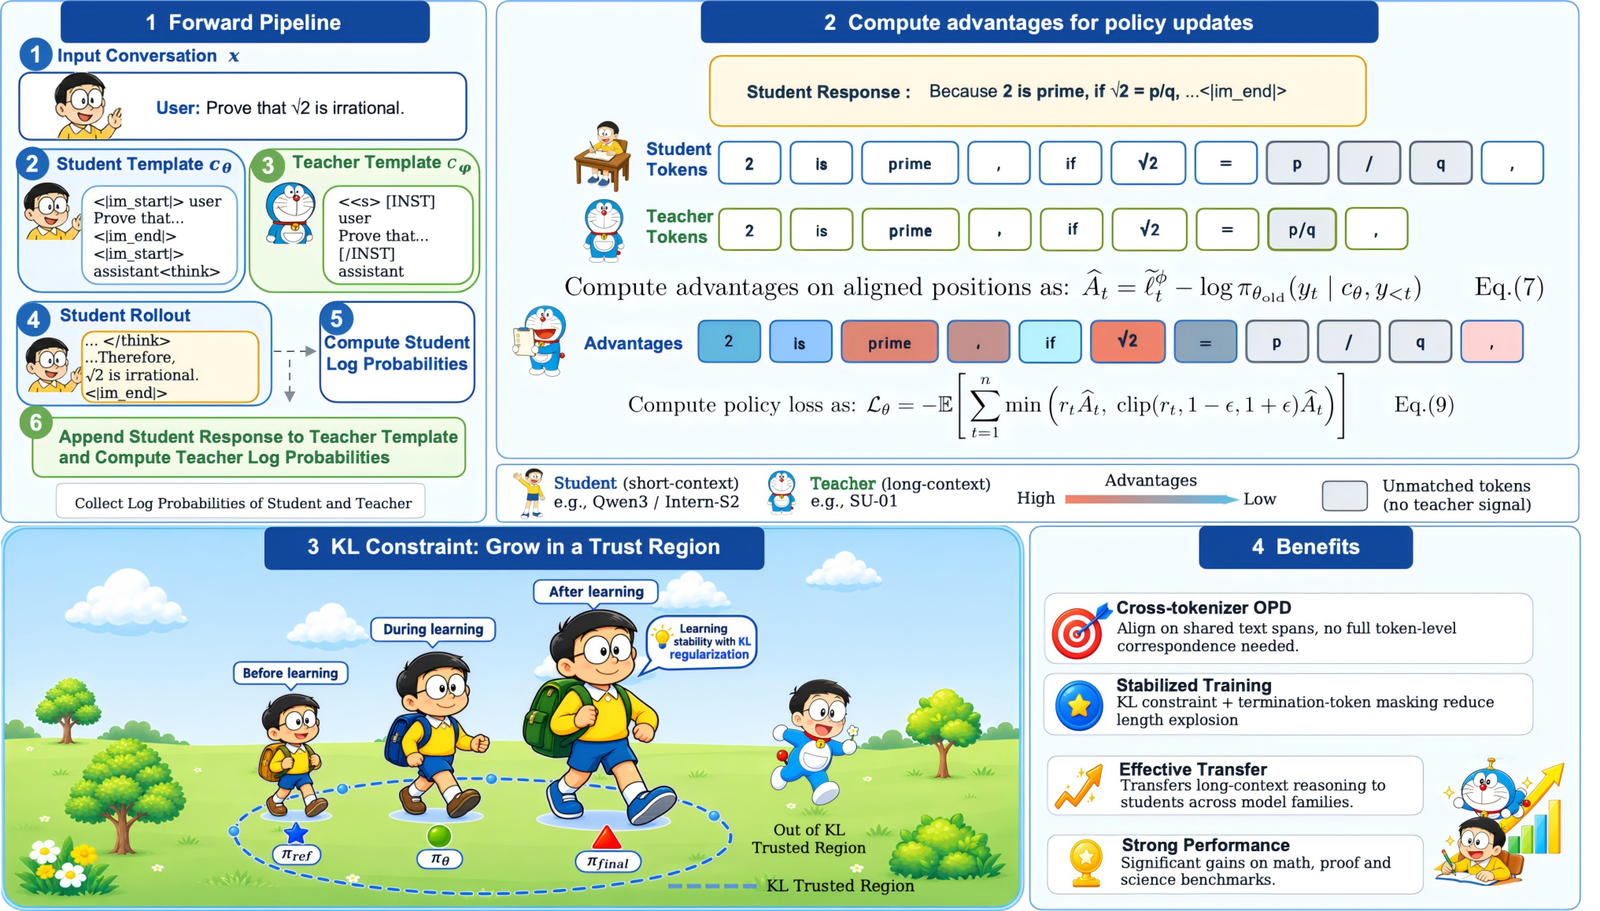
在此基础上,研究团队定义了一种基于累积文本前缀的“字符跨度精准匹配”机制。具体而言,设学生第 $t$ 个 Token 所代表的文本切片为 $\tau_\theta(y_t)$,其在整段文本中前面的累积字符前缀为 $P_\theta(t)$;教师第 $i$ 个 Token 对应的切片为 $\tau_\phi(z_i)$,前缀为 $P_\phi(i)$。只有当:
\[P_\phi(i) = P_\theta(t) \quad \text{且} \quad \tau_\phi(z_i) = \tau_\theta(y_t)\]两者同时成立时,该位置才被视为完全对齐。此时,学生位置 $t$ 将直接继承教师在对应前缀条件下的对数概率 $\log \pi_\phi(z_i \mid c_\phi, z_{<i})$ 作为监督信号。
而对于那些由于切词边界交错导致无法完全重合的位置,SimpleOPD 采取了极为保守却鲁棒的策略:不强行脑补,直接回退。未对齐位置的伪目标概率直接回退为学生模型自身的对数概率。这意味着未对齐 Token 处的优势函数直接归零,不产生有害的虚假梯度更新。
研究团队在训练过程中监控了词元重叠度(Lexical Overlap Ratio $\rho$),结果表明,即便在切词风格迥异的不同分词器之间,由于数学推理本身高度依赖规范的公式与词汇,能够实现完全重合的 Token 比例自初始阶段就相当可观,并在训练中稳步提升至较高水平。这从工程上证实,根本无需进行代价巨大的全局概率对齐,仅靠共享文本空间中的精准局部切片,就足以传递绝大多数高质量的逻辑监督信号。
遏制长度爆炸的双保险:终止符遮蔽与参考 KL
解决了词表通信的问题之后,SimpleOPD 将矛头对准了长推理向短推理蒸馏时的训练失稳现象,通过两道互补的机制构建起防御纵深。
第一项改进是特殊终止符优势遮蔽(Termination-Token Advantage Masking)。研究团队洞察到,决定输出格式和流程终结的特殊标记(例如思考链完结符号 </think> 和对话终结标记 <|im_end|>),其本质上是控制模型系统行为的结构性开关,并不承载具体的数学推导逻辑。在自然推导场景下,教师模型动辄几十万步的长思维链使其根本不急于输出结束符;如果将教师对结束符极低的对数概率强加给学生,无异于剥夺了学生自发收尾的权利。因此,SimpleOPD 将所有结构性终止 Token 处的 OPD 损失直接遮蔽,不计算优势函数。这保留了学生模型根据自身窗口预算和内在节奏自主选择“何时画上句号”的能力。
第二项改进是引入学生参考策略的 KL 散度约束(Student Reference KL Loss)。单纯遮蔽终止符虽然缓解了部分极端情况,但只要学生的生成策略受到强势教师的持续推挤,其整体分布依然会不可逆地偏离初始状态,导致生成过长与能力灾难性遗忘。研究团队在优化目标中引入了学生当前策略 $\pi_\theta$ 与学生初始参考策略 $\pi_{\text{ref}}$ 之间的 KL 散度惩罚。
这个设计巧妙地平衡了两股力量:教师模型提供指向极致奥赛推理的密集引导向量,而参考 KL 则像一根柔韧的弹簧,确保模型始终在可控的动作空间内渐进探索,遏制了无效的长篇大论与自我重复。监控数据显示,在引入参考 KL 之后,截断率迅速被压制到接近于零,平均响应长度平稳过渡,训练曲线表现出优异的收敛稳定性。
实验评测:数学自然语言证明的爆发式跃升
为了验证 SimpleOPD 的普适迁移效力,研究团队选择了在国际数学奥赛级别具备极强实力的长上下文推理模型 SU-01(30B 级别,支持 100K 级超长推演)作为教师基座,蒸馏范围涵盖了同架构与跨架构的多款开源主力模型。
整个评测中最亮眼的突破出现在自然语言数学证明基准 ProofBench 上。在以强模型 Gemini-2.5-Pro 作为独立裁判的严格设定下,学生模型 Intern-S2-Preview 原本的基线得分仅为 34.0。经过 SimpleOPD 蒸馏后的 Intern-S2-OPD,其 ProofBench 得分直接跃升到了 55.2,净增幅高达 21.2 分。这一成绩不仅大幅拉开了与 GPT-5 和 Gemini-2.5-Pro 等通用前沿大模型的差距,甚至已经无限逼近顶尖数学推理模型 DeepSeek-V3.2-Speciale 的水准。
在其他标准化数学基准中,SimpleOPD 同样表现强劲。在包含高难度竞赛题的 AIME25 上,Intern-S2 蒸馏后得分从 88.33 提升至 95.00,AnswerBench 从 76.03 升至 80.10。为了评估方法在算法层面的领先性,研究团队进一步将 SimpleOPD 与当前主流的在线蒸馏变体——引入正向熵权重的 EOPD 以及广义在线蒸馏框架 G-OPD 进行了全面横向对比:
| 模型配置 / 蒸馏方案 | ProofBench@4 | AnswerBench@8 | AIME25@8 | AMOBench |
|---|---|---|---|---|
| Intern-S2-Preview (Base) | 21.70 | 76.03 | 88.33 | 58.00 |
| + EOPD | 34.50 | 79.52 | 95.33 | 58.75 |
| + G-OPD | 34.70 | 78.43 | 94.66 | 58.25 |
| + SimpleOPD (Ours) | 44.50 | 80.10 | 95.00 | 59.50 |
在同等实验设置下,SimpleOPD 在最具挑战性的复杂证明任务 ProofBench 上将得分推升至 44.50,高出次优方案近 10 个百分点,同时在 AnswerBench 和 AMOBench 上全部取得最优成绩。这表明在长链路推导演绎场景中,精准的跨分词器局部锚定配合稳定的长度正则,比起在全词表上计算启发式加权更为扎实有效。
跨越模型家族:从 Qwen 到 GLM、Gemma 与 DeepSeek
除了在同源或近似架构的 Qwen 与 Intern 系列上大展身手,SimpleOPD 真正的试金石在于完全不同血缘、不同切词体系的异构模型家族迁移。
研究人员在 GLM-4.7-Flash 和 Gemma-4-26B-A4B 上进行了严格的跨家族实验。GLM 虽然同属 BPE 路线,但词表定义截然不同;而 Gemma 则直接基于 SentencePiece 构建,两者的分词边界差异更为悬殊。在跨家族蒸馏时,团队适当提高了参考 KL 惩罚系数(由 0.5 提升至 1.0),以应对更大的分布跳跃。
最终结果印证了跨分词器蒸馏的通用性:GLM-4.7-Flash 在蒸馏后,ProofBench 从 30.8 稳步攀升至 39.7,AnswerBench 同步由 69.6 提高至 72.0;分词差异极大的 Gemma-4 也取得了 ProofBench 上 25.5 到 34.2 的可观提升。这明确证明,即使底层分词器完全无关,数学推理的逻辑框架依然可以通过自然语言文本的对齐成功“注射”进异构模型体内。
更为重要的是,SimpleOPD 不仅适用于 SU-01 这一单一教师。实验进一步尝试使用参数量高达 158B 的顶级模型 DeepSeek-V4-Flash 作为教师,去蒸馏 30B 级别的 Intern-S2-Preview。在仅开放 6K 上下文蒸馏长度以节约算力的严苛条件下,经 DeepSeek 蒸馏的 Intern-S2-DS-OPD 在 ProofBench 上依然实现了 18.01 分的巨大飞跃,AIME25 得分更是一路攀升至 97.50。这一跨架构、跨量级(158B 到 30B)的成功迁移,展现了该机制在极具悬殊的师生模型间依然能够稳定运转。
核心机制消融:数据配比、上下文窗口与域外泛化
深入的消融实验揭示了 SimpleOPD 成功的若干关键内在机理:
其一,训练数据究竟是“越杂越好”还是“专注证明”? 研究人员对比了“纯自然语言证明数据”与“混合可验证数学答案数据(Verifiable Math Data)”的蒸馏效果。结果出人意料:混入可验证答案数据仅在纯数值填空类的 AnswerBench 上带来了极微弱的上升(80.10 到 81.10),但在 ProofBench@4 上的成绩却遭遇显著滑坡,从 44.50 跌落至 38.50。这表明对于高阶思维的在线蒸馏而言,证明任务所激发的长程语义演进机制具有排他性,掺杂大量短推导的弱语义答案数据反而会稀释严密推导行为的传承效率。
其二,蒸馏时的窗口长度直接决定了推理能力的上限。在 Intern-S2 与 Qwen3.5 上的长度消融表明,当允许的蒸馏上下文从 6k 逐步放开至 32k 时,各项推理指标呈现单调递增态势。在保持训练稳定的前提下,让学生模型在蒸馏过程中有余地展开并对齐教师的深层长线思维,是激活高级证明能力的关键保障。
其三,领域外能力的奇妙外溢(Out-of-Domain Generalization)。SimpleOPD 的整个训练集仅仅包含数学竞赛证明题目,未掺杂任何外部领域的物理或自然科学数据。然而,当把蒸馏后的模型放到高难度前沿物理基准 HiPhO 以及博士级通用科学测试 HLE 上时,模型同样表现出了显著的性能增长。
| 科学推理基准 | Intern-S2-Preview (Base) | SU-01 (Teacher) | Intern-S2-OPD (Student) | 相对增量 $\Delta$ |
|---|---|---|---|---|
| FrontierScience-Olympiad | 16.8 | 19.3 | 17.1 | +0.3 |
| FrontierScience-Research | 1.7 | 10.0 | 5.0 | +3.3 |
| HLE (Humanity’s Last Exam) | 3.3 | 4.4 | 4.2 | +0.9 |
| HiPhO (国际物理奥赛) | 38.6 | 39.8 | 41.1 | +2.5 |
尤为值得注意的是,在国际物理奥林匹克竞赛评测 HiPhO 上,Intern-S2-OPD 不仅相比自身基线提升了 2.5 分,甚至直接反超了教师模型 SU-01 本身的表现(41.1 vs 39.8)。这种“学生在物理学科超越数学老师”的现象生动地说明:SimpleOPD 所迁移的绝非具体的题目解答记忆,而是一种深层次的符号演绎、假设验证与因果步进元能力;当这种严密的推演逻辑与学生自身原有的物理知识结构结合时,成功碰撞出了更强的科学推理火花。
总结与展望
SimpleOPD 用非常简洁的工程构思切中了当前大模型技术栈中的关键痛点。它向业界表明,在不同分词体系、不同上下文体量的模型之间进行高阶认知能力的迁移,并不需要依赖极其繁复的词表概率矩阵变换。
通过在共享文本空间中只对准那些无歧义的字符跨度,结合结构性终止符的优势遮蔽和参考策略的锚定,SimpleOPD 成功驯服了长上下文教师向短上下文小模型蒸馏时的长度失控与训练崩溃。它不仅让一个 30B 级别的轻量模型在国际奥赛级证明任务中实现了跨越式成长,超越一众体量庞大的前沿商业模型,更为未来跨模型家族、跨异构硬件体系下的高效知识流转,开辟了一条清晰且兼具稳定性的可行通路。