EgoCITE:解耦上下文与时序意图,长时第一视角记忆准确率提升14.2%且成本降低36倍
EgoCITE: Context-Augmented Indexing and Time-Aware Retrieval for Long-Horizon Egocentric Memory
在穿戴式设备、AI 眼镜和多模态生活记录(Lifelogging)的浪潮下,让大模型充当人类的“第二大脑”,随时回答“我把钥匙丢在哪了”、“上次见李医生是什么时候”、“我平时几点喝咖啡”等问题,正成为极具吸引力的应用方向。然而,这一愿景在工程与算法层面正面临严峻挑战。当面对跨越数天、数十小时的连续第一人称音视频流时,现有的长时程记忆(Long-Horizon Egocentric Memory)系统往往频频失效。
ArXiv URL:https://arxiv.org/abs/2608.12627v1
密歇根大学的研究团队指出,当前多模态长时记忆系统的崩溃并非源于推理模型能力不足,而是根植于两个长期被忽视的设计缺陷:一是索引构建阶段的上下文缺失,割裂的视频片段切片和简短文字描述导致生成的记忆索引缺乏自洽性;二是检索阶段忽视了用户提问中的“时间意图”,单纯依赖语义向量匹配根本无法区分“最后一次发生”、“第一次发生”或是“周期性习惯”。为此,研究团队提出了 EgoCITE 框架,通过上下文增强索引与时间感知检索机制,在 EgoLifeQA、EgoMem 和 EgoR1-Bench 三大基准上取得了 4.4% 至 14.2% 的显著准确率提升,同时相比直接堆砌超长上下文的 LLM Agent 方案,将推理成本降低了整整 36 倍。
现有记忆系统的两次“脱轨”
现有的多模态长记忆系统通常遵循一套标准范式:先将连续音视频切块,调用视觉语言模型生成密集的视觉片段描述和语音转录,存入向量数据库或知识图谱;当用户提问时,再将问题转化为检索向量,匹配最相关的片段送入大模型生成答案。
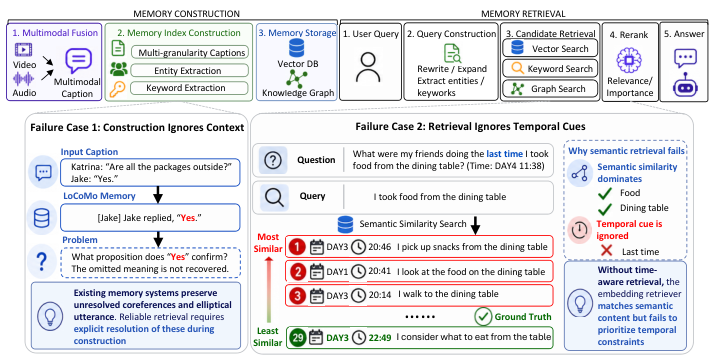
然而这一看似严密的闭环在长时程第一视角数据面前却极易脱轨。首先是指代与省略引发的“语义悬空”。日常佩戴设备记录的画面和声音往往充斥着短暂停顿、省略句以及模糊的人称代词。如果仅对孤立的数秒视频做切片描述,模型记录的往往是“一个男人走开了”或“放下了那个东西”。一旦这种缺乏主语、缺乏空间连续性、缺乏事件因果的描述被固化进向量数据库,后端的图谱推理或检索 Agent 无论算力多么充沛,都绝不可能从“无信息”中推断出“有意义”的事实。
其次是向量相似度与时间意图的逻辑冲突。在第一视角问答中,提问往往天然带有时间副词修饰,比如“我今天早上拿了药没有”、“我最后一次见到张三说了什么”或者“我平时通常在哪个房间看书”。现有的检索系统通常直接把整句话做稠密向量检索,但这会导致两类典型的失败:
-
句子嵌入模型对语义内容极其敏感,却对时间序列钝化,无法感知时间绝对跨度与先后逻辑;
-
如果采用机械的硬时间戳过滤(Hard Temporal Filtering),诸如“中午”、“吃早饭时”这类模糊时间段往往没有固定的起始秒数,极其容易导致关键证据被一刀切地剔除。
EgoCITE 的四阶段协同流水线
针对上述症结,EgoCITE 明确解除了以往系统将上下文补充与时序推理混杂在单点环节的耦合做法,确立了清晰的四阶段流水线:多模态感知生成、上下文增强索引(EgoScheme 与 EgoIndex)、时间感知检索(EgoRetrv)以及跨证据推理生成。
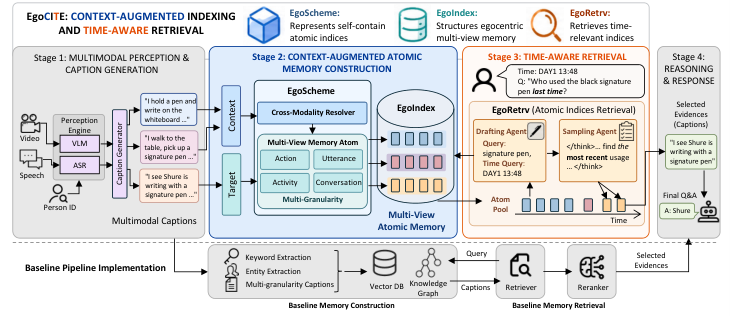
系统的核心突破集中在第二阶段的索引构建和第三阶段的证据召回中。在构建端,系统不再把每一条独立描述直接当作索引,而是借助滑动上下文窗口让记忆单元恢复自洽;在检索端,系统引入软性时间距离衰减函数与双智能体架构,将“寻找候选”与“时间维度全局筛选”彻底拆分为两个阶段。
上下文增强:打造自给自足的多视图原子记忆
为了解决局部片段信息匮乏的问题,EgoCITE 设计了 EgoScheme 机制。它为每一个原始多模态描述引入前后邻近上下文窗口,在大模型的协助下完成跨切片的代词指代消解、语境补全和省略还原。经过 EgoScheme 处理后的每一个条目,都变成了脱离原始上下文依然能被准确理解的“自包含原子记忆索引”(Self-Contained Atomic Memory Index)。
单有完整的文字表达还不够,日常生活的信息粒度极为异构。用户可能询问极其具体的动作细节(如“钥匙塞在哪个口袋”),也可能询问跨度很长的宏观行为(如“周二下午去超市采购”),或者社交对话的主题。为了兼顾不同的查询需求,EgoIndex 构建了包含四个互补视图的层次化索引结构 $\mathcal{M}=\bigcup_{v\in\mathcal{V}}\mathcal{M}{v}={(\tau{i},m_{i})}_{i=1}^{\lvert \mathcal{M} \rvert}$:
-
动作视图(Action):聚焦细粒度的人体与物体交互,记录瞬间发生的高频实体操作;
-
活动视图(Activity):以 30 分钟为基础窗口,将一系列动作解构并聚拢为一个具备明确意图的整体行为,标明参与者、使用工具与所在场所;
-
单句陈述视图(Utterance):保留转录中每一个说话人清晰指代下的具体单句意图;
-
长对话视图(Conversation):跨越多个局部语段,追踪完整对话的主题演进并明确列出所有谈话对象。
为了防止多事件杂糅,系统还引入了解耦流程,把那些通过“and”或“while”连缀的复合事件强行拆分成独立的单事件,并在滑动窗口边界处利用向量相似度和模型合并机制,消除跨窗口造成的记忆割裂。这种多视图拆解让后续检索代理能够按图索骥,大幅缩小了搜索空间。
EgoRetrv:软性衰减打分与双智能体协同检索
在证据检索环节,EgoRetrv 的设计兼顾了召回率与时序精确度。面对自然语言问题中的时间范围,模型并不使用硬性时间截断,而是使用带指数衰减因子的软性时序相关性评分:
\[R_{i}=\begin{cases}1,&t_{\mathrm{start}}\leq\tau_{i}\leq t_{\mathrm{end}},\\[1.0pt] \lambda^{t_{\mathrm{start}}-\tau_{i}},&\tau_{i}<t_{\mathrm{start}},\\[1.0pt] \lambda^{\tau_{i}-t_{\mathrm{end}}},&\tau_{i}>t_{\mathrm{end}}.\end{cases}\]其中 $\tau_i$ 为候选记忆索引的时间戳,$[t_{\mathrm{start}}, t_{\mathrm{end}}]$ 为根据问题意图预测出的时间窗口,$\lambda \in (0, 1)$ 为衰减系数。综合检索得分由语义相似度得分 $S_i$ 与时间得分 $R_i$ 相乘得到:
\[\operatorname{score}(m_{i}\mid Q_{s},Q_{v},Q_{t})=S_{i}R_{i}\]这一设计极其优雅地平衡了时间先验与语义匹配:哪怕某个关键动作发生的真实时间比模型预估的时间窗口稍早或稍晚了几分钟,由于衰减平滑,只要语义强相关,它依然能进入候选池 $\mathcal{K}$,避免了硬切分带来的漏检风险。
更具实用价值的是 EgoRetrv 的双智能体协同运作机制:
-
草稿智能体(Drafting Agent):专注于“广度召回”。它在多轮交互中不断分发语义、视图类型和时间查询,从 EgoIndex 的各个维度将潜在相关的原子记忆候选源源不断地汇聚到持久化的工作内存池(Index Pool)中,确保不发生遗漏;
-
抽样智能体(Sampling Agent):专注于“全局时序过滤与精选”。草稿智能体虽然拿到了高召回候选,但往往缺乏时间轴上的宏观视野。抽样智能体将内存池中带时间戳的记忆按时间升序排列,并结合问题中的限定词执行全局审查。
面对带有“最后一次(Last/Most recent)”倾向的问题,抽样智能体会在满足语义的候选集中优先挑取时间戳最新的条目,同时保留用于选项区分的关联上下文;而面对“平时通常(Usually/Habit)”这类习惯性问题,它会刻意跨越多天采样具备时间多样性的记忆序列,向推理层证明该行为是否构成稳定规律。这种“一人专职收集、一人专职质检裁决”的架构,完美解决了语义搜索与复杂时序推理的内在冲突。
实验结果与性能全景
研究人员在长时第一人称领域的三个主流权威评测集上进行了全面验证,包括 EgoLifeQA、EgoMem 以及专注于复杂推理的 EgoR1-Bench。输入信息包含问题文本、备选项及提问时间戳,评估核心围绕最终回答准确率以及检索命中目标事件的时钟对齐度。
实验数据表明,EgoCITE 显著超越了包括现有多模态图谱检索系统(如 WorldMM、EgoGraph)和基线检索增强系统在内的所有主流方案。在各大核心指标上,系统准确率相比此前最优的 Agent 记忆基线取得了 4.4% 至 14.2% 的稳固增益。尤其在涉及多天跨度习惯归纳和近期特定动作定位等需要精细时序感知的题目上,提升尤为明显。
除了准确率,方案的落地可行性与鲁棒性也是论文的核心亮点。在工业实际落地中,人工标注的高质量稠密文本描述往往不可得,系统必须依赖端到端模型感知。作者进一步验证了采用通用视觉语言模型直接生成视音频转录的现实可行性:在仅依靠 Gemini-3-Flash 或 Gemma-4-31B 自动生成视频叙述(Narration)的非理想条件下,EgoLifeQA 上的准确率仍分别达到了 60.3% 和 57.1%,仅比使用昂贵人工精细标注数据低了 1.2% 和 4.4%。这充分证明上下文增强机制对前端感知引入的噪声和缺陷具备强健的纠错包容能力。
更为关键的是推理开销的断崖式下降。以往应对数小时第一人称视频的粗暴方案是将所有转录完整喂给具有百万 Token 上下文能力的超长文本 LLM,但这会带来极高的计算时延与高昂的 API 调用费用。EgoCITE 凭借精准的多视图分级定位和抽样智能体的精细化裁减,送入最终推理模型的上下文规模大幅浓缩,在保持更高回答准确度的同时,将实际推理花销压低到了长上下文 Agent 方案的 36 分之一($36\times\text{ lower cost}$)。
认知与架构的解耦价值
从技术路径来看,EgoCITE 带来的核心启示在于:长时记忆的核心不在于存储形态有多复杂,而在于信息入库时的自洽度与提取时的意图对齐。以往学术界热衷于在记忆存储上堆叠繁杂的全局知识图谱,但这类图谱不仅在实时流式更新时计算沉重,且极度依赖脆弱的实体对齐逻辑。
EgoCITE 证明,通过局部上下文重写来建立具备自包含特性的“原子索引”,辅以按行为尺度自然拆解的多视图结构,不仅实现更加轻量,对现实感知的容错空间也更大。配合时间衰减打分与双智能体分工,模型能够从被动的语义匹配进化为理解时间动态的经验回溯者。随着智能眼镜等穿戴式端侧设备加速迈向实用,这种低计算成本、支持长时跨度并原生理解时序规律的记忆架构,无疑为下一代个人具身助理提供了极具工程实践价值的范本。