EvoGUI:从轨迹挖掘状态转移探针,28个主流VLM最高得分仅60.4
EvoGUI: An Evolution-Aware Benchmark for GUI State-Transition Understanding
在图形用户界面(GUI)智能体领域,主流评估方式长期被端到端任务成功率主导:给 Agent 一个网页或桌面环境以及一条用户指令,看它最终能否下单成功或填完表单。这种端到端成功率固然贴近落地场景,却将感知、OCR、元素定位(Grounding)、长程规划、动作执行与错误恢复等诸多维度紧密纠缠在一起。当一个 Agent 执行失败时,开发者很难判断它究竟是找不到按钮、没看懂文本框,还是根本不理解自己的点击操作究竟让页面发生了什么变化。
ArXiv URL:https://arxiv.org/abs/2607.17050v1
来自清华大学等机构的研究团队提出了名为 EvoGUI 的诊断型评测框架及其评测集 EvoGUI-Bench。该研究的核心切入点是:GUI 交互本质上是状态演进敏感(Evolution-Aware)的,Agent 必须理解界面状态随动作发生转移的动力学机制。研究人员绕开了端到端黑盒指标,直接从现有的交互轨迹中自动挖掘无需额外人工标注的状态转移探针,并对包含开源与闭源的 28 款主流视觉语言模型(VLM)进行了 Zero-shot 评测。
实验得出了一个值得警惕的结论:即使是当前综合能力最顶尖的视觉语言模型,在经过机率归一化处理后的状态转移综合得分(EvoGain)也仅达到 60.4;更关键的是,模型参数规模的扩大以及针对 GUI 领域的专门微调,并不能可靠地带来状态转移理解能力的提升。
将交互轨迹解构为三类诊断探针
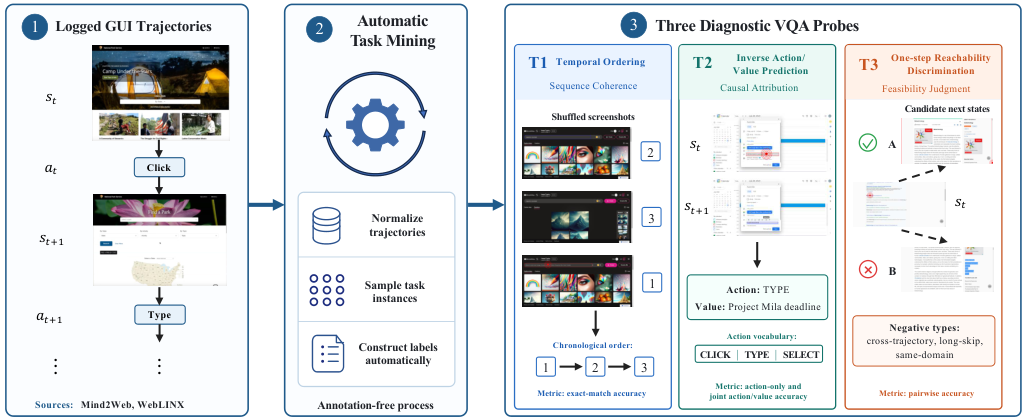
为了在不引入昂贵人工标注的前提下解开端到端能力的纠缠,EvoGUI 提出了一套轻量、通用的转换逻辑。任何 GUI 操作日志都可以被形式化表示为转移序列:
\[\tau=[(s_{t},a_{t},v_{t},s_{t+1},m_{t})]_{t=1}^{T}\]其中 $s_t$ 与 $s_{t+1}$ 代表相邻的前后截图,$a_t$ 为记录的操作行为,$v_t$ 是可选的操作赋值(例如输入的文本、选中的下拉项),$m_t$ 则保存元数据信息。基于这种标准格式,框架将其自动化重构成三种互补的视觉问答(VQA)诊断探针:
-
时序排序(T1: Temporal Ordering):打乱多张状态截图的时间顺序(长度 $K \in {3, 4, 5}$),要求模型还原出正确的交互先后次序,考察全局状态演进的宏观时序感知。
-
逆向动作与数值预测(T2: Inverse Action/Value Prediction):给出相邻的两帧截图 $(s_t, s_{t+1})$,要求模型推断出究竟是哪种用户操作(如点击、输入、选择)导致了界面的改变,并提取出对应的动作值。
-
单步可达性判别(T3: Contrastive One-Step Successor Discrimination):给定当前截图 $s_t$ 与真实后继状态 $s_{t+1}$,混入一张精心挑选的干扰截图,要求模型二选一辨别出哪个才是记录中的即时后继状态。
值得注意的是,该框架在 T3 的负样本设计上避免了泛泛随机采样,而是设置了由易到难的三级干扰项:跨轨迹截图(Cross-trajectory)、同域名其他轨迹截图(Same-domain),以及长跳跃截图(Long-skip)。所谓长跳跃截图,是指从同一条操作轨迹的未来步骤($s_{t+n}, n \geq 3$)中抽取的真实后续页面。模型面对长跳跃干扰项时,必须精准区分“未来可能会出现的合法页面”与“当前动作立刻导致的结果”,这对消除工作流层面的粗粒度合理性混淆具有极高的诊断价值。
为防止页面加载抖动、广告弹窗或异步刷新带来不可归因的视觉噪声,研究人员仅在最后加入了一道人工审核工序,用于剔除存在明显视觉歧义的样本,但这一步骤并不赋予新的标签,基准数据标签完全机械衍生自日志本身。由此构建出的 EvoGUI-Bench 覆盖了来自 Mind2Web 与 WebLINX 的 120 个真实 Web 领域,由 T1、T2、T3 各 1,000 个实例组成,共计 3,000 个平衡实例。
28款模型同台竞技:最高分仅60.4
在评测协议上,为了消除不同任务选项随机基准差异的掩盖效应,作者定义了基于归一化提升幅度的综合指标 EvoGain:
\[\mathrm{NormScore}_{i}=\frac{\mathrm{ModelScore}_{i}-\mathrm{Baseline}_{i}}{100-\mathrm{Baseline}_{i}}\times 100\]EvoGain 即为 T1 绝对正确率、T2 动作数值联合精确率与 T3 判别正确率三项归一化得分的宏观平均值。通过 1,000 次 Bootstrap 重采样计算置信区间,团队评测了包括 GPT-5/5.4 变体、Gemini-3-Flash-Preview、Seed-2.0 系列、Qwen 系列、UI-TARS 以及 GLM 系列等在内的 28 种模型配置。
评测结果展现出显著的分层与巨大的未饱和空间:
-
天花板远未达到:排名首位的 Gemini-3-Flash-Preview 取得了 60.4% 的 EvoGain,第二名 Seed-2.0-lite-260428 为 50.7%,两者的 95% 置信区间完全分离。其余 26 款模型的分数则更低,甚至大量模型在此基准上无法与中间梯队拉开差距。
-
参数规模并不保证状态转移推理:模型参数规模的简单膨胀并没有单调转化为状态转移理解能力的提升。在很多模型族谱中,中等尺寸模型甚至跑赢了超大尺寸模型。
-
领域微调的局限性:以 GUI 专有任务为导向进行微调的模型(如 UI-TARS-1.5-7B)虽然在传统定位与点击任务上表现优异,但在 EvoGain 综合评估中并未展现出对基础底座通用 VLM 的绝对代差优势。这证明当前主流针对屏幕界面的微调,更多是在强化“看到元素-输出坐标”的静态映射,而非建立真正的界面转移心智模型。
细节剖析:模型究竟卡在什么环节?
深入到三个子任务的细分指标,可以更清楚地看到大模型在 GUI 场景下的认知缺陷:
在 T1 时序排序 中,即使是综合得分最高的模型,在多帧绝对排序上的错误率依然超过 40%。这表明从静态图像跨越到时空演变时,多图之间的逻辑演进链条识别依然是视觉语言模型的普遍薄弱项。
在 T2 逆向推断 中,评测拆分了“纯动作类型预测(Action-only)”与“动作+数值联合预测(Joint)”。所有模型均表现出显著的一致性趋势:模型判断发生了“点击”或“输入”相对容易,但要精确还原输入的具体字符串或选中的具体选项却极其困难。不过,消融分析表明,即使在 EvoGain 计算中剔除对 OCR 要求苛刻的具体数值要求,模型间的排位相关性(Pearson $r=0.991$)依然极高。这意味着模型之间的差距并非仅仅由 OCR 强弱决定,而是本质上缺乏对界面因果变化机制的深度解析。
在 T3 即时后继判别 中,粗粒度工作流常识与单步动力学的鸿沟被彻底暴露。大量模型在跨轨迹或同域名干扰项面前能够拿到体面的准确率,但一旦面对 长跳跃(Long-skip) 干扰项,表现就会剧烈下滑。换言之,模型知道这个界面“符合这个网站的操作逻辑”,却无法断定它“是不是这一步操作立刻会产生的画面”。此外,分辨率对比实验显示,盲目拉大输入截图的分辨率虽然有助于提升 T2 中的微小文字识别,却无法有效修复 T3 中的时序状态鉴别能力。
为了排除模型是在依靠纯文本语义或元数据走捷径,研究人员对 Qwen3.5-27B 进行了严格的视觉剥离对照实验:
当把输入图像全部替换为全黑图片或纯文本元数据时,T1 的绝对排序准确率直接从 28.1% 断崖式跌落至 7.4% 与 6.9%(Kendall $\tau$ 相关系数归零);T3 准确率从 70.8% 跌落至 49.1%,完全退化到 50% 的随机抛硬币水平。这一控制实验强有力地证明:EvoGUI-Bench 的测试结果高度依赖模型对视觉界面像素变化的直接观察与空间推理,无法通过纯文本先验实现投机作弊。
对未来智能体研究的启示
EvoGUI 的价值不仅在于给现有的 VLM 泼了一盆冷水,更在于指明了 GUI 智能体评估与训练范式所缺失的关键环节。
在初步的跨维度对比中,作者将 5 款具有公开 OSWorld 真实系统任务得分的模型与 EvoGain 进行了排序分析,发现两者存在明显的正相关性(Spearman $\rho=0.90$)。这为诊断指标的有效性提供了初步依据:那些在底层状态转移诊断中表现更好的模型,往往在真实的复杂桌面操作系统交互中也能走得更远。
长期以来,社区构建 GUI Agent 的主要精力集中于端到端的数据蒸馏或强化学习对齐,让模型在黑盒环境中试错。但 EvoGUI 表明,如果底座模型连单步动作对界面造成的微小确定性变化都缺乏准确预判与解释能力,上层的长程规划和错误恢复就会建立在极其脆弱的基础之上。
摆脱端到端黑盒指标的遮蔽,将界面的动力学机制(Dynamics)显式引入训练与评估体系,或许正是推动下一代 GUI Agent 真正走向稳健落地的必经之路。