GALA+:以服务拓扑约束智能体推理,微服务根因定位AC@1提升超25个百分点
GALA: Graph-Augmented LLM Agents for Root Cause Analysis and Incident Response in Microservices
在现代以微服务和云原生为底座的复杂分布式系统中,故障排查(Root Cause Analysis, RCA)向来是现场可靠性工程师(SRE)最头疼的挑战之一。几百个松散耦合的微服务纵横交错,一个底层依赖服务的 CPU 暴涨或内存泄露,往往会沿着调用链路层层上涌,最终在毫无因果责任的前端网关或聚合服务上炸出一堆超时告警。
ArXiv URL:https://arxiv.org/abs/2608.08968v1
此时,运维人员面临的不仅是“警报响起的节点往往不是故障根因”的误导,还有爆炸式涌现的海量异构遥测数据——指标(Metrics)、链路追踪(Traces)和日志(Logs)。近年来,研究界尝试引入以大语言模型(LLM)为核心的自主智能体(Agent)来处理这一繁复流程。然而,放任 Agent 自由发散排查往往会导致“盲目漫游”:它们在大规模服务空间中缺乏空间拓扑的约束,极易产生幻觉和假设漂移;同时,绝大多数学术工作到“给出一张故障概率排名表”就戛然而止,无法输出运维人员真正需要的因果推导链条与分级处置方案。
多伦多大学(University of Toronto)的研究团队针对上述痛点,提出了专为微服务根因定位与事件响应设计的图增强多智能体框架 GALA+。该框架的核心哲学十分务实:用系统物理依赖图作为 Agent 推理的“拓扑紧箍咒”,将复杂的跨模态证据推理严格限制在故障传播的局部因果邻域内。同时,作者联合工业界 SRE 专家提出了首个专门面向微服务 RCA 运维报告质量的评估框架 SURE-Score。在基准测试中,GALA+ 将首位根因命中率(AC@1)大幅拉升,较以往顶尖的 LLM 基线取得了超过 25 个百分点的显著提升。
告警节点欺骗与自由 Agent 的漫游陷阱
想要理解 GALA+ 的设计精髓,首先要看清现有自动化排查方法为何频频在实际生产场景中失效。
典型的微服务级联故障具有高度的欺骗性。假设下游服务 $S_5$ 遭遇了静默式的 CPU 饱和,导致其响应严重变慢;调用它的中间服务 $S_4$ 请求堆积,最终在监控看板上触发高延迟报警。如果 RCA 系统仅做孤立指标分析,或者单纯以触发告警的时间先后为准绳,极容易将 $S_4$ 判定为罪魁祸首。传统统计学或因果图方法试图通过指标时间序列来推导因果网络,但这类时序因果推断(如 Granger 因果、PC 算法)极易受运行工况的正常抖动干扰,甚至时常将因果边的方向搞反。多模态融合方案则习惯将日志、链路与指标强行压成低维统一表征,在这个过程中,原本能够将“传播受害者”与“始作俑者”区分开的模态特异性关键特征被抹平了。
当引入 ReAct、Tree-of-Thought 等大模型智能体工作流后,另一重隐患浮出水面:搜索空间的无界性。微服务集群动辄包含数十乃至上百个服务节点,缺乏图拓扑约束的 LLM Agent 在调用各种排查工具时,会在全系统节点之间随意跳转尝试。这种缺乏拓扑常识的推理不仅消耗巨量 Token、拖慢救火速度,还会引发严重的假设漂移——大模型在连续查看多个非关键服务的报错日志后,往往会把局部的偶发异常误认成系统级故障,最终导致幻觉滋生。
更重要的是,对于争分夺秒的 SRE 而言,单薄的服务概率列表缺乏可落地性。工程师不仅想知道哪个 Pod 坏了,还需要知道故障是如何传播的、当务之急该怎么止血、后续该怎么根治。以往学术界使用 BLEU、ROUGE 或 BERTScore 来给生成的运维文本打分,但在高度严肃的工程场景下,哪怕一段文本与参考答案字面重合度高达 90%,只要关键参数或排查逻辑存在因果倒置,在实际操作中就是彻底无用的废话。
GALA+ 四阶段流水线:从粗筛到图引导的因果收敛
为了在兼顾多模态信息的同时守住推理边界,GALA+ 构建了一套循序渐进的四阶段架构:
-
初始假设生成(Phase I):利用指标与链路两种正交维度的算法进行粗筛,并通过专门的整合智能体完成双信号假设融合;
-
Pod 级紧凑上下文构建(Phase II):提取候选 Pod 的模态切片,蒸馏出涵盖时序波动、错误语义与局部拓扑的低 Token 诊断包;
-
图引导智能体推理与重排(Phase III):以服务依赖图的局部因果边为导航边界,并行调度排查 Agent,自适应展开邻域探索;
-
诊断综合与结构化事件响应(Phase IV):跨分支汇聚证据,产出具有因果解释力的根因报告与三层时序递进的处置建议。
1. 双信号协同:指标因果与 STRIX 拓扑挖掘
在排查伊始,直接将所有微服务的所有日志全部灌给大模型既不现实,也不经济。GALA+ 在第一阶段先排除日志——因为大量致命故障初期并不产生显式错误日志——仅使用指标和分布式链路追踪(Traces)来圈定首轮候选名单。
该阶段引入了双轨并行机制:
-
一方面,利用经典的指标因果挖掘模块 BARO,通过在线变点检测与因果有向无环图(DAG)构建,输出基于时序因果影响力的初步候选排序 $R^{\text{Init}}_M$。
-
另一方面,为了弥补指标分析对因果边方向判断易错的缺陷,论文全新设计了 STRIX(基于跨模态探索的结构化链路排序)模块。STRIX 直接深入分布式调用链内部,提取两个核心拓扑特征:其一是服务拓扑与流量入度、出度比结合的改进 PageRank 得分,倾向于捕捉处于调用网络核心承压位的瓶颈;其二是服务耗时贡献度指标,精准计算某一节点相较于其下游调用节点的净延时增量。
通过倒数排名融合(RRF),STRIX 输出了完全基于图拓扑与 Trace 性能画像的候选序列 $R^{\text{Init}}_T$。
紧接着,系统指派了一个 Consolidation Agent(整合智能体)。面对两个来源的信息不对称(指标结果带有时序故障类型推测但拓扑较弱,链路结果拓扑显著但缺乏具体故障语义),该智能体并非粗暴地做数值平均,而是推导因果一致性:两方榜单皆高亮的服务被赋予极高置信度;仅在 Trace 中表现异常的服务会被参照指标信号补全故障类型假设;而仅在指标中露头的孤立节点则被下调置信度。最终,系统输出 top-$k$ 个带有来源出处与置信度 $\hat{c}_i \in [0, 1]$ 的统一候选集合 $R^\text{C}$。
2. Pod 上下文轻量化打包
进入第二阶段后,进入候选名单的每个 Pod 都需要接受细致的审讯。为了避免超长上下文带来的注意力稀释,GALA+ 将遥测数据抽象为三个极其精简的结构化片段:指标层提取异常峰值与趋势的 JSON 摘要,日志层仅筛选出在异常时间窗口内具有语义突变的关键错误序列,拓扑层则压缩为包含直接上下游连接的邻接列表。这种多模态诊断包既保全了原生特征的互补性,又将单节点排查的 Token 消耗压制在极低水平。
3. 拓扑引导下的深度受限并发探查
第三阶段是整个框架最核心的推理创新。为了打破以往无约束 Agent 的盲目搜索,GALA+ 引入了图引导的调查机制。
系统为 $R^\text{C}$ 中的高置信度候选节点并行派发 Investigator Agent。每一个智能体在审视该节点的诊断包时,必须输出结构化的判断结果,包含因果解释得分、正面支持证据、反面排他证据以及最新置信度。如果当前节点的本地多模态证据已经形成坚实闭环(置信度高且因果明确),调查立即收敛;若证据模糊或存在疑点,Agent 绝不被允许在系统中任意盲跳,而是必须沿着依赖图的有向边,仅向其前驱(上游调用方)或后继(下游被调用方)局部延伸。
调查的分支展开受到严格的置信度驱动与深度限制(Depth-bounded),在探索广度上也设定了采样预算 $b$。这种机制既防止了故障排查脱离图结构的无序发散,又赋予了系统修正上游误报、顺藤摸瓜揪出下游潜伏根因的能力。所有探查分支收集到的局部证据与推断,统一沉淀至共享的调查记忆体 $\mathcal{M}$ 中。
4. 证据综合与分级处置建议
在第四阶段,Evidence Synthesis Agent 从全局视角介入,对记忆体 $\mathcal{M}$ 中的多路分支展开仲裁。它核对各智能体搜集的论据,排查上下游之间是否存在相互矛盾的推断,剔除纯属连锁反应的虚假受害者节点,进而给出最终的根因 Pod 确诊排名。
不仅如此,该模块结合推理出的具体物理失效机理(例如数据库连接池耗尽、死锁、网络丢包引发的拥塞控制失效),自动生成面向 SRE 的三层时序递进处置建议:
-
即时缓解措施(Immediate Mitigation):旨在几分钟内阻断雪崩,如服务降级、临时限流扩容或针对异常 Pod 执行滚动重启;
-
永久修复方案(Permanent Fix):指引开发与运维在数小时或数天内定位代码缺陷,包括调整重试退避算法、修复内存泄露代码、重构阻塞调用等;
-
长期预防手段(Preventative Measure):着眼于架构演进,如完善全链路超时配置、部署熔断器、补充细粒度追踪埋点等。
告别字面匹配:工业级评估体系 SURE-Score
大模型不仅写诊断报告需要标准,评估这些报告更需要超越学术玩具级别的度量衡。论文的一个重要突破是与工业界一线 SRE 专家联合研发的 SURE-Score 评估框架。
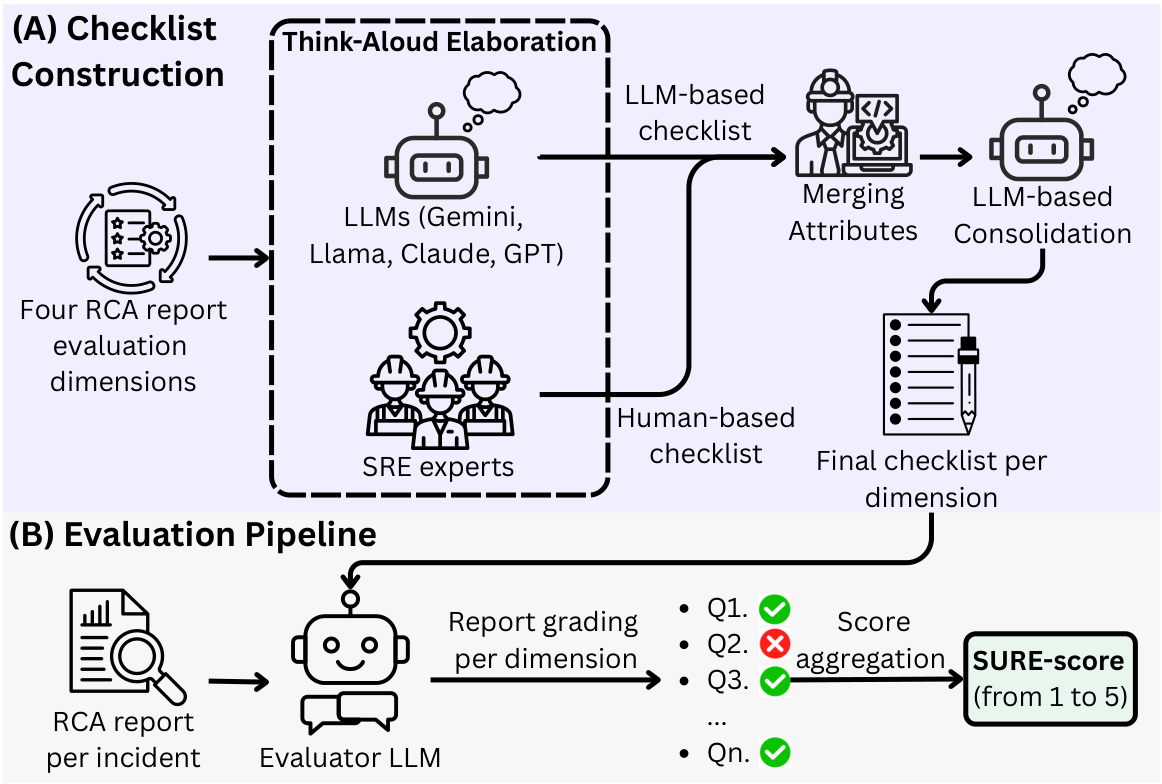
传统的 NLG 评估指标(如 ROUGE-L、BERTScore)在运维场景下存在致命盲区。以 BERTScore 为例,如果模型把“重启下游支付服务”误写成“重启上游网关服务”,两者语义向量可能高度相似,分值极高,但在实操中会造成灾难性的生产误操作。
SURE-Score 构建了一套细致的核查清单(Checklist)与双模型互审机制,从四个专业维度严格打分:
-
证据可溯源性(Evidence Groundedness, E):报告中的每一句断言是否能在指标突变、日志堆栈或链路延时中有迹可循,杜绝“空穴来风”的幻觉推论;
-
操作可行性(Operational Feasibility, O):所提缓解与根治方案在当前的云原生编排系统(如 Kubernetes)中是否真实可行,有无空洞的“优化性能”套话;
-
诊断精确性(Diagnostic Precision, D):对故障传播链条、失效机理和具体故障类型的定性是否完全切中要害;
-
分诊逻辑性(Triage Logic, T):三层处置方案在时间序列上是否合理,有没有出现“未止血就急着改代码重新上线”的逻辑倒错。
在评测流程上,体系先由专家根据真实故障现场审核并确立高质量黄金基准,再交由两个独立的大语言模型(Qwen3 与 Llama-4-Maverick)进行交叉双盲检查,将判断结果转化为 1 到 5 分的客观标尺,彻底规避了大模型评估自身输出时的“自恋偏好”(Self-preference bias)。
实验验证:复杂拓扑下的性能跃迁
研究团队在两个极具代表性的开源微服务基准测试集上验证了 GALA+ 的表现:OnlineBoutique (OB)(17 个微服务,典型的密集电商服务图)和 TrainTicket (TT)(69 个微服务,更深且高度复杂的分布式订票网络)。注入的故障涵盖了 CPU 饥饿、内存泄露、磁盘 I/O 阻塞、网络延时、套接字错误和丢包等各类典型模式。
下表呈现了 GALA+ 与各主流路线代表性基线在根因定位指标上的对比情况(AC@1 与 AC@3 代表前 1 和前 3 名命中率,MRR 代表平均倒数排名):
| 方案类别 | 代表性基线方法 | OB - AC@1 (%) | OB - AC@3 (%) | OB - MRR | TT - AC@1 (%) | TT - AC@3 (%) | TT - MRR |
|---|---|---|---|---|---|---|---|
| 传统图与因果方法 | BARO | 47.78 | 70.00 | 0.589 | 43.33 | 64.44 | 0.548 |
| 传统多模态方法 | Nezha | 42.22 | 68.89 | 0.551 | 38.89 | 62.22 | 0.513 |
| 现有 LLM Agent 方案 | RCA-Agent | 48.89 | 66.67 | 0.584 | 44.44 | 63.33 | 0.542 |
| 拓扑增强 Agent 方案 | GALA+ (本文) | 74.44 | 88.89 | 0.817 | 73.33 | 87.78 | 0.806 |
数据直观反映出几个层面的现实:
在纯统计与多模态表征融合时代,复杂网络(如具有 69 个服务的 TrainTicket)让传统算法在深层故障传播中难以维系稳定性,命中率普遍被压制在 40% 左右。即便是引入了通用 LLM Agent 的 RCA-Agent,受制于自由搜索带来的注意力涣散与工具误用,其表现也仅与顶尖的因果统计方案相当。
相比之下,GALA+ 在两个测试集上均将 AC@1 推高至 73%~74% 以上,较最强的 LLM 基线相对提升了超过 25 个百分点。这证明了拓扑剪枝结合轻量级多模态上下文,能够精准锚定首位根因,大幅降低 SRE 甄别排查结果的认知负担。
在运维文本生成的定性与定量对比中,SURE-Score 展现出对传统自然语言评测指标的碾压性优势。在传统的 BERTScore、ROUGE-L 和 METEOR 上,由于大模型普遍具备良好的语言生成能力,各对比方法的得分犬牙交错,差距微弱;但在 SURE-Score 的四个专业维度上,缺少图引导机制的基线模型在“诊断精确性”和“证据可溯源性”上大幅落后,频频给出似是而非的分析与脱离系统配置的操作建议。只有 GALA+ 在双 LLM 评估与盲测人类专家评估中,均斩获了最高的置信评级。
在消融实验中,如果将 STRIX 链路拓扑挖掘模块剥离,仅保留指标因果推断,系统的首选命中精度在复杂网络中出现了超过 15 个百分点的下滑;如果进一步去除 Phase III 的图引导局部调查,退化为仅依靠单步合并推理,AC@1 更是全面失守。这一结果印证了论文的核心判断:单模态粗筛必然存在系统性盲区,而缺少拓扑指导的 Agent 根本无法穿透级联依赖的迷雾。
同时,针对不同底层大模型的兼容性测试表明,尽管 Claude 3.5 Sonnet 等闭源旗舰模型能榨取出系统的极限排查性能,但借助 Qwen2.5-72B 或 Llama-3-70B 这类开源权重,GALA+ 同样能在兼顾数据合规与私有化部署的同时,以极其低廉的 Token 成本交付逼近顶级的根因排查精度。
工业启示:Agent 落地的正确姿态是注入物理世界法则
GALA+ 的工作为当前轰轰烈烈的“Agent + 垂直领域运维”研究给出了极具启发性的工程示范。
在过去两年中,不少方案陷入了“大模型无所不能”的技术崇拜,试图通过提示词工程让 LLM 全权接管分布式系统的决策中枢。然而,真实的工业场景由严格的架构拓扑、因果物理链条和强隔离的运维规约构成。不加约束的通用自主性往往演变为不负责任的胡思乱想。
GALA+ 的成功之处在于展现了符号约束与神经推理的深度互补:
-
它没有让 Agent 去从零猜测调用拓扑,而是让底层的 Service Mesh 或 APM 拓扑图成为 Agent 行动的绝对物理边界;
-
它没有用大模型做昂贵而低效的高频数字计算,而是将成熟的因果分析与 STRIX 拓扑挖掘封装为前置过滤器,只把最关键、最需要语义仲裁的多模态冲突交给大模型;
-
它不再把生成式任务当成写总结,而是将其严格锚定在具备操作可行性的生产排障工作流之中。
无论是对于从事 AIOps 的算法研究者,还是身处一线苦于排障效率的平台工程团队,GALA+ 都指明了一条清晰的演化路径:不要指望通识大模型天生理解生产架构,给智能体戴上业务与拓扑的“紧箍咒”,它们才能在真实的工程泥潭中真正成为 SRE 的得力搭档。