EnvCraft:从单步工具调用到系统级工作区,让Claw类Agent基准提升11.9%
EnvCraft: Synthesizing Executable Environments in Agentic RL for Claw-like Agent
大语言模型正在加速从“只会聊天的被动对话框”,演进为能够在真实操作系统、文件目录、终端与数据库中长期自主执行任务的“行动派”。在这一演进浪潮中,以 OpenClaw、NanoClaw 和 Hermes-Agent 为代表的系统级智能体(Claw-like Agent)逐渐成为前沿焦点。与调用单步外部 API 的普通工具型 Agent 不同,Claw 类智能体需要在带有持久状态的工作区(Stateful Workspace)中穿梭,执行跨工具、跨环境的多轮异步动作,并在执行报错时动态修复。
ArXiv URL:https://arxiv.org/abs/2609.05576
要训练这种具备长期规划与自我纠错能力的智能体,Agent 强化学习(Agentic RL)被视为最具前景的路径。然而,Agentic RL 的规模化扩展遭遇了一道致命屏障:缺乏高质量、低延迟、可执行且具备真实状态转移的交互式训练环境。现存的环境合成方法多集中在模拟单个工具接口(如天气查询、计算器),根本无法承载带有文件系统变更、复杂依赖和多轮状态追踪的系统级交互;若采用大模型在线伪造环境响应,不仅推理成本高昂,严重的幻觉还会导致奖励信号失真。
针对这一核心瓶颈,来自哈工大、华为、北大与清华的研究团队推出了 EnvCraft。这是首个专门面向 Claw 类智能体及通用工具智能体、可全自动合成代码沙盒环境与可验证 RL 任务的框架。通过解耦的环境合成引擎与拓扑感知数据生成引擎,EnvCraft 自动合成了 139 个可执行环境及近 2 万个复杂任务。在 Qwen3 与 Qwen3.5 全系列模型上的强化学习实验证明,该方案不仅在 Claw 专有基准上实现了最高 11.9% 的任务成功率提升,在通用工具调用评测中提升达 8.0%,同时还将推理阶段的 Token 消耗削减了最高 35%。
为什么现有环境无法训练真正的系统级智能体?
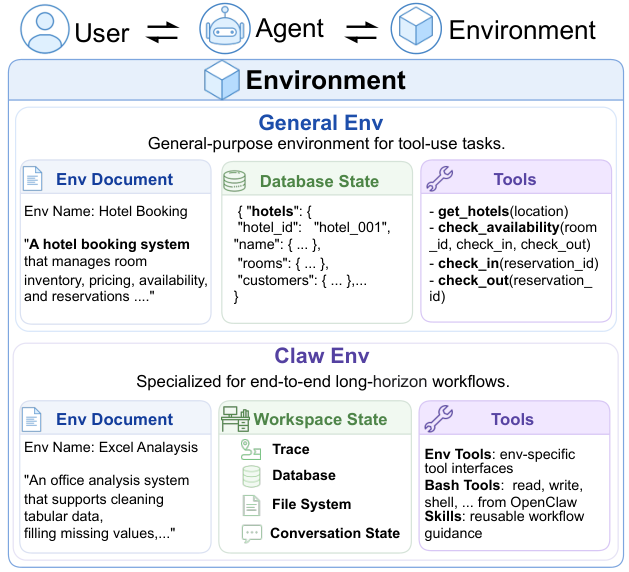
在传统的强化学习设定中,Agent 与环境之间构成典型的状态转移与反馈回路。如图 1 所示,一个健全的 Agentic RL 环境必须同时具备三项要素:环境交互文档 $\mathcal{D}{\text{doc}}$、工具接口规范 $\mathcal{I}{\text{tool}}$、显式状态空间 $\mathcal{S}$,以及确定性的沙盒状态转移函数 $\mathcal{T}$。每次智能体执行动作 $a_t$,沙盒必须真实演算出新状态 $\mathcal{S}{t+1}$ 并返回确定性观测 $\mathcal{O}{t+1}$。
以往学术界尝试通过两种路径解决训练环境不足的问题。第一种是用大模型作为模拟器(Simulator)来伪造工具的返回结果。这种方式最大的问题是高昂的上下文开销与无法根除的幻觉,一旦多轮交互深入,模拟器极易产生前后矛盾的系统状态。第二种是合成静态的代码沙盒,但此前的方法如 EnvScaler、ScaleEnv 等,主要将视角局限在孤立的无状态 API 端点或简单的类属性修改上。
Claw 类智能体的运行特征截然不同。它们不仅要在单次任务中操作 Shell 终端、读写本地磁盘文件,还涉及多工具间的数据管道流转与跨环境状态同步。如果缺少可执行的底层工作区,强化学习算法便无法获得客观、确定的后验奖励,模型也就无从学会如何在长序列执行失败后回滚状态或换路重试。
为此,研究团队明确了可执行环境与训练任务的形式化定义。他们将训练数据抽象为一个自包含三元组 $\mathcal{P}=\langle\mathcal{Q},\mathcal{S}{0},\mathcal{V}{\text{script}}\rangle$。其中 $\mathcal{Q}$ 为用户分步意图,$\mathcal{S}0$ 是预先注入的沙盒初始物理状态(包括必要文件与混淆数据),而 $\mathcal{V}{\text{script}}$ 则是基于代码的确定性验证脚本。这一设计彻底剔除了脆弱的 LLM-as-a-Judge 评判机制,用真实的后验状态断言(如检查特定文件是否被正确修改、数据库记录是否完整变更)来提供绝对可信的强化学习奖励信号。
双引擎驱动:代码沙盒与拓扑任务的自动化生成
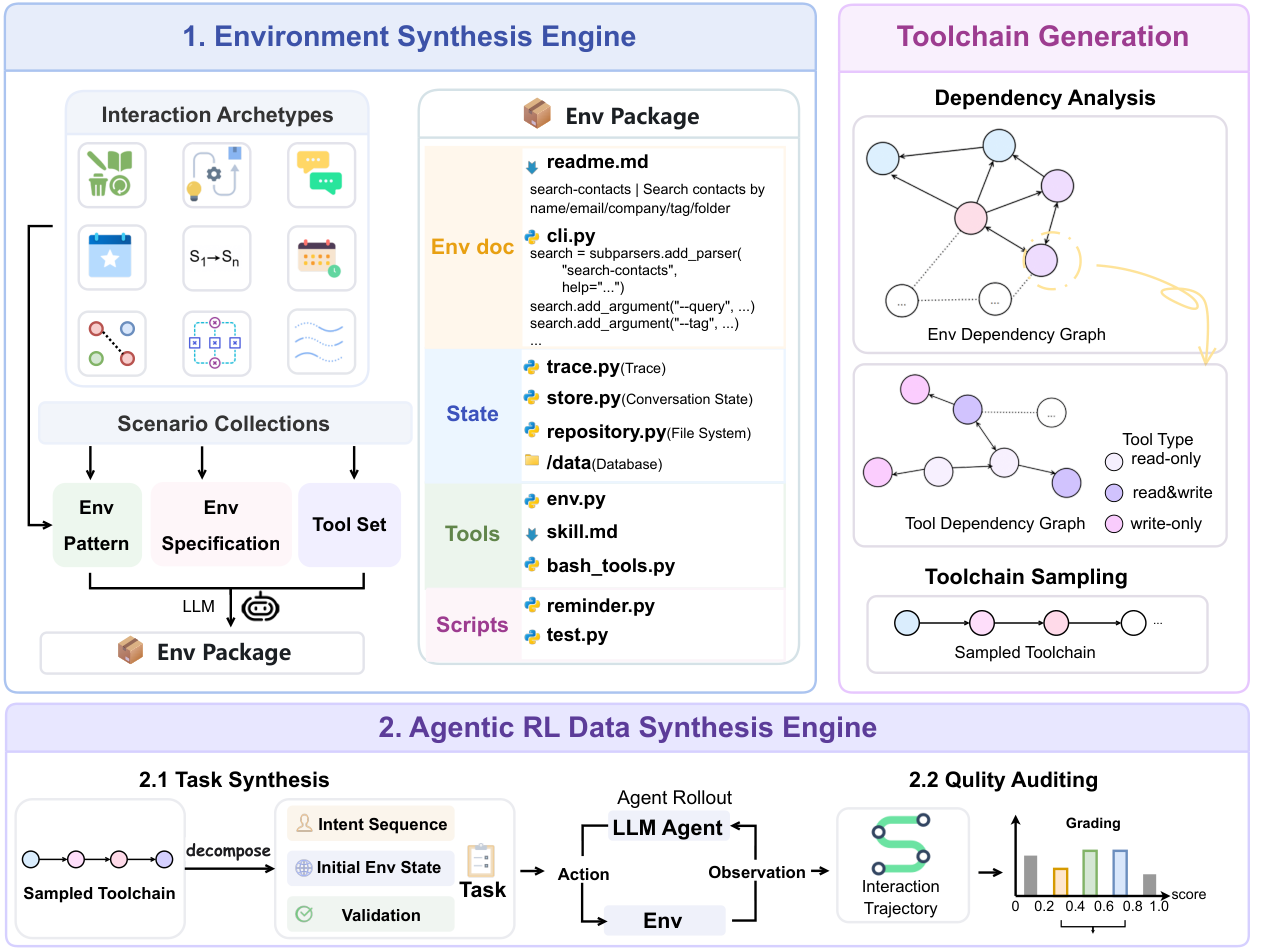
为了在无人值守的前提下批量生产高拟真环境,EnvCraft 构建了端到端的自动化管线,主要由环境合成引擎与数据生成引擎协同运作。
在环境合成阶段,研究团队首先从开源社区与实际应用中梳理出 41 个通用工具场景与 42 个 Claw 专有场景。面对错综复杂的系统逻辑,如果直接让大语言模型随意编写沙盒代码,极易生成结构散乱、难以稳定运行的代码块。EnvCraft 的破局点在于提炼出了软件交互的 9 大核心原型(Interaction Archetypes),作为代码架构锚点:
-
事务型工作区(Transactional Workspace)
-
跨工具数据管道(Cross-Tool Data Pipelines)
-
动态人机交互(Dynamic Human-Agent Interaction)
-
异步事件触发(Asynchronous Event Triggering)
-
约束引导状态机(Constraint-Guided State Machine)
-
多资源时序调度(Multi-Resource Temporal Scheduling)
-
多准则双边撮合(Multi-Criteria Bilateral Matching)
-
分布式工作流编排(Distributed Workflow Orchestration)
-
容错流处理(Fault-Tolerant Stream Processing)
每一种原型都包含严格的控制流范式与参考实现设计契约。生成新环境时,框架根据场景规格书的关键词匹配度,检索出最相关的两个原型作为上下文少样本参考,驱动底层模型编写完整的环境封装类。与此同时,环境合成器还会同步共生出配套的 Agent Skills(基于 Markdown 的领域执行指导文档),辅助智能体在复杂环境中快速领悟操作模式。
合成出的沙盒代码必须经过两道严格质检:第一层是静态语法校验与依赖安装测试;第二层是自动化探索测试,验证工具之间是否存在无法调通的死循环或逻辑断点。在最初生成的 324 个原始候选环境中,仅有 139 个环境通过了全部鲁棒性与稳定性审计,过滤后留存的环境包含 70 个通用工具环境与 69 个 Claw 专有环境。
在数据生成阶段,EnvCraft 解决了“如何生成符合因果逻辑的多轮执行任务”这一难题。框架构建了一个双层有向依赖图:底层是单环境内的工具依赖图,描摹参数流动的前置与后置条件;顶层是跨系统的工作流依赖图,将多个环境作为节点连接。系统通过带权随机游走算法,从图拓扑中采样出在逻辑上必然自洽的工具调用链路。
紧接着,框架采用“逆向工程”策略将工具链路转化为真实的用户任务:
-
因果反向推导与信息隐藏:大模型深入分析调用链上的每个参数,区分为“用户显式输入”和“中间依赖输出”。例如,查询返回的中间记录 ID 会被刻意抽象化掩盖,迫使智能体必须在沙盒中真实运行前置工具才能解开后续参数,坚决杜绝了模型在多步执行中的投机取巧。
-
意图递进分解与角色注入:现实中的人类用户极少在一句话里交代完所有长程任务要求。EnvCraft 将复合意图拆解为多轮对话,分步揭示信息,并从 PersonaHub 中检索语义匹配的人物画像注入对话,模拟真实场景下的多样化交互风格。
-
状态注入与验证脚本配对:模型根据工具链路,在沙盒中预埋必要的数据记录与逼真的干扰项(Distractors),并同步编写断言脚本 $\mathcal{V}_{\text{script}}$。
合成任务同样要经过难度校准筛选:研究团队使用 Qwen3.5-27B 对每个任务进行 8 次独立试跑,直接剔除通过率为 0%(不可解或错误任务)与通过率为 100%(过浅任务)的样本,仅保留处于适度难度区间的样本。最终,管线从 3.5 万个原始候选样本中沉淀出 19,777 条高质量轨迹数据。
强化学习实证:不仅成功率跃升,推理路径更加精简
实验团队采用开源的 VERL 框架与 GRPO(Group Relative Policy Optimization)算法,在 64 张 GPU 上对 Qwen3-8B、Qwen3-32B 以及 Qwen3.5-9B 三种骨干模型进行了端到端 Agentic RL 训练。
评测覆盖了两大阵营:一方面是针对真实复杂环境的 Claw 专属基准 PinchBench 与 Claw-Eval,评测智能体在 OpenClaw 架构下的长程端到端执行力;另一方面是通用多轮工具调用基准 BFCL-v3 与 $\tau^2$-bench,考察基础能力的迁移性。
在 PinchBench 和 Claw-Eval 基准上,基于 EnvCraft-Claw 数据的训练展现出极其显著的性能跃迁。具体来看,基座模型 Qwen3-8B 在 PinchBench 上的任务成功率从基准的 12.94% 翻倍提升至 24.85%(绝对提升 +11.91 个百分点),在 Claw-Eval 上的得分从 44.06% 增长至 55.42%(提升 +11.36 个百分点)。在更大参数量的 Qwen3-32B 上,PinchBench 成功率提升了 6.59 个百分点;而 Qwen3.5-9B 也在两个基准上分别取得了 +4.85 与 +4.08 个百分点的稳定增长。
这一提升不仅来自模型解题能力的提高,还体现在交互效率的根本性改善。实验监测了智能体在任务执行过程中的平均 Token 消耗。在经过系统级沙盒强化学习后,模型在 PinchBench 上的平均单任务 Token 消耗下降了约 20%。其中 Qwen3-8B 的 Token 消耗从 13.69K 骤降至 8.84K,降幅高达 35%;Qwen3-32B 与 Qwen3.5-9B 的消耗也分别缩减了 16% 和 8%。
这一“得分升高、消耗降低”的剪刀差现象极具技术说服力。它表明,在具备物理反馈的沙盒中进行强化学习,迫使模型戒掉了盲目试错和啰唆冗余的代码推演,学会了用更直接、逻辑密度更高的工具序列达成状态转移目标。
此外,研究人员还观察到显著的跨域泛化效益。在与训练集完全不重叠的通用工具基准 BFCL-v3 上,经由 EnvCraft 训练的模型取得了跨越式的进步:Qwen3.5-9B 的基准得分从 44.75% 提升至 52.75%(+8.00 个百分点),Qwen3-8B 也取得了 +7.00 个百分点的提升。即便仅在 Claw 专属数据(EnvCraft-Claw)上进行强化学习,模型在 BFCL 上的表现(45.88%)也与在通用工具数据上训练的结果(46.25%)高度接近,甚至超越了体积庞大得多的商用基线模型 Kimi-K2-Instruct。
这有力地证明:让智能体面对具备持久状态和复杂依赖的系统环境进行训练,所习得的规划与工具调用策略并非局限于合成环境内部的记忆,而是成功内化成了高度通用、稳健的系统操作认知。
走向自给自足的 Agentic RL 飞轮
长期以来,社区在讨论大模型强化学习时,往往聚焦于数学推理和编程竞赛等具有明确规则闭环的领域,原因正在于这些领域天然拥有低成本、自动化的执行判题机制(Compiler & Test Cases)。但在智能体领域,复杂物理或虚拟系统环境的搭建一直重度依赖人工苦力,成为阻碍 Agentic RL 规模化落地的核心枷锁。
EnvCraft 展现的深层价值,在于它验证了一条“以模型合成环境,用环境淬炼模型”的可行闭环链路。通过九大交互原型的模式抽象与双层拓扑图引导的反向工程,框架绕开了昂贵且脆弱的人工标注与大模型 Mock 欺骗,批量制造出经得起真实代码运行检验的数字沙盒。
当高质量、可执行、带断言验证的环境能够像代码语料一样源源不断被合成出来时,智能体的大规模后训练就不再受限于外部 API 权限或人为编写的测试用例。从单步接口调用迈向系统级全功能操作,EnvCraft 所奠定的环境自动化合成范式,为真正具备自主工作能力的下一代 Agentic RL 演进提供了关键的基础设施支撑。