DIVE:用多样性技能进化打破冻结模型上限,推理成本降低42.5%
DIVE: Unlocking Self-Improvement in Frozen Language Models Through Diversity-Driven Skill Evolution
大语言模型在部署后往往处于参数冻结的状态。无论在实际任务中遇到多少次相似的边界情况、经历多少次推理失败,抑或得到外部验证器的即时反馈,这些交互经验都无法直接沉淀到权重之中。尽管模型在单次上下文内可以表现出极高的推理灵活性,但只要对话窗口关闭,那些耗费大量算力探索出的解题思路与避坑指南就会彻底归零。
ArXiv URL:https://arxiv.org/abs/2608.12486v1
针对这一困境,工业界通常依赖微调(SFT)或强化学习(如 PPO、GRPO)来调整参数,但这类方案需要全量访问模型权重、搭建复杂的工程流水线,对闭源商业 API 并不适用。另一条路径是让模型将经验以自然语言的形式总结在上下文中,即提示词优化与反思记忆。然而,基于自然语言的自我改进本质上是一个高度非凸、方差极大的随机搜索过程。当模型完全依靠自身反馈来修改策略时,极易陷入局部最优、对少数失败样本过度拟合,甚至由于一次错误的反思而彻底破坏原有的解题逻辑。
来自思科研究院(Cisco Research)与佐治亚理工学院(Georgia Institute of Technology)的研究团队提出了名为 DIVE(Diversity-Driven Skill Evolution)的全新框架。该工作表明,无需更新模型权重,也不需要引入更强大的教师模型,冻结的语言模型完全可以通过“多样性驱动的技能演化”实现稳定的自我进化。在六项高难度数学与逻辑推理任务中,DIVE 仅凭纯文本技能的迭代,便在更少的采样步数下取得了超越参数微调与强化学习的表现;搭载 DIVE 的轻量模型甚至能以更低的综合成本,直接击败常规提示下的顶级超大模型。
将经验沉淀为可进化的结构化技能
在传统上下文学习(In-Context Learning)中,最直观的经验复用方式是构建动态示例库或检索增强(RAG)。但简单地拼接解题历史会迅速耗尽模型的上下文窗口,并引入大量琐碎无用的噪声。DIVE 的基本立足点,是将一次性的上下文反思升华为持久、抽象、可复用的“自然语言技能(Skill)”。
在 DIVE 的定义中,一项技能是一个经过提炼的紧凑文本组件,它不仅包含可推广的推理步骤,还显式封装了验证策略、常见失败模式以及格式边界约束。更为重要的是,技能是作为一种高阶认知策略注入到下游推理中的:相同的底层冻结模型既是这些技能的执行者,也是技能的审查者与修改者。这种形式完全避开了权重修改带来的灾难性遗忘与硬件门槛,同时让模型的演化过程具备了天然的人类可读性、可编辑性与跨模型可迁移性。
但要让模型自己修改自己的技能,核心难点在于演化过程的路径依赖(Path Dependency)。如果从单一的初始提示词出发,顺着贪心策略进行迭代,单次劣质修改就可能导致技能退化。为了解决这种优化方差,DIVE 并没有试图设计一个近乎完美的单线优化器,而是将演化算法中的种群思想引入到了自然语言搜索中,通过在全流程保持“假设多样性”,来抵御单轨迹搜索的脆弱性。
独立种群与自适应演化算子:如何系统性对抗局部最优
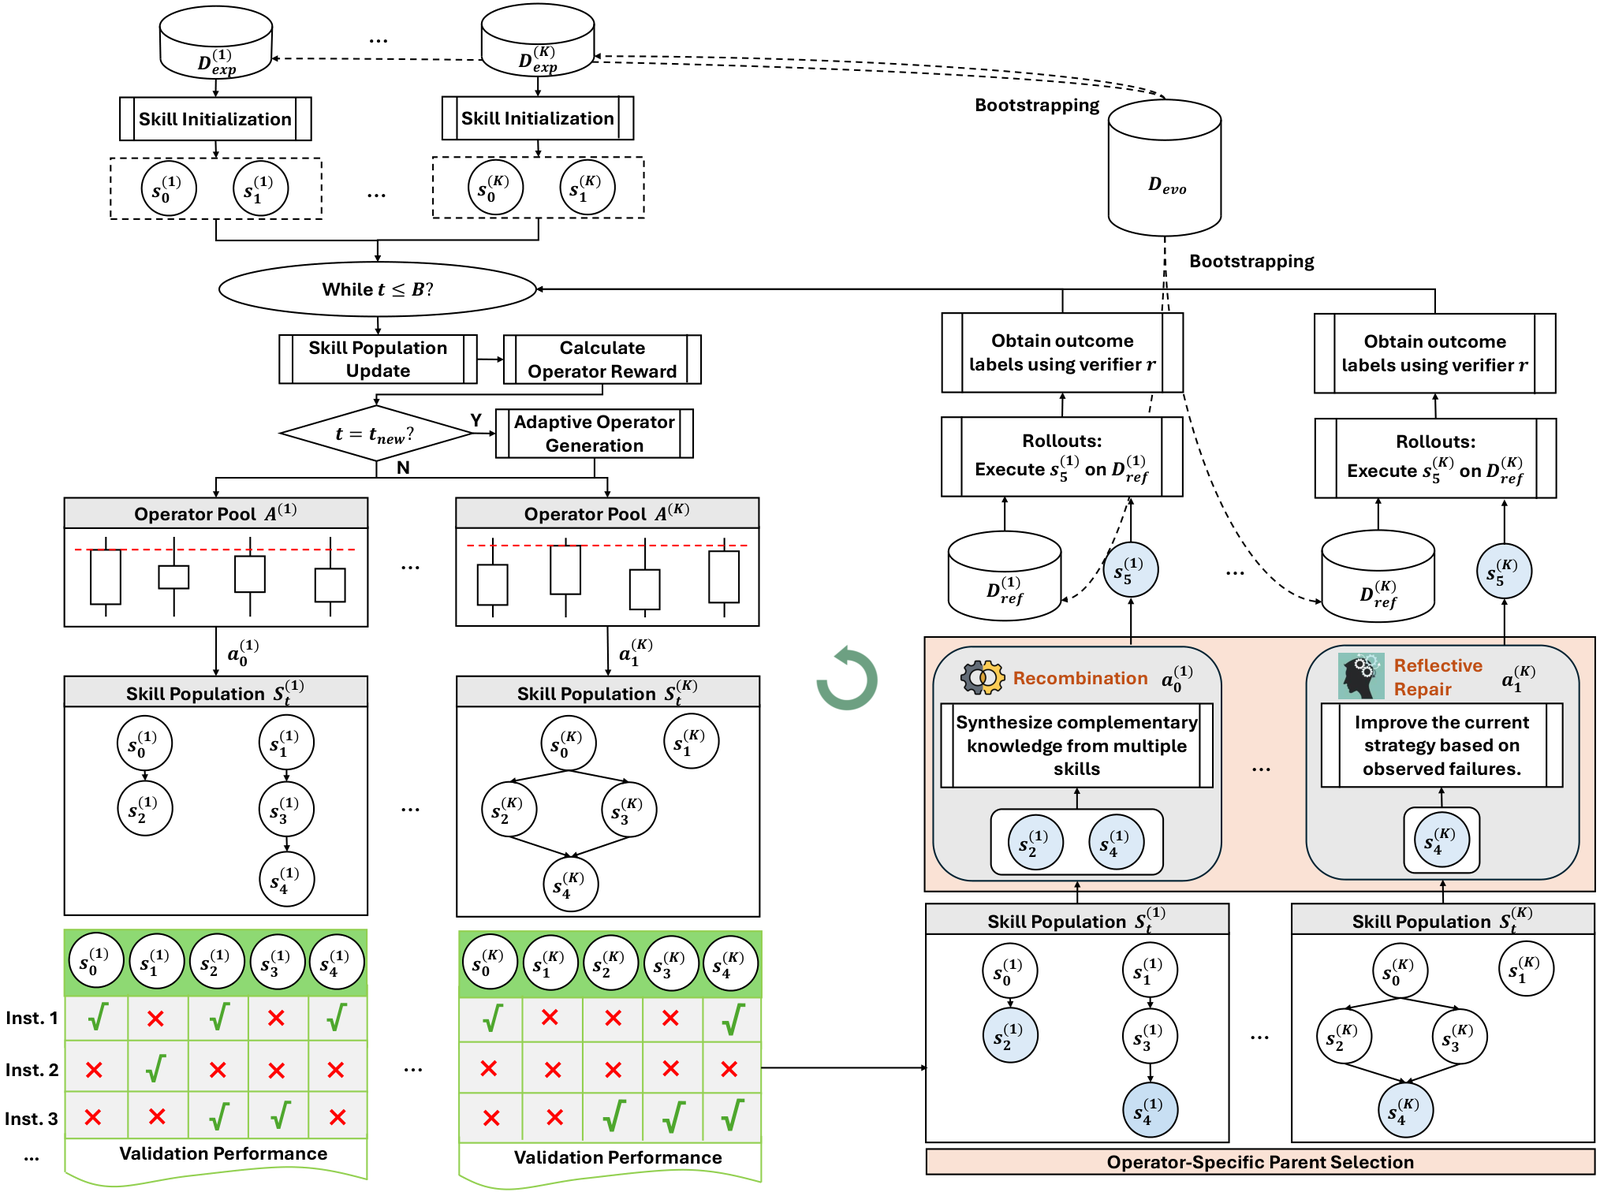
DIVE 的核心机制可以划分为三个紧密相连的阶段:经验自举初始化、自适应多算子演化,以及最终的多样性联合筛选。
整个演化流程从数据切分开始。开发集被划分为演化集与验证集,而演化集内部又为每个独立的种群随机自举采样(Bootstrap)出两组数据:经验子集与反思子集。对于第 $k$ 个技能种群,经验子集负责提供带有验证器标签的轨迹,模型从中提取初期的成功模式与常见错误,生成各具偏差的种子技能;反思子集则充当该种群内部演化过程中的试金石,用来动态评估当前技能的有效性并暴露新的缺陷。由于不同种群接触到的自举数据分布存在细微差异,各个种群在初始阶段就形成了截然不同的解题范式。
在种群内部的迭代演化中,DIVE 摒弃了单一的“反思-重写”逻辑,而是设计了一套异构的演化算子工具箱。不同的算子代表了截然不同的搜索步长与方向:
-
反思修复(Reflective Repair):针对反思集中的具体失败轨迹,对技能进行局部微调与针对性修补;
-
探索性修订(Exploratory Revision):鼓励模型跳出既有解法,引入完全不同的推理框架或全局视角;
-
压缩(Compression):去除技能冗余,将复杂的解题逻辑浓缩为高密度的核心规则,以降低认知负荷与上下文消耗;
-
多亲本重组(Multi-Parent Recombination):借鉴遗传算法的思想,将种群内表现良好的两个不同技能进行杂交,融合各自的局部优势。
由于不同任务或不同演化阶段所需要的算子各不相同,DIVE 引入了多臂老虎机中的置信区间上限(UCB)算法来动态分配计算预算。系统根据每个算子在历史迭代中带来的性能增益均值以及被尝试的频次计算 UCB 分值:
\[\operatorname{UCB}_{a}(t)=\widehat{\mu}_{a}(t)+\beta\sqrt{\frac{\log t}{N_{a}(t)}}\]其中,第一项鼓励利用(Exploitation),优先调用历史上收益显著的算子;第二项则保障探索(Exploration),防止某些潜在算子由于前期偶然的失败而被永久弃用。不仅如此,当演化推进到特定步数时,DIVE 还会分析当前的演化历史记录,让模型自主生成针对当前困境的新算子,将其作为未测试臂直接扩充到 UCB 决策池中,实现了算子层面的元演化(Meta-Evolution)。
联合互补筛选与测试期候选重排
经过多轮迭代后,各个种群中都会涌现出一批高分候选技能。以往的提示工程往往只会在这批候选者中挑选一个在验证集上得分绝对最高的技能作为最终输出。但 DIVE 的实验和理论分析表明,单个最强技能往往具有其盲区,而多个略有差异但能够相互覆盖彼此失败样例的技能,所能激发的集体潜能远高于单兵作战。
DIVE 改变了最终产物的构成逻辑,转向构建一个规模为 $M$ 的“互补技能组合”。在演化结束阶段,候选技能脱离各自的演化子集,统一在共享验证集上接受评测。筛选算法以贪心的方式寻找边际增益最大化的组合:每次加入的新技能,必须能够最大程度解决已有技能组合未能正确解答的遗留难题。为确保来源的多样性,算法同时施加了每个种群最多贡献一个技能的结构约束。
在最终推理阶段,系统并不强行将这 $M$ 个技能拼接进同一个提示词中——这种做法往往会导致指令过长、注意力分散乃至逻辑冲突。相反,DIVE 采取了“分而治之、统一裁决”的推理管道:每个入选技能分别独立挂载在输入问题之后,驱动冻结模型生成各自的候选解,随后再由该冻结模型充当重排裁判(SelectTop),从这组候选解中挑选出置信度最高或一致性最强的最终答案。多样性演化带来的多元解题视角,最终在推理阶段转化为了互补的候选解空间。
实验评测:不仅超越单轨迹优化,更叫板参数微调
研究团队在 HMMT(哈佛-麻省理工数学竞赛题)、Equational Theories(方程理论)以及四种高难度逻辑谜题(Sudoku 数独、Cryptarithm 字母算术、Calcudoku、Futoshiki 不等式数独)的 Hard 子集上对 DIVE 进行了全面评测。测试基座涵盖了 GPT-5-nano、DeepSeek-v4-flash 以及 Qwen3.5 系列等不同体量的模型。
基准对比覆盖了四大门类:基础推理与采样方案(ICL、Self-Consistency、Tree-of-Thought)、外部记忆与经验检索(Experience RAG、ExpeL)、代表性技能学习方法(Direct Skill Generation、SkillOpt),以及先进的单轨迹提示词优化方案(MIPROv2、GEPA)。
主实验数据展现出了压倒性的优势。在所有测试任务上,DIVE 均取得了显著超越现有非参数优化方法的成绩。传统的单轨迹提示优化方法(如 GEPA)在遇到需要长程规划的复杂逻辑任务时,往往很快出现早熟收敛,在演化中期就停止了性能攀升;而 DIVE 得益于多兵种算子的动态博弈与多姿态种群的并行探索,能够持续挖掘出更有泛化力的规则。
尤其引人注目的是 DIVE 与参数级更新方法(SFT、GRPO)在 Qwen3-8B 上的横向对比。通常认为,调整参数所能带来的表征适应能力必然优于外部提示词的调整。但在相同的采样预算(Rollouts)下,DIVE 展现出了惊人的样本效率:其自进化曲线以远陡峭的斜率向上攀升,在显著少于 GRPO 的样本消耗下,便达到了更高的任务准确率;而受限于数据蒸馏质量的 SFT 与单线搜索的 GEPA 则很早陷入了瓶颈平台。这一结果证明,对于具备基础指令遵循与长程思考能力的基座模型而言,阻碍其解题的往往不是知识容量的匮乏,而是缺乏针对特定复杂规则的系统性解题步骤与自查机制,而这些高阶认知完全可以通过结构化的语言技能来激活。
降维打击与通用迁移:小模型跨越量级挑战大模型
除了在同尺寸模型上拔高上限,DIVE 还展现出极具工程落地价值的“越级挑战”与“技能迁移”属性。
在关于模型规模与推理成本的实验中,研究者对比了轻量级模型 GPT-5-nano 与未经过技能演化的全尺寸旗舰模型 GPT-5。结果显示,搭载 DIVE 演化技能库的 GPT-5-nano,在六项任务上的平均准确率不仅逼平、甚至略微超过了采用常规上下文学习的 GPT-5 原生模型;与此同时,由于小模型本身的计费或推理消耗远低于大模型,即使 DIVE 在测试期生成了多路候选解并进行重排,其总体的推理 Token 成本仍然比直接调用单次 GPT-5 降低了 42.5%。这意味着,对于计算资源受限或需要高频调用的生产环境,通过离线演化一套专用技能集赋能轻量模型,在经济性与性能上都要显著优于盲目堆砌巨型模型。
此外,DIVE 演化出的技能本身脱胎于自然语言,天然具备语义层面的泛化能力。实验表明,在 Qwen3.5-9B 上演化打磨出的技能集,直接零样本迁移给更大尺寸的同族模型 Qwen3.5-27B,甚至直接应用到架构与训练语料完全不同的 DeepSeek-v4-flash 上时,依然带来了非常稳健的性能提升。虽然针对目标模型直接运行 DIVE 能获得最契合其自身特性的定制化技能,但这种跨模型乃至跨架构的技能泛化性,揭示了自然语言作为一种“模型间通用认知协议”的巨大潜力。
消融验证:演化闭环中的关键抓手
为了进一步剥离框架中各模块的实际贡献,论文在 Qwen3.5-9B 上针对技能集合构建策略与算子调度方式展开了细致的消融分析。
在关于“如何挑选最终技能集”的对比实验中,研究人员设置了三种对照策略:
-
随机选择(Random $M$ Skills):从每个种群中随机抽取一个技能组合成集;
-
单兵最优(Top-$M$ Individual Skills):仅依据验证集上的绝对准确率,选取表现最好的前 $M$ 个技能;
-
联合互补选择(Joint $M$-Skill Selection):DIVE 所采用的贪心边际增益选择机制。
测试表明,联合互补选择在所有任务上均全面领先于“单兵最优”。单兵最优策略选出来的技能往往同质化严重——它们擅长解决同一类相对简单的常见题型,但在面对边缘复杂案例时集体失灵;而联合互补策略虽然纳入了个别单独表现略逊一筹但解题视角独特的技能,却在重排后展现出了极高的容错率。
在演化算子的消融中,如果将算子库退化为单一的“反思修复”,演化轨迹很快陷入停滞;引入探索性修订与重组算子能显著拓宽搜索边界;而 UCB 自适应分配与动态新算子生成机制,则确保了在有限的演化迭代步数内,计算资源能够智能倾斜给当前任务最急需的认知变换方式。
重新审视自进化:从参数更新到语义搜索
DIVE 的出现为大语言模型的自我改进提供了一种全新的思考视角。长期以来,学术界与工业界存在一种潜在的思维定式,即将模型的“进化”等同于“反向传播与参数重置”。然而,随着前沿基座模型的规模不断膨胀以及 API 交付模式的普及,直接修改权重的代价已经高昂到让多数开发者难以承受。
DIVE 用扎实的实验数据表明,冻结的语言模型完全可以通过探索自然语言的解空间来完成自我迭代。自然语言不仅可以充当通信的载体,更可以作为一种外置的、可读可写的“认知程序代码”。通过多样性种群维持假说空间、借助异构算子实现全局跳跃、利用老虎机策略平衡算力分配,并最终以互补原则统揽全局——这种将演化计算精髓与自然语言理解深度融合的范式,或将成为未来低成本、高可控大模型自主进化的关键演进方向。