知识注入仅占4.5%!斯坦福等解构Agent技能:程序锚定与检索陷阱
Demystifying Agent Skills: Why They Work-Until They Don't
在赋予大语言模型(LLM)自主解决复杂问题的过程中,“技能”(Skills)正成为智能体(Agent)系统最炙手可热的演化构件。无论是让智能体操作命令行、处理软件工程任务,还是调用外部工具,业界普遍的做法是将过去的成功执行记录、调试经验或工具调用规范打包成模块化的 SKILL.md,以此实现所谓的“自进化”或“经验复用”。
ArXiv URL:https://arxiv.org/abs/2608.14036v1
然而,这种做法背后长期笼罩着一层黑盒迷雾:我们只知道把技能塞给 Agent 后,基准测试的整体成功率提升了,却很少追究它究竟改变了 Agent 的什么行为。为什么相同的技能能够拯救一次任务,却在相似的另一项任务中引发死循环甚至超时?Agent 变强是因为它学到了此前缺失的事实知识,还是仅仅被规范了动作?
来自约翰斯·霍普金斯大学、普林斯顿大学、斯坦福大学、加州大学圣迭戈分校以及南加州大学的联合研究团队,在论文《Demystifying Agent Skills: Why They Work-Until They Don’t》中对这一机制进行了系统剖析。他们建立了一套对照轨迹分析框架,对 8,135 次执行记录进行标准化处理,并提炼出包含 12 种模式的行为分类法。研究给出了一个颠覆直觉的结论:在技能发挥正面作用的案例中,显式事实知识注入仅占 4.5%,而高达 65.7% 的收益来自“程序性锚定”(Procedural Anchoring)。技能的本质不是教模型“新知识”,而是为其容易漂移的推理轨迹提供一副操作手铐。
不是经验累加,而是表示形式的抽象跳跃
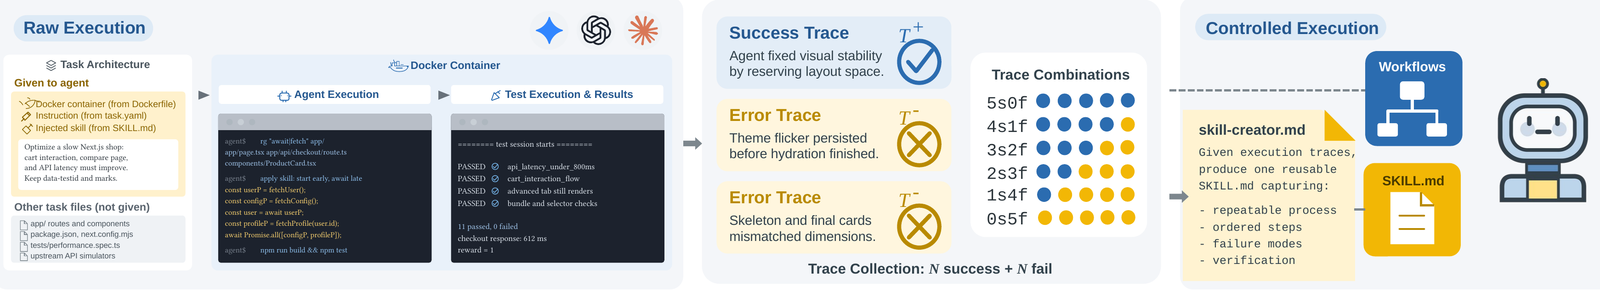
为了把技能的作用机制与单纯的“经验输入”彻底剥离,研究团队首先设立了一组严谨的受控实验。以往的很多工作混淆了“让 Agent 看过往执行轨迹”与“让 Agent 使用结构化技能”之间的界限。为此,该研究设计了三组对照条件:
-
原始基线(Raw):智能体在没有任何先验经验的环境中独立解题。
-
工作流记忆(Workflow Memory):将过去执行中经过清洗的操作轨迹原样注入上下文,提供真实发生过的执行流程。
-
结构化技能(Skill):由同样的底层轨迹提炼、规范化生成的紧凑操作指南(
SKILL.md),包含环境准备、操作步骤、自检点和避坑指南。
在固定计算预算与相同数据源的条件下,研究人员让两个主流模型组合(Codex + GPT-5.3-Codex 与 Gemini CLI + Gemini-3.1-Pro-Preview)在 Terminal-Bench-2、SkillsBench 和 Terminal-Bench-Pro 等严苛的命令行与软件工程基准上进行了多轮匹配评测。
实验得出的第一个关键结论是:在相同先验轨迹支撑下,Skill 相较于 Workflow Memory 取得了 6.06 个百分点的显著净提升(95% 置信区间为 [+0.76, +11.36])。
这一差距极为重要。因为两种方案吃进的原始经验完全一致,性能差异只能归因于“经验是以何种形式被表征的”。直接将过往轨迹灌给模型的工作流记忆方案,不仅无法提供同等程度的帮助,在某些高难度配置下甚至会拖累表现。深入轨迹分析表明,工作流记忆虽然保留了详尽的探索细节,但也附带了大量无关尝试、走入死胡同的失败分支以及冗长的过程噪声。大模型在面对这类非结构化的冗长上下文时,极易产生目标漂移,并在调试细节上反复消耗推理步数,最终因超时或上下文膨胀而崩溃。
相反,经过提炼的技能文件将混乱的探索收敛为标准化的程序。它剔除了偶发性的试错动作,保留了可泛化的操作范式,使模型免于在历史噪声中重新摸索。
拆解技能黑盒:三大类别与十二种使用模式
为了超越“宏观成功率”的粗糙度量,研究者对 240 个抽样轨迹进行了开放式编码(Open Coding),最终聚合出一套具有高一致性($\kappa = 0.952$)的分类框架,将智能体在注入先验后的行为划分为三大宏观类别(Skill-use Categories, SC)及 12 种微观模式:
-
SC1:成功程序锚定(Successful Procedural Anchoring)。包括自主成功、格式/环境规避、工具调用流对齐等正面赋能状态。
-
SC2:执行层与验证崩溃(Execution-Layer and Verification Failures)。包括环境配置报错、输出格式失配、服务生命周期失控、Shell 语法污染、算法底层逻辑错误以及缺乏动态运行时的静态虚假验证。
-
SC3:调用、适用性与边界失效(Invocation, Applicability, and Boundary Failures)。包括技能被机械误用或忽略、上下文冲突、不可执行的前提假设以及硬性资源限制。
统计分布揭示了技能如何精确重塑 Agent 的行为。相比于未经强化的原始基线,注入技能后,SC2 类的执行层崩溃大幅缩减:在基线中,执行层错误占据了 37.3% 的轨迹标签,而在技能组中这一比例骤降至 23.5%。这表明,技能最擅长扑灭的是那些低级但致命的操作脆弱性——例如配错环境变量、拼错启动参数、遗漏依赖安装、违背评测脚本所要求的 JSON 结构规范等。技能以程序锚点的形式,将智能体牢牢钉在一条安全的操作走廊内。
然而,数据同时也划清了技能的效能边界。在 SC2 中,两类顽疾几乎对技能免疫:算法逻辑错误(在基线中占 8.3%,技能组依然占 7.4%)和缺乏动态验证的虚假自信(各组均稳定在 11%~12% 左右)。这意味着,如果一个任务的破局点在于深层次的数学推导、核心业务逻辑重构,或者需要 Agent 自行设计并运行严谨的单元测试进行闭环校验,那么静态的技能指南几乎无法提供实质性帮助。技能可以教会 Agent 如何稳妥地启动服务、执行构建,却无法替大模型完成高阶推理。
技能的副产物:机械套用与语境漂移
任何抽象都是一把双刃剑。研究人员注意到,虽然技能压制了执行层的操作失误,但它却制造了一种全新的系统性故障——SC3 类中的“技能误用或机械照搬”(skill_guidance_misapplied_or_ignored)。
在原始基线和工作流记忆中,此类现象几乎可以忽略(占比分别为 0.8% 和 0.4%),但在技能测试组中,该模式猛增至 10.0%。这类失败并不是因为技能写错了,而是因为技能写得“太像标准答案”,导致模型放弃了基于当前具体语境的自适应判断。
一个典型的现场是:技能文件中提供了一段用来规避特定端口占用的脚本范例,其中硬编码了默认配置;当 Agent 面临一个目录结构或运行环境略有不同的新任务时,它往往不加辨别地机械执行该脚本,直接破坏了已有环境,引发级联报错。智能体未能理解技能成立的前置假设,在“盲目信奉先验规范”与“结合当前环境动态调整”之间失去了平衡。
此外,提炼技能的过程同样依赖先验信号的纯净度。实验表明,当源轨迹中混入失败经验时,技能生成器是否被赋予“成败标注”(Outcome Annotations)将产生决定性差异。在全是成功样本时,给不给标签对技能质量影响不大;但一旦经验池中包含失败案例,缺乏显式成败提示(No-hint)就会导致提取出的技能充斥着错误的操作预设,直接造成下游成功率腰斩。例如在 Gemini 针对 Terminal-Bench-2 的 $3s2f$(3次成功、2次失败)混合池实验中,标准带标签技能实现了 0.7462 的成功率,而无标签指导下生成的技能成功率断崖式下滑至 0.4000。
检索的残酷真相:精度暴跌与非必要命中
在真实业务场景中,我们不可能为每个任务人工预置唯一的 SKILL.md,智能体必须从一个包含数十乃至数百个技能的共享库中自行检索。这构成了论文探讨的另一个关键命题:技能检索的瓶颈到底在哪里?
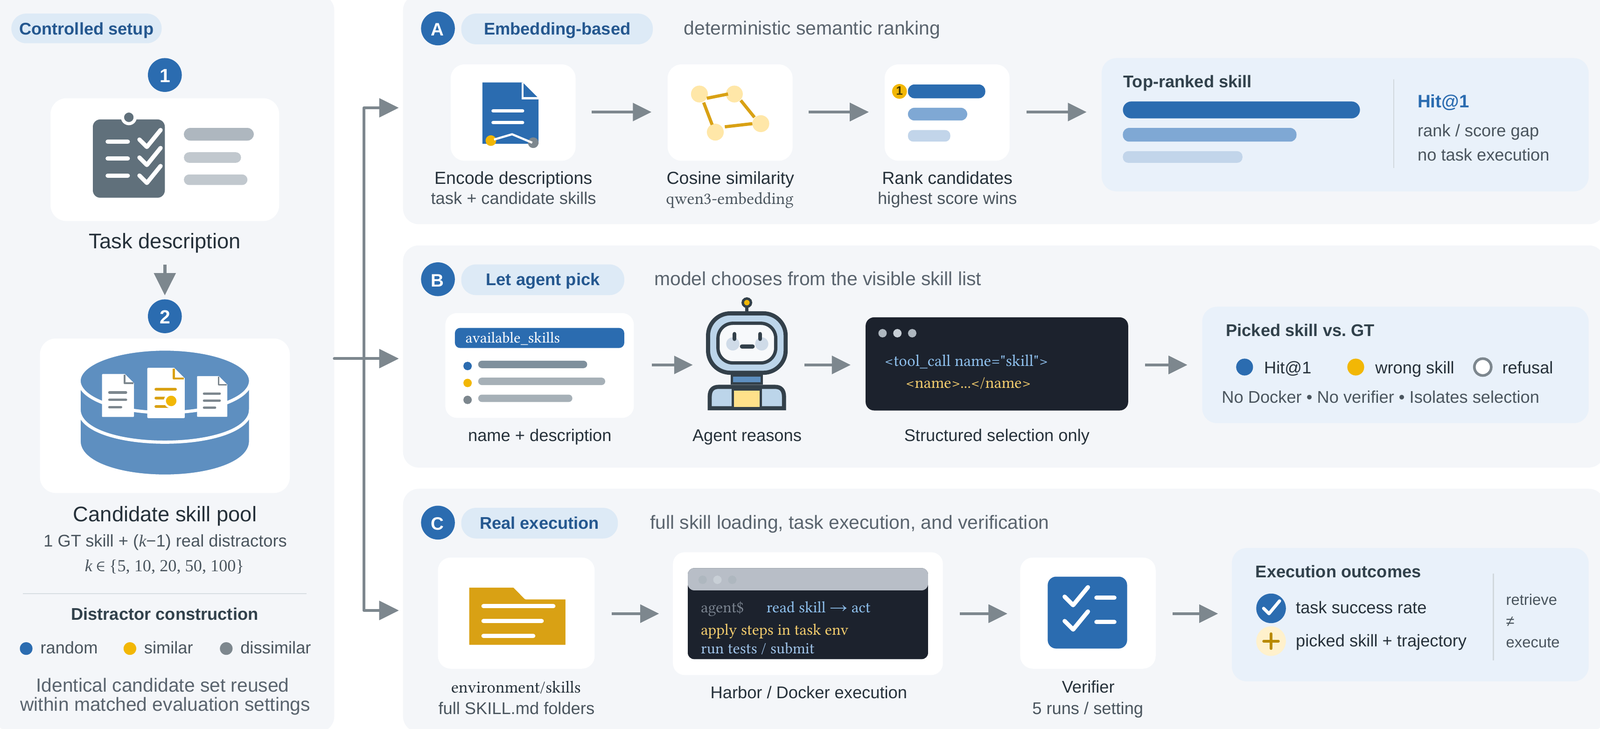
研究团队设计了三层独立的评测流水线,将向量嵌入排序(Embedding Ranking)、智能体显式选择(Agent Selection)以及全池动态执行(Full-pool Real Execution)隔离开来。他们在 SkillsBench 上通过注入不同数量与类型的混淆项(Distractors),观测系统的退化趋势。
实验暴露出了令人心惊的检索效率跌落:当技能候选池的规模从 5 个扩大到 100 个时,智能体在实际执行过程中调用的技能精度(Actual-use Precision)从 29.6% 一路滑落至 3.3%。高混淆度干扰项的加入,使得基于文本相似度的嵌入模型和模型自身的离线预筛选近乎失效。
但在看似崩溃的检索指标背后,下游任务的真实执行成功率却展现出了惊人的韧性。更深入的对比分析得出了一个反直觉的洞见:在执行层面上,精准命中官方标注的“基准技能”(Ground-Truth Skill),既不是任务成功的充分条件,甚至也不是必要条件。
之所以“不充分”,是因为即便检索模块分毫不差地拉取到了黄金技能,Agent 仍可能在后续执行中因为超时、数值精度缺失或深层算法缺陷而折戟;之所以“不必要”,则是因为技能本质上是程序性锚点。当面对一个复杂的系统运维任务时,Agent 检索到的可能是一个“相关但并非完全对标”的技能(例如检索到了类似的数据库迁移指令,而非当前特定的脚本工具),但该技能所包含的标准工具链组织逻辑、防御性检查步骤和通用命令写法,已经足够为 Agent 提供关键的下限支撑,助其平稳推进行动。
换言之,把技能当成 RAG 中的精准文档片段来做检索,从一开始就偏离了技能运行的真实逻辑。技能提供的是结构范式,而非绝对对应的事实补丁。
走向自适应程序进化
这项研究打破了对 Agent 技能机制的盲目乐观,也为后续构建真正能够自进化的系统提供了清晰的工程指引:
首先,必须重新校准对技能的定位。不要指望通过堆砌技能文件来弥补大语言模型在核心算法推理上的缺陷,也不要将其视作注入垂类专业知识的常规容器。技能最擅长且最应该负责的,是充当操作层面的标准作业程序(SOP),用来固化那些易错的环境搭建、接口适配、管道调度与格式约定。
其次,技能的生命周期管理远比无限扩充技能库更重要。当技能库膨胀后,检索精度的急剧衰减会迅速反噬系统;而僵化的先验规则又会导致模型机械执行。一个健康的自演化 Agent 系统,不仅需要具备从多源轨迹中剔除噪声、提炼程序锚点的能力,更需要建立语境兼容性验证机制——让 Agent 在调用一项技能时,能显式校验当前运行时是否满足技能的前提约束,并学会在发现环境冲突时主动抛弃先验、回归基础推理。
智能体的真正进化,从来不在于上下文窗口里塞进了多少记忆,而在于它能否在充满噪声的现实交互中,精确识别出那些值得固化的行动锚点,并在新场景降临时,保持随时修正这些锚点的敏锐。