ForeWAM:不生成未来视频,如何让机器人决策拥有“预见力”?
Foresight Without Seeing: Latent Futures for World Action Models
给具身智能机器人装上“世界模型”,让它在行动前预判物理世界会发生什么,是当前具身决策领域最受关注的演进方向。然而,现有的世界动作模型(World Action Models, WAMs)正陷入两难境地:显式生成未来画面的方案需要在推理时运行多步视频去噪,计算延迟极高,且一旦生成的画面出现幻觉,动作就会变形;而跳过未来生成、直接输出动作的方案虽然高效,动作生成模块(Action DiT)却丢失了预见未来动态的显式通道。
ArXiv URL:https://arxiv.org/abs/2608.11605v1
来自南洋理工大学、上海交通大学与 ACE Robotics 的联合团队提出了 ForeWAM(Foresight-without-Seeing WAM)。这项研究的核心结论是:直接策略型的世界动作模型无需在部署阶段真正解码出任何一帧未来画面,就能让动作决策模块享受到高质量的世界动态预见能力。
该框架在仅使用轻量化 1.3B 视频底座、完全没有经过具身真实机器人数据预训练的条件下,在 LIBERO 基准上取得了 96.7% 的平均成功率,并在更严苛的扰动基准 LIBERO-Plus 上达到了 61.6% 的成功率。通过结合动作去噪蒸馏,其加速版本 ForeWAM-Flash 的动作生成延迟被压缩至 220 毫秒,在模型参数量仅为 Fast-WAM 约三分之一(2B vs 6B)的情况下,实现了速度与泛化能力的兼得。
具身控制的两难:要预测未来,就必须生成视频吗?
目前的视觉-语言-动作(VLA)模型本质上是在学习从静态观测到连续动作的反应式映射。当机器人执行抓取、推移、放置等涉及复杂接触的任务时,下一步的动作高度依赖于接触发生后物体会怎么动、场景状态会如何转移。这就是将视频生成与动作输出结合的 WAM 范式兴起的原因。
在已有的 WAM 架构中,主要存在三类路线:
-
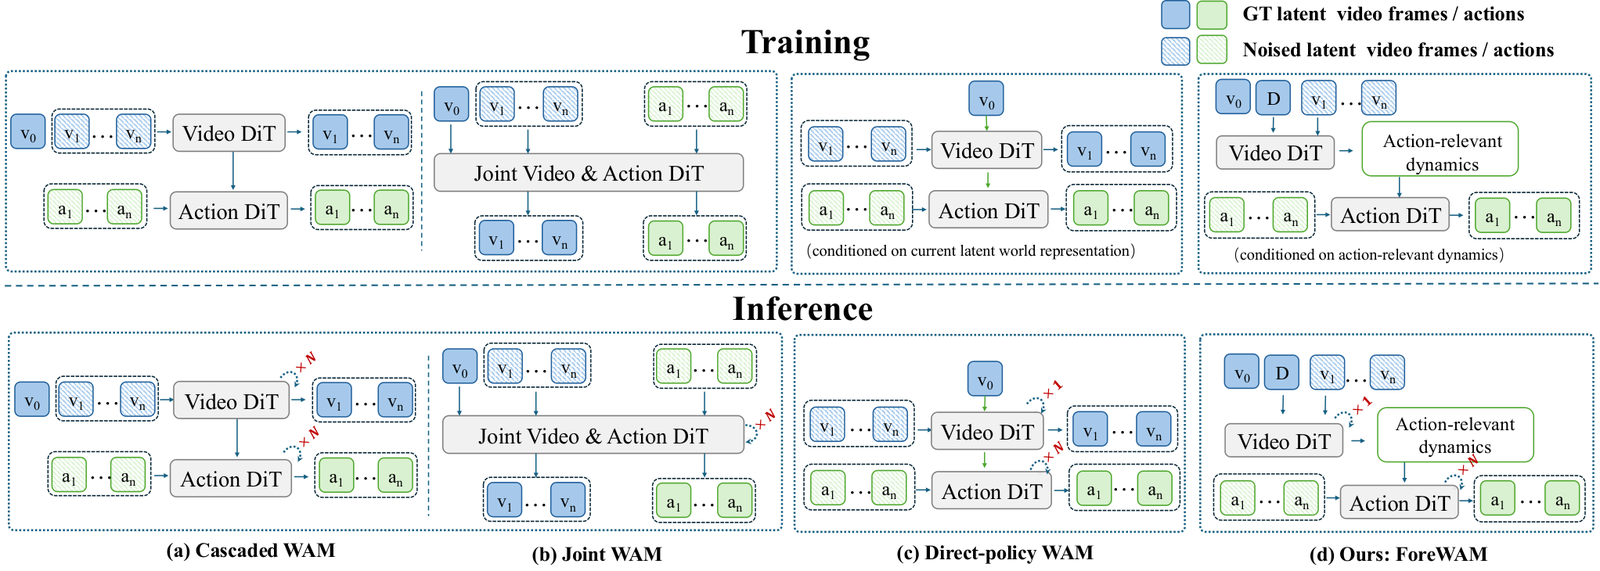
串联式(Cascaded WAMs):先“脑补”出未来的多帧视频,再基于生成的画面预测动作。
-
联合式(Joint WAMs):将未来视频潜空间与连续动作轨迹统一建模,在同一个去噪序列中共同演进。
-
直接策略式(Direct-policy WAMs):如 Fast-WAM,训练阶段利用视频目标学习未来动态,但在推理控制阶段直接从当前观测中推断动作,跳过视频生成。
前两类方案面临着难以逾越的推理开销:视频扩散模型需要多轮反向去噪,这使得机器人控制循环的延迟大幅攀升;此外,生成画面的像素级微小误差极易向动作空间级联放大。直接策略方案虽然砍掉了耗时巨大的视频去噪过程,却把动作去噪网络(Action DiT)退化成了一个仅能看着当前静态画面的普通策略网络,其底座内部学习到的世界推演能力很难直接穿透给动作分支。
ForeWAM 的核心切入点正是化解这一结构性矛盾:在完全不生成未来视频像素的前提下,如何在网络内部为动作去噪建立一条直达未来物理动态的快速通道?
ForeWAM 核心机制:隐式 Future-KV 与动态寄存器
为了同时获取视频底座表征的细粒度空间动态和针对物理交互的紧凑抽象,ForeWAM 提出了两条相互配合的内部信息路由路径。
1. Future-KV:单次前向完成的隐式未来推演
在推理控制阶段,ForeWAM 完全不进行迭代式的视频去噪。其动作预测过程如下:
-
模型保留当前观测图像的清晰潜变量 $z_{\mathrm{cur}}(o)$;
-
对于未来时间步的槽位,并不填充真实观测,而是初始化为纯高斯噪声 $\epsilon_{F}$,构成一个组合输入 $\widetilde{z}^{\mathrm{Fsub}}{1:T} = \operatorname{concat}(z{\mathrm{cur}}(o), \epsilon_{F})$;
-
将该输入与语言指令、机械臂自身本体状态一起,送入视频扩散模型(Video DiT)进行单次 Prefill(预填充计算)。
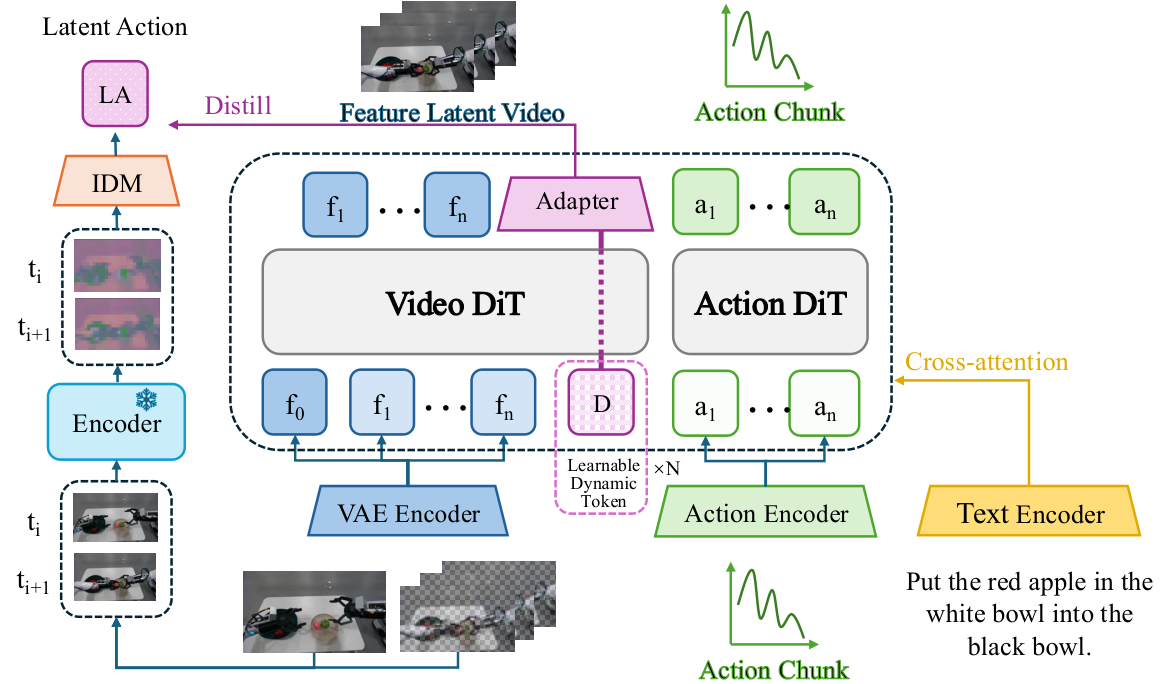
在这次单步前向传播中,模型记录并缓存 Video DiT 每一层的键(Key)和值(Value)状态,构成隐式缓存 $\mathcal{H}_{\mathrm{KV}}$。在随后的连续动作去噪过程中,Action DiT 每一层都通过交叉注意力直接复用这一套缓存。
这意味着,Action DiT 获取的不是经过反向去噪解码后昂贵的“显式像素序列”,而是 Video DiT 底座在面对未来随机槽位时、结合当前观测自然涌现出的“多层级隐式推演上下文”。整个推理过程没有像素反投影,也没有迭代循环,只消耗了一次前向 Prefill 计算。
2. 动态寄存器与潜动作监督:提炼交互层面的状态转移
仅靠通用的视频预训练损失,底座网络往往倾向于关注大背景的运动或低频纹理变化,而不一定能精准聚焦于机器人指尖的微小接触与物体滑移。
为了解决这一问题,ForeWAM 引入了一组可学习的动态寄存器(Dynamics Registers) $D = {D_i}{i=1}^{N_D}$。在训练阶段,团队引入了一个冻结参数的 LaWM(Latent Action World Model)逆动力学编码器作为教师模型。该教师模型读取机器人交互前后的真实视觉片段,提取出紧凑、非执行性的离散潜动作表征 $z{\mathrm{LA}}$。动态寄存器的池化输出通过一个投影头 $g_\psi$,直接去对齐该潜动作特征:
\[\mathcal{L}_{\mathrm{LA}}=\left\|g_{\psi}\!\left(\frac{1}{N_{D}}\sum_{i=1}^{N_{D}}D_{i}\right)-\operatorname{sg}(z_{\mathrm{LA}})\right\|_{2}^{2}\]需要强调的是,潜动作 $z_{\mathrm{LA}}$ 仅仅是对“物体移动了多少、接触状态如何变化、任务推进到了哪一步”的高维语义概括,它本身不可执行,也不是另一个动作解码器;教师模型和未来真实图像只在训练阶段存在,部署时两者完全被剥离。
动态寄存器在架构中充当了一个经过强监督的“状态转移信息瓶颈”,与提供分布式视觉细节的 Future-KV 缓存形成互补,共同作为 Action DiT 预测连续流动作时的全局上下文。
实验评测:不经具身预训练,表现究竟如何?
在具身操作的核心基准评测中,ForeWAM 展现了直接策略架构在效率和精度上的上限。
1. 标准 LIBERO 基准评测
在包含 Spatial、Object、Goal、Long 四大套件的经典 LIBERO 任务中,ForeWAM(基于 Wan2.1-T2V-1.3B 架构,总参数量约 2B)在完全未经过海量机器人多任务先验预训练的前提下,取得了 96.7% 的整体成功率,在 Long-horizon(长流程)任务中达到了 92.8%,Object 任务中达到了 99.6%。
采用 OneDP 技术将 10 步动作去噪蒸馏至 2 步的加速版本 ForeWAM-Flash,平均成功率依然稳定在 96.9%,相比标准版在各个子项上的差距最多不超过 0.8 个百分点。这一表现直接比肩并贴近了参数量达 6B、结构更为庞大的 Fast-WAM(97.6%)。
2. LIBERO-Plus 强扰动鲁棒性验证
真实世界的机器人控制面临光照变化、相机视角偏移、机械臂初始位姿偏差等多重不确定性。LIBERO-Plus 评测在 7 个维度上对场景施加了严重扰动。
在所观察的 LIBERO-Plus 评估子集下:
-
ForeWAM 取得了 61.6% 的综合成功率,比 Fast-WAM 报道的 51.5% 高出 10.1 个百分点。
-
加速版本 ForeWAM-Flash 取得了 58.2% 的成功率,同样显著优于 Fast-WAM(高出 6.7 个百分点)。
-
分解来看,ForeWAM 在相机视角扰动(Camera Viewpoint)下的成功率相比对比基线提升了 46.1 个百分点,在传感器噪声(Sensor Noise)下提升了 21.1 个百分点。
这表明,借助单次 Prefill 建立的未来隐式特征与动态寄存器,动作决策网络获得了远比单一当前帧特征更强的空间鲁棒性。
3. 部署延迟:从 667ms 到 220ms
在单张配备 80GB 显存的 NVIDIA A800 GPU 上,研究团队对独立的动作生成阶段延迟进行了精确测量:
-
Fast-WAM 的动作去噪延迟约为 667 毫秒;
-
标准版 ForeWAM 降至 568 毫秒(降低约 14.8%);
-
结合动作去噪蒸馏的 ForeWAM-Flash 进一步将单次动作生成的延迟拉低至 220 毫秒,相比 Fast-WAM 实现了 67.0% 的大幅缩减。
在机器人控制中,数百毫秒的延迟缩减直接决定了系统面对滑脱或外力扰动时能否做出实时动态闭环响应。
4. 关键消融:机制拆解
在 LIBERO-Plus 的同条件受控测试(各 1,482 次评估)中,消融实验揭示了两个核心组件的独立价值:
-
完整版 ForeWAM 取得 61.6%;
-
若仅保留 Future-KV 缓存通道、去除潜动作动态寄存器,成功率下滑至 58.5%;
-
若仅保留动态寄存器、去除 Future-KV 预填充缓存,成功率下滑至 58.0%;
-
作为对比参考,既没有 Future-KV 也没有潜动作监督的基线策略(Base Policy),其在相应分布下的表现为 53.6%。
这一结果验证了作者的初始判断:分布式未来视觉表征与高阶交互状态转移信息并不是互斥的,两者的结合才能为 Action DiT 构筑最稳固的“未来上下文”。
启示与边界
ForeWAM 展示了一种具身世界模型极具吸引力的新用法:让视频扩散模型退居幕后,只利用其内部注意力隐状态(KV 缓存)来为决策提供先验,彻底放弃费时且易错的显式生成。
当然,该研究目前也有明确的边界:评测集中在仿真环境 LIBERO 及其增强集 LIBERO-Plus 上,尚未覆盖真实实体机械臂的硬件扰动与更加杂乱的长程现实任务。同时,LIBERO-Plus 上的提升幅度具有任务敏感性——例如在机械臂初始位姿扰动下,模型的抗干扰表现依然面临挑战。
但 ForeWAM 指明的方向十分清晰:具身物理世界的“想象力”未必需要渲染成可见的画面,在网络隐空间中静默流淌的预测张量,同样能赋予机器人看穿物理因果、从容交互的“预见力”。