RIFT:告别耗时视频推演,单次前向生成未来Cache,延迟降低89%
Keep the Future, Drop the Rollout: RIFT for World Action Models
在具身智能与机器人操作领域,将未来视频预测与动作生成深度绑定的“世界动作模型”(World Action Models,简称 WAM)正逐渐成为前沿热点。这类模型的核心逻辑非常直观:让机器人先在脑海中“脑补”出未来的视觉画面,再以这些预测出的未来表征作为条件来规划当前的动作。在直觉上,能够洞见未来的机器人自然比只看当前帧的反应式策略更聪明、更鲁棒。
ArXiv URL:https://arxiv.org/abs/2608.11521v2
然而,这一范式在落地部署时撞上了一堵高墙——推演延迟(Rollout Latency)。为了让动作专家读取未来的视觉线索,模型往往需要在推理阶段执行数十步的视频去噪扩散过程(Rollout)。这使得世界动作模型的推理延迟往往达到纯当前帧策略(Current-only)的 3.3 倍到 9.6 倍,严重拖慢了机器人的闭环控制频率。为了提速,现有的折中方案往往选择在推理时直接砍掉未来分支(如 Fast-WAM),或者将未来的影响蒸馏进当前特征中(如 PFD)。但这些方法无一例外都在任务成功率上留下了遗憾。
这带来了一个根本性的科学疑问:动作生成到底必须依赖去噪轨迹中一步步演化的视频推演过程本身,还是仅仅需要推演最终留下的“未来表征”?
来自澳大利亚国立大学(ANU)的研究团队在最新论文中给出了清晰的答案。他们通过对底层注意力缓存的因果干预发现:动作专家对未来特征的内容和时空排布极度敏感,但根本不在乎这些特征是不是通过多步扩散推演出来的。基于此,研究团队提出了 RIFT(Rollout-free Imagination via Future Tokens)框架。RIFT 彻底摒弃了测试阶段迭代式的视频去噪,仅通过引入一组可学习的“前瞻 Token”(Anticipation Tokens),在一次骨干网络前向传播中就直接构建出完整的每层未来 Key/Value(K/V)缓存。
实验结果表明,在标准基准 LIBERO 的全部 40 项任务上,RIFT 取得了 98.8% 的整体成功率,超越了依赖多步视频推演的 Fast-WAM-Joint(98.4%)和 Fast-WAM-IDM(98.6%),同时将每个动作块(Action Chunk)的推理延迟大幅缩减 68.2% 至 89.1%,其耗时仅为纯当前帧策略的 1.1 倍。这项研究不仅解开了世界动作模型中“推演过程”与“表征消费”的长期混淆,更为高频、实时的具身智能世界模型部署开辟了全新的技术路径。
刨根问底:动作专家究竟在“读”未来的什么?
要打破高昂的推演成本,首先要弄清现有多步世界动作模型之所以有效的物理本质。以往的对比往往是将“带有推演的模型”直接与“完全不看未来的模型”做宏观的成功率对比,这把两件事搅在了一起:一是模型是否使用了未来表征,二是模型生成未来表征的推演过程是否必不可少。
为了解耦这两个因素,研究者将目光投向了动作专家读取视频信息的唯一物理通道——未来位置的 K/V 缓存(Future-position K/V Cache)。在基于 Transformer 的交叉注意力机制中,为了防止因果倒置,视频 Token 通常不能看到动作 Token,因此未来视频在各层生成的 Key 与 Value 是一个独立于动作去噪的纯净干预位点。
研究团队在 LIBERO 的 40 项任务中设计了一套配对闭环干预实验(Paired Closed-loop Intervention)。他们在统一初始状态和随机种子下运行未经修改的原始模型(Original),记录下动作去噪过程中调用的真实 K/V 缓存;随后在执行相同环境任务时,固定其他输入,精准干预未来缓存的读取接口,并通过两个指标量化动作的偏离:
-
末端执行器平均位移误差(EE-ADE):以厘米为单位,直接测量干预策略与原始策略在真实物理轨迹上的空间漂移;
-
任务成功率(SR):衡量物理漂移是否造成了任务失败。
基于这套严密的物理探针,研究人员得出了两项颠覆性的关键发现:
第一,动作专家对未来 Value 的时空组织极度敏感。
如果把未来读取通道彻底掩码(Masking),机器人的末端执行器轨迹平均漂移高达 $11.8$ 至 $20.4\text{ cm}$,成功率直接从接近满分的 $98.5\%$ 断崖式跌落至 $0.0\%$ 至 $32.0\%$。如果用保持范数匹配的随机高斯噪声替换,或者塞入当前帧的“静止未来”(Frozen-present),成功率同样暴跌至个位数。更耐人寻味的是位置置换实验:如果打乱同一帧内的空间 Token 顺序(Spatial Shuffle),或者交换不同时间步的未来帧(Temporal Swap),轨迹漂移都显著放大,成功率大打折扣。这证明动作专家绝不是把未来当成一个无序的语义提示词袋,而是在严格读取特定时空坐标上的未来演化信息。
第二,动作专家消费的是表征本身,而非动态的生成演化轨迹。
在像 Fast-WAM-Joint 这样的联合去噪模型中,未来视频和动作是一起逐步去噪的,这意味着未来 K/V 缓存在每一步去噪循环中都在动态变化。研究团队做了一个极其大胆的实验——最终纯净缓存回放(Final-clean Replay):他们不再让 K/V 缓存随着动作去噪步数逐步更新,而是在动作去噪的每一步,都直接复用最后那一步已经生成完毕的、无噪的最终 K/V 缓存。
结果极具启发性:在 Fast-WAM-Joint 和 Cosmos-2 模型上,使用这一固定不变的最终缓存,末端执行器的物理轨迹漂移仅为 $1.7$ 至 $1.9\text{ cm}$,最终任务成功率依然高达 $97.9\%$ 至 $98.2\%$,与原始复杂的多步动态缓存表现几乎完全一致。
这一发现正式将缓存的消费(Consumption)与缓存的生产(Production)剥离开来:动作端完全可以接受一个静态、固定的完整未来 K/V 缓存,只要这个缓存中承载的内容足够准确且时空对齐。传统方法之所以在推理阶段极慢,完全是因为“生产端”被困在多步扩散去噪的传统视频生成框架里。
RIFT 架构:单次前向直接生成未来表征
既然消费端只需要一个固定的优质 K/V 缓存,那么能否彻底抛弃多步扩散推演,用单次网络前向传播把这个缓存“写”出来?
这正是 RIFT(Rollout-free Imagination via Future Tokens)的核心构想。RIFT 保留了与成熟世界模型(如 Fast-WAM-Joint)完全相同的动作读取接口和网络主干,但在推理阶段删除了所有的未来潜变量噪声采样、去噪迭代和 VAE 视频图像解码。
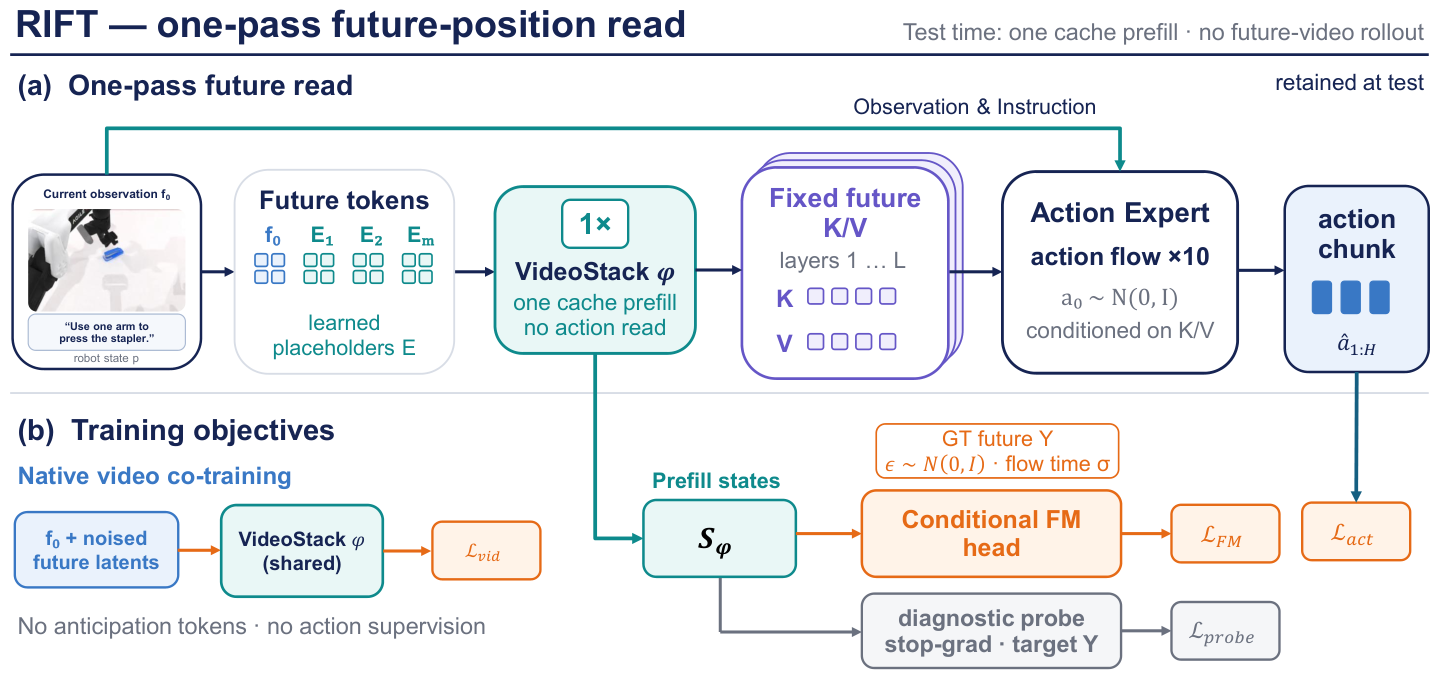
如上图所示,RIFT 的技术实现主要由两个紧密耦合的模块构成:
1. 前瞻 Token(Anticipation Tokens)与单次前向 Prefill
RIFT 在视频主干网络的输入端定义了一组可学习的参数化嵌入 $E \in \mathbb{R}^{m \times d}$,被称为前瞻 Token。这里的每一个 Token 都显式绑定了未来潜在视频帧中的特定时空索引。例如,在包含 $T_{\mathrm{lat}}$ 个潜在未来帧、每帧切分为 $n$ 个 Patch 的设置下,RIFT 设置了 $m = n(T_{\mathrm{lat}} - 1)$ 个 Token,与真实的未来潜在网格实现一对一完全对齐(在 LIBERO 上 $m=196$,在双臂平台 RoboTwin 2.0 上 $m=240$)。
在测试部署阶段,主干网络只需要执行一次单帧 Prefill:输入当前观察帧特征 $f_0(o)$、任务语言 $l$ 以及前瞻 Token $E$。网络通过前向计算,一次性输出所有层对应位置的未来 K/V 缓存:
\[\mathcal{C}_{\phi}(o, l) = \left\{ \left( K_{E}^{(\ell)}, V_{E}^{(\ell)} \right) \right\}_{\ell=1}^{L}\]动作专家在后续的动作流匹配去噪过程中,自始至终复用这套固定的 $\mathcal{C}_{\phi}$。这意味着测试期间完全没有未来视频的扩散循环,前向耗时几乎等同于普通的当前帧特征提取。
2. 条件流匹配(CFM)监督与多模态对齐
单次前向要生成具有前瞻性的有效缓存,训练阶段的监督目标至关重要。如果直接用均方误差(L2 Loss)强行让前瞻 Token 的输出状态回归到真实的未来特征,会触发经典的“多模态平均坍缩”:机器人在面对多种合理动作分支时,简单的 L2 回归会倾向于输出多种可能未来的加权平均,导致生成的表征模糊且不符合物理规律。
为了解决这一问题,RIFT 引入了条件流匹配(Conditional Flow Matching,简称 CFM)作为辅助训练目标。设前瞻 Token 经过主干网络演化后的最终隐状态为 $S_{\phi} \in \mathbb{R}^{m \times d}$,真实的未来潜在 Patch 为 $Y$。RIFT 将 $S_{\phi}$ 作为条件,训练一个轻量级的向量场网络 $v_{\psi}$,通过流匹配目标将高斯噪声推向真实的多模态未来分布:
\[\mathcal{L}_{\mathrm{FM}} = \mathbb{E}_{Y, \epsilon, \sigma} \left[ w_{\mathrm{vid}}(\sigma) \left\| v_{\psi}(X_{\sigma}, \sigma; S_{\phi}) - v_{\sigma}^{\star} \right\|_2^2 \right]\]这种分布级的监督信号迫使前瞻 Token 学会捕捉清晰、尖锐的多模态环境动态,同时避免了直接回归导致的表征平滑。
在训练时,RIFT 采用了精心设计的双前向传播机制:
-
原生视频监督前向:输入纯净首帧和带有噪声的真实未来潜变量,计算原生视频流损失 $\mathcal{L}_{\mathrm{vid}}$,保持模型对物理世界动态规律的基础感知;
-
部署匹配的前向:输入首帧与前瞻 Token $[f_0; E]$,计算动作损失 $\mathcal{L}{\mathrm{act}}$、上述条件流匹配损失 $\mathcal{L}{\mathrm{FM}}$,以及一个附带的停止梯度均方误差线性探针 $\mathcal{L}_{\mathrm{probe}}$。
至关重要的是,在训练完成后的部署阶段,辅助的 CFM 头部、线性探针、原生视频去噪头以及真实未来数据被全部剥离,仅保留下极简的单次 Prefill 和标准的动作生成流。
性能评测:毫秒级延迟下的断层式表现
为了验证 RIFT 能否在抹平推演延迟的同时保住世界模型的性能红利,研究人员在多个极具代表性的机器人基准上进行了系统性评测。
1. LIBERO 全套基准表现与推理延迟
在包含 Spatial、Object、Goal、Long 四大套件共 40 项任务的 LIBERO 基准中,评估统一基于 Wan2.2-5B 骨干网络在相同的数据和预算下展开。
数据展现出了压倒性的对比:
-
纯当前帧方案(Fast-WAM):动作生成延迟为 $235.7\text{ ms}$,但由于完全不看未来,任务成功率为 $96.8\%$;
-
推演型联合模型(Fast-WAM-Joint):借助 10 步未来视频去噪,成功率升至 $98.4\%$,但延迟暴增至 $782.9\text{ ms}$(当前帧的 $3.3\times$);
-
推演型逆动力学模型(Fast-WAM-IDM 与 LingBot-VA):成功率分别为 $98.6\%$ 和 $98.5\%$,然而动作块延迟分别高达 $1073.4\text{ ms}$($4.6\times$)和 $2261.2\text{ ms}$($9.6\times$);
-
RIFT:取得了所有评估方案中的最高成功率 $98.8\%$,而每个动作块的延迟仅需 $247.9\text{ ms}$。
与经典的推演型 WAM 相比,RIFT 在保住甚至微幅超越原版模型操作精度的同时,将生成延迟大幅削减了 68.2% 至 89.1%。其运行耗时仅为基准纯反应式策略的 1.1 倍,真正做到了“保留未来的视野,甩掉推演的累赘”。
2. 分布外鲁棒性:LIBERO-Plus
为了检验单次前瞻生成的缓存是否会因为场景微扰而崩溃,团队在包含视角变化、光照偏移、物体扰动等 $10,030$ 个变种的 LIBERO-Plus 分布外(OOD)基准上进行了零样本泛化测试。
在无需任何微调的前提下,RIFT 展现出了惊人的泛化适应能力:在全部 $10,030$ 个扰动场景中取得了 $81.1\%$ 的总成功率。这一成绩不仅大幅领先于 Fast-WAM($76.2\%$),更相较于复杂的推演型模型 Fast-WAM-IDM($71.4\%$)高出了整整 9.7 个百分点。这有力地反驳了“单次前瞻生成不如多步去噪推演鲁棒”的猜想,证明经过条件流匹配塑形的前瞻 Token 在特征空间中具备极高的抗扰动弹性。
3. 复杂双臂操作:RoboTwin 2.0
在更复杂的双臂协同仿真平台 RoboTwin 2.0(涵盖 50 项双臂任务)上,实验同样验证了 RIFT 的跨构型泛化能力。
在干净场景(Clean)和环境随机化场景(Randomized)下:
-
经过具身预训练的推演模型 LingBot-VA 成绩为 $92.4\% / 91.4\%$;
-
联合去噪的 Fast-WAM-Joint 为 $91.0\% / 91.1\%$;
-
蒸馏方案 PFD 为 $92.5\% / 92.1\%$;
-
RIFT 分别达到了 $92.9\%$ 和 $92.6\%$,再度位列所有评估方案之首。
无论是在单臂精细操作还是双臂协同任务中,单次前瞻构建的未来 K/V 缓存都完全经受住了闭环控制的考验。
思考与延伸:重新审视世界模型的具身角色
从认知与计算的角度来看,RIFT 的成功为具身世界模型领域提供了一次重要的认知纠偏。
在过去两年中,视频生成模型的惊人画质让机器人学术界产生了一种天然的路径依赖:人们潜意识里认为,机器人要具备世界模型的能力,就必须像 Sora 或 Runaway 那样,一帧一帧地把未来逼真的像素或潜空间视频扩散去噪出来。但对于底层的机器人控制器而言,它根本不需要去“欣赏”一段高分辨率的流畅视频;它所渴望的,仅仅是在时空注意力交互中,能够查询到未来可能发生的物理关键点和边界状态。
多步扩散推演对于人类观察者而言是不可或缺的渲染步骤,但对于策略网络内部的神经元表征而言,它可能只是巨大的计算冗余。RIFT 的价值不仅在于工程上的成倍提速,更在于它用干净利落的因果干预证明了:表征的充足性并不绑定于其生成历史。通过在前向通道中引入专门的前瞻表征容器,并配以分布式的生成目标进行约束,网络完全有能力在单次计算中内化环境的演化规律。
当世界动作模型的推理延迟被压缩到仅仅 240 毫秒、几乎逼近纯反应式网络时,高保真世界模型的实时闭环上机部署才真正从理论可能走向了工业工程的可行域。