清华提出IoA-Prober:不是真共识!用选择题场均揪出2.89个隐性分歧
Illusion of Alignment: Detecting Hidden Disagreement in Collaborative Dialogue
在团队协作或多智能体交互中,最致命的失败往往不是激烈的争吵,而是所有人都在点头。
ArXiv URL:https://arxiv.org/abs/2608.08210v1
在一次常规的项目交接中,技术主管对新来的工程师交代:“先去把 Torch 学明白,再来调试这个模块。”工程师爽快答应:“没问题,我这就去看。”一周之后,主管询问进度,发现模块完全无法运行——原来主管所指的是客户端遗留系统里基于 Lua 语言的初代 Torch,而工程师那一周废寝忘食钻研的,是当下主流的 Python 深度学习框架 PyTorch。在整个对话记录中,没有任何迟疑、没有否定词,也没有哪怕一句打断与修正。双方都以为彼此达成了完全一致的共识,直到最后的交付彻底脱轨。
清华大学团队在最新研究中将这种普遍却隐蔽的现象命名为对齐幻觉(Illusion of Alignment, 简称 IoA):协作对话在表面上达成了看似毫无破绽的共识,但参与者在核心目标、底层假设或具体执行方案上,依然保留着互不相容的分歧。
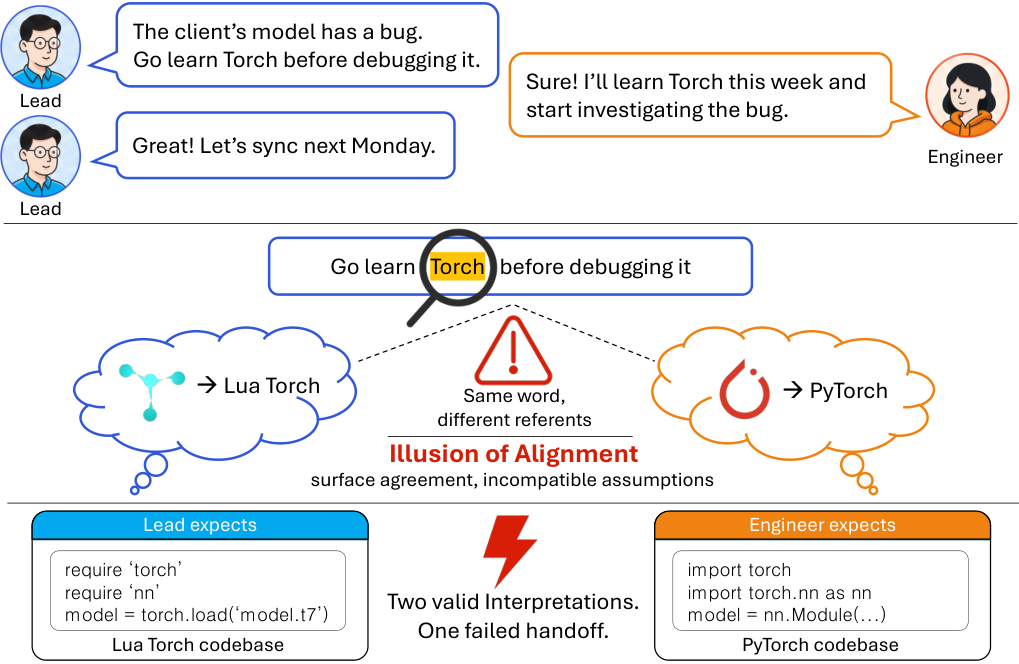
这项研究揭示了一个耐人寻味的悖论:如果对话双方意识到了分歧的存在,他们理应在对话中表达出来;而如果双方根本没有意识到彼此理解有偏差,即便事后追问“你们有什么分歧”,他们也无法用语言将其描述出来。这种不可见性让传统的对话分析方法和主流大语言模型统统失灵。为此,清华大学团队提出了一套全新检测框架,将隐性分歧的挖掘转化为诊断性多项选择题生成(Multiple-Choice Question Probing, MCQ Probing),并构建了基准数据集 IoA-Suite 与专用探测模型 IoA-Prober-8B。在 18 场真实人类会议的盲测中,该模型平均每场会议挖掘出 2.89 个此前从未被任何参会者提及的深层分歧。
为什么表面一致反而比公开争执更难捕捉?
在计算语言学和人机对话的研究脉络中,分歧检测从来都不是一个新课题。过去的研究通常聚焦于如何捕捉对话中的摩擦信号,例如语调的犹豫、肢体语言的回避、话语层面的修补(Repair),或者是明确的否定立场分类。这类研究成立的底层前提,在于分歧一定会以某种可被标注的形式在语料中留下“痕迹”。
然而,对齐幻觉从定义上就剥离了这些痕迹。正因为所有参与者都坚信大家已经达成一致,对话文本在表面上呈现出极高的对齐度。如果让常规大模型直接分析这段文本,模型唯一的合理推论就是“对话进行得非常顺利,双方没有异议”。
为了严谨刻画这种隐蔽状态,研究团队将协作对话中的参与者进行了形式化建模。假设存在 $n$ 个参与者 $P={p_1, \dots, p_n}$,每个参与者不仅拥有外部可观测的公开角色(Public Profile)$r_i$,还携带各自未曾明说的私有诉求(Private Agenda)$g_i$ 以及各自默认的隐性假设(Tacit Assumptions)$a_i$。在对话展开过程中,每个发言者基于自己的内心想法产生公开表述。对话结束后,每个人对“刚刚达成了什么共识、后续该怎么推进”会形成各自的认知构建(Post-dialogue Construal):
\[c_i(\iota) = \mathcal{C}(\iota;\, r_i, g_i, a_i, u(\tau))\]当且仅当存在议题 $\iota$,使得不同参与者在各自认知构建中产生实质冲突 $c_i(\iota) \neq c_j(\iota)$ 时,隐性分歧集合 $M(\tau)$ 就此诞生。
这不仅超出了常规文本分类的能力范畴,也让现有的心智理论(Theory of Mind, ToM)评测相形见绌。传统的心智理论基准测试(如经典的 Sally-Anne 实验或对话意图推断)大多遵循一个逻辑:评测系统预先知道要在哪个对话节点提问,并且存在一个客观世界的标准答案。但在对齐幻觉的场景中,根本没有人知道分歧藏在对话的哪句话之下,也不存在所谓的外部客观真理,评测面对的是两个或多个主体之间关于同一段语料的认知错位。
用选择题作为“探针”,把认知分歧转化为行为证据
面对这个近乎死结的隐蔽性悖论,研究人员转换了解决思路:既然文本本身没有记录分歧,参与者自己也说不清哪里不一致,那么就不要试图从文本中“抓现行”,而是去主动制造一种能够把分歧客观暴露出来的下游行为。
这套方法被确立为诊断性选择题探测机制(MCQ Probing)。探测模型并不需要像法官一样去直接宣判“某两人在某件事上存在分歧”,它的唯一任务,是扮演一个只拥有公开对话记录和发言者公开身份的外部观察者,针对对话中潜在的模糊地带,提炼出一组有针对性的单选题 $Q = {q_1, \dots, q_K}$。
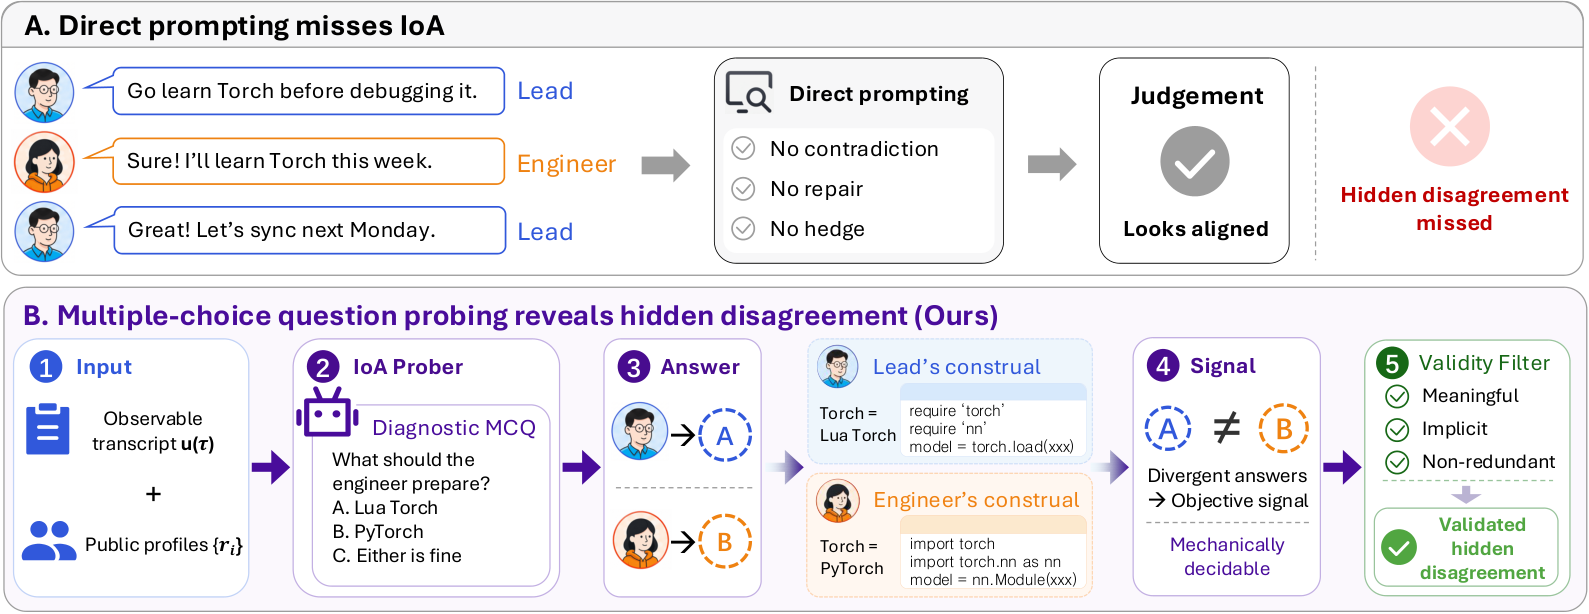
设计这种多项选择题的精妙之处在于“客观可判定性”。如果让参与者去回答开放性问答题,判定两个人回答是否冲突,不可避免地又需要依赖另一个语言模型或人工判断去语义比对,极易引入二次偏差与主观幻觉。而在封闭的单选题场景下,选项集合被严格固定,每个选项代表一种互斥的执行假设或认知倾向。
当参与者独立作答时,一旦参与者 $A$ 选择了选项甲,而参与者 $B$ 选择了选项乙,这种选项上的分离($c_i(q) \neq c_j(q)$)就构成了直接的、不可抵赖的行为分歧证据。检测系统完全绕开了“模型主观裁决”,将一个模糊的心理学悖论降维成了可机械化执行的布尔判定。
为了确保生成的问题不会变成无意义的文字游戏,评测流水线中还内嵌了一个严格的有效性过滤器(Validity Filter $\mathcal{V}$)。该过滤器自动审查产生分歧的问题是否满足三个硬性条件:
-
实质意义(Meaningfulness):选项的差异必须反映实际执行层面的认知鸿沟,而不是措辞细微差别的噪声;
-
内隐性(Implicitness):所提问题绝不能是对话中已经被公开讨论过的争执焦点;
-
非冗余性(Non-redundancy):不得与前面已经暴露过的问题重复。
只有同时满足这三点,这道问题所暴露的分歧才会被确认为真正的隐性对齐失败。
IoA-Suite:前沿大模型的共同滑铁卢
为了验证现有大模型在这一全新任务上的表现,研究团队构建了目前首个系统性基准 IoA-Suite。由于真实世界中的隐性分歧天然缺乏客观标注,团队采用了一种“逆向植入”的高质量合成方案:首先确定场景和特定隐性分歧 $M(\tau)$(其中强制包含至少一个定义层面的混淆点,即表面同名而私下指代不同的概念),随后在严格禁止显式争论该分歧的硬约束下生成长对话,确保分歧全程处于潜伏状态。
IoA-Suite 覆盖了协作动力学中的 5 类任务类型(规划、设计评审、故障排查、跨职能协调、头脑风暴),跨越机器学习研究、软件工程、跨学科科研、医学、商业和法律等 6 大高壁垒专业领域,包含 1,200 个训练对话、120 个验证对话与 300 个测试对话,并引入了跨模型家族重判和人类专家双盲质检。
在该基准上的全面评测带来了一个相当冷酷的结论:当前最顶尖的前沿大模型,在对齐幻觉检测任务上集体面临瓶颈。
在传统的“直接提示”(Direct Prompting,让模型直接列出对话里的隐性分歧)设定下,模型的整体表现堪称灾难。即便换上了团队提出的选择题探测机制(MCQ Probing),各家模型的检测能力虽然均获得了显著提升(平均 F1 提升了 13.5 个百分点),但性能天花板依然极低。在涵盖闭源与开源的 9 款主流前沿模型中,性能最高的模型最终得分也仅仅停留在 49.5% 的 F1 值上,无一能够跨过 50% 的及格线。
更值得注意的是,闭源顶级模型与开源模型之间的差距变得异乎寻常的微弱。例如,开源的 DeepSeek-V3.2 与闭源代表 GPT-5.4 之间的 F1 差距仅有 6.6%,远小于两者在传统复杂推理基准上的鸿沟。这强有力地说明:探测对齐幻觉并不是依靠通用的“扩充参数或堆叠推理步数”就能自然涌现的能力,现有的模型在缺乏专门建模心智推断机制的情况下,对这种潜伏在平静表象下的认知分流普遍缺乏警惕性。
不仅如此,不同模型家族在生成探测问题时展现出了完全割裂的策略倾向。GPT 系列模型偏好“大网捕鱼”,平均每个对话生成 5.8 道问题,虽然换取了相对更高的召回率(Recall),但大量问题缺乏区分度,导致精确度(Precision)严重下滑;而 Gemini 系列模型则高度保守,平均只提 3.5 到 3.8 个问题,精确度虽高,却漏掉了大部分潜在风险。仅靠 Prompt 工程,根本无法在这一任务中平衡提问质量与覆盖广度。
为了弄清楚这道天花板究竟因何形成,研究团队进行了一场精细的“信息消融实验”。他们为模型分别注入不同层级的上帝视角信息:参与者在对话每一轮的内心独白(Inner Thoughts $h_k$)、未言明的私有诉求与隐性假设($g_i, a_i$)。
实验给出了极为清晰的诊断信号:一旦将私有语境和内心独白直接展示给模型,模型的检测 F1 得分瞬间飙升至 70% 乃至 80% 以上。这充分证实,基准测试本身并没有设计过分苛刻的语法陷阱;模型的核心卡点,完完全全在于“如何仅从参与者公开说出的只言片语中,反向推演其背后未公开的心智模型”。
8B 小模型如何逆袭顶尖基线?
既然问题根源在于从公开文本反推私密心智的能力缺失,那么通过针对性强化学习来弥补这种推断能力便成为了破局关键。
研究团队以开源的 Qwen3-8B 为基座,开发了专用检测模型 IoA-Prober-8B。其训练过程分为紧密衔接的两个阶段:
在第一阶段,模型在经过筛选的高质量子集上进行监督微调(SFT)热身,重点学习什么样的选择题结构能够有效切中核心认知断层,同时过滤掉那些被验证机制拒绝的低信噪比问题。
进入第二阶段后,团队采用群组相对策略优化(GRPO)展开端到端强化学习:
\[\mathcal{J}_{\text{GRPO}}(\pi_{\theta}) = \mathbb{E}_{\tau \sim \mathcal{D},\, \{Q^j\}_{j=1}^G \sim \pi_{\theta}}\!\left[\frac{1}{G}\sum_{j=1}^G A_j \log \pi_{\theta}(Q^j \mid \tau)\right]\]在强化学习循环中,环境直接根据整套问题在验证流水线中跑出的端到端 F1 值计算优势度(Advantage $A_j$)。这种奖励设计直接倒逼模型学会自我博弈与收敛:既不能为了盲目冲高召回率而海量抛出无关问题,也不能为了自保而过度缩减提问量。
训练带来的性能提升是非常直接的。从 Qwen3-8B 初始状态下贫弱的 28.0% F1 起步,IoA-Prober-8B 最终冲上了 51.8% F1,实现了 23.8 个百分点的绝对增长,不仅大幅超越了 Gemini-3.1-Pro Preview 等大体量模型,甚至超越了 GPT-5.4 取得的 49.5% 顶尖成绩。
深入分析其表现可以发现,经过 GRPO 调优后的 8B 模型展现出了极佳的提问克制力与精准度,实现了 50.5% 精确率与 53.9% 召回率的均衡结构。如果以完全暴露私有语境的“先知上限”(Oracle Ceiling,Qwen3-8B 在该状态下为 76.4% F1)为基准线,这次专门训练成功将仅凭公开信息到先知上限之间的信息鸿沟抹平了将近一半(差距从原本的 48.4% 缩减到了 24.6%)。这意味着,即使只有 8B 参数,模型也切实学会了如何根据角色画像与历史语境,在潜意识层面重塑不同参与者的心智轨迹。
走出实验室:18 场真实人类会议的盲测检验
在实验室基准之外,对齐幻觉在真实人类日常协作中究竟有多严重?经过合成数据调优的探测模型,能否无缝迁移到嘈杂、非结构化的人类真实交谈中?
为了回答这两个现实问题,研究团队深入真实组织场景,采集了 18 场涵盖不同专业背景的真实线下工作会议录音转录本,涉及 43 位具有真实协作关系的职场与科研参会者。在会议自然结束且所有人均认为“讨论顺利完成”后,评测流水线启动:Qwen3-8B 基线、GPT-5.4 以及 IoA-Prober-8B 在完全盲测的状态下,针对每场会议各生成一套诊断选择题。
会后,43 位参会人员被要求独立完成这些选择题作答,并在答题完毕后进行第二轮盲审交叉校验。只有当两名参会者的选项出现实质分歧,且两人随后在复盘中一致确认“我们在会上的确没意识到彼此想的不一样,而且这个分歧会对后续执行造成实际困扰”时,才会被计为一个被成功验证的隐性分歧(Validated Hidden Disagreement)。
盲测结果展现了极具冲击力的数据:
-
真实人类协作中的隐性分歧极其高频。在整整 18 场参会者自认为“达成共识”的会议中,系统平均每场会议挖掘出了 2.89 个此前完全没有被说出口的深层分歧。在后续的问卷调查中,大量参会者表示这些被挑明的分歧“拯救了后续几个星期的错误推进”。
-
在探测效果上,IoA-Prober-8B 表现出了出色的跨域泛化能力。在有效隐性分歧的挑出数量上,经过专项训练的 8B 模型不仅完胜未调优的基座,而且超越了参数规模大出数个数量级的 GPT-5.4。参会者在事后对不同模型生成题目的“最佳探测集”盲投票中,IoA-Prober-8B 也赢得了最高比例的赞同票。
除了解决人类会议中的沟通损耗,这项技术同样在多智能体系统(Multi-Agent Systems)中展现了巨大的应用潜力。在以往构建由多个 LLM Agent 协同写代码、做系统设计的复杂管线时,开发者经常遭遇“Agent 互相吹捧并给出虚假确认,最终导致代码无法编译”的问题。研究团队将 IoA-Prober 接入多 Agent 协作回路,在复杂的编码基准 BigCodeBench-Hard 和交互式基准 HiddenBench 上,探测器成功在 Agent 宣布完工之前拦截了多次底层逻辑脱节,显著提升了下游任务的执行成功率。
从宏观视角审视,这项研究的突破不仅在于训练出了一个更聪明的 8B 探测模型,更在于它精准指出了当前多模态、对话式 AI 研究中的一大认知盲区。过去很长一段时间,学术界习惯于把“理解对话”等同于“理解文本字面意思”。但真实的协作从来都不是字面符号的简单交换,而是多方在各自封闭心智模型驱动下的博弈与妥协。
当人工智能开始从单纯的信息检索工具转向深度参与人类组织协作的协作者、观察者乃至管理者时,不仅要学会听懂对方“说了什么”,更要能够洞察在那些看似祥和的“好的”、“明白”背后,对方究竟“漏掉了什么”。清华团队通过选择题探针这一极度巧思的机制,将心理学与管理学中悬浮的认知概念,成功落地为了一个在工程上可闭环、在数学上可计算、在商业上具有极高止损价值的技术方案。