Hugin:突破多视角协同规划瓶颈,Qwen3-VL分拣准确率从63.6%提升至78.8%
HUGIN: Enhancing Vision-Language Planning for Autonomous Logistics Sorting
在具身智能(Embodied AI)的研究与工业落地中,机器人对操作环境的感知与规划大多被简化在“单一视角”或“连续重叠视场”的理想假设下。无论是安装在机械臂末端的眼在手(Eye-in-Hand)相机,还是固定在操作台上方的广角全局镜头,模型通常只需要关注同一个连续物理空间内的物体。
ArXiv URL:https://arxiv.org/abs/2608.11692v1
然而,真实的现代工业场景往往并非如此简单。在占地约 70 平方米的自主物流分拣系统(Autonomous Logistics Sorting System, ALSS)中,环境不仅高度动态,物理空间更是被严格划分为多个功能区域。全局相机受限于分辨率,无法捕捉微小包裹上的条码与精细边缘;末端相机虽然细节丰富,却只能管窥局部,无法预知其他货格与目的笼车的即时容量。为此,工业界通常在供包货格、缓存区、不同流向的笼车上方部署多台独立相机。这些相机的视场(Field-of-View)在物理空间上互不重叠,但机械臂的下一步动作决策却同时依赖于这多路相机的实时状态。
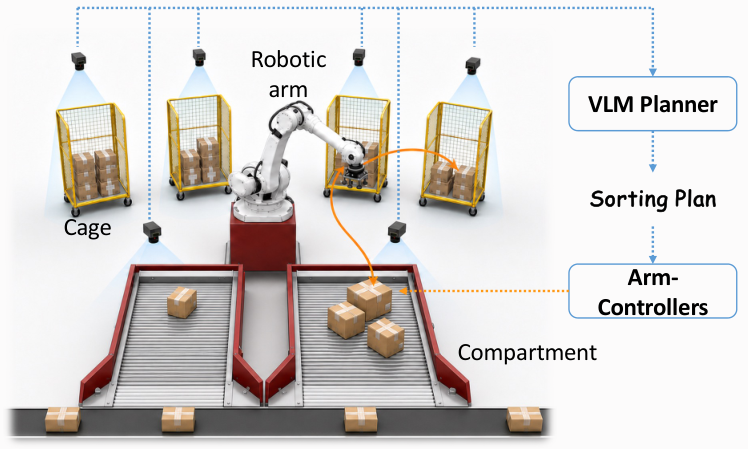
针对这一工业痛点,哈尔滨工业大学、京东物流、西北工业大学与清华大学的研究团队在一项联合工作中,将这一任务抽象为联合多场景理解(Joint Multi-Scene Understanding, JMSU)。为了让视觉语言大模型(VLM)真正具备统揽全局的工业级规划能力,研究者提出了名为 Hugin 的全流程优化训练框架,并构建了涵盖四种工业真实布局的基准测试集 SortingBench。
实验结果表明,Hugin 在多个开源大模型基座上均取得了显著提升。其中,在 Qwen3-VL-8B 上的端到端规划准确率直接从基线的 63.6% 跃升至 78.8%。不仅如此,该方案在真实物流枢纽中经受住了超过 15,000 件非标包裹的实际分拣考验,验证了 VLM 充当复杂工业级任务规划大脑的可行性。
工业分拣的核心症结:何为 JMSU?
在讨论技术创新之前,有必要先明确自动化物流分拣面临的底层挑战。一个标准的 ALSS 工作站由供包货格、机械臂底座、多个目标分拣笼车以及分布在各区域的传感器组成。系统运行的核心业务逻辑有着严格的约束:机械臂必须优先从堆积包裹最多的货格中取件;在同一货格内,要遵循先进先出(FIFO)原则,优先抓取最靠近出料口的包裹;而在放置阶段,系统必须动态评估各个笼车的剩余容量,优先将包裹堆叠到当前最空闲的笼车中以实现负载均衡。
这一整套流程将感知与规划死死绑定在多个离散视角之上。研究团队将 JMSU 的特性形式化为两个数学条件:
其一是空间离散性(Spatial Distribution)。设 $\mathcal{I} = {I_1, \ldots, I_N}$ 为同步采集的一组多相机观测图像,任意两张图像对应的物理视场空间映射 $\mathcal{P}(I_i)$ 与 $\mathcal{P}(I_j)$ 之间的交并比(IoU)接近于零,即 $\mu(\mathcal{P}(I_i), \mathcal{P}(I_j)) \leq \epsilon$(其中 $0 \le \epsilon \ll 1$)。这意味着模型无法像做三维点云拼图那样,通过视觉特征重叠来拼接全景。
其二是决策层面的强相互依赖(Decision-level Interdependency)。在给定的多路画面中,存在一个核心最小充分观测集 $\mathcal{I}^* \subseteq \mathcal{I}$。仅当给全这批核心视角时,任务决策 $\mathcal{Y}$ 的条件熵才趋近于零($H(\mathcal{Y} \mid \mathcal{I}^, \mathcal{T}) \leq \delta$);而一旦丢弃其中任意一个有效视角,哪怕只剩一个真子集 $\mathcal{S} \subsetneq \mathcal{I}^$,决策的不确定性也会呈断崖式上升($H(\mathcal{Y} \mid \mathcal{S}, \mathcal{T}) \ge \gamma > \delta$)。
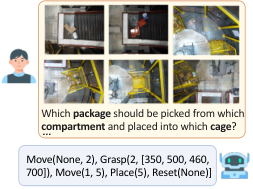
现有的多模态大模型面对这种场景往往暴露出两大致命缺陷:
-
数据密度极低且跨场景标注昂贵:通用 VLM 绝大多数是在网络公开图文对上预训练的,极度缺乏多视角工业状态与机械臂动作对齐的数据。流水线虽然能产生海量原始视频流,但标注一个包含“货格识别-抓取位姿估计-空闲笼车决策”的完整链条成本奇高,常规的单图裁剪、色彩抖动等数据增强方式又极易破坏跨视角的物理逻辑一致性。
-
超长多图上下文下的注意力涣散:在当前的自回归 Decoder-only 架构中,多张高分辨率视角的视觉 Token 按顺序被串联在上下文开头。随着视觉序列大幅拉长,模型自注意力机制往往聚焦于局部的某些显眼视线前缀,导致“顾头不顾尾”,难以对全部关键视角进行统一表征整合。
内生数据增强:在物理约束下重组“原子事实”
为解决高质量跨视角监督信号匮乏的问题,Hugin 提出了内生数据增强(Endogenous Data Augmentation, EDA)。
传统的多模态合成方式大多借助大语言模型进行思维链(CoT)扩写,但在缺乏严格工业先验的条件下,外部模型生成的内容极易发生物理幻觉;纯文本扰动又无法提升视觉信息的特征密度。EDA 选择不依赖外部生成器,而是深挖已有标注数据内部的内在组合潜力。
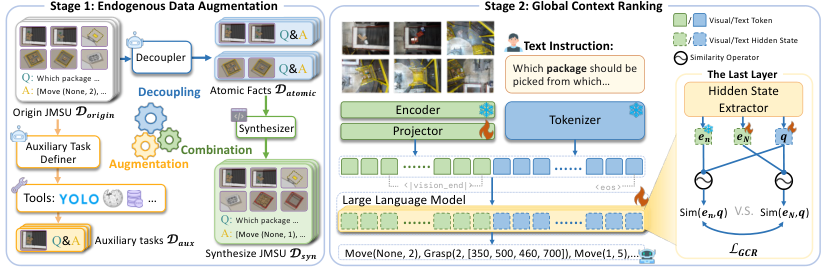
EDA 将一个复杂的 JMSU 样本拆解为若干个在物理世界中已得到验证的“原子事实”(Atomic Facts)。例如:某相机的画面对应“货格 A 包含 3 件包裹”、“包裹 $k$ 距离出口最近且边界框为 $B$”、“笼车 C 当前填充率约为 40%”等。随后,算法利用受控的置换与组合机制,在满足 ALSS 运营逻辑的前提下,把这些原子状态拼装成全新的多图训练样本。
如图所示,EDA 将原始数据扩充为包含具身规划样本(包含原子任务、合成多视角任务与辅助感知任务)与通用问答(VQA)样本的混合训练流。这种方式不仅在多项式级别放大了有效训练集的多样性,更关键的是完全维持了跨视角空间对应、物理状态以及最终动作序列标签之间的严格因果逻辑,规避了由于随意拼接图像导致的标签污染问题。
全局上下文排序:拉紧指令与完整视域的表征纽带
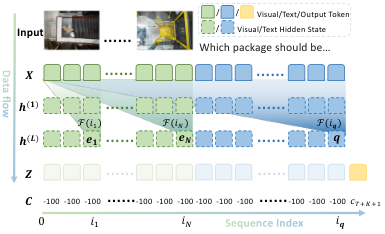
光有高质量数据还不够,必须从模型表征层面迫使模型“看完所有相关画面再做决定”。为此,研究团队设计了全局上下文排序(Global Context Ranking, GCR)这一辅助训练目标。
在 Decoder-only 架构中,多张图像被依次排布,每一张图像序列的结尾都带有一个专用的标识符 <|vision_end|>。设这些视觉结束标识符对应的隐层状态为 $e_1, e_2, \ldots, e_N$。因果注意力的聚合特性决定了,靠后出现的视觉隐层状态汇聚了更多前文视觉信息,其中最后一个视觉标识符 $e_N$ 理论上蕴含了完整的全局视域特征,而前文的 $e_n$($n < N$)仅代表局部的部分视角信息。
如果仅使用标准的自回归交叉熵损失(Next-token Prediction),模型往往会取巧,在尚未充分整合 $e_N$ 的情况下就根据某几张局部画面的先验启动解码。GCR 则引入了一个三元组排序损失,将经过投影归一化后的文本指令隐层表征 $q$ 作为锚点,强制约束指令表示与全局完整视觉特征 $\tilde{e}_N$ 的相似度,必须高于它与任意局部视觉特征 $\tilde{e}_n$ 的相似度,且保持预设的间隔裕量 $\alpha$:
\[\mathcal{L}_{GCR} = \mathbb{E}_{n \sim \mathcal{U}\{1, N-1\}} \big[\max\left(0, \alpha + \mathcal{SG}(\tilde{e}_n)^\top \tilde{q} - \tilde{e}_N^\top \tilde{q}\right)\big]\]其中 $\mathcal{SG}(\cdot)$ 为停止梯度算子。整体训练目标函数被定义为:
\[\mathcal{L}_{total} = \mathcal{L}_{CE} + \lambda \cdot \mathbb{I}(N \ge 2) \cdot \mathcal{L}_{GCR}\]这里的指示函数 $\mathbb{I}(N \ge 2)$ 确保了该排序损失只在真正的多图输入样本上激活。
这一设计精妙之处在于两点:其一,它直接重用了大模型本身的隐层特征,不引入任何额外的参数模块或复杂的跨注意力架构;其二,GCR 纯粹作为训练阶段的正则化手段存在,在实际部署推理时完全剥离,因此不会给在线推理带来哪怕一毫秒的额外延迟,保持了基座模型原汁原味的计算效率与通用接口。
实验评测:从必要视角干预到 15,000 件实战验证
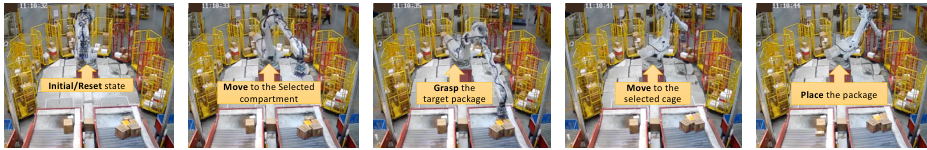
为了系统检验 JMSU 规划的有效性,研究团队花费 3 个月时间在 4 种实际物流工位布局下采集并标注了 SortingBench 数据集。评测指标极为严苛:只有当模型预测出的完整动作序列(移动、抓取、放置、复位)完全匹配,且抓取边界框的交并比达标时,才判定该样本执行成功。
1. 核心视角干预实验
为了证明 JMSU 的决策依赖确实立足于多图协同而非数据泄露,研究人员进行了“关键视角移除实验”。在基准场景中,如果决策核心依赖于 4 到 5 个视角中的 2 个关键视图,随机遮盖一个输入视角,理论保留的成功率期望应在原成功率的 $[50\%, 60\%]$ 区间内。
实测数据显示:未经优化的标准微调模型(SFT)成功率从 63.6% 骤降至 35.6%(理论区间 $[31.8\%, 38.2\%]$);采用 Hugin 优化的模型则从 78.8% 跌落至 41.6%(理论区间 $[39.4\%, 47.3\%]$)。两个模型在剔除视角的干预下,衰减比例与数学理论预期吻合。这直接证实了:模型的规划行为是在真正聚合跨视角依据,而不是在靠单一主视角的先验死记硬背。
2. 消融分析与泛化能力迁移
在针对 Qwen3-VL-8B-Instruct 的消融实验中,各模块的价值得到了充分量化:
| 模型配置 | SortingBench 准确率 | BLINK/VS (多视角对比) | MME (通用基准) |
|---|---|---|---|
| Qwen3-VL-8B-Instruct (原版基线) | 63.6% | 75.6% | 1699 |
| + 仅微调原始数据 (SFT) | 63.6% | 77.2% | 1682 |
| + SFT + GCR (不加数据增强) | 68.8% | 84.3% | 1705 |
| + Hugin (完整版: EDA + GCR) | 78.8% | 88.2% | 1743 |
| - 移除具身增强数据 $\mathcal{D}_{emb}$ | 73.3% | 79.5% | 1718 |
| - 移除通用正则数据 $\mathcal{D}_{general}$ | 78.4% | 87.1% | 1661 |
消融数据揭示出两个关键技术取舍:
首先,具身数据与通用数据存在精妙的协同效应。若去除 EDA 产出的具身数据 $\mathcal{D}{emb}$,SortingBench 准确率直接下跌 5.5 个百分点,表明仅凭工业原始数据很难提供足够的特征密度;但若彻底摒弃通用 VQA 数据 $\mathcal{D}{general}$,虽然分拣任务本身仍能保持 78.4% 的高分,通用多模态能力(如 MME 得分)却会出现灾难性遗忘。通用数据在此处充当了防退化的锚点。
其次,GCR 机制不仅在分拣任务上带来了净收益,更在通用跨图推理基准(如 BLINK/VS 提升至 88.2%)上展现了强大的正向外溢效应。这说明强制全局上下文对齐不仅没有让模型陷入工业过拟合,反而显著增强了 VLM 底层的多图语义关联与对比推理能力。
3. 真实工业部署验证
实验室环境跑通并不等于工程可用。在配备 2 个货格、10 个目的笼车的实际 ALSS 分拣站中,搭载 Hugin 框架的 Qwen3-VL-8B 模型完成了超过 15,000 件非标包裹的连续在线分拣测试,真实环境下的一次性端到端规划准确率稳定在 73.1%。在高强度包裹反光、非均匀照明、异形件遮挡以及相机外参微小漂移的真实工业噪点下,模型展现出了强大的鲁棒性。
工业具身多模态的新范式
长期以来,工业分拣与上下料自动化严重依赖于定制化的传统机器视觉算法配合复杂的 PLC 状态机。这类系统面对规则变化极其脆弱,一旦引入新的货格规格或动态调度逻辑,整套算法往往需要重构。
Hugin 与 JMSU 概念的提出,为复杂工业场景下部署视觉语言模型提供了新路径。它表明,VLM 在工业自动化中不应仅仅被视作一个“开放词表的目标检测器”,而是可以胜任统一的多机位时空规划中枢。通过在训练阶段使用受物理规律约束的内生增强手段,以及用零推理代价的表征排序拉平长文本多图的注意力偏差,大模型不仅能理解多眼分布的现实世界,更能以纯语言接口稳定驱动底层的运动控制原语。这项研究展示了前沿多模态大模型从“能看图对话”走向“能管整座车间”的关键一步。