GraphThink:引入双图先验,具身长程规划成功率达到90%
GraphThink: Graph-Enhanced LLM Thinking for Long-Horizon Embodied Task Planning
在大模型驱动具身智能(Embodied AI)执行家庭日常任务的研究中,长程任务规划(Long-Horizon Task Planning)始终是一个瓶颈。当人类给出一句抽象指令(例如“把热好的切片面包放到餐桌上”)时,智能体需要自行拆解为包含导航、寻找物品、交互、改变物体状态等长达十几个甚至数十个步骤的子任务序列。
ArXiv URL:https://arxiv.org/abs/2608.07905v1
然而,直接让通用大语言模型(LLM)充当高级规划器,常常会出现严重的“物理幻觉”:智能体可能会规划出“在拿起刀之前先切面包”、“穿过闭合的柜门取物”等脱离物理现实的操作;更为棘手的是,传统监督微调(SFT)训练出的规划模型泛化能力薄弱,一旦任务步数拉长或环境稍作变动,错误便会层层累积。同时,开环执行的智能体对动态环境缺乏感知,无法识别语义偏差并在执行中及时纠偏。
针对这一系列痛点,来自北京智源人工智能研究院、清华大学、中国人民大学、香港理工大学等机构的研究团队提出了 GraphThink 框架。该研究的核心洞察在于:不能把长程规划完全寄托于大模型的自由文本生成,而是应当在任务逻辑与物理环境之间构建结构化的约束网络。GraphThink 创新性地引入了“双图”协同机制——利用任务图(Task Graph)约束动作前置依赖并辅助强化学习训练,利用场景图(Scene Graph)维持轻量级环境动态记忆并驱动闭环重规划。在 ALFRED 基准测试中,GraphThink 在未见测试集(Unseen Test)上取得了 67.71% 的成功率,领先此前业界最佳水平 6.17 个百分点;更关键的是,在长程任务规划评测中,相较于同底座下传统 SFT 方案暴跌至 20.57% 的惨状,GraphThink 实现了高达 90.04% 的规划成功率。
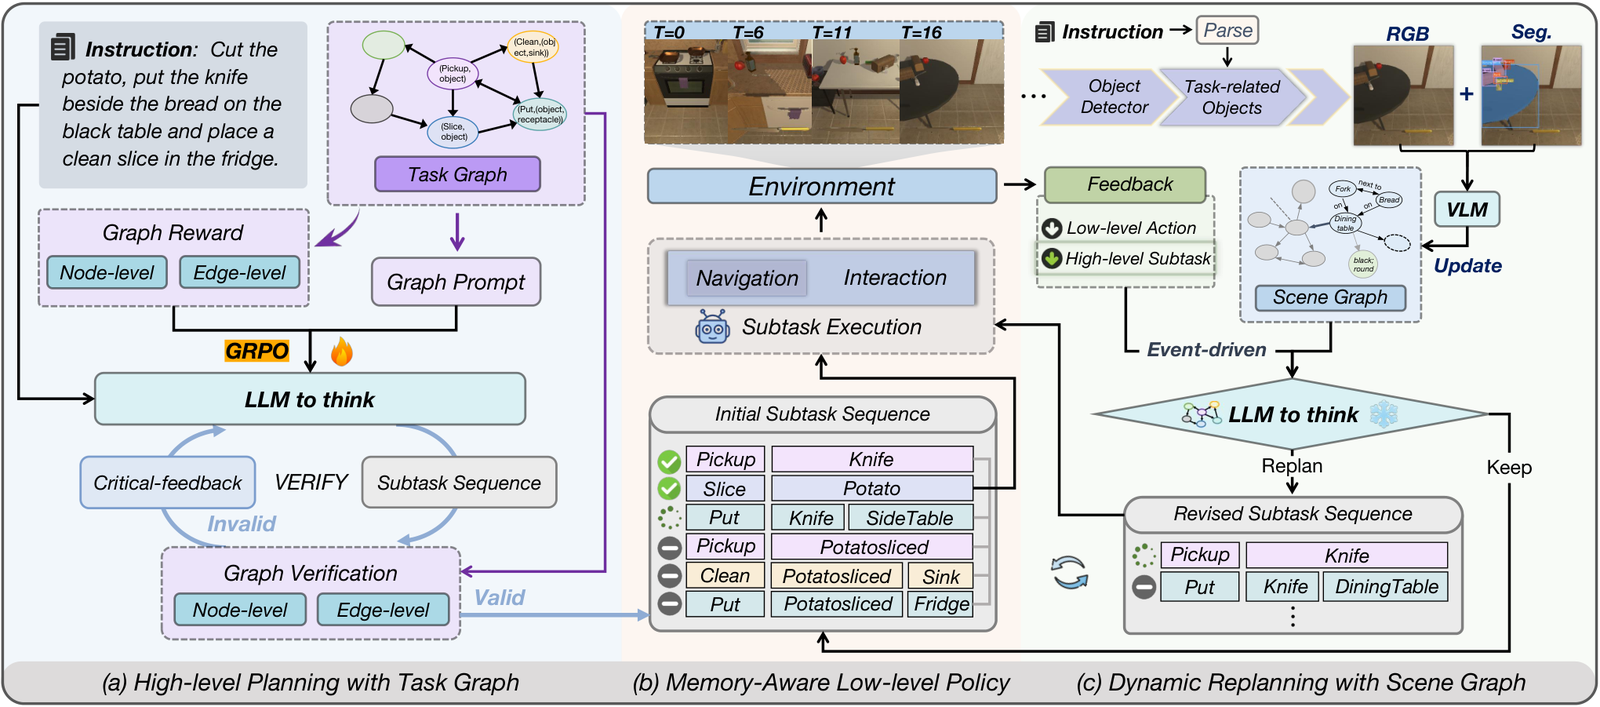
物理约束从何而来:任务图的多阶段注入
传统端到端的分层具身系统通常由高级规划器拆解子任务,再交由底层技能库执行。但由于自然语言空间的离散与发散,模型经常给出不可行的子任务组合。为了让规划器在物理世界中“脚踏实地”,GraphThink 构建了有向任务图 $\mathcal{G}=(\mathcal{V},\mathcal{E})$。
在任务图中,节点 $\mathcal{V}={v_i}_{i=1}^N$ 代表环境支持的元子任务(如拿起物品、加热、切片等),有向边 $(v_i, v_j)\in\mathcal{E}$ 则表征了动作之间的物理可行性流转规则。例如,只有完成了对刀具的拿起动作,后续才能转移到切片子任务。这种图结构并非死记硬背训练轨迹,而是对动作空间物理前置条件的可扩展抽象。当引入新技能时,研究人员仅需根据转移相容性拓展节点和边,无需重新采集海量专家轨迹。
任务图在 GraphThink 中并不是一个简单的后验过滤规则,而是纵贯了高级规划模型的提示工程、强化学习和推理验证全流程:
首先,在提示阶段,环境可见的目标物体集合 $\mathcal{O}_{\text{env}}$ 与任务图的拓扑关系被转化为符号化连接形式注入系统提示词。模型被明确约束在图拓扑的邻近节点间进行下一步推演,从而在生成源头截断天马行空的幻觉。
其次,也是 GraphThink 最具特色的设计,研究团队将任务图引入了组相对策略优化(GRPO)强化学习框架。在具身规划中,一条自然语言指令往往对应多种合法的子任务执行路径,强行用单一标注数据进行模仿学习会导致严重的过拟合。GRPO 框架通过规则驱动的奖励引导模型探索,整体奖励设计如下:
\[R_{\text{total}} = R_{\text{fmt}} + R_{\text{node}} + R_{\text{edge}} + R_{\text{inst}}\]其中,$R_{\text{fmt}}$ 确保输出符合 XML 思考标签与合法的 JSON 格式;$R_{\text{node}}$ 衡量规划中涉及的交互实体是否确实存在于环境检测集合中;$R_{\text{edge}}$ 则是强结构的布尔连乘奖励,检验整条规划路径是否严格构成了任务图中的连通路径:
\[\textstyle R_{\text{edge}}=\prod_{1\leq t\leq T-1}\mathbb{I}(s_t,s_{t+1}\in\mathcal{V})\cdot\mathbb{I}((s_t,s_{t+1})\in\mathcal{E})\]为了避免模型产生“虽然每一步都合法、但完全偏离人类指令”的奖励欺骗(Reward Hacking),$R_{\text{inst}}$ 作为语义软约束加入,使得强化学习既鼓励在可行任务图空间中灵活探索,又牢牢锚定指令目标。最后,在推理阶段,任务图充当轻量级外部验证器(Verifier),一旦检测到残存的非法转移,便触发至多 3 轮的反馈修正循环,筑牢逻辑防线。
告别遗忘:具身底层的对象主动缓存
即使高级规划给出了完美的步骤,如果底层的导航和操作策略缺乏对环境细节的记忆,长程任务依然极易崩溃。在典型的多物体交互任务(例如“清洗两只玻璃瓶并摆放到架子上”)中,现有智能体往往在处理完第一个物体后,就把之前探索过程中路过的第二个物体忘得一干二净,导致耗费大量步数重复巡检,甚至在重复放置时产生混淆。
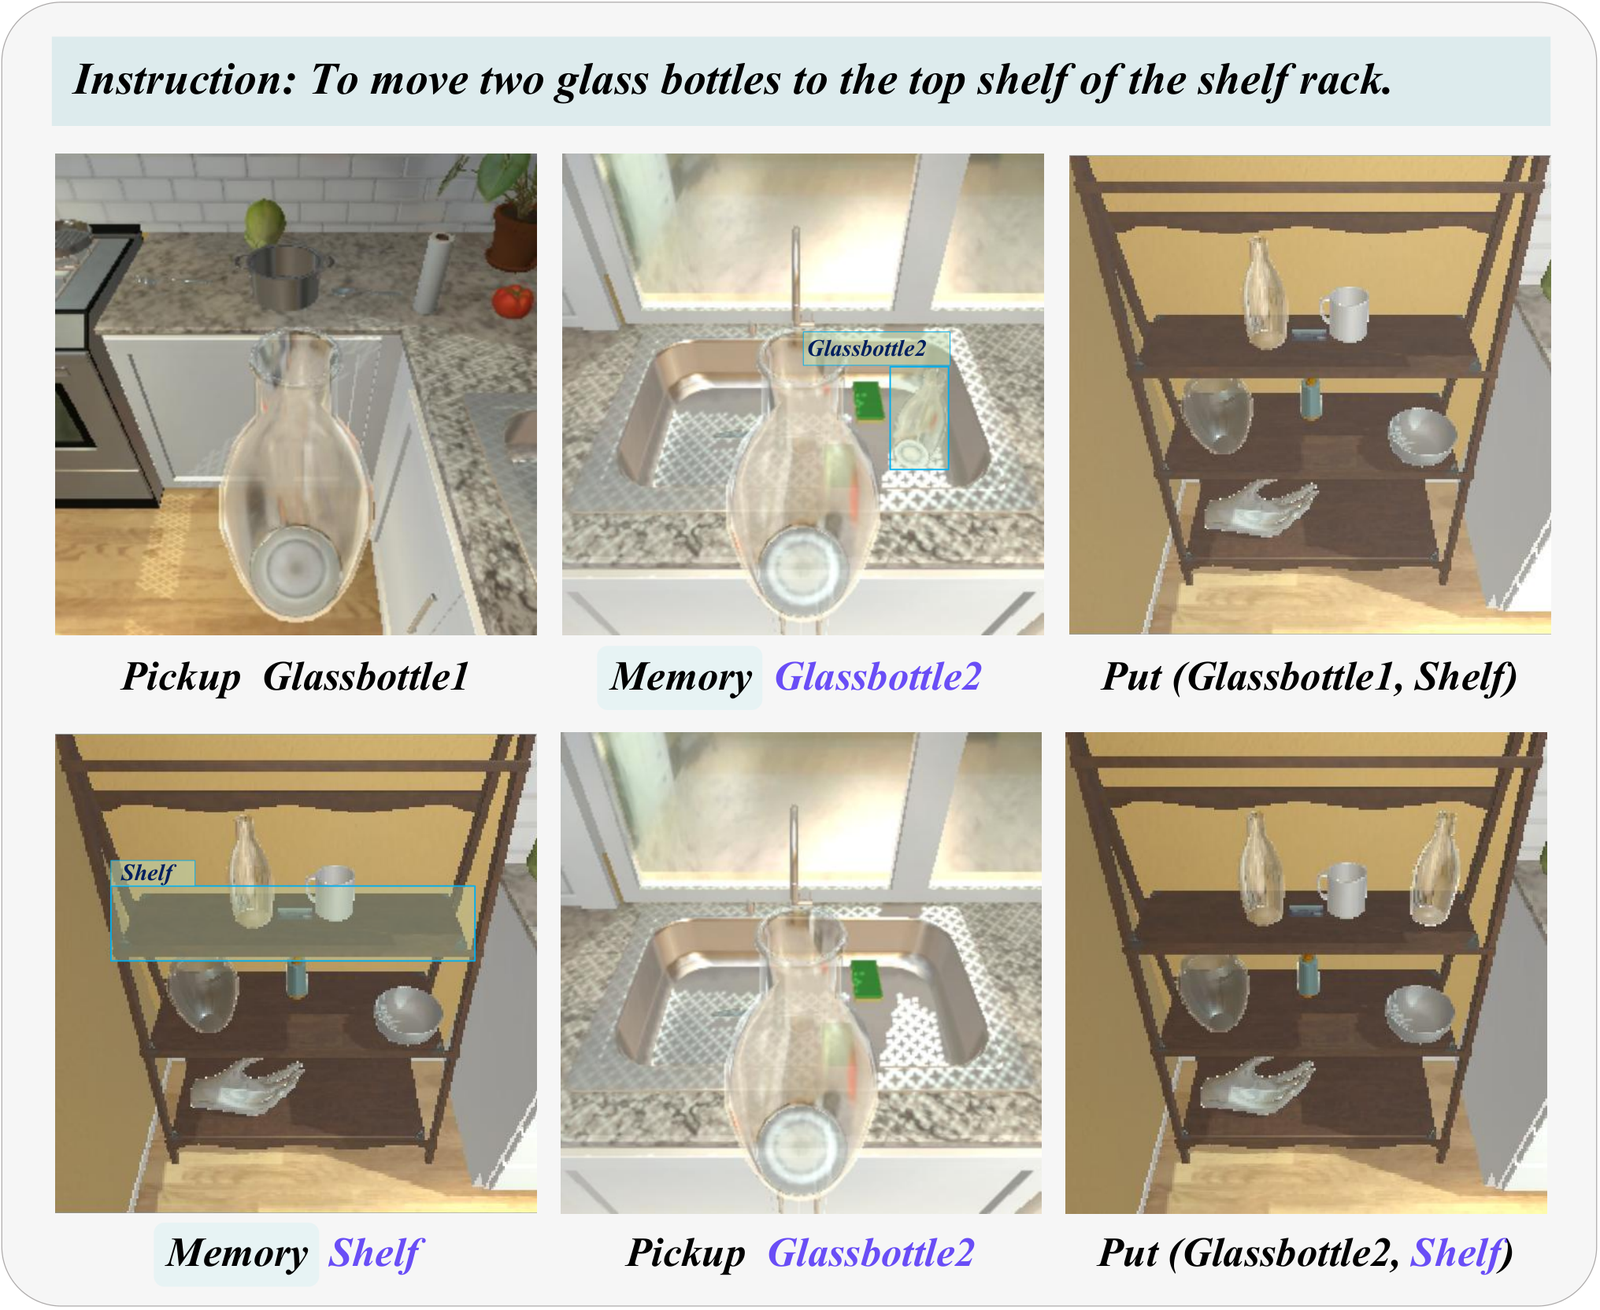
GraphThink 为此设计了具有环境记忆感知(Memory-Aware)的底层执行策略。区别于传统仅记录历史交互痕迹的被动机制,GraphThink 强调“主动缓存”与“实例级区分”。
智能体在前往主交互目标的导航途中,视觉系统会持续监测视野。一旦发现未来可能需要交互的相关物体,即便当前子任务尚未涉及该物体,底层模块也会立即将当前坐标记录为候选航路点,并缓存对应的实例分割掩码(Segmentation Mask)。当高级子任务推进到需要操作第二件物体时,底层策略直接从缓存中索引航向,无需漫无目的地重新建图探索。对于同一类别的多个实例,系统维护独立的交互记录,确保拿起瓶子 A 后不会将其错误替换为瓶子 B,显著压降了导航冗余步数与放置错位率。
场景图驱动的双事件闭环重规划
静态生成的计划无论多么周密,都无法完全预测交互后的物理反馈。抽屉打开后里面可能是空的,目标容器可能因遮挡而无法放置。许多已有工作要么完全依靠开环执行,要么仅在底层动作报错时被动尝试局部绕道,无法站在全局视角审视任务意图。
GraphThink 引入了基于场景图(Scene Graph)的动态重规划模块。与那些试图在三维空间中重建所有几何网格的重度场景图不同,这里的环境记忆 $\mathcal{G}_{\text{scene}}$ 追求极端紧凑与任务强相关:
-
关键物体提取:大语言模型首先解析总目标文本,提取出核心物体子集 $\mathcal{O}_{\text{key}}$,将图节点规模控制在 20 个以内,杜绝无关视觉杂讯干扰;
-
前向视角截取与 VLM 解析:智能体仅在面向目标物体中轴偏角 $45^\circ$ 以内的前向视角下采集 RGB 与分割图像,联合输入多模态模型(VLM)生成物体属性与空间语义三元组(例如
(knife, on, sidetable)); -
动态增量更新:每次物理交互后,过时的空间关系被即时替换,形成对当前物理状态的保真语义快照。
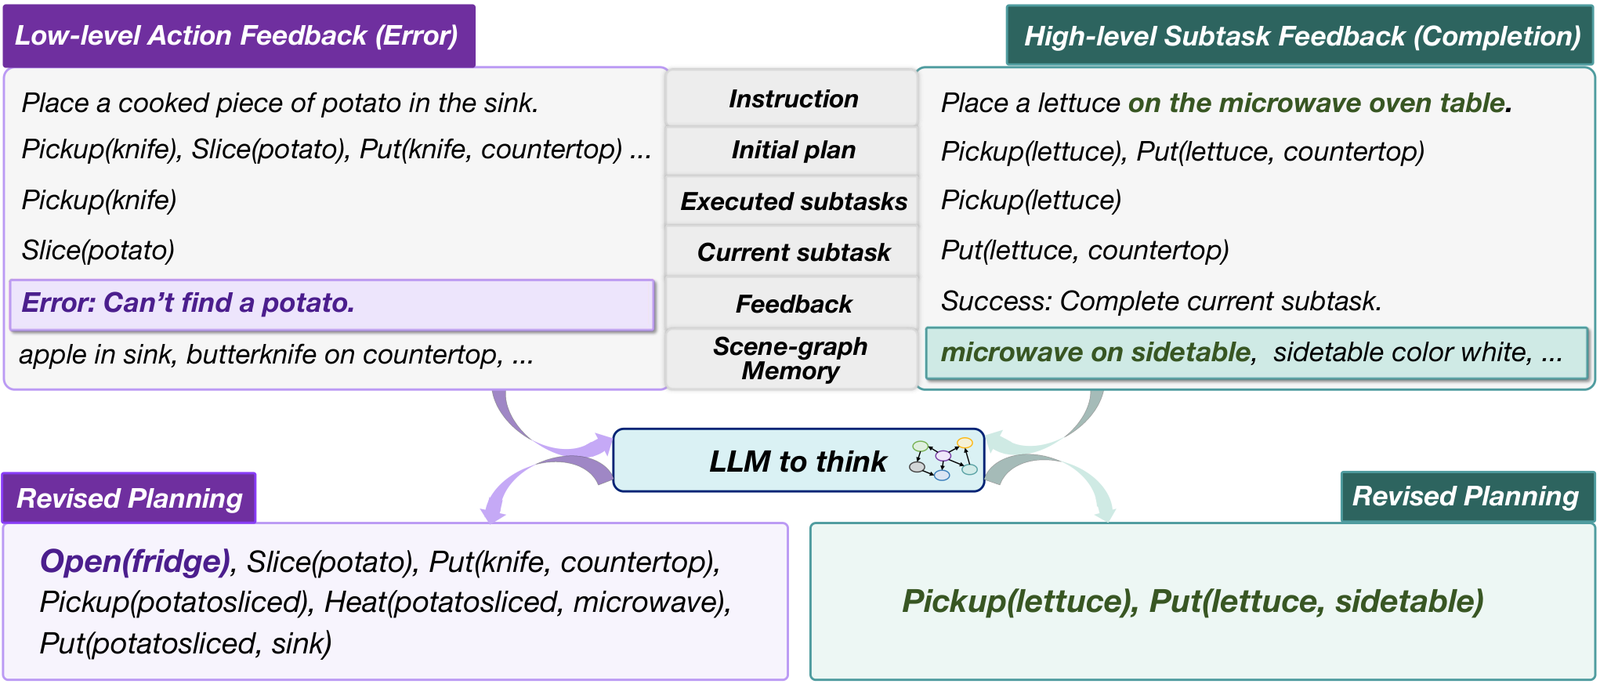
在此基础之上,研究团队提出了双事件驱动(Event-Driven)的重规划机制。这一设计兼顾了即时物理故障与高层语义偏离:
其一是底层动作执行错误触发。当底层策略遭遇导航死路、交互受阻(例如试图抓取紧闭微波炉内的盘子)时,底层报错连同当前观测被抛送至重规划模块,促使智能体调整局部路径或插入必要的前置动作(如打开炉门)。
其二是高层子任务完成检查点触发。这是防范语义幻觉的关键屏障。在某些场景下,智能体的动作在物理上完全可行,但已经在不知不觉中偏离了最终目标。例如指令要求“把生菜放在微波炉所在的桌子上”,初始规划可能假设微波炉位于厨房操作台;但当智能体走到微波炉前完成观察并更新场景图后,场景图明确显示“微波炉位于侧边小桌上”。此时,子任务完成事件立即激活 LLM,利用更新后的场景图对未执行计划进行全局审查,主动纠正后续目的地,避免了错上加错的无效执行。
实验结果与长程泛化剖析
研究团队在 ALFRED 官方基准上对 GraphThink 进行了全面评估。ALFRED 包含了 120 个室内房间场景、7 类复杂家庭任务以及长指令序列,极具挑战性。
在测试集表现上,GraphThink 展现出了强大的执行鲁棒性。在无见场景(Unseen Test)下,仅依靠高层目标指令引导,GraphThink 的任务成功率达到了 67.71%,目标条件达成率(Goal-Condition Success)达到 74.07%,均刷新了该榜单的世界纪录。相比于此前依赖逐步人工指令(Step-by-step Instructions)的领先方案,GraphThink 纯依靠自主规划便超越了对手,且完全不依赖模拟器的元数据作弊(No Ground-Truth Metadata),证明了其实际落地到物理真实场景的潜力。
消融实验进一步厘清了系统各部件的实际价值。若将基于任务图的规划器退化为通用的 RAG 增强 Qwen2.5-7B,验证集成功率直接暴跌超过 27 个百分点;若完全剥离动态重规划模块进入开环状态,无见场景成功率下降 8.90 个百分点;分别移除底层动作错误驱动与高层完成检查点驱动,均会导致 4% 以上的性能滑坡,验证了双事件机制的互补性。同时,关闭底层的对象主动缓存后,智能体在涉及多个同类物体的任务中频频发生抓取混淆,导致成功率明显下滑。
更为震撼的对比发生在长程任务规划的专项评测中。在基于 Qwen2.5-7B-Instruct 底座的实验中,研究人员对比了 SFT 方案与 GraphThink:
SFT 方案在与训练分布极度接近的常规验证集上表现尚可,但在复杂的未见长程任务上,成功率骤降至 20.57%。这是大模型行为克隆(Behavioral Cloning)的典型弊端——一旦轨迹步骤拉长,步骤缺失与逻辑幻觉呈现指数级放大。而采用图增强 RL 的 GraphThink 依然保持了 90.04% 的极高规划成功率,甚至超越了调用商业化闭源大模型 API 的基线表现。
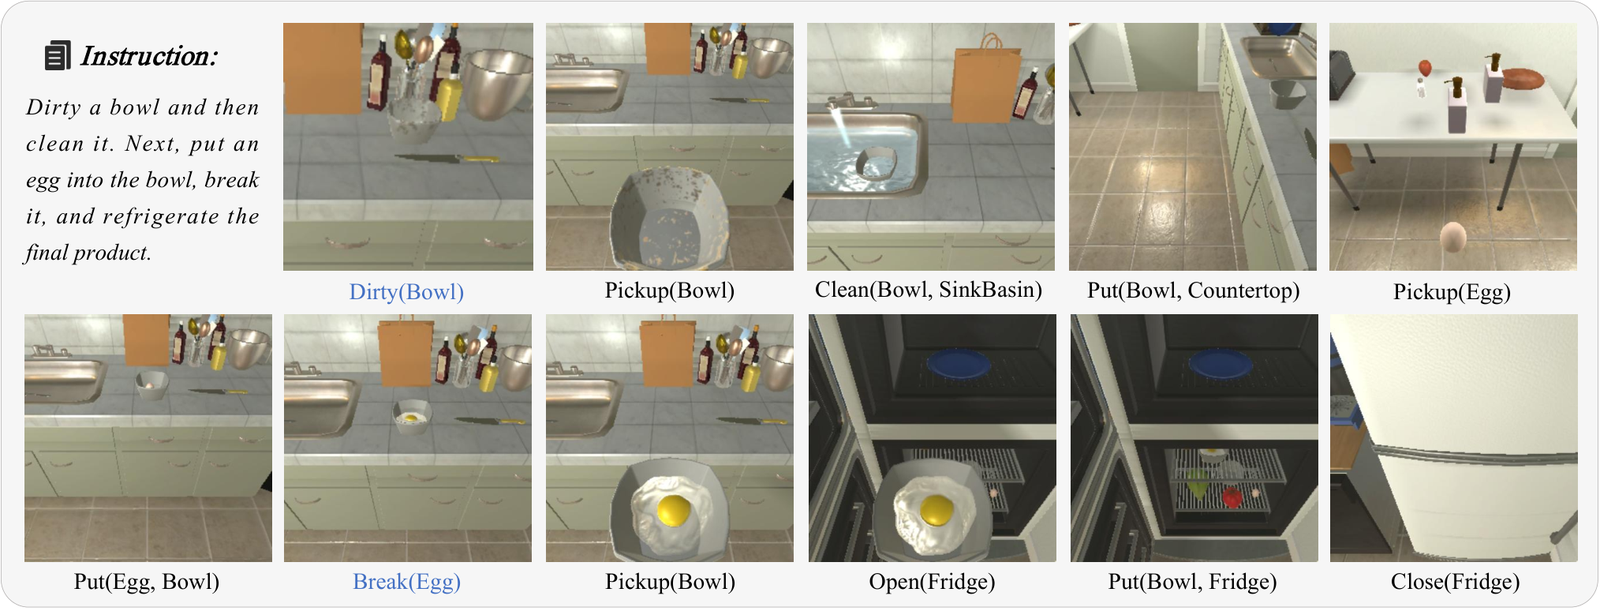
在跨任务与跨环境泛化测试中,GraphThink 同样展示了出色的迁移能力。在 AI2-Thor 环境中,面对训练阶段从未出现过的全新动作元语(如将物品弄脏 DirtyObject、打碎物品 BreakObject),任务图仅需扩展对应的逻辑转移边,无需额外收集长程轨迹,智能体便能无缝规划出合理的执行链条。在向 VirtualHome(WAH-NL 和 VirtualHome-HG)这一完全不同动作空间与模拟机制的环境迁移时,GraphThink 依然显著优于基线模型,展现出极强的跨领域适应性。
总结与技术启示
GraphThink 的成功给当前的具身智能规划范式提供了一个清晰的启示:在大模型时代,端到端并不等于完全放弃先验符号知识。纯靠统计概率学习的大语言模型,在缺乏严格因果世界模型的长程决策中极易迷航;而传统基于硬编码的符号图搜索,又缺乏理解开放词表与泛化上下文的柔性。
GraphThink 巧妙地将二者结合:它用结构化的“任务图”充当探索边界和强化学习导师,教会大模型在物理法则的轨道内“思考”;同时用动态紧凑的“场景图”充当智能体的环境工作记忆,让重规划由环境事件精准触发,而非盲目重试。这种将“逻辑先验图”与“感知动态图”深度嵌入 LLM 认知回环的设计,为突破长程具身智能任务的可靠性瓶颈提供了一条极具说服力的可行路径。