Gated-BEPO:用置信门控贝尔曼估值重构信用分配,成功率提升14.5%
Gated-BEPO: Confidence-Gated Bellman Credit Assignment for Large Language Model Agents
在大语言模型(LLM)被广泛应用于多轮交互与环境规划的背景下,智能体(Agent)面临着一个最根本的训练瓶颈:长程交互中的信用分配(Credit Assignment)。当智能体在 Web 界面点击跳转十几次,或者在具身环境中翻箱倒柜几十步之后,环境通常只会返回一个极为稀疏的二元结果——成功或失败。当前以 GRPO 为代表的主流无 Critic(Critic-free)强化学习算法,通常将最终的整条轨迹收益均匀分摊给每一个步骤。这种粗放的做法带来了显而易见的弊端:成功轨迹中往往混杂着大量的低效甚至错误动作,却被一并盲目奖励;而失败轨迹里即便包含关键的正确探索,也会被彻底惩罚。
ArXiv URL:https://arxiv.org/abs/2608.06861v1
来自北京航空航天大学、高通公司与中关村实验室的研究团队针对这一痛点,提出了 Gated-BEPO(置信门控贝尔曼策略优化)。该方法在不依赖庞大且难以训练的额外 Critic 网络的前提下,巧妙利用同批次采样的多条交互轨迹构建“经验状态图”(Empirical Rollout Graph),通过均值回传贝尔曼不动点(Mean-backup Bellman Fixed Point)在局部图中稳定估计状态价值,进而计算时序差分(TD)残差与广义优势估计(GAE)。更关键的是,团队设计了一个置信度门控机制(Confidence Gate):唯有在状态出现多次访问且观测到多个不同后继分支(即存在明确的局部对比证据)时,才激活单步贝尔曼优势并降低全局轨迹权重;反之则退回全局轨迹收益。
这项工作直击多轮智能体强化的核心矛盾,在 WebShop、ALFWorld 以及视觉多模态推箱子(Sokoban)等基准上展现出显著优势。在 ALFWorld 上,Gated-BEPO 相比 GAGPO 成功率提升达 7.7%;在 WebShop 上相比 GAGPO 成功率提升达 14.5%,相比此前的强基线 HGPO 提升达 4.17%,且几乎没有引入额外的计算时间开销。
为什么现有无 Critic 强化学习走入了死胡同?
为了摆脱传统 Actor-Critic 架构中 Critic 模型的显存占用与训练不稳定,近期的智能体强化学习研究广泛转向基于分组采样的无 Critic 范式。然而,在面对复杂交互任务时,这一技术路线迅速显露出两类极具代表性的缺陷。
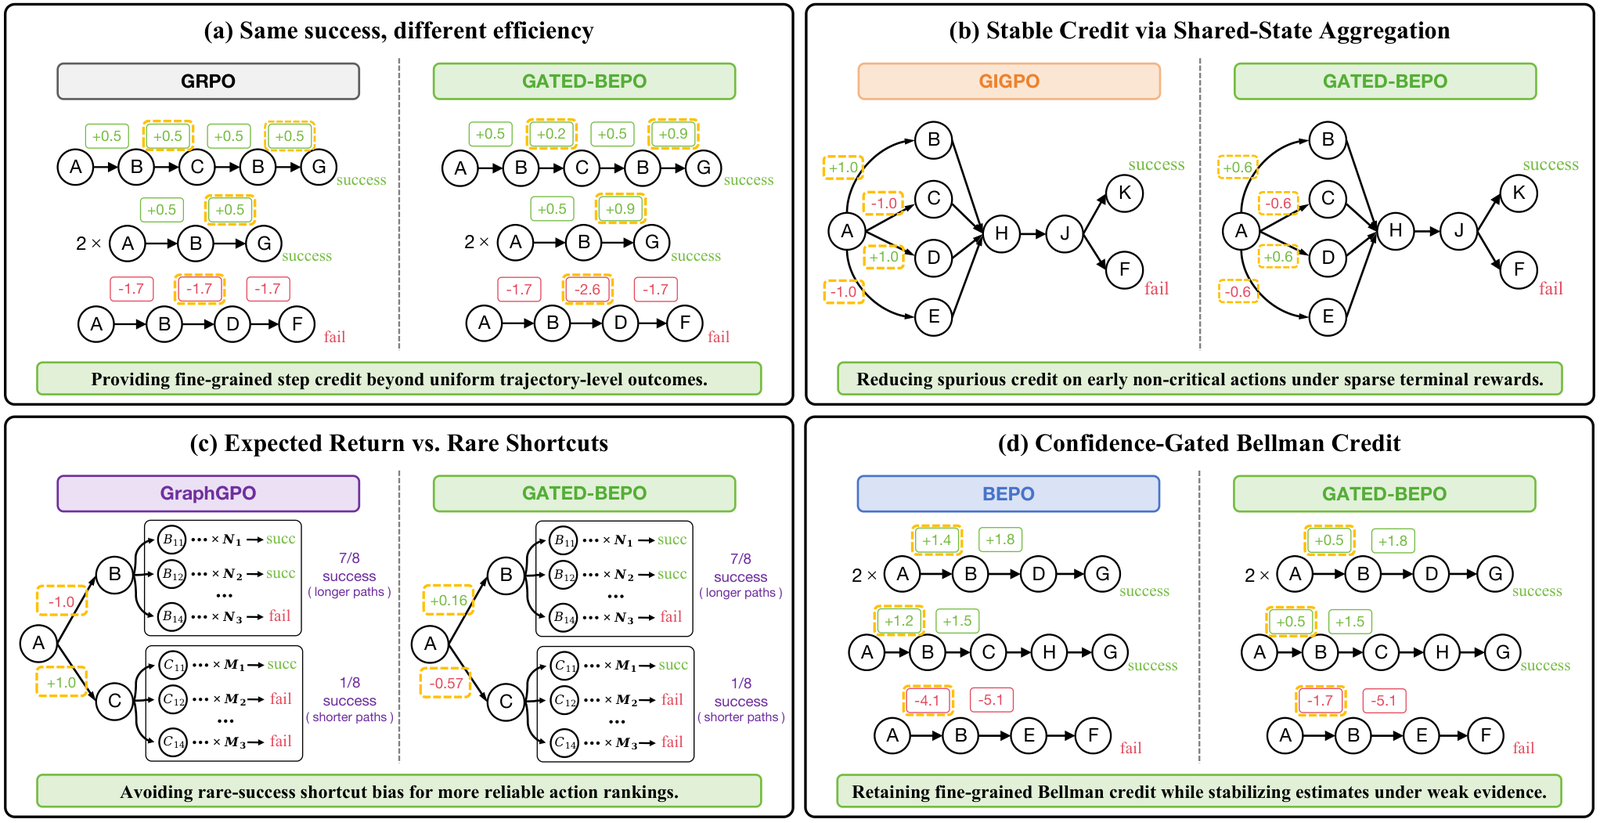
第一类是以标准 GRPO 为代表的整轨均摊机制。这类算法在给定的任务起点采样一组轨迹,计算各轨迹的最终回报,并将标量优势无差别地广播至该轨迹内的所有动作 Token。在步数极短的数学推理中,这种粗粒度归因尚可接受;但在长程交互环境下,单一步骤的失误可能在十几步后才导致全局崩溃,或者智能体纯粹依靠长程随机游走误打误撞达成目标。均摊奖励直接破坏了策略梯度对有效局部决策的辨识能力,导致模型收敛缓慢,最终性能上限严重受限。
第二类是近来试图从采样组中提取单步信号的改进方案。例如 GiGPO 和 HGPO 通过匹配历史轨迹中重复出现的锚点状态,将不同轨迹的相同状态归为一组进行动作收益对比;GAGPO 则构建分组收益代理并借用 TD/GAE 传播时序优势。然而,这些方法仅仅比对单步动作之后产生的最终整轨回报,未能显式建模跨轨迹共享的下游转移拓扑。另一种思路如 GraphGPO,虽然把采样轨迹合并成了状态转移图,却采用了“到达成功终止状态的最短路径倒数”来定义状态价值。这种乐观的最短路径估计在复杂的长程任务中极其脆弱,一旦遇到感知混淆(Perceptual Aliasing)——即不同底层环境状态表现出完全相同的文本或视觉观测时,图搜索便会产生严重的虚假捷径,导致策略更新彻底失稳。
更普遍的短板在于,现存方法均采用固定的权重强行混合步级信用与轨迹级信用,完全不考虑当前状态是否真的具备“做出有效对比”的局部样本证据。
贝尔曼不动点与均值回传:在经验图上重构价值估计
Gated-BEPO 的核心思路,是在完全摒弃外挂 Critic 模型的同时,回归强化学习经典且稳固的动态规划基石。智能体与环境交互的每一条轨迹可表示为:
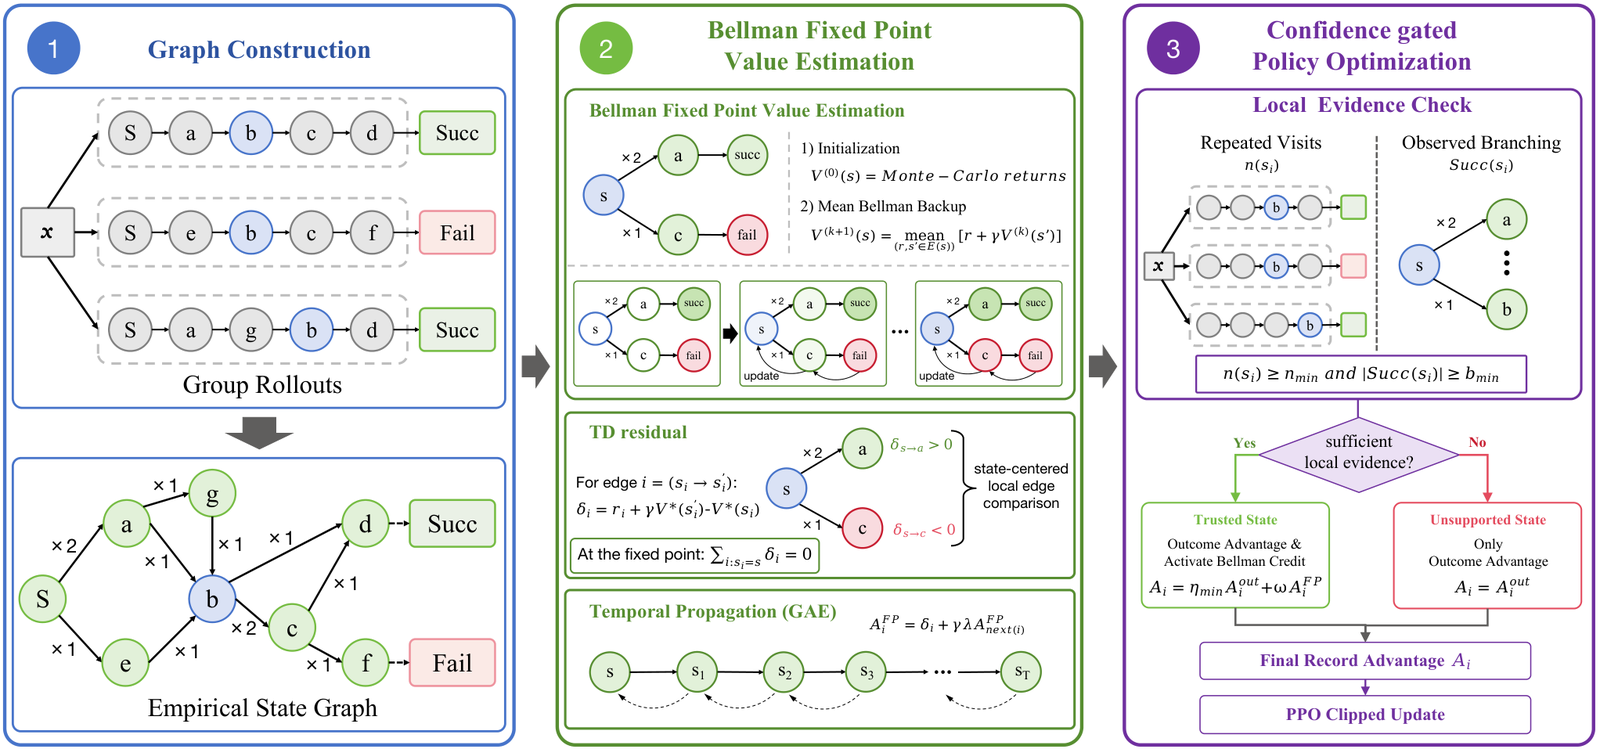
\[\tau=(s_{0},a_{0},r_{0},s_{1},\ldots,s_{T-1},a_{T-1},r_{T-1},s_{T})\]针对同一初始任务,算法采样由 $K$ 条轨迹组成的 Rollout Group。Gated-BEPO 首先将该组内观测文本(或多模态特征哈希值)完全相同的状态节点进行聚合,建立一张局部经验转移图。
对于图中的任意状态节点 $s$,其在当前批次中观测到的所有转移集合为 $E(s)={(r_{i},s’{i}):s{i}=s}$。Gated-BEPO 没有采用强化学习中常见的 Max 算子(如 Q-learning)或基于最短路径的图算子,而是定义了一个均值回传贝尔曼算子:
\[V^{(k+1)}(s)=\frac{1}{\lvert E(s) \rvert}\sum_{(r,s')\in E(s)}\left[r+\gamma V^{(k)}(s')\right]\]经过若干次迭代直至不动点收敛后,节点所赋予的价值恰好对应当前行为策略在经验图上的期望累积回报。这里选择“均值(Mean)”而非“最大值(Max)”有着至关重要的考量:最大值算子极具投机性,一旦存在感知混淆或者低概率的罕见成功跃迁,Max 算子会瞬间将异常高估的价值传递至整个图结构中;而均值算子忠实反映了当前策略在该状态下的实际期望,天然具备更强的平滑性与抗噪能力。
当获得节点的不动点价值 $V(s)$ 后,算法便可为每一个真实的交互记录计算时序差分残差:
\[\delta_{i}=r_{i}+\gamma V(s'_{i})-V(s_{i})\]值得注意的是,在经验图的定义下,从同一状态出发的所有实际转移残差之和严格满足 $\sum_{i:s_{i}=s}\delta_{i}=0$。这意味着在局部状态节点上,策略更偏好的有效分支残差为正,低效分支残差为负,构成了天然的零和对比信号。
置信度门控:不要强行在“单行道”上做单步对比
拥有了局部 TD 残差后,一个常见误区是直接将其均匀混合进所有步骤的最终优势函数中。然而,经验采样的图结构在很多时候是稀疏且不均匀的:某些状态在整个批次中仅被访问过一次,或者虽然被访问多次,但智能体在所有轨迹中都转向了相同的后继状态。在这些缺乏局部横向对比证据的“单行道”上,强推步级优势只会引入无意义的估值方差。
为此,Gated-BEPO 引入了核心机制——图置信度门控(Graph-Confidence Gate)。门控针对每个状态 $s$ 统计两个关键量:状态在批次内的总访问频次 $n(s)$,以及观测到的相异后继状态数量 $\lvert \operatorname{Succ}(s) \rvert$。置信度判定函数定义为硬性阈值门控:
\[\rho(s)=\begin{cases}1,&n(s)\geq n_{\min}\ \text{且}\ \vert{}\operatorname{Succ}(s)\vert{}\geq b_{\min}\\ 0,&\text{否则}\end{cases}\]通常设置访问次数 $n_{\min}=2$ 且相异后继分支 $b_{\min}=2$。这就确保了只有当经验图为当前状态提供了至少两条不同的交互分支时,算法才认定该节点具备充分的局部对比置信度。
整个优势估计流程通过如下两步精细设计协同运作:
第一步是先 GAE 累积,后门控截断。固定点步级优势函数在整条原始轨迹上通过广义优势估计递归计算:
\[\widehat{A}_{i}^{\mathrm{FP}}=\delta_{i}+\gamma\lambda\widehat{A}_{\operatorname{next}(i)}^{\mathrm{FP}}\]关键在于,即使下游某个中间状态的门控处于关闭状态(即没有分支对比),该状态生成的真实转移残差 $\delta$ 仍然会被保留在整条轨迹的 GAE 反向累积链条中。这样既保证了下游深处的反馈信号能有效向上传递,又避免了门控硬切断导致的时序信息丢失。
第二步是动态自适应混合。当步骤记录 $i$ 的门控 $\rho(s_i)$ 处于开启状态时,表明局部对比高度可信,算法主动抑制全局轨迹优势的权重;反之则全面依靠全局轨迹优势:
\[\widehat{A}_{i}=\eta_{i}\widehat{A}_{i}^{\mathrm{out}}+w\,\rho(s_{i})\widehat{A}_{i}^{\mathrm{FP}}\] \[\eta_{i}=\eta_{\min}+(1-\eta_{\min})(1-\rho(s_{i}))\]其中 $\widehat{A}{i}^{\mathrm{out}}$ 为经过记录加权标准化的轨迹级相对优势,$w$ 控制步级信号强度,$\eta{\min}$ 保证在置信状态下仍然保留微弱的全局锚定。最终合成的混合优势标量被广播至对应动作 $a_i$ 的各个有效 Token 上,接入标准的 PPO 裁剪目标中完成策略参数更新。
实验评测:全面超越强基线与极度抗感知混淆
为检验方法在长程决策、文本语义与视觉感知下的通用表现,实验在具身操作基准 ALFWorld、电商多轮决策平台 WebShop 以及视觉多模态推箱子(Visual Sokoban)上展开评测,基础模型涵盖 Qwen2.5-1.5B、7B 与多模态 Qwen2.5-VL-3B。
主实验结果表明,Gated-BEPO 在各项任务上均稳稳压制现有无 Critic 算法。在以 Qwen2.5-1.5B 为底座的 ALFWorld 评测中,Gated-BEPO 的最终平均任务成功率达到 93.2%,比 GAGPO 的 85.5% 显著高出 7.7 个百分点,也明显领先于 HGPO(90.5%)与 GRPO(69.7%)。将底座扩展至 7B 规模后,Gated-BEPO 进一步提升至 94.7% 的高位。在动作空间极大、对细粒度语义匹配要求严苛的 WebShop 环境中,基于 1.5B 模型的 Gated-BEPO 斩获了 74.0% 的成功率与 87.8 分的平均分,较 GAGPO 提升了 14.5% 的成功率,较 HGPO 提升了 3.51%。在视觉多模态 Sokoban 任务中,面对极易死锁的规划空间,Gated-BEPO 依然取得了 80.0% 的成功率,显著高于基线。
最耐人寻味的发现来自针对感知混淆(Observation Aliasing)的对照测试。此前的图结构方法 GraphGPO 在其原始论文中高度依赖向模型额外喂入环境特权信息(如房间精确坐标、背包物品清单、动作合法掩码等)才能勉强生效。当在严格公平的原始文本观测(Raw-observation)协议下进行测试时,GraphGPO 几乎彻底丧失了学习能力,成功率呈现断崖式暴跌;而 Gated-BEPO 的学习曲线保持着极高的上升斜率与稳定性。这充分印证:单靠状态合并与图最短路径极易将不同语境下的相同字面描述错误串联;而 Gated-BEPO 将均值不动点与沿原轨迹的 TD/GAE 传播结合,哪怕节点字面相同,只要后继反馈与整轨回报有差异,对应样本依然能获得差异化且正确的信用评定。
在计算开销方面,Gated-BEPO 展现出了惊人的工程实用性。在 ALFWorld 环境下,每轮参数更新中,整个经验图构建、贝尔曼不动点求解及门控混合的计算过程仅需 0.361 秒,而环境交互与模型自回归前向优化过程耗时约 225.7 秒。这意味着该算法在几乎不增加端到端训练墙上时钟时间(Wall-clock time)的前提下,达成了远超传统 Trajectory-level 方法的样本效率。
诊断性消融:三大机制为何缺一不可?
为理清各设计模块的具体增益,研究团队在 WebShop 环境中进行了递进式的逐层消融实验,结果揭示了极具说服力的内部演化规律。
当仅保留纯粹的轨迹级全局优势时,基线模型的成功率仅为 62.50%。在此基础上,若无门控地在所有状态强行加入经验图贝尔曼不动点优势,成功率温和攀升至 66.41%。这表明引入下游拓扑的贝尔曼单步信号确实包含有效增量,但因噪声过多而未完全释放潜力。
在此基础上进一步引入置信度门控机制,将步级优势严格限制在具备真实经验分支对比的状态上,成功率瞬间跳升至 73.83%(绝对增幅达 7.42%)。最后,加上在置信状态下主动压低全局轨迹权重的自适应混合策略,成功率最终定格在 75.91%。
进一步的细分诊断回答了关于算法内在机制的几个核心问题:
-
分支阈值设定:实验对比了不同的门控参数,当 $n_{\min}=2, b_{\min}=2$ 时表现最佳。若将分支数放宽至 $b_{\min}=1$(即允许没有动作分支的单行状态入选),成功率直接跌落至 62.50%,与完全不做门控的劣质水平相当。这强有力地佐证了:缺乏横向对比分支的局部单步信用本质上是不可靠的伪信号。
-
回传算子抉择:在 ALFWorld 上对比均值算子与规划类算子(Max 与 Softmax),Mean 备份以 90.4% 的成功率碾压了 Max(65.4%)与 Softmax(64.6%)。在经验采样极不充分的局部图中,乐观类算子会极度放大偶然出现的异常跃迁,直接毁掉策略梯度的稳定性。
-
不动点迭代预算:仅做 1 步贝尔曼迭代虽然能提供即时改善(73.7%),但中间过渡阶段(如 3 步迭代,71.0%)由于价值尚未收敛,容易向 TD 残差中引入半生不熟的震荡噪声;只有持续迭代至不动点完全收敛(20 次迭代),成功率才彻底释放至 75.91% 的峰值。
-
门控框架的通用性:研究人员将这套“置信度门控”机制平移到先前的竞品算法 GAGPO 上,在不改变 GAGPO 原本返回值代理估计的前提下,仅凭门控筛选便将 GAGPO 的 WebShop 成功率从 64.5% 拔高至 70.1%。这证实了“选择性融入步级信用”本身就是一种具有通用指导价值的智能体强化设计哲学。
总结与展望
在 LLM 驱动的智能体训练中,无 Critic 强化学习因为架构轻量、显存友好而成为当下的前沿主流。但主流往往掩盖了粗放:整条轨迹的“一刀切”奖惩不仅违背了因果直觉,也在很大程度上浪费了宝贵的环境交互样本。
Gated-BEPO 给出的破局方案既克制又精巧。它没有退回昂贵且脆弱的学习型 Critic 老路,而是向内挖掘单批次 Rollout 内部蕴含的图结构信息,通过经典严谨的均值贝尔曼不动点求得无偏的局部预期;同时,它又极其清醒地设立置信门控,明白何时该信赖局部对比、何时必须退回宏观全局。这种“有证据则精细对比,无证据则尊重全局”的策略,为多步交互智能体提供了一种兼具高样本效率、高抗混淆鲁棒性与低算力消耗的信用分配范式,对未来复杂交互环境下的模型自进化与在线强化学习具有高度实用的落地价值。