EviSD:仅调节10%动作Token,特权证据自蒸馏破解多轮搜索信用分配
EviSD: Evidence-Conditioned Self-Distillation for Search-Augmented Agents
在多步复杂推理场景中,让大语言模型自主调用搜索引擎已成为解决知识时效性与幻觉问题的核心范式。然而,当开发者尝试用强化学习(RL)去优化一个具有多轮交互能力的搜索 Agent 时,往往会撞上一堵难以逾越的工程之墙:信度分配(Credit Assignment)的极端粗糙。
ArXiv URL:https://arxiv.org/abs/2608.01359
以 DeepSeek 推出的 GRPO 等基于结果奖励(Outcome-based RL)的算法为例,优化目标完全依赖最终给出的答案是否正确。如果最终答案匹配,整条轨迹里的所有 Token 都会被赋予正向优势(Advantage);如果答案错误,所有 Token 都会受到惩罚。但在真实的多轮检索过程中,模型可能前两次搜索精准找到了核心论据,却在第三次提出了冗余检索,最后侥幸答对;也可能每一步检索词都构造得极其专业,仅因最终输出格式出现微瑕而被全盘否定。这种“轨迹级粗放奖励”将有效检索、无效检索、中间思维链以及终局回答混为一谈,严重阻碍了 Agent 学习高效检索策略的效率。
针对这一痛点,最新研究提出了一种名为 EviSD(Evidence-Conditioned Self-Distillation,证据条件自蒸馏)的创新框架。该框架的精妙之处在于:它既不引入昂贵的外部判别模型(Critic),也不在推理阶段增加任何额外开销,更没有推翻原本的强化学习方向,而是巧妙地将训练集自带的支持性证据(Supporting Evidence)与标准答案作为“特权信息”,在训练阶段通过同一模型的自身打分差异,对 GRPO 的优势值进行微调。尤为惊人的是,这项技术在整个生成轨迹中仅仅调制了 6.7% 至 15.1% 的动作关键 Token,就在 7 个问答基准测试上全面超越现有方法 1.3 到 2.3 个百分点。
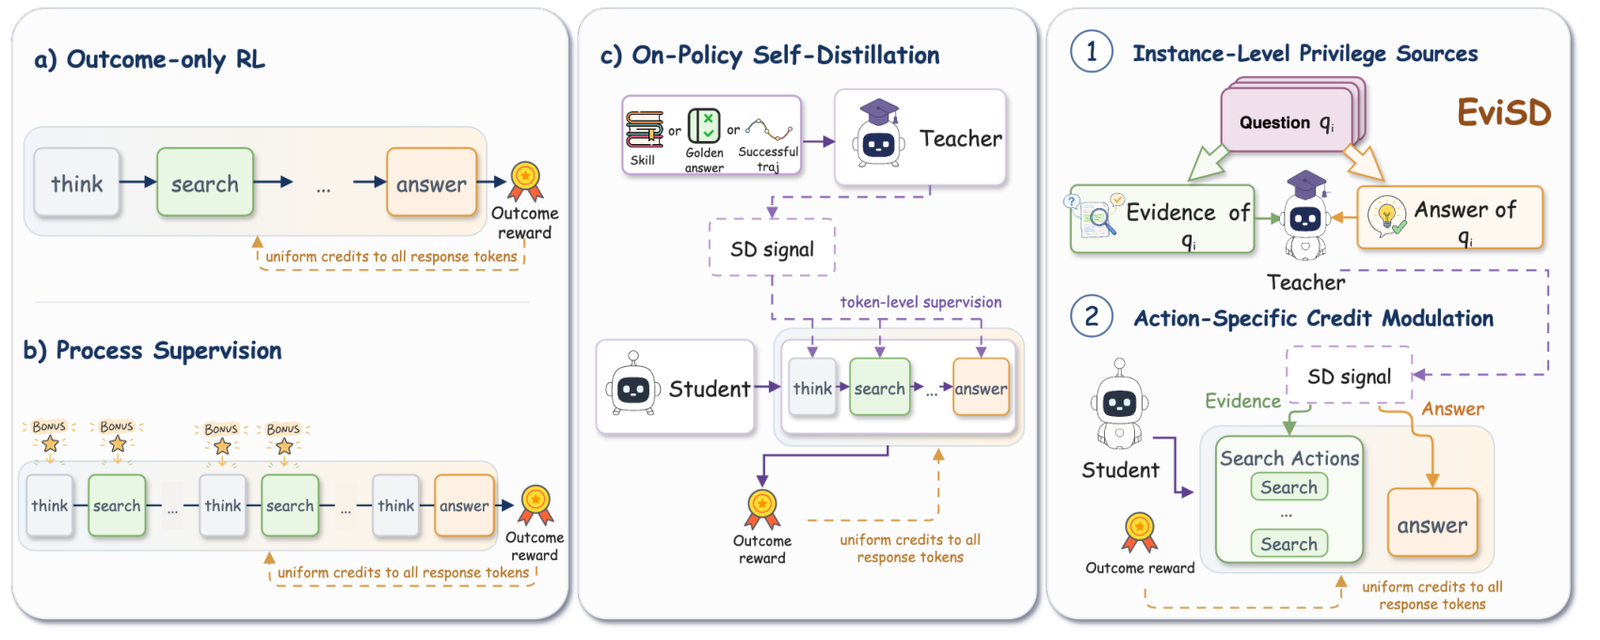
多轮检索 Agent 的信用分配困境
要理解 EviSD 的价值,必须先透视当前搜索 Agent 训练的技术瓶颈。
在检索增强生成(RAG)演进为自主决策智能体的过程中,模型需要自主判断“何时检索”、“检索什么”以及“何时停止检索并输出答案”。目前学术界与工业界主要采用三类监督思路,但均存在明显的妥协与短板:
-
纯结果奖励的强化学习(Outcome-only RL):如 Search-R1 或 KBQA-R1,完全依赖最终答案的可验证性。其优势是流程干净、容易规模化扩展,但缺点是环境反馈过于迟钝。在包含 3 到 4 轮检索的复杂多跳问题中,早期的某一个检索 Query 往往决定了后续所有推理的生死,结果级优势广播根本无法定位究竟是哪一步决策起到了关键作用。
-
细粒度过程监督(Process Supervision):如 AutoRefine、IGPO、StepSearch 等,通过显式引入检索质量评估器、答案置信度变化差值或者每一步的转移图来补充过程奖励。这类方法虽然让反馈变密集了,但极度依赖额外的奖励模型或复杂的探针,不仅训练链路脆弱,而且容易诱发强化学习中的“刷分(Reward Hacking)”现象。
-
在策略自蒸馏(On-Policy Self-Distillation, OPSD):该范式让同一个模型在普通推理上下文(Student 视角)下采样生成,并在喂入特权信息(如任务指南、标准答案或成功轨迹后见之明)的 Teacher 上下文下对该生成重新打分,计算两者的分布差异并进行蒸馏。然而,现有的蒸馏方案大多缺乏精准约束,要么直接把标准答案塞给 Teacher 导致检索步骤无法被合理评估,要么在整个响应的所有 Token 上盲目添加辅助蒸馏损失(Auxiliary Loss),强迫部署模型去模仿一个拥有作弊视角的特权上下文,反而造成严重的分布偏移。
这引出了构建搜索 Agent 强化学习框架时最核心的两个根本问题:在自蒸馏视角下,究竟应该给 Teacher 注入什么维度的特权信息?这些特权信息又应当以何种形式、作用于模型的哪些 Token 上?
特权信息的精准解耦:证据用于检索,答案用于归纳
EviSD 给出的第一个关键洞察,是对特权信息(Privileged Information)与动作语义的精准解耦。
在绝大多数开源 QA 数据集的训练元数据中,除了最终的黄金答案(Golden Answer $\mathcal{C}_{q}$)之外,往往还附带了人工标注的支持性证据(Supporting Evidence $\mathcal{E}_{q}$)——即维基百科中支撑该事实的关键段落与句子。以往的研究往往忽视了这一宝贵资产,或者仅仅在检索预训练时将其作为正样本。
作者明确指出:支持性证据天然是为检索动作量身定制的特权上下文。如果直接把最终答案给 Teacher,Teacher 根本无法判断模型提出的检索词好不好,因为答案本身并不包含中间的检索路径信息;反之,支持性证据明确勾勒出“一个高效的检索动作应当挖掘出怎样的信息增量”,但它又没有强行规定某一个固定的标准检索 Query。这既为评估留出了探索空间,又提供了极具区分度的参照物。
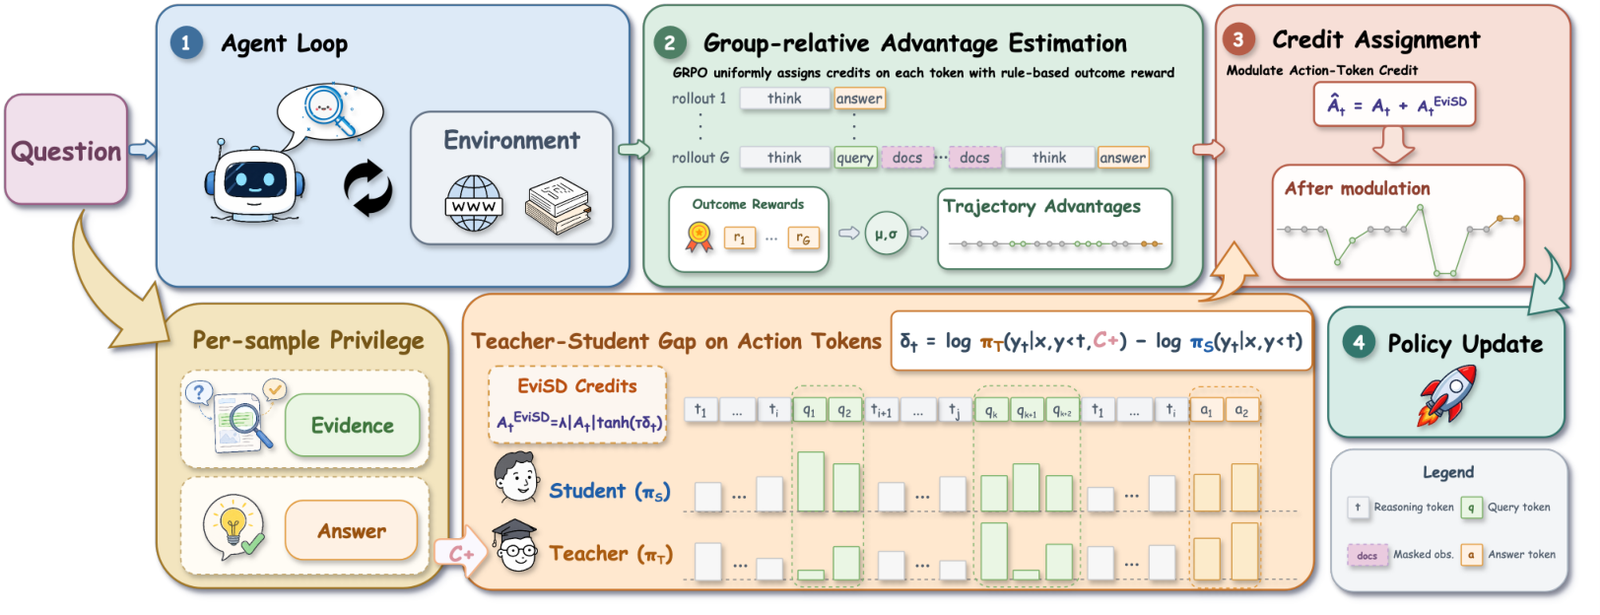
因此,EviSD 制定了一套动作对齐的特权路由机制:
-
当模型在第 $k$ 轮生成的动作为
search时,系统将实例级的支持性证据 $\mathcal{E}{q}$ 拼接入 Teacher 上下文 $\widetilde{x}{i,k}$; -
当模型生成的动作为
answer时,系统将黄金标准答案 $\mathcal{C}_{q}$ 拼接入 Teacher 上下文; -
若为其他思考过渡或无效动作,则不提供特权信息(上下文退化为原始推理上下文 $x_{i,k}$)。
这种设计彻底打破了以往“全局塞答案”的粗糙做法,让 Teacher 在打分时具备与当前动作高度契合的认知视角。
有界调制:不改优化方向,只在关键动作上“精雕细琢”
明确了特权信息“喂什么”,紧接着必须解决“怎么用”的难题。许多传统方法选择在原始 PPO/GRPO 损失函数之外,硬生生挂一个 KL 散度或交叉熵作为辅助蒸馏损失函数。这种做法常常导致优化方向打架:强化学习希望往高奖励方向探索,而蒸馏损失又死死拽着模型往特权分布上靠拢。
EviSD 抛弃了辅助损失函数的设计,采用了更加优雅的优势调制机制(Advantage Modulation),在空间和幅度两个维度上施加了极强的数学约束。
空间定位(Where):严守动作片段掩码
在模型生成的完整响应序列中,不仅包含检索指令,还交织着大段的内部思考(Thought Chain)、特殊分隔符以及从外部搜索引擎拉回来的观测文本(Observation)。
EviSD 引入了一个二值动作掩码 $m^{\mathrm{act}}_{i,k,t}$。该掩码仅在模型自主生成的 search 与 answer 动作内容 Token 上为 1,对思维链 Token、语法边界符以及环境返回的检索文本全部置为 0。根据统计,在模型生成的整个长文本轨迹中,真正受到特权信号作用的 Token 比例仅仅占到 6.7% 到 15.1%。绝大多数非动作 Token 完全保持由最终结果决定的原始 GRPO 信用。这种高度局域化的设计,最大程度避免了特权信息污染模型的通用推理能力。
机制映射(How):锚定结果的有界校正
在具体的信用调制上,Student 在原始上下文 $x_{i,k}$ 下完成采样,而处于截断梯度(Stop-gradient)状态的 Teacher 在特权上下文 $\widetilde{x}{i,k}$ 下对相同的输出 Token $y{i,k,t}$ 重新评估对数几率,两者做差得到一个局部的概率差距信号:
\[\delta_{i,k,t}=\mathrm{sg}\!\big[\log\pi_{\theta}(y_{i,k,t}\mid\widetilde{x}_{i,k},y_{i,k,<t}) - \log\pi_{\theta}(y_{i,k,t}\mid x_{i,k},y_{i,k,<t})\big]\]如果 $\delta_{i,k,t} > 0$,说明在拥有支持性证据的前提下,模型当前的检索词显得更加合理;反之则说明该动作并不受特权视角的认可。
为了防止这一信号破坏整体强化学习的稳定性,EviSD 将 $\delta$ 传入一个双曲正切函数 $g_{\tau}(\delta)=\tanh(\tau\delta)$,并与轨迹原本的 GRPO 优势值 $A_{i,k,t}$ 的绝对值相乘,构建出调制项:
\[\Delta A^{\mathrm{priv}}_{i,k,t}=\lambda\vert{}A_{i,k,t}\vert{}g_{\tau}(\delta_{i,k,t})\,m^{\mathrm{act}}_{i,k,t}\] \[\widehat{A}_{i,k,t}=A_{i,k,t}+\Delta A^{\mathrm{priv}}_{i,k,t}\]仔细审视这一数学形式,可以发现其暗含的几重精妙特性:
- 符号严格保持:只要超参数 $\lambda \in (0, 1)$(实验中默认取 $0.2$),由于 $\vert{}\Delta A^{\mathrm{priv}}{i,k,t}\vert{}\leq\lambda\vert{}A{i,k,t}\vert{}$,校正后的优势值 $\widehat{A}_{i,k,t}$ 的正负号永远不会逆转。换言之,由最终终局奖励所确定的“奖惩大方向”完全不可动摇。
-
动态幅度缩放:特权信号的作用仅仅是“奖优减惩”或“罚劣削奖”。如果一条轨迹最终成功($A > 0$),而某个检索词被证明极其符合支持证据($\delta > 0$),那么它的正向奖励会被放大;如果该轨迹最终失败($A < 0$),但模型在中间其实提出了一个非常合理的检索词,特权信号会将对其的惩罚大幅软化。
- 零开销推理:在推理和实际部署阶段,整个特权 Teacher 上下文被彻底剥离,模型依然以标准的 Student 上下文运行,完全不存在推理侧的算力负担。
跨越规模与代际的全面突破
为了严密验证这一范式的普适性,研究团队在 7 个极具挑战性的公开问答基准上展开了高强度评测。测试集覆盖了单跳检索场景(NQ、TriviaQA、PopQA)与复杂的长链多跳问答场景(HotpotQA、2WikiMultiHopQA、MuSiQue、Bamboogle)。模型骨干横跨了多个参数规模与代际,包括 Qwen2.5-7B-Instruct、Qwen2.5-3B-Instruct 以及最新的 Qwen3-1.7B。
在最具代表性的 Qwen2.5-7B-Instruct 评测中,基线涵盖了基于结果奖励的经典方案(Search-R1、AutoRefine)、细粒度过程奖励方案(IGPO、TIPS、PiCA、StepSearch、CriticSearch、GiGPO),以及各类基于轨迹回溯或技能库的在策略自蒸馏变体(OPSD、Skill-SD、RLSD 等)。
实验数据显示,在多跳数据集 MuSiQue 和 Bamboogle 这类高度考验连续检索与逻辑推理的任务上,传统纯结果强化学习的 Exact Match(EM)准确率往往徘徊在较低水平,而 EviSD 展现出了统治级的表现:
-
在整体宏平均(Macro-Average)EM 指标上,EviSD 达到了 50.8%,全面超越所有参评基线。相比强劲的过程监督方法与自蒸馏方案,取得了 1.3 到 2.3 个百分点的绝对领先。
-
在未见过的分布外(OOD)数据集上,EviSD 展现了极强的泛化能力。例如在复杂的 2WikiMQA 上达到了 49.3%,在 MuSiQue 上达到了 34.6%,显著优于简单塞入轨迹历史的 SD-Search 或依赖技能抽取的 Skill-SD。
而在模型规模下探至轻量化的 Qwen3-1.7B 与 Qwen2.5-3B 时,这一优势依然稳固。
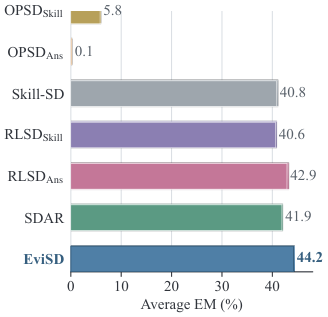
从上图可以清晰看到,在参数量仅为 1.7B 的紧凑模型中,各类依靠技能提示或单纯后见蒸馏的方法性能提升较为平缓,而 EviSD 凭借针对检索动作与证据的精准校准,将平均 EM 强势推升至 44.2%,拉开了明显的代际差距。
深度消融:为什么局部调制不可替代?
为了将 EviSD 内部各组件的功劳彻底理清,作者进行了一系列极其严谨的受控消融实验(Controlled Ablation),这些实验结果为大模型 Agent 的训练机制研究提供了深刻的启示。
1. 证据特权 vs. 答案特权
如果在蒸馏阶段不引入支持性证据,而是像传统方法那样,在所有动作上都仅仅向 Teacher 喂入黄金标准答案(Answer-only),模型的宏平均 EM 直接从 50.8% 断崖式跌落至 48.7%(下降 2.1 个百分点)。这一对比清晰证明:在指导检索动作时,答案本身并不能代替支持性证据。证据告诉模型“世界中存在哪些相关知识”,而答案仅仅是一个静态的终局符号。
2. 动作局域化 vs. 全序列蒸馏
如果保留这套有界调制公式,但撤销动作掩码 $m^{\mathrm{act}}_{i,k,t}$,允许特权信号作用于包括思维链在内的整个响应序列(Full Response),模型的宏平均性能更是暴跌 7.1 个百分点,跌至 43.7%。
这是一个非常关键的研究结论:在部署环境中,模型思考时是绝对无法得知支持性证据的。如果在训练时强迫模型整个内部思考链去向拥有特权证据的 Teacher 拟合,不仅无法增强逻辑推理能力,反而会导致严重的认知失调和过拟合。特权信息只能像“外科手术”一样,精准滴定在模型输出给外部环境的动作接口上。
3. 辅助损失 vs. 优势调制
实验同时对比了类似 SDAR 的全局门控辅助蒸馏损失方案(保留相同特权上下文,但通过额外的 Cross-Entropy Loss 蒸馏到全部有效 Token)。结果显示,该方案的平均得分比 EviSD 低了整整 5.8 个百分点,在多跳问答上的滑坡尤为严重。这直接印证了作者的判断:不要用外挂的硬性损失函数去干扰强化学习的目标,将其内化为优势值的幅度修正,才是兼顾稳定性与探索性的最优路径。
4. 对证据质量的鲁棒性:走向无标注落地
在实际落地中,许多业务场景可能缺乏高质量的人工支持证据标注。为此,作者在 Qwen3-1.7B 上进行了一项颇具实用价值的敏感度实验:人为地将训练集中的黄金支持性证据逐步替换为 HotpotQA 负样本库中检索出来的“相关但非金标”的干扰段落。
测试结果极为坚挺:
-
当把两篇黄金证据中的一篇替换为弱相关的检索段落时,模型的平均 EM 完全保持在 44.2% 未发生任何下滑;
-
哪怕将两篇黄金证据全部替换为外部检索到的相关段落,模型的平均 EM 也仅从 44.2% 微跌 0.6 个百分点至 43.6%,依然大幅优于所有基线模型。
这一现象极具实践指导意义:它表明 EviSD 并不苛求极其纯净的“人造黄金证据”,只要通过简单的无监督检索获取与问题高度相关的上位文档,就能作为特权信息构建起极其有效的动作级自蒸馏机制。
总结与启示
EviSD 提供了一种构思精巧且极度实用的多轮搜索 Agent 训练方案。它既没有陷入在外部重型 Critic 之间反复调优的泥潭,也没有粗暴地在整条回答上强行施加可能导致分布崩塌的全局蒸馏,而是敏锐地抓住了“训练期证据作为检索动作的天然特权”这一核心抓手。
通过“动作对齐路由”、“动作片段掩码”以及“保持 GRPO 符号的有界调制”三位一体的设计,EviSD 成功实现了用极小的改动撬动极大的性能飞跃:
-
它保留了标准强化学习纯粹的探索方向与零开销部署特性;
-
仅用不到 15% 的关键 Token 信用微调,彻底盘活了复杂多轮交互中的信度分配死结;
-
对证据纯度的高容忍度,更为其在工业级复杂垂直搜索系统中的落地铺平了道路。
在探索大语言模型向高阶自主智能体演进的道路上,如何让训练时期的“先验元数据”以最克制、最合乎数学逻辑的方式反哺给自主决策策略,EviSD 无疑给出了一个教科书式的示范。