HLSmith:给大模型装上硬件专家直觉,C转HLS实现4.24倍加速与100%仿真通过
HLSmith: An Expert-Guided Agentic Framework for C/C++-to-HLS Translation
把一段普通的 C/C++ 代码编译成能在 CPU 或 GPU 上运行的高性能软件,现代编译器已经能替工程师扛下大部分重活;但如果目标平台换成现场可编程门阵列(FPGA),游戏规则就会彻底改变。
ArXiv URL:https://arxiv.org/abs/2608.06791v1
在硬件高层次综合(High-Level Synthesis, HLS)领域,开发者表面上虽然仍然在编写 C/C++ 代码,但每一行代码本质上都在描摹底层的硬件电路、数据流通道、缓冲队列和时钟节拍。这导致即使是目前最前沿的通用大语言模型(LLM),在面对 C 转 HLS 任务时也频频受挫:它们能够写出语法挑不出毛病、甚至在纯软件环境运行通过的代码,却普遍缺乏硬件设计直觉,无法遵循硬件专家的推演逻辑,导致综合出的硬件电路要么时延极高,要么直接无法在真实的 RTL 仿真中跑通。
来自阿贡国家实验室(Argonne National Laboratory)、西蒙菲莎大学(Simon Fraser University)与明尼苏达大学(University of Minnesota)的研究团队给出了全新的破局思路。他们提出的 HLSmith 框架将 C 到 HLS 的转换重新定义为“硬件微架构演进”,而非单纯的“代码翻译”。该框架不仅提炼了硬件专家优化技巧并将其模块化、守卫化(guarded recipes),还通过分阶段编译反馈与模型适配策略,让 LLM 能够像资深硬件工程师一样逐步重构代码。
在经典的 PolyBench 基准评测中,HLSmith 面对同类最先进的智能体编排框架 ChatHLS 时,实现了 100% 的软硬件跨层级仿真通过率(ChatHLS 仅为 57%),并在测试集上达成了 4.24 倍的几何平均加速比,单算子峰值加速更是高达 252 倍。这一成果清晰地揭示了 AI 在复杂 EDA 垂直场景中真正落地的关键:单纯依赖大模型泛化能力远远不够,必须把严密的工程依赖关系显式编码进编排系统。
为什么写 HLS 不是“代码重写”,而是“架构重塑”
要理解通用大模型在硬件加速领域的困境,必须看清软件逻辑与硬件电路之间深刻的范式代差。通用大模型在刷 LeetCode 或写日常 Python 脚本时表现出色,是因为这些代码共享了“指令顺序执行”的通用图灵机模型。但在硬件描述中,性能主要来自于空间并行、精细的流水线重叠以及片上局部存储架构的定制。
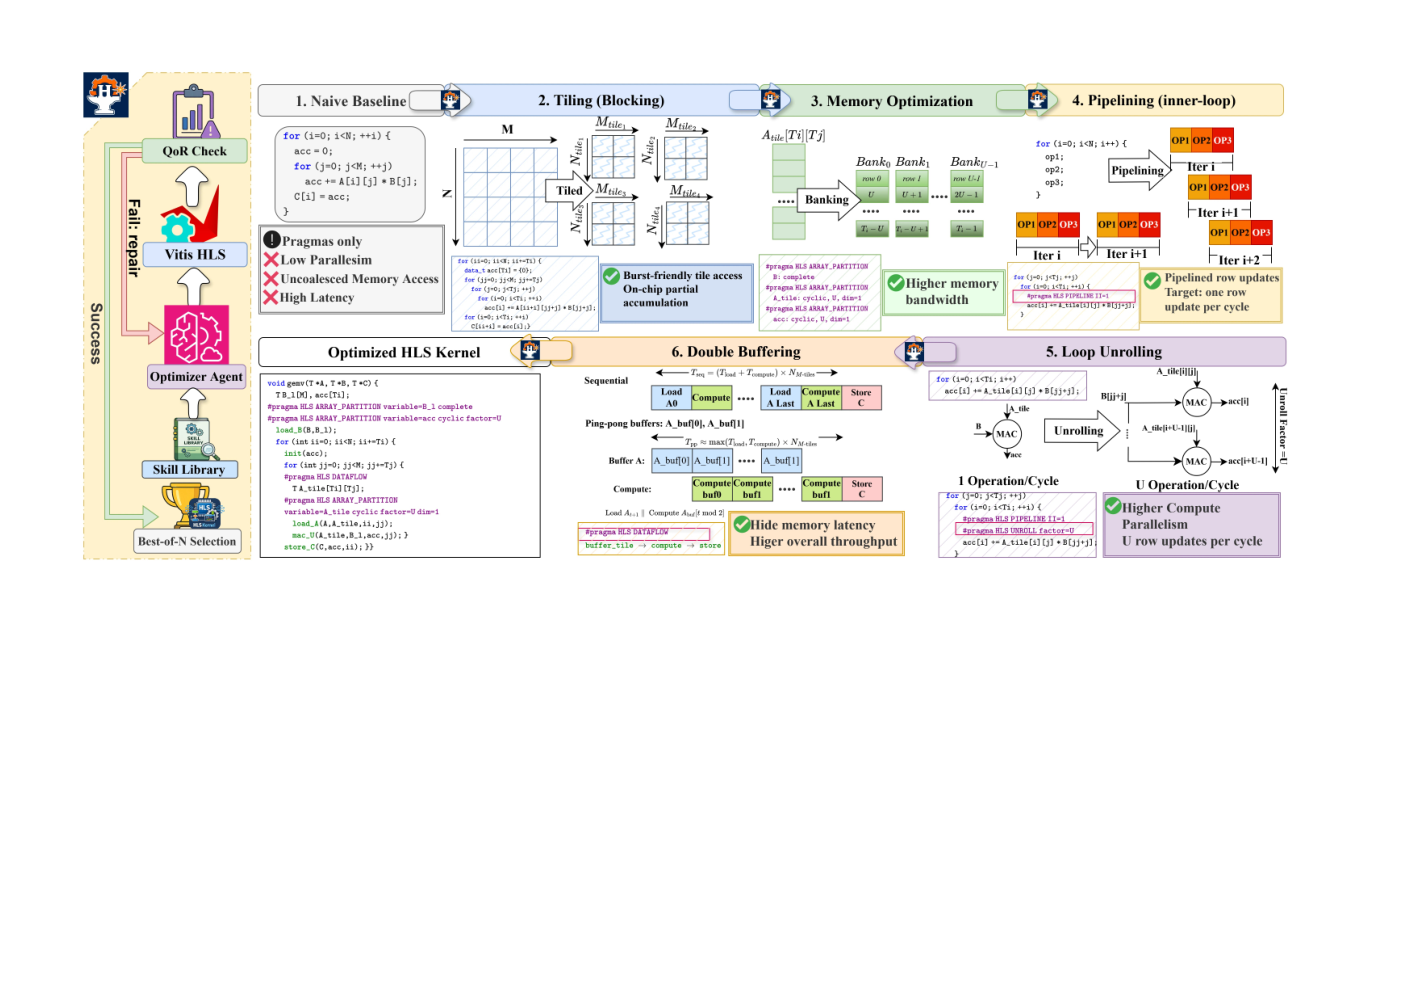
当人类专家拿到一段原始的朴素 C 代码时,通常会执行一套具有强前置依赖的微架构转换过程:
首先,为了缓解外部存储器带宽瓶颈,需要通过分块(Tiling)将数据搬运到芯片内部的片上缓存(BRAM/URAM);
其次,为了喂饱并行算力单元,需要将存储数组做多通道划分(Array Partitioning/Banking),提供成倍的物理读写端口;
随后,在计算核心循环展开(Loop Unrolling)并搭建精密的流水线(Pipelining);
最后,还需要构建乒乓双缓冲(Double Buffering)机制,让数据搬运和核心计算在时域上彻底重叠。
在这一连串动作中,操作顺序具有绝对的因果约束。如果前一步没有正确开辟局部缓存,盲目插入流水线 Pragma 只会导致综合工具报出致命的时序冲突或端口争用;如果在没有多端口物理支持的情况下激进展开计算循环,硬件资源消耗会瞬间爆炸,最终导致布局布线失败。
市面上的多数探索主要依赖通用智能体进行单轮 Prompt 生成,或是依靠简单的语法检查报错让大模型不断自我修复。这种“把头撞向编译器”的盲目重试,完全忽略了微架构转换的拓扑序。不仅生成的候选设计良品率极低,而且由于每次大修改都会破坏上一轮的微结构平衡,导致设计探索在巨大的状态空间中四处游荡,无法收敛到全局最优。
把专家直觉做成“守卫知识库”
HLSmith 的首要核心创新,在于彻底放弃了“让模型自由发挥硬件创造力”的幻想,转而从真实的硬件专家优化模式中(如 Rodinia-HLS 等高质量代码库)提炼出一套具备严密状态约束的优化知识库。
在 HLSmith 中,每一项硬件优化策略都被精确抽象成一个带有先决条件的数学元组:
\[s = \langle b, p, a, q, g, e\rangle\]其中包含了六大核心要素:
-
$b$(Bottleneck):针对的硬件瓶颈类型(如内存端口争用、循环间数据依赖、吞吐量不足等);
-
$p$(Prerequisites):当前代码必须具备的先决结构条件;
-
$a$(Applicability):适用范围的严格判定规则;
-
$q$(Strategy):具体的架构转换策略;
-
$g$(Safety Guards):必须避开的破坏性编辑与不安全操作;
-
$e$(Execution Steps):有序的源码级别重写动作指南。
这种元组设计将优化动作切分成了五大主流微架构族系:局部空间分块(Tiling)、深度流水线化(Pipelining)、计算展开与存储切分(Unrolling with Memory Banking)、双缓冲阶段重叠(Double-buffered Stage Overlap)以及访存合并(Memory-access Coalescing)。
更关键的是其中的“安全守卫机制”。过去很多 LLM 在为循环添加展开指令时,经常会漏改数组索引或破坏循环终止条件,产生死锁或功能错误的电路。HLSmith 的知识库明确规定了大模型在调整代码时“绝不能触碰的结构底线”。通过显式的守卫规则,智能体被严格限制在安全的变换边界内,从机制根源上杜绝了伪合法代码的生成。
诊断驱动的分步演进与动作路由
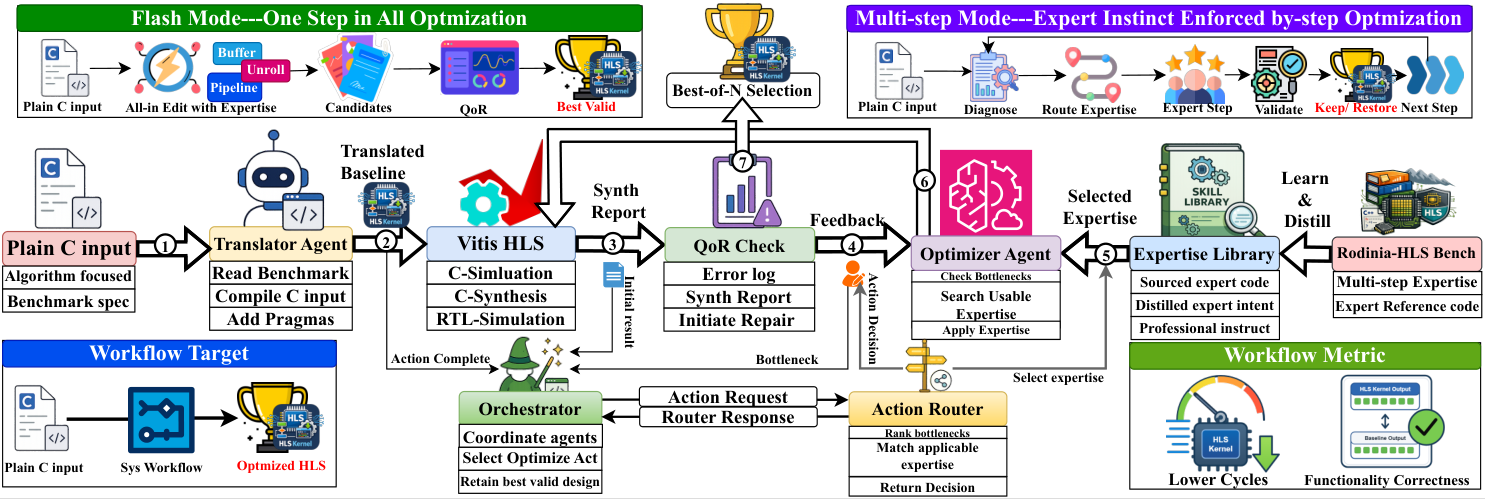
有了模块化的专家知识库,系统如何将其编织进自动化设计流程?HLSmith 搭建了一套分阶段、由编译器直接提供反馈的编排流水线。
整个流程不是一蹴而就的单次代码生成,而是交织着真实工具链验证的渐进探索循环:
-
翻译与初基线建立:Translator 智能体先将原始 C 代码转换成首个满足 Vitis HLS 语法规范的基准版本,由 Vitis 跑出最初的 C 综合报告;
-
瓶颈诊断:Profiler 与 Diagnoser 智能体解析 Vitis 的硬件报告,定位当前电路的最深性能痛点——究竟是 II(Initiation Interval,流水线启动间隔)太大,还是片外存储访问打架?
-
动作路由与专家注入:内部的动作路由器(Action Router)依据当前诊断结论和现有代码结构,从知识库中检索出最匹配、且当前前置条件完全满足的优化项;
-
架构演进重写:Optimizer 智能体接收到带有严格约束的优化说明,对 C++ 源码进行微架构重构;
-
门禁校验与回滚:新代码立即送入底层 Vitis 工具链,只有同时通过 C 仿真(验证功能)、C 综合(验证硬件可实现性与时序)并在目标芯片资源约束内的版本,才能作为下一步迭代的新基线。
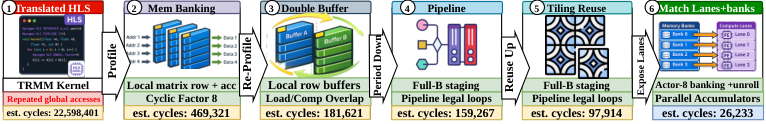
以矩阵三角求解算子 TRMM 为例,HLSmith 的演进过程极其清晰地复现了硬件架构师的调优思路:
第一步,先打通基本代码逻辑并实现基础访存打包;
第二步,利用局部数组构建分块,打破对外部全局内存的频繁吞吐;
第三步,对内层循环做展开,并精确匹配片上 BRAM 的 Bank 划分,解决局部并行带来的端口冲突;
第四步,引入多阶段缓冲重叠执行。
从图中的真实时延走势可以看到,中间每一次代码演进都伴随着 Vitis 评估时钟周期数的阶梯式暴跌,最终生成的 RTL 级电路在真实仿真中展现出极致的吞吐性能。
双层混合路由:用极小算力剪掉低效探索
硬件编译(尤其是高层次综合与随后的 RTL 联合仿真)是非常耗时的过程,一次完整的验证往往需要耗费数分钟到数十分钟。如果盲目遍历所有的优化路径或深度,算力开销将不可承受。
为了兼顾效率与设计质量,HLSmith 设计了一套“双层混合路由器”机制。除了前文提到的在迭代内部决定下一步做什么的内部动作路由器外,还引入了一个前置工作流配置路由器(Early-prediction Setup Router)。
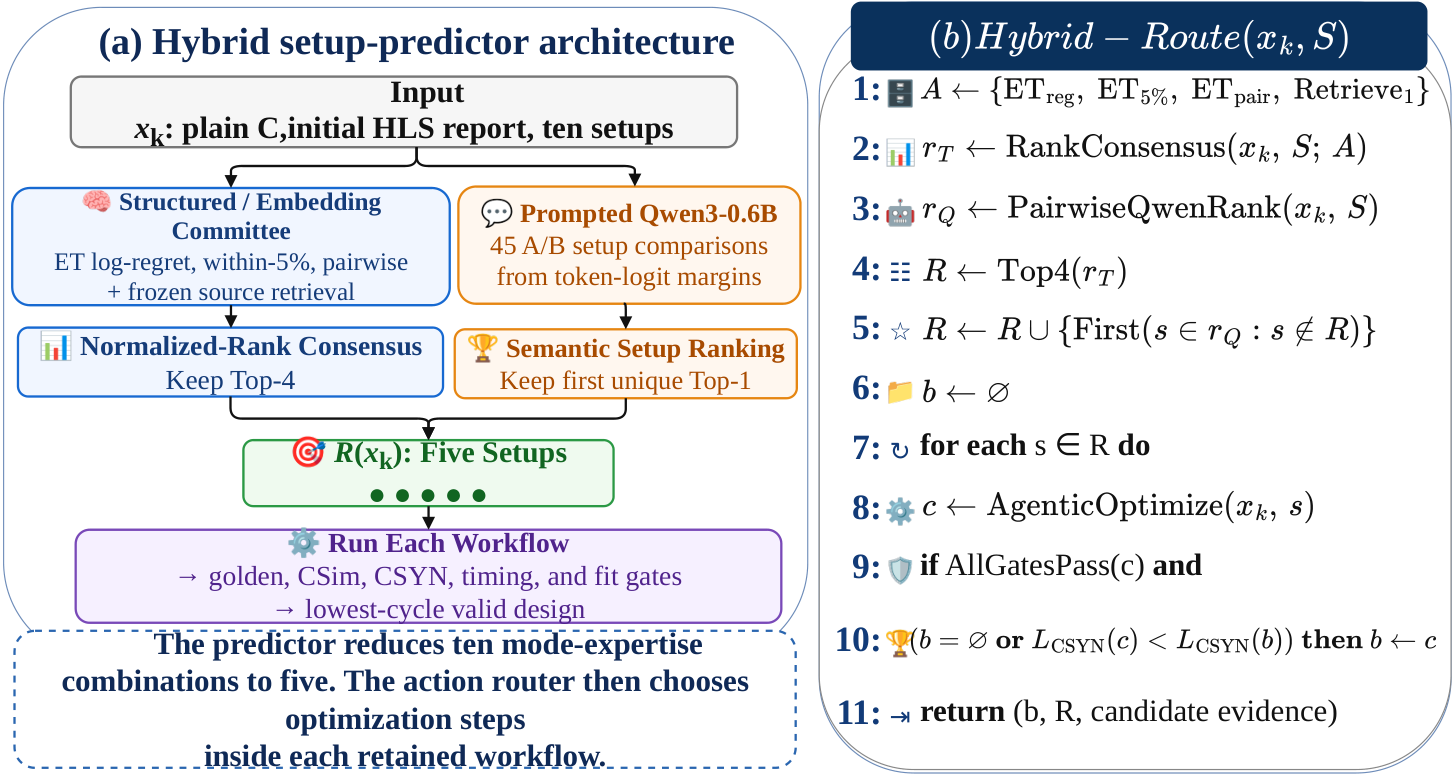
该路由器在工作流启动前生效。它仅仅阅读原始 C 代码的静态 AST 结构特征以及初始未优化的粗糙 HLS 报告,就提前预测该算子应该采用极速单轮模式(Flash)还是深度多步迭代模式(Multi-step),以及应该注入哪种粒度的专家知识。
该路由网络由一个结构化排序委员会(基于 ExtraTrees 树模型)和一个独立语义比较器组成,两者将各自的建议进行融合。实验结果显示,这一前置路由机制直接在探索开始前剪掉了整整 50% 的低价值配置分支;同时,在被测试的 19 个独立算子开发集中,依然保留了 18 个算子最终进入最优方案 5% 时延容差范围内的能力,最大程度避免了算力在平庸设计路径上的无谓空转。
从闭源商业巨头到轻量开源模型的后训练
虽然 Claude 4.6 或 Opus 这类闭源商业大模型在配合专家库时展现出了惊人的理解力,但在实际芯片设计与工业落地场景中,出于数据隐私与部署成本考量,完全依赖商业云端 API 往往不切实际。研究团队进一步探索了如何把这套“硬件专家直觉”沉淀并转移到轻量级开源大模型上。
他们采用了两套互补的后训练(Post-Training)管线:
一是离线有监督微调(SFT)。研究者将强大的前沿商业模型在专家库引导下探索出的大量高质量轨迹进行清洗,把每一个包含“当前硬件报告上下文 + 目标优化动作 + 最终通过 Vitis 严苛门禁的代码”打包为样本对 $\mathcal{D}^{+}$。这里的关键准则是工具落地驱动——任何无法通过 C 仿真、时序违例或超出了 FPGA 物理资源(LUT、DSP、BRAM)上限的代码,统统从训练集中剔除。开源基座模型通过模仿这些被硬件工具链校验过的优质动作,迅速掌握了符合 HLS 语法的合规改写范式。
二是面向硬件结果质量(QoR)的分组相对策略优化(GRPO)强化学习。为了直接促使模型追求极致的吞吐量,研究团队把单步生成建模为上下文老虎机问题,设计了一个三段式综合奖励函数:
\[\widetilde{r}_{k,i}(h) = b + \alpha h\left(\frac{L_{k}^{0}}{L_{k,i}}\right) - \beta\sum_{d}\max\left(0, \frac{U_{k,i,d}}{B_{d}} - 1\right)\]该奖励函数设定了明确的奖惩阶梯:不仅有基础的功能正确门槛分 $b$,更将相对基线时延的加速比比值 $\frac{L_{k}^{0}}{L_{k,i}}$ 作为核心拉升奖励;与此同时,一旦任何一项硬件资源利用率 $U_{k,i,d}$ 突破芯片的物理容量极限 $B_d$,就会触发严厉的线性惩罚。
经过这套软硬结合的强化训练,即使是参数量中等的开源模型(如 Qwen 系列和 Gemma 系列),在面对 gesummv 这类线性代数经典算子时,时延周期直接从基线的 64,835 周期大幅压缩至 4,987 周期,单项提升达到 13 倍,成功掌握了循环拆分、向外流水线化与归约展开等高级硬件重构技巧。
严苛评测:100% 正确率与数倍的实际加速
在评价指标方面,HLSmith 研究团队设定了比以往类似工作更加严苛的门禁条件。在硬件加速领域,仅仅声称“C 代码跑通了”没有任何意义,必须经历综合、布局布线评估,并由底层的 RTL 协同仿真(Co-Simulation) 最终判定波形与时序的完全一致。
以目前最具代表性的 HLS 智能体系统 ChatHLS 作为直接对比标杆,双方在 14 个同台测试的 PolyBench 算子上展开了正面交锋:
在功能正确性与鲁棒性上,ChatHLS 在面对真实的 RTL 联合仿真检验时显露出疲态,仅在 8 个算子上拿到了有效结果,有效通过率仅为 57.1%;而 HLSmith 在专家守卫机制的兜底下,14 个算子全部通过了 RTL 协同仿真,达成了 100% 的完美通过率。
在生成硬件的执行性能上,排除掉 ChatHLS 失败的算子,仅在双方共同跑通的 8 个基准测试算子上进行对比,HLSmith 生成的设计展现出了压倒性的周期优势,相对于 ChatHLS 达成了 6.91 倍的几何平均加速比。即便是剔除对结果波动影响极大的特大算子(syr2k)之后,在其余算子敏感性分析集中,HLSmith 依然稳定保持着 4.24 倍的几何平均加速。
而在更广阔的算子搜索空间中,当 HLSmith 搭载顶尖商业模型进行深度多步探索时,面对基准初始实现,峰值加速比冲到了 252 倍;即使完全依靠微调后的开源权重模型,峰值加速也达到了 138 倍。
给智能体设计带来的长期启示
HLSmith 的价值不仅在于刷新了几个基准数据集的打分,更在于它向工业界和学术界展示了一种处理极高壁垒工程任务的方法论范式。
长期以来,很多试图将 LLM 引入专业工程领域的研究陷入了一种误区:要么寄希望于大模型凭借数十亿甚至万亿参数的隐式知识“无师自通”;要么仅仅把大模型当做单向代码输出器,把下游编译器当做报错日志打桩机。
HLSmith 的成功证明了相反的路径:对于 EDA 这种容错率极低、物理约束极强的严苛场景,最有效的智能体架构应当是“外紧内松”的。外层由极其严密的专家约束图谱、先决条件检查器和双层路由器构成冰冷强韧的工程骨架,确保每一次探索都在合法的拓扑序列上前进;内层的语言模型则专注于在这个被大幅压缩、高度确定性的安全语义空间中,释放其最擅长的代码生成与局部语法转换能力。
当大模型的泛化能力真正嵌合进经典硬件设计的拓扑骨架之中,将算法工程师手头数以万计的存量 C/C++ 业务逻辑一键转化为高效片上硬件加速器的愿景,才算真正迈出了坚实的一步。