LAWM-3D:破解人类视频动作捷径,具身世界模型泛化新范式
LAWM-3D: Learning 3D-Aware Latent Actions from Human Videos for Generalizable Robot World Models
让机器人在脑海中预演未来,是实现通用具身智能的核心途径。世界模型(World Models)为此提供了一种内在环境模拟器,使智能体无需在物理世界中进行试错,就能依据动作条件推演未来画面的演变,进而完成复杂的轨迹规划与策略决策。然而,在开放多变的现实场景中,构建通用的机器人世界模型长期受制于一个根本矛盾:真实机器人的动作标注极其昂贵、采集周期漫长,且不同机械臂与末端执行器的物理结构差异巨大,导致动作空间难以统一。
ArXiv URL:https://arxiv.org/abs/2608.05706v1
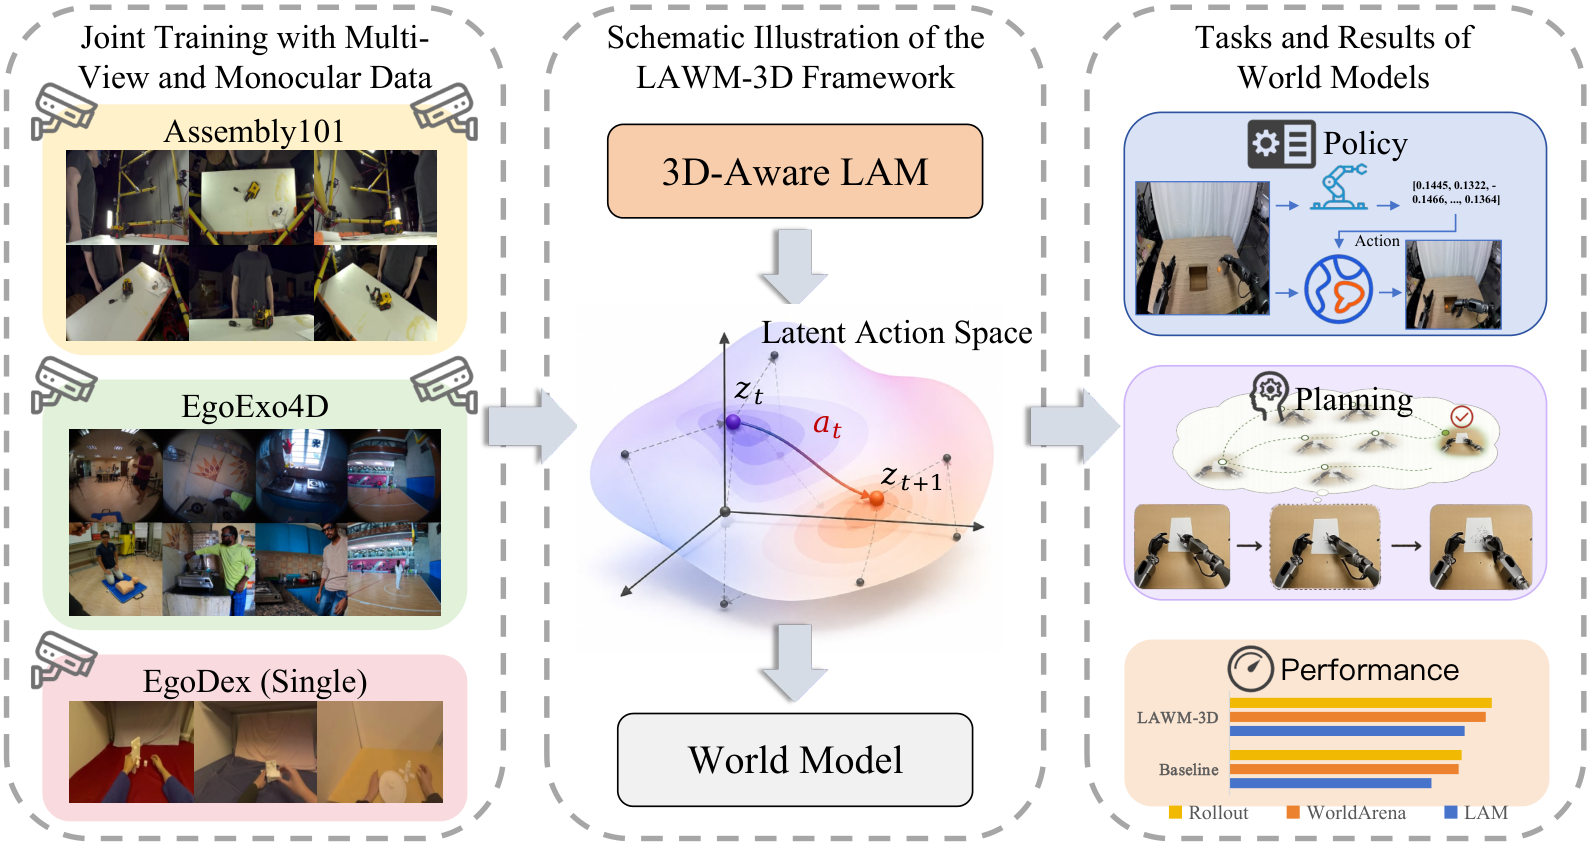
为了打破标注瓶颈,学术界近期将目光投向了无监督的“潜在动作模型”(Latent Action Models, LAM)。这类方案的核心思想,是从海量无标注的人类日常视频中,自监督地反推帧与帧之间的隐式状态转移,把人类五花八门的操作抽象为连续或离散的潜在动作编码。例如 DreamDojo 等前序工作,已经证明了用人类视频提取动作表征来预训练世界模型的巨大潜力。
但现有 LAM 几乎都建立在单视角视频与二维像素空间之上。当智能体试图根据 2D 潜在动作去推演三维世界的物理交互时,往往会遭遇严峻的几何失真与接触崩塌——机器人手臂可能会凭空穿透物体、物体的深度与三维姿态无法自洽。哈尔滨工业大学、南开大学、洛桑联邦理工学院(EPFL)与清华大学的研究团队提出了一个直接而尖锐的疑问:直接把多视角视频塞给现有的潜在动作模型,模型就能自然而然学会 3D 感知吗?
研究表明,答案是否定的。纯粹堆叠多视角视频不仅无法自动获得 3D 动作理解,反而会暴露出深层结构性缺陷。为此,研究团队提出了 LAWM-3D 框架,通过揭示并修补传统自监督训练中的“信息泄露捷径”,首次在无标注视频中成功提取出具有真实 3D 几何一致性的潜在动作,并在 16 项评测指标与严苛的分布外(OOD)泛化测试中刷新了 SOTA 表现。
为什么朴素的多视角自监督行不通?
在深入 LAWM-3D 的设计之前,必须先理解为什么简单的“多视角数据扩充”会在潜在动作学习中彻底失效。研究团队在剖析传统 LAM 的训练机制时,发现了三个致命症结:
其一是未来帧的外观信息泄露(Future-Frame Appearance Leakage)。常规潜在动作模型通常采用变分自编码器(VAE)结构:编码器吃进相邻两帧图像 $f_t$ 和 $f_{t+1}$,压缩得到潜在动作 $\mathbf{a}$,再由解码器基于 $f_t$ 与 $\mathbf{a}$ 尝试重建 $f_{t+1}$。这种训练目标存在天然的“作弊捷径”。因为自编码器要尽可能完美地在像素级复原下一帧,编码器往往不会费心去抽象真正的物理运动动力学,而是倾向于将 $f_{t+1}$ 中的高频纹理、光照、背景等静态外观信息直接打包进动作变量 $\mathbf{a}$。换言之,动作变量退化成了未来画面的压缩包,而非驱动状态改变的运动矢量。
其二是视角间的外观差异与视点变化(Viewpoint Variations)。现实采集的人类视频(如包含头戴视角与多路旁观视角的 Ego-Exo4D)并不具备完美的色彩校准与同构成像条件。不同机位之间的光照反射、视角遮挡与传感器差异极大。如果缺乏显式的三维空间约束,模型在像素空间强行比对不同视角时,会被视角相关的低级视觉统计特性牢牢绊住,无法提取出视角无关的几何语义。
其三是二维投影缺乏显式几何对应。多视角相机虽然从不同角度记录了同一事件,但它们在本质上依然是 3D 世界向 2D 平面的离散投影。仅凭重构损失,模型无法凭空建立跨视角的点云级、体素级空间对应关系。最终,潜在动作模型只能在 2D 像素变化的表层打转,下游世界模型在推演空间移动时自然频频“翻车”。
针对这三重挑战,LAWM-3D 没有选择单纯堆砌参数或增加损失项,而是围绕“强制模型关注几何运动”这一统一动机,构筑了三层紧密咬合的核心机制。
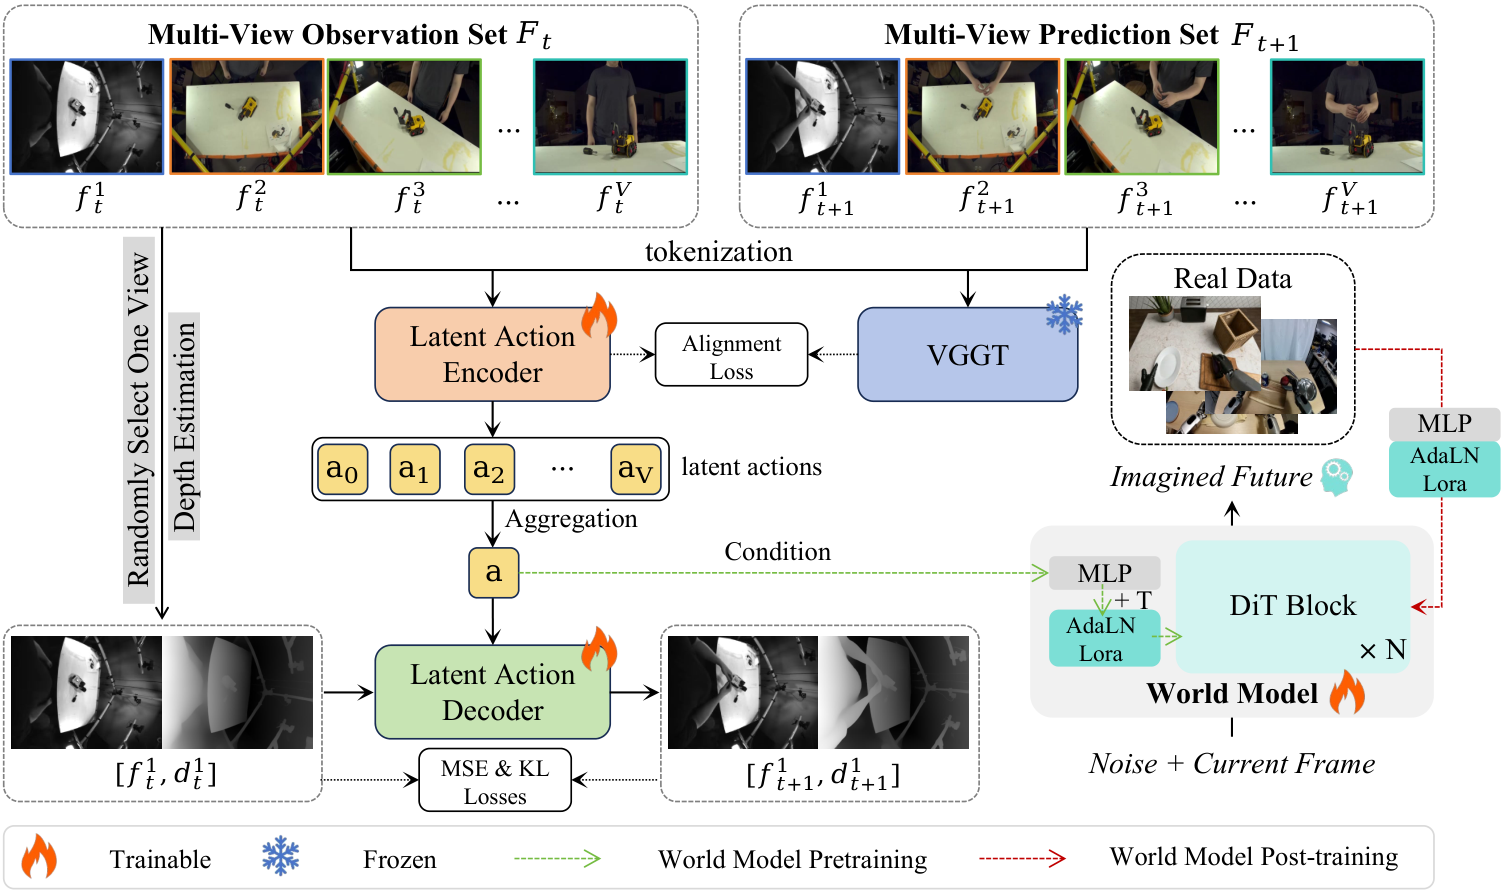
(注:架构图展示了从多视角编码、VGGT 几何对齐到 RGB-D 非单射解码的全流程)
机制拆解:跨视角不变性与几何锚定
LAWM-3D 的整体管线分为三个有机阶段:首先在多视角与单视角视频混合数据上预训练 3D 潜在动作模型;接着利用提取出的三维潜在动作预训练视频世界模型;最后在真实机器人数据上微调,实现潜在动作与实际物理控制指令的对齐。整个框架最精妙的突破,集中在第一阶段的潜在动作编码与解码设计。
首先是多视角不变的统一动作 Token 编码方案(Unified Action Tokenization)。在物理空间中,客观发生的物体位移或人体手部操作是唯一的,不应该随观察者的站位改变而改变。为了迫使编码器捕获这种跨视角的一致性,LAWM-3D 采用了时空 Transformer 架构。对于任意单视角的相邻输入帧 $f_{t:t+1}^v$,由于双向自注意力机制的存在,$t+1$ 时刻的 Token 已经隐式聚合了从 $t$ 到 $t+1$ 的时序演变信息。因此,模型在编码器末端仅提取每个视角的 $a_{t+1}$ Token,并通过视角维度的聚合算子(如 Pooling)将其融合成全局统一的潜在表征,进而参数化高斯分布。
更为关键的是训练时的“随机视角掩码”(Random View Masking)机制。在输入多视角集合时,系统随机丢弃部分视角(至少保留一个视角),而在解码重建阶段,随机抽取被保留视角中的某一个进行未来帧预测。这种强迫网络在信息残缺下依然必须重构目标视角的做法,彻底切断了潜在表征对单一视角视觉上下文的依赖。与此同时,这种统一动作空间的设计赋予了 LAWM-3D 极强的灵活性:它既可以在包含 7 个视角的丰富多视角数据集上联合训练,也能无缝接入普通的单视角第一人称视频;到了推理部署阶段,模型仅需单视角输入便可平滑退化运行,丝毫不损失稳健性。
其次是基于 3D 基础模型的几何表征对齐(Geometric Representation Alignment)。既然二维像素重建无法自发学会真实深度与三维点位,LAWM-3D 选择引入预训练的 3D 基础模型 VGGT 来充当几何先验的“引路人”。不同于以往工作直接在扩散模型输出端进行全局对齐的粗放做法,LAWM-3D 将对齐锚点精准锁定在动作编码器 ViT 的中间层特征上。
设编码器在特定中间层的特征为 $h$,VGGT 提取的空间几何特征为 $y$。研究团队设计了一组协同的几何对齐损失函数:一方面通过角度损失(Angular Loss)最大化两者特征向量的方向余弦相似度,确保几何方向的感知对齐;另一方面通过尺度损失(Scale Loss)利用投影网络匹配模长分布。长公式表达如下:
\[\mathcal{L}_{\text{Angular}}=-\frac{1}{KVP}\sum_{k,v,p}\cos\big(y_{k,v,p},\,f_{\phi}(h_{k,v,p})\big)\] \[\mathcal{L}_{\text{Scale}}=\frac{1}{KVP}\sum_{k,v,p}\left\|g_{\psi}\left(\frac{f_{\phi}(h_{k,v,p})}{\|f_{\phi}(h_{k,v,p})\|_{2}}\right)-y_{k,v,p}\right\|_{2}^{2}\]通过这两项显式几何拉拽,编码器被迫从早期的底层像素特征中跳脱出来,直接在特征提取的中间阶段就建立起符合三维空间结构的几何对应关系。
阻断捷径:非单射 RGB-D 联合重建
即使有了统一编码与几何对齐,只要解码器依然只负责吐出下一帧的 RGB 像素,自编码器就依然存在“钻空子”的冲动——它依然可能将微小的像素噪点或光影作为传递信息的隐蔽通道。为了彻底杜绝未来帧外观信息的泄露,LAWM-3D 提出了非单射 RGB-D 联合预测目标(Non-injective RGB-D Joint Reconstruction)。
这里的“非单射”指的是信息流向的单向不对称设计:在编码器端,输入严禁接触任何深度图信息,只能读取普通的 RGB 双帧;而在解码器端,模型除了输入当前帧 $f_t$,还会拼接当前帧的深度图 $d_t$,并强制要求解码器联合预测出下一帧的彩色图像与未来深度图 ${f_{t+1}, d_{t+1}}$。
这一设计的底层逻辑非常深刻:深度图去除了所有视点特异性的颜色、纹理与复杂光影,纯粹呈现物体在空间中的几何距离与轮廓结构。让没有接触过未来深度图的编码器,去通过潜在变量 $\mathbf{a}$ 驱动解码器生成精确的未来深度变化,就如同剥夺了模型的“像素抄近道”特权。潜在变量 $\mathbf{a}$ 无法再依靠偷运 RGB 纹理糊弄过关,它必须真正编码物体运动的矢量位移、手部操作引起的几何形态改变。最终,潜在动作模型被迫将所有监督信号聚焦在具有明确几何意义的物理运动线索上。
实验印证:空间物理一致性与 OOD 泛化
在完成 3D 潜在动作模型的预训练后,团队基于开源世界模型基座 Cosmos-Predict2.5 构建了完整的条件扩散世界模型,并通过 MLP 将潜在动作序列注入到 DiT 模块的自适应层归一化(AdaLN)中进行协同演化。
为了验证这套机制是否真正赋予了世界模型更强的物理认知,研究团队在包含多种现实操作任务的世界模型基准测试 WorldArena 上进行了极其严苛的对比。评测涵盖了视觉质量、运动质量、3D 空间精度、物理规律遵从度等 6 大维度共 16 项客观指标。
定量测试表明,在同等参数量与分辨率设定下,LAWM-3D 相比 Genie Envisioner、RoboMaster、DreamDojo 等代表性方案展现出压倒性的优势。过去大部分基于单视角 2D 潜在动作的模型,在画面清晰度(如 PSNR、SSIM)上或许表现平平或仅略有波动,但在与交互动作密切相关的“动作保真度(Action Fidelity)”、“运动质量(Motion Quality)”以及“3D 几何准确度”上均出现断崖式落后。LAWM-3D 在生成视频的三维点云投影与深度一致性指标上大幅领先,证明其潜在动作切实包含了真实的空间运动动力学。
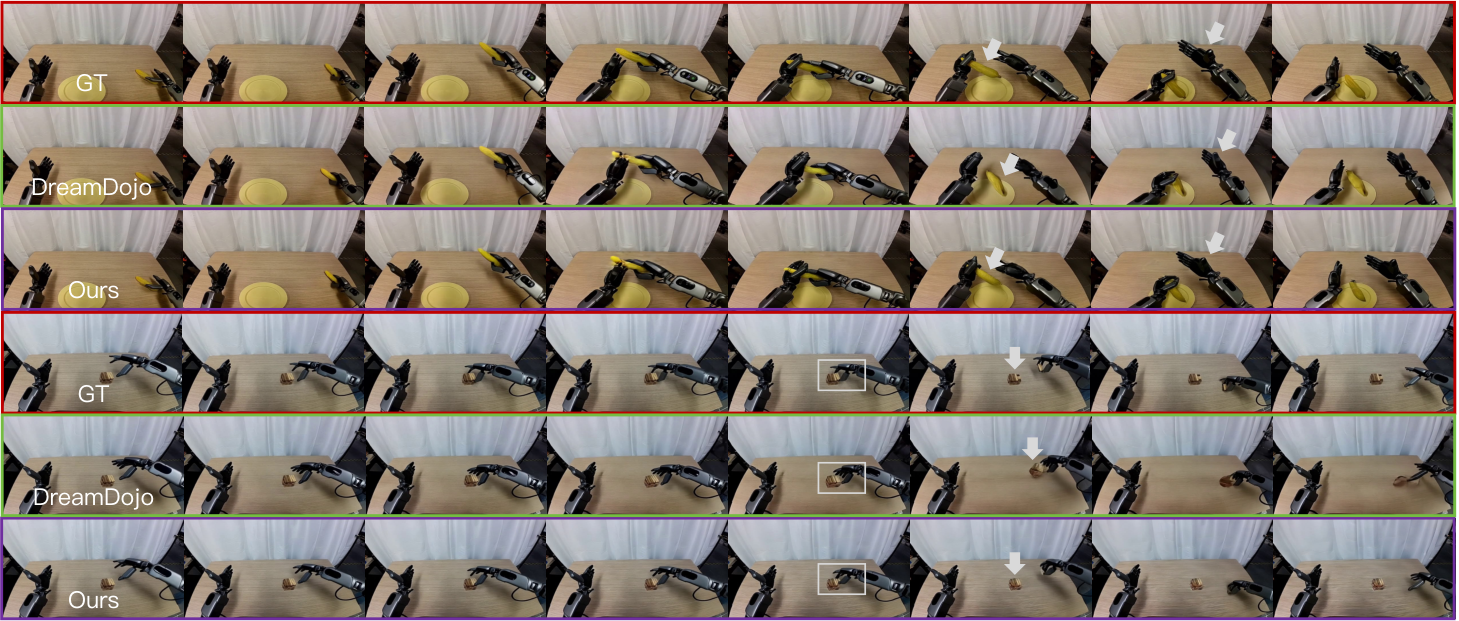
上图展示的真实操作推演序列,生动揭示了 2D 潜在动作与 3D 潜在动作在物理常识层面的云泥之别。在香蕉抓取与积木空间重排任务中,基线方法 DreamDojo 出现了灾难性的形变与幻觉:香蕉在受力瞬间发生非物理的扭曲与拉伸,积木在空间位移时出现深度错乱与结构坍塌;而 LAWM-3D 生成的未来序列在接触动力学、几何轮廓保持和空间三维深度分布上,几乎与真实物理世界的 Ground Truth 保持同步。这表明,3D 感知动作真正教会了世界模型理解“物体是一个刚性或半刚性的三维实体,而不是一张变色变光的光栅画布”。
更具实践意义的是智能体的跨场景泛化能力。现实世界中机器人面临的物体、光照和背景无穷无尽。在预训练仅使用人类视频的前提下,团队将世界模型仅在简单的机械臂交互数据上做少量后训练,直接扔到未见过的实验室环境(In-lab Eval)、全新视角与物体集(EgoDex Eval)以及 DreamDojo-HV 评估集上进行分布外(OOD)测试。
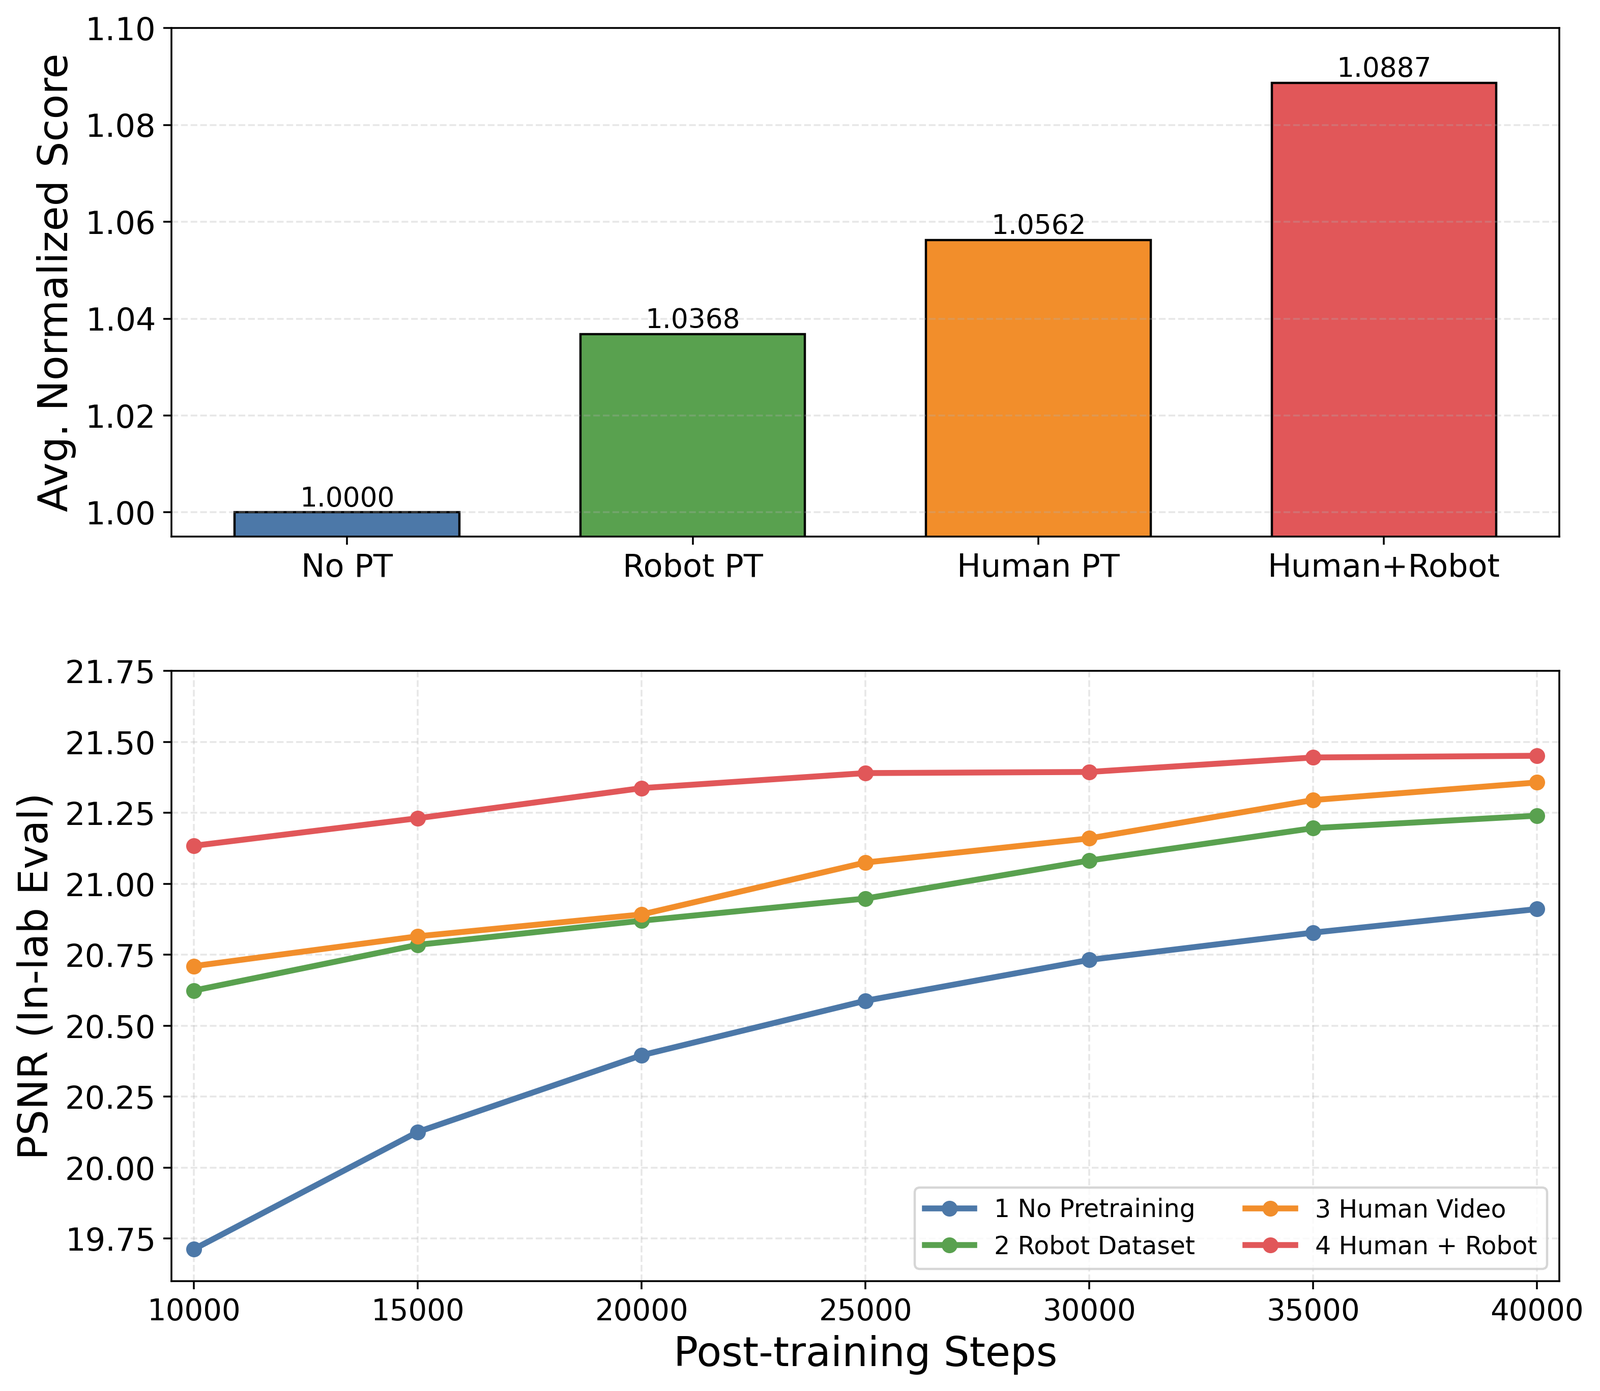
从组件消融与数据源实验分析中,可以清晰提取出两个核心结论:
第一,单纯引入多视角数据(Case1)甚至会因为视角差异导致生成指标发生抖动;只有将多视角、VGGT 几何对齐与 RGB-D 非单射解码三者完全耦合成全功能版本(Default)时,世界模型的跨场景 OOD 泛化分值才迎来质的飞跃。
第二,在针对不同预训练数据源的对比中(如上图),仅用机器人数据预训练的表现,明显弱于包含人类视频的大规模预训练;而将海量人类视频与机器人视频进行联合预训练,世界模型的综合性能得分从基准的 $1.0000$ 飙升至 $1.0887$。更关键的是,从 PSNR 收敛曲线可以直观看到,利用人类多视角视频注入 3D 动作先验的世界模型,微调收敛速度呈倍数级提升,下游适配所需的优化步数与真实交互数据量大幅压缩。
走向通用的具身动作基座
回顾整个研究,LAWM-3D 带来的核心启示并不局限于某一个特定损失函数的有效性,而是从根本上指出了利用互联网海量非结构化人类视频训练机器人的关键阻碍——自监督模型往往是“极具惰性”的捷径学习者。
如果不通过几何机制切断未来信息的泄露,AI 会永远停留在二维像素表象的重构中,而无法真正触及具身智能所必需的三维时空物理规律。LAWM-3D 证明了,即便输入的是单双目混杂、机位不规范、没有机械臂外骨骼标注的人类生活日常录像,只要施加合理的空间对齐与非单射深度约束,同样能够榨取出高保真、跨视角不变且可直接用于驱动真实机器人规划决策的 3D 潜在动作流。这种两阶段的泛化扩展范式,无疑为跨平台、跨形态机器人世界模型的规模化进化,铺就了一条极具可行性的工程与理论路径。