SiMDex:像推荐系统一样精选5%人类视频,灵巧手成功率达61.1%
SiMDex: Mining Similar Egocentric Videos for Cross-Embodiment Dexterous Manipulation
在具身智能领域,基于视觉-语言-动作(VLA)模型的大脑正在快速进化,但高自由度灵巧手的物理落地却长期被困在“数据荒漠”中。双臂多指灵巧手的远程遥操作极其昂贵、繁琐且难以大规模泛化,导致真实机器人示教数据往往停留在几十个小时的微小量级。为了打破这一瓶颈,研究社区此前寄希望于利用大规模人类第一视角(Egocentric)视频来补充操作先验。
ArXiv URL:https://arxiv.org/abs/2608.04196v1
然而,将成千上万小时包含做饭、社交、运动的人类第一视角视频直接倒给机器人,往往适得其反。未经筛选的异构数据不仅混入大量无意义噪声,还会稀释针对特定操作任务的关键轨迹监督。面对这个难题,来自字节跳动、上海交通大学、清华大学、香港大学和东京大学的研究团队提出了全新视角:将大模型时代的后训练数据选择转化为一个成熟的“工业级推荐系统问题”,并推出了相似性数据挖掘框架 SiMDex。
该框架不改动任何现有的 VLA 模型网络结构,从包含约 3200 万个样本的人类视频切片池中,仅精准挖掘出不到 5%(约 149 万)的高相关样本。在三项严苛的双臂灵巧手真机操作任务中,SiMDex 将平均任务成功率从 47.7% 拉升到了 61.1%。更关键的工程启示在于:在遥操作示教极端匮乏的低数据区间,借助精准挖掘的人类经验,机器人仅需约 6 小时的示教数据,就能匹敌甚至超越基线在 25 小时示教下的表现,相当于将昂贵的数据采集成本压缩了近 4 倍。
痛点破局:从盲目堆量到按任务精准检索
大语言模型(LLM)的发展早已证明,盲目扩展未经清洗的 Web 语料库会迅速遇到边际效应递减,高质量的精选子集(Curated Data)往往能超越更大规模的脏数据。而在具身机器人学习中,现有的数据筛选工作大多停留在机器人自身数据集内部的样本加权或过滤,少数引入人类视频的探索也大多局限于几十条视频的小型样本库,或者需要专门修改策略架构、引入额外的上下文示例模块。
SiMDex 试图解决一个更本质的问题:既然预训练阶段已经吞下了海量第一视角视频,那么在针对特定任务进行微调(Post-training)时,应该怎样以示范轨迹为锚点,跨越具身形态的物理鸿沟,在数千万级的人类经验池中“大海捞针”?
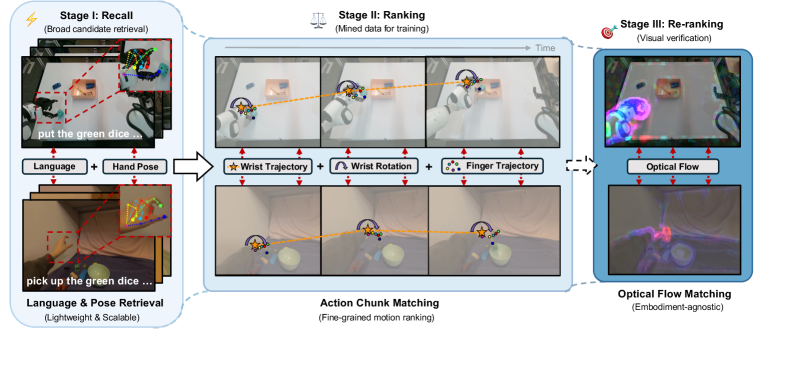
如上图所示,SiMDex 的核心逻辑在于将人类视频的复用从“单次粗放使用”转变为“按需精细淘金”。对于给定的每一条机器人任务示范,算法并不去采集新的外源数据,而是反向检索既有人类视频库,借助统一的形态无关动作表征与多级级联漏斗,找到细粒度运动最接近的人类示范,直接参与下游联合训练。
统一表征:脱离构型依赖的 42 维几何空间
人类的手掌具有极其精细的生物软组织与关节自由度,而机器人的多指灵巧手(如五指灵巧手、三指夹爪)在电机布局和连杆运动学上截然不同。如果直接基于关节角度进行相似度匹配或行为克隆,跨具身映射几乎无法成立。
为了绕过这一形态鸿沟,SiMDex 采用了一种以指尖为核心的局部几何表征。无论是机器人的远程遥操作数据,还是从 EgoDex 等人类第一视角视频中提取出的手部三维姿态,系统都会提取每一帧的手腕三维位姿 $\mathbf{T}{t} \in \mathbb{R}^{4 \times 4}$ 与五个指尖的世界坐标 $\mathbf{q}{t} \in \mathbb{R}^3$。随后,算法将指尖坐标全部转换至当前手腕的局部坐标系:
\[\mathbf{q}^{\mathrm{loc}}_{t} = \mathbf{T}_{t}^{-1} \mathbf{q}_{t} \in \mathbb{R}^{3}\]这种转化的巧妙之处在于,它彻底剥离了机械臂在世界坐标系中的绝对基座位置,只保留手掌内部纯粹的抓握几何形态。双手的五个指尖局部坐标拼接为 30 维的手指状态向量,再配合左右手腕在相邻时间步内的局部平移与旋转增量(各 6 维,共 12 维),最终锁定了 42 维的共享动作向量 $\mathbf{a}{t} = (\mathbf{d}^{\mathrm{L}}{t}, \mathbf{d}^{\mathrm{R}}{t}, \mathbf{p}^{\mathrm{L}}{t}, \mathbf{p}^{\mathrm{R}}_{t}) \in \mathbb{R}^{42}$。该表征既不依赖特定机器人的正逆运动学解,也不受人类体型差异干扰,为后续千万级规模的高效比对奠定了数学基础。
三级级联筛选:工业推荐架构的具身化落地
面对约 3200 万个人类动作切片,若对每个机器人锚点轨迹都展开高精度的多模态动力学比对,计算开销将完全不可承受。SiMDex 借鉴了工业推荐系统的经典流水线,构建了一套由粗到精的三阶段级联机制(Recall-Ranking-Re-ranking),在算力成本与动作相关性之间取得了平衡:
-
第一阶段:粗召回(Recall)
追求极致吞吐量。系统结合了两个极轻量的先验特征:一是使用预训练语言模型将任务指令转化为文本嵌入,通过余弦相似度召回语意相符的视频片段;二是利用起始帧经过归一化的指尖姿态向量,在欧氏距离空间检索抓握预备手势最相似的样本。通过简单的倒排排名融合,海量候选池瞬间被压缩到极小范围。
-
第二阶段:细排序(Ranking)
重点对齐未来 30 步动作的时空动态一致性。在这个阶段,算法从四个互补维度进行细粒度比对:手腕平移速度曲线、手腕旋转速度曲线、指尖的三维运动轨迹,以及手腕末端执行器的空间轨迹。将四项指标的打分加权求和,并在原始视频序列级别做去重操作,保留每个源轨迹中得分最高的一条。这道工序筛出的样本集,实际上就已经构成了注入下游 VLA 训练的核心子集。
-
第三阶段:光流重排(Re-ranking)
作为最后的校验机制,此阶段跳出了运动学参数,回归底层视觉物理一致性。利用密集光流(Optical Flow)提取动作片段的像素级位移场,对比机器人视角与人类视角的整体运动趋势。这一步能够有效剔除“手势数值恰好对上、但实际物理交互完全风马牛不相及”的伪相似样本。
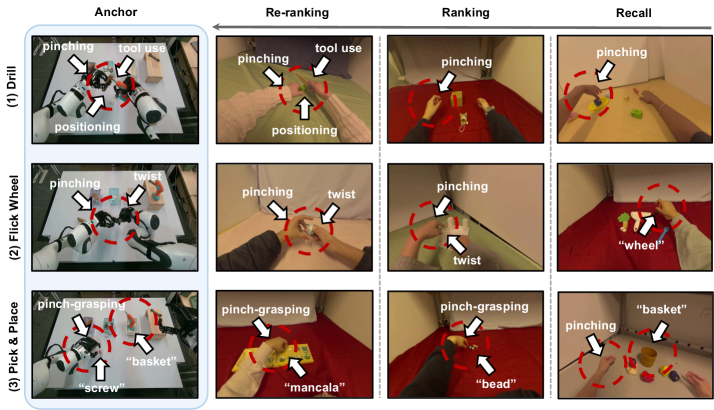
从上图的可视化演进中可以清晰看到各级漏斗的作用机制:在粗召回阶段,系统仅仅匹配了相似的起始姿势或提到了“轮子”“篮子”这类物体,但动作本身只是普通的平面平移;进入细排序后,手指的捏合、扭转弧度以及手腕的旋转节奏开始贴合目标;而最终的光流重排则确保了双手的协同语义——例如左手稳固工件、右手对准工具发力,让检索出的经验真正具备物理迁移价值。
零架构侵入:掩码流匹配下的跨具身联合训练
如何将这部分筛选出的人类数据喂给下游模型?以往许多工作为了吸收跨具身数据,往往需要设计复杂的分支网络或辅助损失函数。SiMDex 则反其道而行之,选择在策略架构上做“减法”,让策略骨干完全保持原生状态。
研究团队采用了类 $\pi_0$ 的流匹配(Flow-Matching)VLA 架构。机器人的真实动作空间总共包含 88 维:42 维形态无关的共享动作,加上 46 维机器人专属的机械臂与多指灵巧手关节角度。在训练批次中,机器人数据与精选的人类数据按 1:1 的混合比例加载。
对于机器人数据,模型接收全部 88 维的监督信号;而对于人类样本,由于其不具备具体的电机角度信息,模型只在共享的 42 维动作上计算损失,其余 46 维用占位符填充,并通过一个二值掩码向量 $\mathbf{m} \in {0, 1}^{88}$ 将其完全从梯度反向传播中剔除:
\[\mathcal{L} = \frac{\sum_{h,d} m_{h,d} \, \big(\hat{u}_{\tau,h,d} - u_{\tau,h,d}\big)^{2}}{\sum_{h,d} m_{h,d}}\]其中 $h$ 代表动作预测的时间步步长(Horizon = 30),$d$ 为动作维度索引,$\hat{u}$ 与 $u$ 分别为流匹配模型在插值状态下的预测速度与真实目标速度。这种设计让单一策略网络在无须调整层结构的情况下,平滑融合人类的端部交互意图与机器人的底层动力学控制。
真机实验:复杂装配任务上的质变
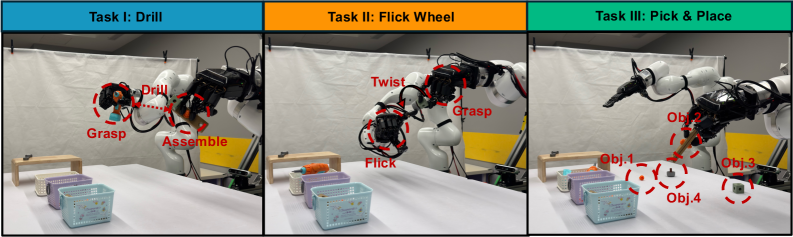
为了检验筛选机制在物理世界中的极限表现,研究团队搭建了一套高难度的双臂灵巧手真机测试平台,选取了工业装配与精细操作场景下的三类长程任务:
-
Task I:电钻装配(Drill):双手配合抓取、部件对齐并执行钻孔,各子阶段容错率极低;
-
Task II:拨动滚轮(Flick Wheel):先精确抓握底座,随后单指多自由度扭转,最后小幅度快速拨动滚轮;
-
Task III:多几何体抓放(Pick & Place):针对四种截然不同的工件几何形状执行顺序抓取并精准放置。
所有任务都具有严格的时序依赖性,前序动作一旦发生滑移或偏角,后续流程直接宣告失败。基线模型 GR-Dexter 采用了完全相同的 VLA 结构和超参数,训练时混合了等量但未经精准筛选(随机采样)的人类第一视角数据。
实验统计显示,SiMDex 在这组复杂的实机考核中将综合成功率从基线的 47.7% 推升至 61.1%。尤为惊人的是在 Task II(拨动滚轮)任务上,基线模型在 Twist(扭转)阶段成功率仅为 0.13,在最终的 Flick(拨动)阶段更是全军覆没(0.00),整体成功率卡在 24.5%;而 SiMDex 将该任务成功率大幅拉升至 45.5%(提升 21.0 个百分点)。在多几何体抓放任务中,SiMDex 同样将成功率从 54.0% 提升到了 83.4%。这有力地证明了,真正决定高自由度指尖微操能力的,并不是灌注了多少人类视频,而是灌注的人类视频里是否包含了物理规律一致的高信噪比指尖轨迹。
数据扩展消融:低数据困境下的压舱石
在工业场景中,灵巧手遥操作数据最真实的痛点是“几乎没有数据”。为了进一步摸清该机制在不同示教量级下的鲁棒性,研究人员进行了严密的数据缩放消融实验(Data Scaling Ablation)。
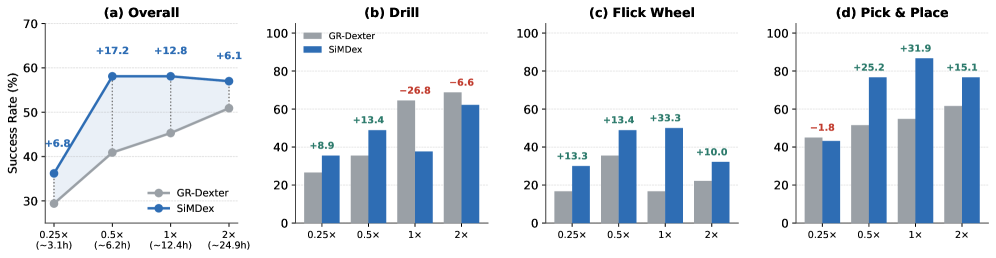
上图揭示了令人瞩目的实验规律:
当机器人自有的示教数据被人为削减至基准的 0.5 倍(约 6.2 小时)时,基线模型的表现呈现断崖式下跌,成功率仅剩约 40%;而 SiMDex 依靠精准检索出的人类先验,在极度匮乏的数据环境下依然支撑起了一个稳定坚固的性能底座(Floor),成功率稳定在 57%~58% 之间,在 0.5x 点位上领先基线足足 17.2 个百分点。
这意味着,借助精细化挖掘的人类视频,系统仅耗费约 6 小时的示教成本,就能抗衡基线耗费约 25 小时(2.0x 规模)采集的数据集。对于被遥操作硬件高成本与高人力耗费所折磨的具身研究团队而言,这种效率层面的飞跃具备极强的现实工程价值。
与此同时,研究团队也客观剖析了在 Drill(电钻)任务中出现的反常现象:当机器人示教数据极度充沛时,SiMDex 的提升并不明显,甚至略微落后于随机基线。深入排查发现,其根本瓶颈在于人类预训练数据池本身的技能覆盖上限。在现有的 EgoDex 开源数据池中,类似工业电钻这种高精度的双手紧固与对准视频本身极为稀少。当检索机制在候选池中搜寻不到足够多高质量的真实相似样本时,强行挖掘出的边缘样本反而可能引入额外的方差。这一发现清醒地提醒业界:基于检索的数据挖掘并非凭空创造能力,其收益上限终究受制于底层外源资产的多样性广度。
总结与展望
SiMDex 所呈现的路径,不仅是一个具体算法的成功,更是大模型数据工程思维在具身智能物理世界的一次成熟映射。它宣告了“拿来主义式的无脑混合人类视频”阶段的终结,开启了以任务为锚点、多级相似度漏斗精细化调度的后训练范式。
让具有泛化能力的双臂多指机器人走进复杂场景,并不意味着人类工程师必须手把手带它把世界上所有工具的操作流程都重开一遍遥操作示教。未来的终极形态,或许恰如 SiMDex 展现给我们的图景:人类数十年日常生活中佩戴头显或第一视角穿戴设备所沉淀下的万千小时影像,本质上是一座庞大的具身操作知识库;新机器人的每一次微调部署,不再是昂贵的数据拓荒,而是一次面向人类文明经验的高并发检索与技能重放。