SkillReason:让Agent内化隐式推理,小模型检索能力跨级反超8B
SkillReason: Reasoning-Enhanced Agent Skill Retrieval for Implicit User Requests
大模型智能体(LLM Agent)正在从单纯的“提示词工程”走向模块化的外部能力复用。在诸如 Claude Code 或 OpenClaw 等前沿智能体框架中,核心解法是将特定任务的指令、执行逻辑与外部资源打包成可复用的技能(Skill)。通过技能库,Agent 避免了每次面对复杂任务时都从头摸索的低效。
ArXiv URL:https://arxiv.org/abs/2608.08640v1
然而,随着技能库急剧膨胀,新的瓶颈迅速显现:如何在数以万计的技能池中,精准找到当前任务需要的那一个?
由北京信息科技大学、北京邮电大学、北京智源科技与北京大学等团队联合提出的研究指出了当前技能检索最痛的痛点:真实用户的指令往往是高度简略且未充分指定的(underspecified)。用户通常只说“要什么结果”,却不会也不可能说出“背后的底层技术能力与执行步骤”。现有检索模型依赖浅层关键词或显式流程匹配,极易“望文生义”返回看似相关、实则无法执行目标的泛化技能。
针对这一问题,该研究提出了包含 61,228 个技能的新基准 SkillReason-Bench,并设计了名为 SkillReason 的双阶段推理增强框架。该框架将思维链(Chain-of-Thought, CoT)能力推理作为训练期特权监督信号内化到表征中,实现了训练期有 CoT、推理期零延迟纯 Query 单次编码的高效机制。评测显示,仅 0.6B 参数的 SkillReason 不仅大幅超越同量级基座,更全方位击败了 8B 规模的通用嵌入模型。
为什么现有技能检索在真实交互中频频失效?
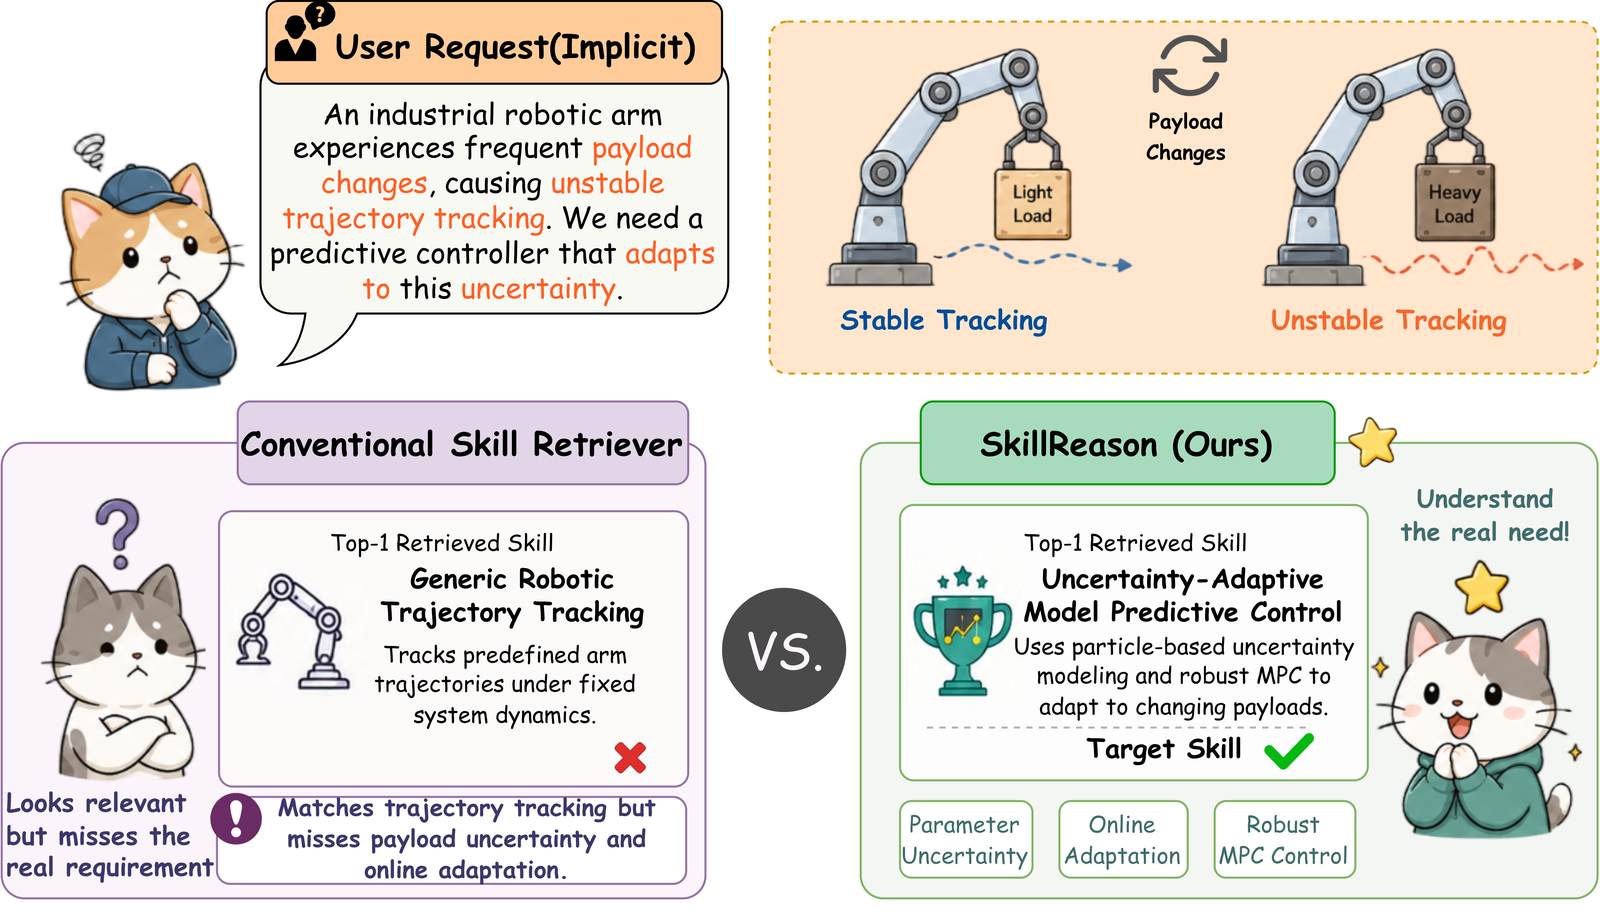
观察图 1 呈现的典型场景:用户提出“工业机械臂在负载频繁变化时如何维持稳定的轨迹追踪”。
-
常规检索器(Conventional Retriever)捕捉到“轨迹追踪”,便直接匹配到了一个泛化的通用轨迹追踪技能。但机械臂的核心难点在于“负载频繁变化”,真正能解题的技能必须具备“感知负载的动力学建模”与“自适应不确定性模型预测控制(MPC)”。常规模型因无法推导这层隐式需求,导致检索彻底脱靶。
-
真实的 Agent 交互中,用户不是算法专家,不会把依赖的算法包、API 签名或控制理论关键词写在 Prompt 里。
现有主流基准(如 SkillRet、SRA-Bench)虽然提供了有价值的测试环境,但其测试 Query 往往篇幅较长,充满了显式流程说明或专业领域术语,放大了显式词法匹配的作用。一旦遇到简短、目标高度抽象的隐式指令,传统检索器的准确度便迅速跳水。
为了还原真实场景,研究团队构建了 SkillReason-Bench。
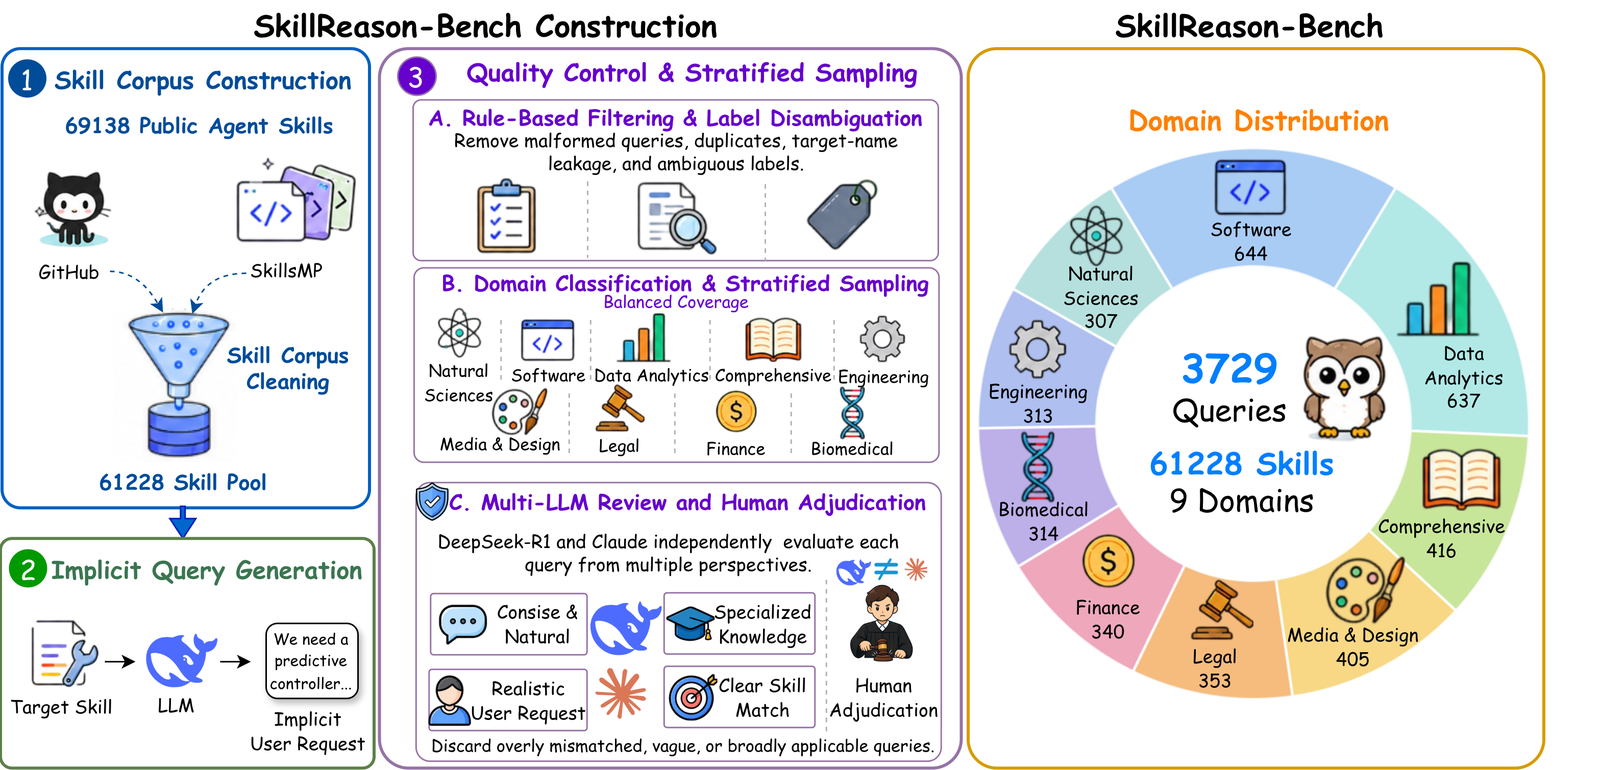
团队从 GitHub 聚合的 SkillsMP 技能库中提取清洗出 61,228 个技能,横跨软件工程、数据分析、金融、自然科学等 9 个领域。最关键的是,团队没有进行语义去重,保留了真实开源技能生态中广泛存在的“功能重叠与边界模糊”特性。随后利用 DeepSeek-R1 生成对应的隐式 Query:仅陈述目标,严格剔除显式的核心能力名称与完整步骤,最终构建出包含 3,729 条高质量隐式测试查询的评测集。
SkillReason 架构:把 CoT 蒸馏进稠密表征
以往提升检索语义匹配的方案,往往是在推理阶段让模型先生成一段 CoT(如 Think-Then-Embed、LREM)再做向量化。这种做法虽然利用了显式推理,但在 Agent 生产环境中引入了不可接受的自回归生成延迟与显存开销。
SkillReason 的核心洞见在于:能否只在训练阶段引入特权推理,而在推理阶段将其完全内化到 Query 向量里?
SkillReason 采用两阶段训练框架,实现了这一目标:
第一阶段:教师推理引导的多目标对齐与内化
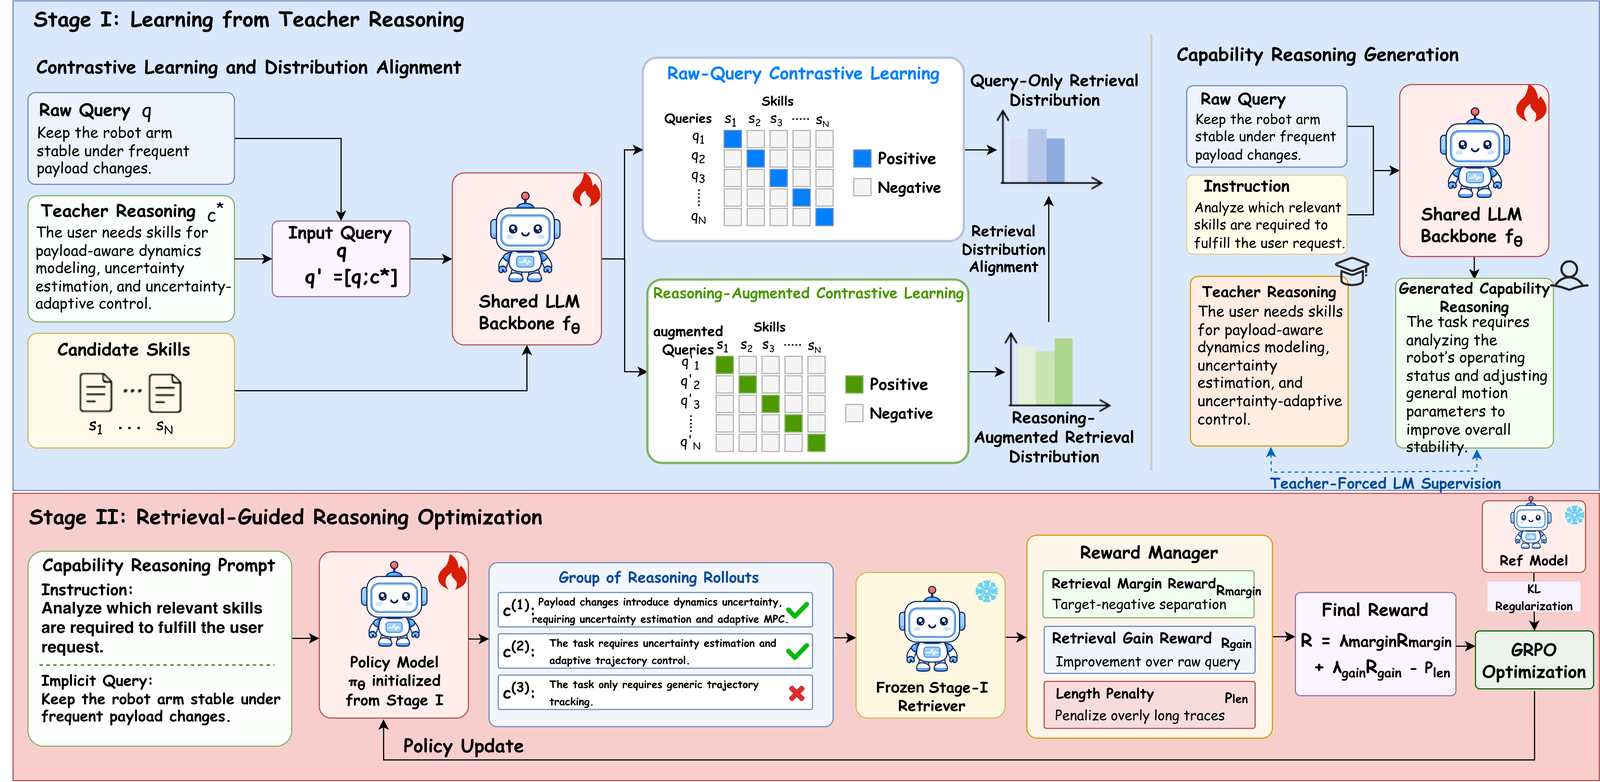
给定用户隐式指令 $q$ 与由强教师模型生成的“能力需求分析推理轨迹” $c^$,构建增强输入 $\tilde{q} = [q; c^]$。模型基于共享的 Transformer 主干 $f_\theta$ 进行多目标联合优化:
-
双视角对比学习(Contrastive Learning):分别计算原始 Query $q$ 与包含特权推理的增强 Query $\tilde{q}$ 到正样本技能 $s_q^+$ 的对比损失 $\mathcal{L}{\mathrm{raw}}^{\mathrm{CL}}$ 与 $\mathcal{L}{\mathrm{cot}}^{\mathrm{CL}}$。
-
检索分布对齐(Distribution Alignment):特权视角 $\tilde{q}$ 显然具有更强的判别力。为了让原始 Query 在无推理链辅助时也能逼近特权视角,框架定义了平滑后的候选技能分布:
通过引入 KL 散度约束,将特权视角的排序偏好蒸馏给纯 Query 视角:
\[\mathcal{L}_{\mathrm{KL}} = T^2 D_{\mathrm{KL}}(\operatorname{sg}[p_{\theta}^T(\cdot \mid \tilde{q})] \parallel p_{\theta}^T(\cdot \mid q))\]其中 $\operatorname{sg}$ 为梯度截断(stop-gradient)。这一步迫使纯 Query 编码器学会在单次前向中“预判”推理后的技能偏好。
- 能力推理生成自监督:共享主干同时通过自回归交叉熵损失 $\mathcal{L}_{\mathrm{LM}}$ 拟合生成 $c^*$。这一任务不仅促使模型参数充分理解“如何将任务目标分解为能力要素”,而且为第二阶段的策略模型提供了高质量的冷启动初始化。
第二阶段:基于 GRPO 的检索导向推理优化
第一阶段的局限在于:固定的教师 CoT 可能是次优的,且较小的主干模型强行模仿大模型推理轨迹可能存在容量不对齐。因此,第二阶段引入了检索引导的群体相对策略优化(Retrieval-guided GRPO)。
在 Stage II 中,Stage-I 初始化的策略 $\pi_\theta$ 为每个 Query 采样 $G$ 条不同的候选推理轨迹 ${c^{(g)}}{g=1}^G$。评估这组轨迹优劣的裁判不再是单纯的语言模型打分,而是来自一个冻结的 Stage-I 检索器 $h\phi$ 的实际检索表现:
-
边界奖励(Margin Reward):度量增强 Query 与正样本的相似度相较于最强负样本的优势:$m(x) = h_\phi(x, s_q^+) - \max_{s^-} h_\phi(x, s^-)$。
-
增益奖励(Gain Reward):衡量引入推理轨迹 $c^{(g)}$ 相较于原始输入 $q$ 带来的检索增益:$R_{\mathrm{gain}}^{(g)} \propto (m(\tilde{q}^{(g)}) - m(q))$。
-
长度惩罚:防止生成冗长无效的套话,惩罚超出预算长度的 Token。
因为策略网络 $\pi_\theta$ 与底层的 Query 编码器共享主干参数 $f_\theta$,GRPO 的策略梯度在奖励那些“能直接提升检索排序能力的推理分解”的同时,直接反向更新了编码器底层的表征空间。这种生成与编码的协同优化,彻底完成了推理能力向稠密表征的沉淀。
在推理阶段,所有技能向量离线预先计算好,线上只需要把原始 Query 送入模型单次编码计算余弦相似度,无需执行任何自回归推理生成,维持了亚秒级的高并发检索性能。
核心实验:0.6B 小模型全面跨级反超
为了全面评估模型能力,研究人员在三个基准上进行了系统评测:
-
SkillReason-Bench:以隐式、简短需求为核心;
-
SkillRet:强调跨领域长 Query,包含大量流程细节;
-
SRA-Bench:覆盖复杂推理、工具调用与代码等 5,400 个端到端任务。
实验对比了 BM25、通用稠密模型(如 Qwen3-Embedding 系列)以及专用的技能检索器(SkillRouter、SkillRet)。
最令人瞩目的结果出现在参数跨级对抗上。基于 Qwen3-Embedding-0.6B 微调的 SkillReason-0.6B,在 SkillReason-Bench 上的 Recall@10 相比初始基座暴涨了 17.56 个百分点。更重要的是,仅有 0.6B 参数的 SkillReason-0.6B,在所有三个基准的所有主要指标上,全面击败了拥有 8B 参数的 Qwen3-Embedding-8B 原生模型。
跨基准对比揭示了此前专用技能检索模型的深层缺陷。先前的技能检索模型在 SkillRet 这种富含流程细节的长文本基准上表现抢眼,但面对 SkillReason-Bench 的简短隐式需求时,其检索效果急转直下,甚至弱于通用的 Qwen3-Embedding-0.6B。这证明以往的模型重度拟合了字面线索和流程词法;而 SkillReason 在长短指令之间展现出了极强的鲁棒性,证明其内化的“能力推断”机制真正起到了语义桥梁的作用。
消融实验进一步印证了架构设计的合理性:
-
引入 CoT 对比学习后,模型在隐式与显式基准上均有明确收益;
-
加入分布对齐(KL 散度)后,缺少显式线索的隐式基准提升尤为明显,证实了特权排序偏好确实传递给了单视角向量;
-
引入 Stage II 的 GRPO 强化学习后,隐式需求检索指标继续稳健走高;
-
关键推论验证:在测试阶段,如果强制让模型先自回归生成 CoT 再做检索,其效果相比于纯 Query 单次编码并没有出现一致性的提升。这从侧面有力证明:检索所需的能力推断逻辑,已经在两阶段训练中被完全压缩进了向量表征之中,无需在线额外消耗计算资源。
下游收益:Agent 端到端任务成功率跃升
检索性能的提升是否真正转化为 Agent 解决实际问题的能力?研究团队在 SRA-Bench 评测集上测试了“检索器 + 重排器 + 下游智能体”的完整全链路端到端任务成功率,跨越了 5 款主流开源与闭源 LLM。
在完整的 Retrieve-Rerank 架构中,全套基于 0.6B 参数构建的 SkillReason 管线,在下游任务中稳定胜过了由 4B 参数 Qwen3 驱动的检索管线。而当使用 4B 规模的 SkillReason 管线为下游 LLM 提供 Top-1 检索技能时,下游模型的端到端任务成功率平均提升了 14.66 至 25.03 个百分点。在多项复杂代码与数学推理任务中,其供给的技能质量已经逼近了人工提供的“黄金技能(Gold Skill)”所达到的效果天花板。
这一结果表明,对于自主智能体系统而言,制约任务执行上限的往往不是下游模型的生成参数量,而是外部技能接入的准确率。一个轻量但具备深层隐式推断能力的检索前端,能够以极小的部署成本成倍放大整个 Agent 系统的综合效能。