LifelongCrossNav:从平面投影到3D体素记忆,实现跨楼层连续多目标导航
LifelongCrossNav: Persistent 3D Semantic Memory for Cross-Floor Multi-Object Navigation
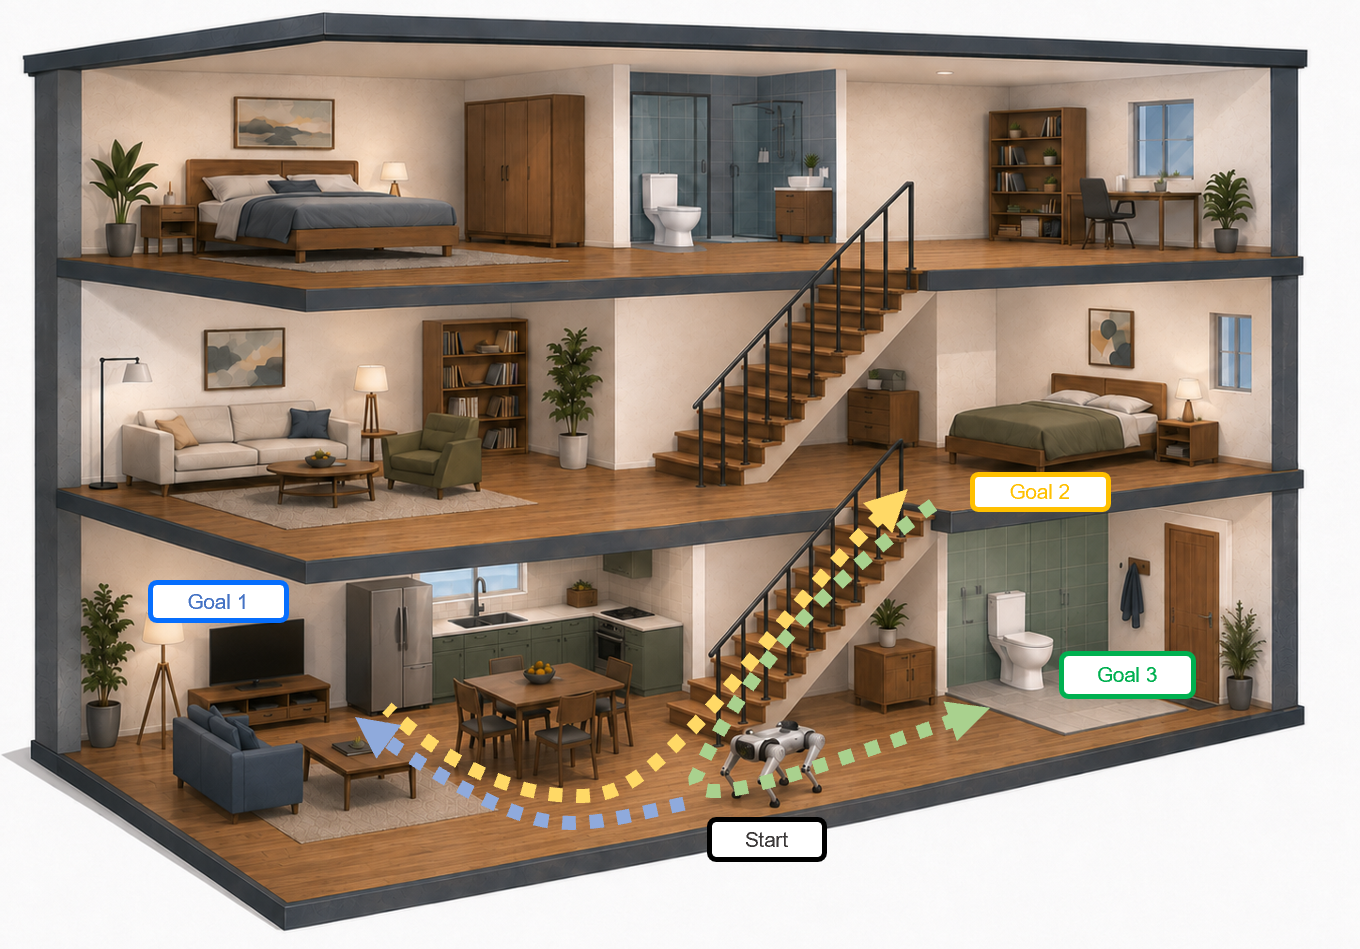
在具身智能(Embodied AI)的经典任务中,目标导向导航(Object-Goal Navigation, ObjectNav)一直被视为衡量智能体环境理解与空间决策的核心试金石。过去几年,得益于视觉语言大模型与开放词表感知技术的爆发,智能体在未知单层房间里寻找沙发、电视或冰箱的能力突飞猛进。然而,真实的物理世界极少是扁平的。现实中的家庭、复式公寓或办公楼往往拥有多层空间和复杂楼梯结构;真实场景下的服务需求,也从来不是找到一个单品就立刻重置环境,而是需要顺次完成“先去客厅找电视、再去二楼卧室找床、最后去卫生间找马桶”这类连续多目标搜寻。
ArXiv URL:https://arxiv.org/abs/2608.07079v1
以往的学术研究大多将这两个维度人为割裂:研究多目标导航的方案(如 MultiON、OneMap)倾向于采用平面俯视图(Bird’s-Eye-View, BEV)或 2D 语义栅格,在多目标切换时保留环境记忆,却完全无法处理垂直空间的几何重叠,直接回避了上下楼梯的场景;而研究跨楼层导航的方案(如 ASCENT、TravExplorer)虽然关注楼梯识别和竖向连通性,却局限于单目标搜寻,一旦找到目标就结束任务,根本没有设计跨任务、跨周期的可复用语义记忆系统。
针对这一结构性断层,来自北京智源人工智能研究院(BAAI)与北京大学的研究团队提出了名为 LifelongCrossNav 的具身导航框架。该框架首次将支撑感知的 3D 稀疏体素建图、任务无关的持久视觉语言特征记忆、阶梯自适应通行推理以及统一的跨层导航策略深度融合在闭环系统中。与此同时,团队构建了首个跨楼层连续多目标导航基准 HM3D-MFMON,并提出严谨的“事后阶段式最短路径评估协议”,彻底解决了连续导航中由于智能体动态起点和多目标实例共存导致的评估失真问题。
为什么平面记忆在立体建筑中注定崩溃?
要理解 LifelongCrossNav 的突破,必须先看清现存多目标导航范式在多层空间中的致命软肋。以先前代表性的多目标导航方法 OneMap 为例,这类方案的核心思想是在探索过程中维护一张 2D 开放词表语义特征图。智能体每走一步,就将当前的 RGB-D 观测投射到水平地面网格上,并利用视觉语言特征对网格进行持续融合更新。当接收到下一个目标指令时,智能体直接在 2D 图上通过文本向量做余弦相似度检索,挑出最匹配的区域作为潜在兴趣点,进而规划最短路径直奔目标。
这种思路在平层单房间中效率极高,但在多层建筑中会立刻引发严重的物理逻辑灾难:
-
垂直空间压缩与几何折叠:二维投影视角默认整个空间只有一个高度平面。当一楼的餐厅正上方正好是二楼的书房时,投影操作会将两层的墙壁、地面、家具甚至虚空区域强行碾平到同一个 2D 像素内。不同楼层的语义特征互相污染,可通行区域与不可通行的垂直障碍彻底混淆。
-
楼梯拓扑与连通性丢失:阶梯不是单纯的水平走廊,它是由连续高程变化、具有特定几何坡度和支撑面的三维立体结构。2D 地图无法区分“可攀爬的楼梯表面”与“无法穿越的实体墙体”,导致全局路径规划器要么在楼梯口反复打转迷失,要么计算出直接穿透楼板的荒谬路径。
-
单目标跨楼层方案缺乏长期语义留存:已有的跨楼层导航模型在找到单楼层目标后就会被强制重置。它们虽然能识别楼梯,但没有在垂直空间中构建能够被新文本指令重复检索的 3D 语义场;智能体即便在上一次任务中已经瞥见过二楼的卧室,等到切换到新目标时,也只能当作全新环境从头搜寻。
LifelongCrossNav 的出发点正是打破这种割裂:既要用真 3D 几何表达解决多层垂直连通性,又要让 3D 体素携带可泛化的视觉语言特征,使得智能体在多任务转移过程中具备“终身(within-episode lifelong)”记忆与快速检索能力。
LifelongCrossNav 架构:3D 体素建图与视觉语言特征的深度融合
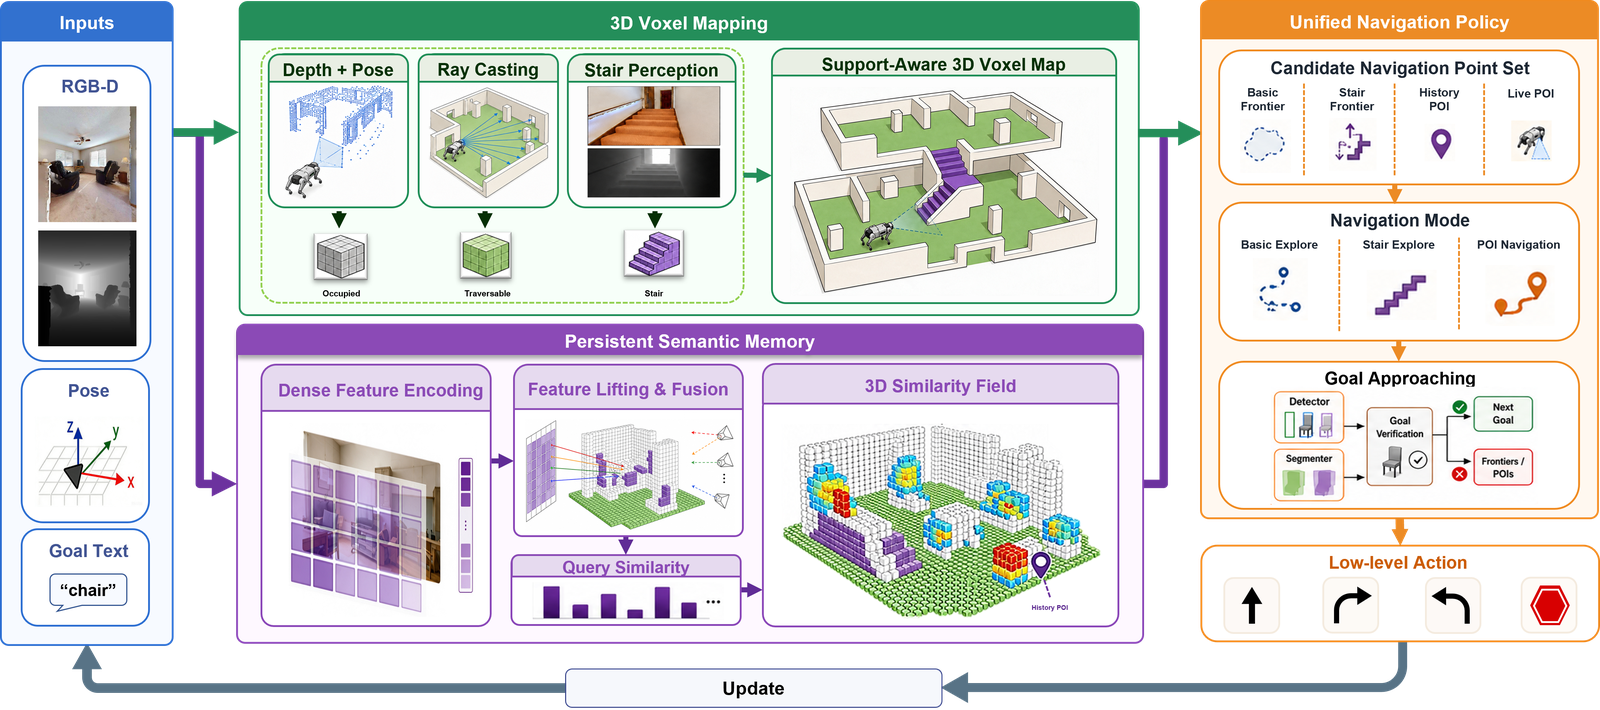
智能体在每个时间步 $t$ 接收机载 RGB-D 相机观测 $I_t$、$D_t$、自身 6-DoF 位姿 $T_t$ 以及当前活跃的目标文本 $g_k$。整个系统的核心由两大并行互补的分支驱动:几何分支构建支持跨楼层通行的 3D 空间结构,语义分支则把与具体目标解耦的高维视觉语言特征锚定到 3D 表面体素中。
支撑感知的三维体素建图
为了在保留竖向几何的同时控制显存消耗,LifelongCrossNav 采用稀疏 3D 体素网格组织场景。几何分支不仅仅记录占用与空闲状态,更核心的是推导垂直支撑关系。系统通过对深度图进行光线投射(Ray-casting),区分出观测到的物体表面点和自由空间。但单凭点云无法判断智能体能否站立,算法会在体素局部构建高度梯度与法向量约束,筛选出倾角平缓、具有稳定地面或台阶支撑特征的体素,赋予其可通行属性。
更为精妙的是其阶梯专用感知与几何校验模块。普通地面与楼梯在动力学上差异极大。系统首先通过在室内全景与台阶数据集上微调的 SegFormer-B2 模型,从当前 RGB 图像中分割出楼梯像素级掩码;随后将掩码与深度点云反投影至 3D 空间。然而纯视觉分割极易受到条纹地毯、栏杆阴影的干扰而产生假阳性,因此算法设计了多重严格的几何过滤器:连续体素的高度差是否符合踏步规律?空间走向是否具备一致的阶梯坡度?是否与已知的地面支撑面具有空间拓扑连续性?只有同时满足语义与三维几何双重判据的体素,才会被固化为“楼梯体素”。楼梯体素不仅在 3D 路径规划器中充当跨楼层垂直连通的桥梁,也是智能体决策系统触发跨层探索模式的物理开关。
任务无关的持久 3D 语义记忆与查询机制
为了让记忆具备长期复用价值,系统不能直接存储特定类别的置信度,而必须存储通用视觉语言嵌入。LifelongCrossNav 将二维密集特征提取网络(如 CLIP 或预训练视觉模型)提取的稠密特征映射到 3D 表面点上。
对于落在体素 $\mathbf{v}$ 内的点集 $\mathcal{P}{\mathbf{v}}$,先根据视觉特征置信度 $q_p$ 计算当前时刻的加权聚合特征 $\bar{\mathbf{f}}{\mathbf{v}}^{(t)}$:
\[\bar{\mathbf{f}}_{\mathbf{v}}^{(t)}=\frac{\sum_{p\in\mathcal{P}_{\mathbf{v}}}q_{p}\mathbf{f}_{p}}{\sum_{p\in\mathcal{P}_{\mathbf{v}}}q_{p}+\epsilon}\]考虑到机器人从不同角度、光照和距离观察同一物体时特征会有涨落,体素记忆采用累加计数的在线指数移动平均进行时序平滑:
\[\mathbf{F}_{\mathbf{v}}^{(t)} =\frac{C_{\mathbf{v}}^{(t-1)}\mathbf{F}_{\mathbf{v}}^{(t-1)}+c_{\mathbf{v}}^{(t)}\bar{\mathbf{f}}_{\mathbf{v}}^{(t)}}{C_{\mathbf{v}}^{(t-1)}+c_{\mathbf{v}}^{(t)}}, \quad C_{\mathbf{v}}^{(t)} =C_{\mathbf{v}}^{(t-1)}+c_{\mathbf{v}}^{(t)}\]其中 $C_{\mathbf{v}}$ 为体素被观测到的置信累积量。这种设计使得整栋建筑的 3D 记忆在漫长的探索过程中平稳演进,不会因为单帧相机的运动模糊或视角遮挡而彻底损坏已建好的语义特征。
当上一个子任务顺利完成、环境向智能体派发下一个目标文本 $g_{k+1}$ 时,系统根本无需重置场景或重新扫描环境,而是直接计算文本嵌入与所有存储体素特征 $\mathbf{F}_{\mathbf{v}}$ 之间的余弦相似度。这会在整个三维稀疏网格中瞬间激活一个以目标为条件的 3D 语义相似度场。系统通过 3D 邻域聚类将高响应区域聚集,挑选出响应最强的候选聚类中心作为历史兴趣点(History POI)。智能体在开始迈步前,就已经通过“回忆”锁定了此前路过区域中可能性最大的空间坐标。
统一导航策略与目标多重校验闭环
面对庞大的未知多层建筑,智能体在任意时刻都面临多种决策冲突:是继续探索当前楼层的未知死角?还是踏上楼梯去开拓全新楼层?或是径直走向语义检索唤醒的历史目标点?
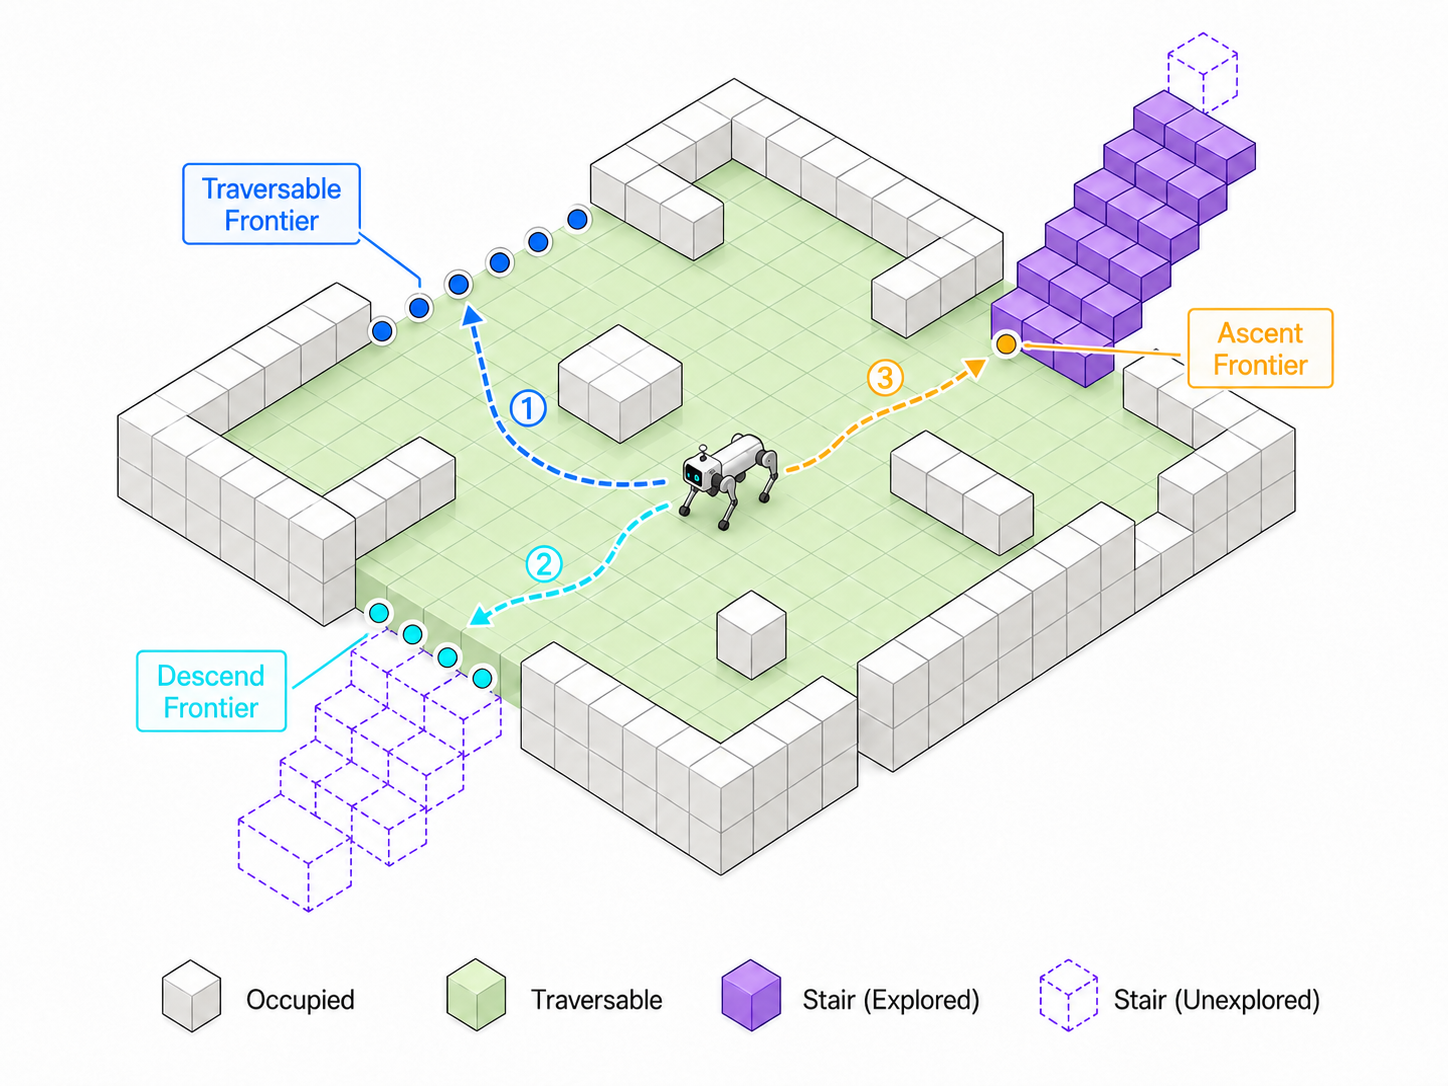
LifelongCrossNav 设计了一个层次化的统一导航策略,将空间线索统一划分为四类航点候选,并驱动三种行为模式的平滑流转:
-
基础前沿(Basic Frontiers):代表当前楼层已知可通行区域与未知虚空区域的交界线,用于驱动智能体在当前楼层进行由近及远的平层盲探(Basic Explore 模式)。
-
楼梯前沿(Stair Frontiers):当系统几何分支在楼梯口确认了具有高程连通性的楼梯体素后生成,一旦被选中,智能体切入楼梯探索(Stair Explore 模式),以特定的步长与视角偏置执行稳定的上下楼动作。
-
历史兴趣点(History POIs):通过前述 3D 语义记忆检索获得,代表智能体“隐约记得那儿有个目标”(POI Navigation 模式)。
-
实时兴趣点(Live POIs):在实时前向观测中由目标检测器(如 YOLOv7)或高置信度多模态线索捕捉到的瞬时目标候选。
整套策略奉行分层渐进、保守穿越的运行原则:智能体默认优先在当前楼层利用 Basic Frontiers 搜集信息与验证 Live POI;一旦文本检索产出了极高相似度的 History POI,系统直接调用 3D $A^*$ 规划器沿已确认的支撑表面快速导航;只有当平层探索彻底陷入死胡同、且没有高置信度语义线索时,系统才会激活 Stair Frontiers,引导智能体安全过渡到另一个未探索的楼层。
值得强调的是,导航到 POI 并不等同于任务结束。为了防止远距离视错觉导致的虚假早停,LifelongCrossNav 设立了严格的终极目标靠近与物理验证(Final Approach & Verification)机制。当机器人行进至目标候选附近约 1.5 米安全观测位姿时,机载目标检测器会对物体进行多帧连续核验,综合判定检测框置信度、3D 掩码体积合理性、观测视角朝向以及三维欧氏距离。只有连续通过严苛几何与外观检验,智能体才会发出最终的 Stop 动作宣告子任务成功;一旦核验失败,系统立刻判定该 POI 为虚警,将其从当前候选池中剔除,回退至全局探索流程。这种闭环机制极大地压制了开放词表特征在大场景中偶尔出现的幻觉漂移。
HM3D-MFMON 基准:重构多层连续评估的标准
为了客观量化多层连续导航能力,研究团队在 Habitat 仿真器与 HM3D 数据集基础上构建了全新的标准化基准:HM3D-MFMON(Multi-Floor Multi-Object Navigation)。
测试集涵盖了 36 个具有完整真实多层结构、楼梯拓扑与语义标注的高质量 3D 真实扫描场景,总计构建了 927 个包含 3 个有序目标(Three-goal Episodes)的连续任务序列。尤为关键的是,研究团队深入分析了目标物体在多层建筑中的空间分布与跨层路径连通性,从中专门提炼出一个极具挑战性的子集——CFR(Cross-Floor-Required,必须跨楼层子集),包含 288 个测试序列。在该子集中,智能体若想完整达成目标序列,必须至少完成一次跨越楼层的物理转移。
事后阶段式评估协议(Post-hoc Evaluation Protocol)
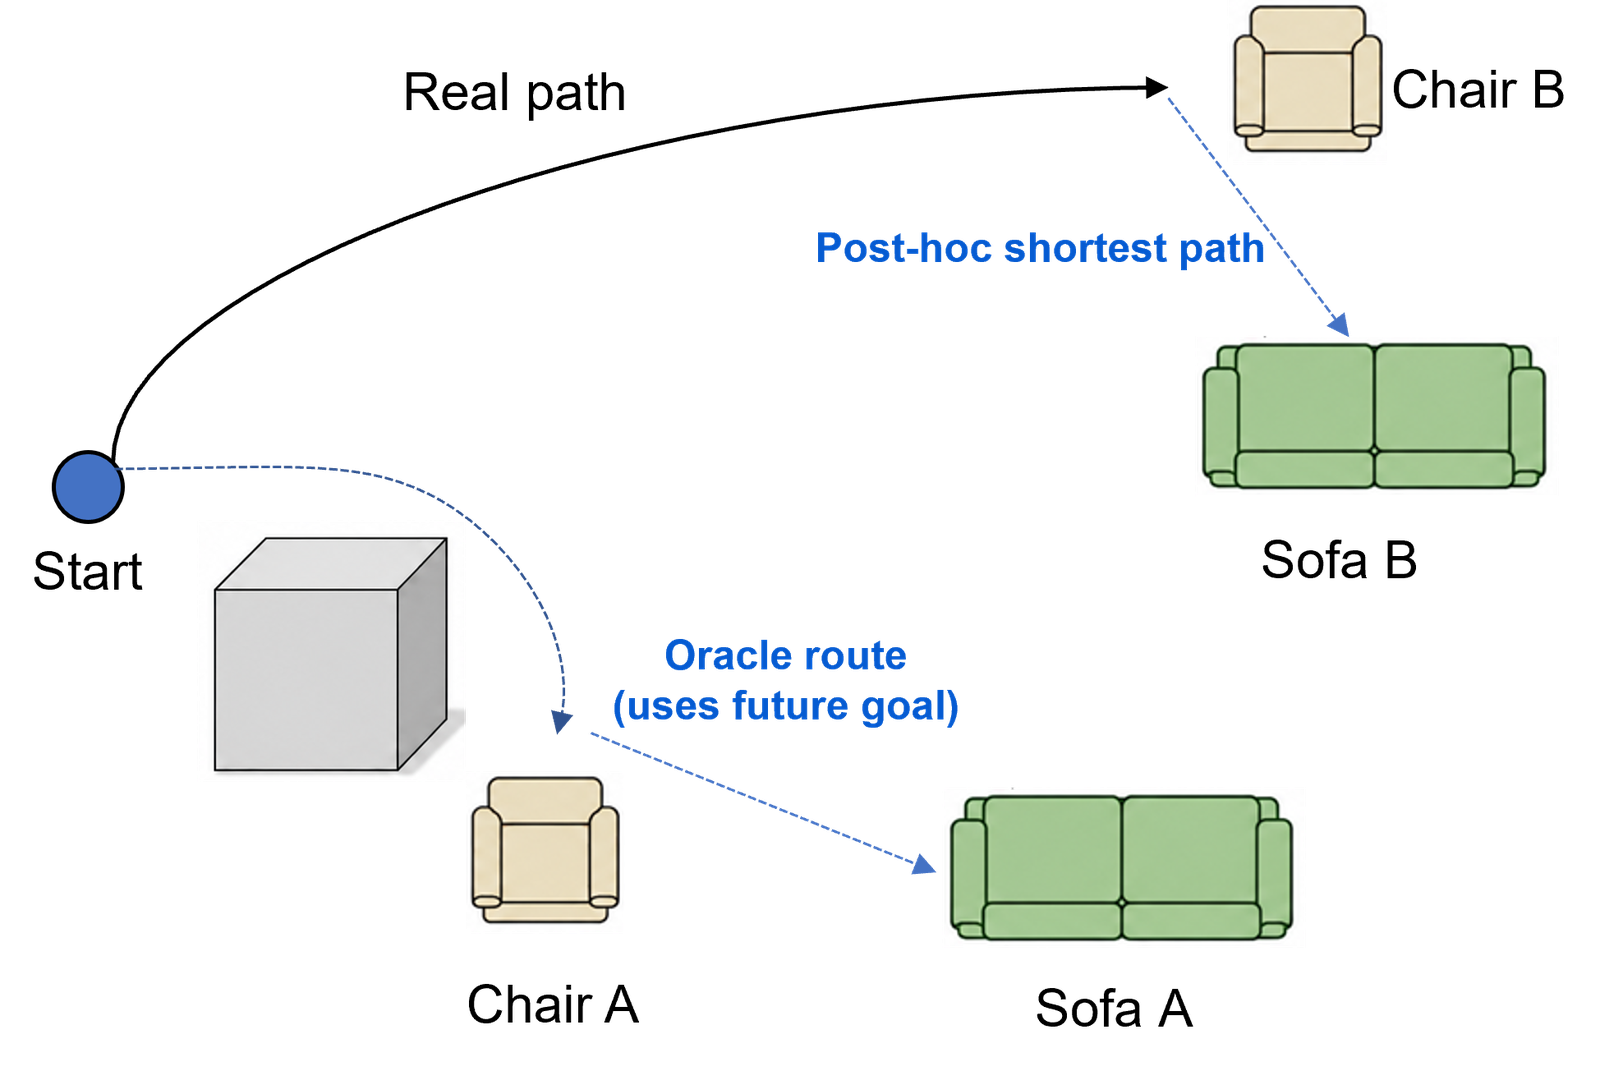
多目标连续导航的评测在学术界长期存在一个深层次的技术痛点:最短路径的非静态性。在单目标导航中,起点和目标是固定的,理论最短测地线距离 $d^*$ 可以在仿真开始前预先计算好。但在连续多目标任务中:
-
场景中往往存在同一个类别(如“椅子”)的多个合法实例;
-
智能体在完成第 1 个子任务时停下的物理位置,直接决定了它去往第 2 个目标的起点;
-
智能体实际选择走向的是哪一个实例,取决于它自身的探索轨迹和决策逻辑。
如果依然使用全局预设的静态最短路径来计算路径效率指标 SPL(Success weighted by Path Length),将不可避免地导致分母极度不公正。为此,研究团队引入了事后阶段式最短路径协议(Post-hoc Stage-Wise Shortest-Path Protocol)。在智能体完成阶段 $k-1$ 的真实停机坐标 $\mathbf{x}^{\mathrm{start}}{i,k}$ 处,动态遍历场景中目标类别 $g{i,k}$ 的所有有效实例集合 $\mathcal{X}_i$,计算出真实的动态测地线距离:
\[d^*_{i,k}=\min_{\mathbf{x}\in\mathcal{X}_{i}(g_{i,k})}d_{\mathrm{geo}}\left(\mathbf{x}^{\mathrm{start}}_{i,k},\mathbf{x}\right)\]并由此定义每个阶段真实的动态路径效率:
\[\mathrm{SPL}_{i,k}=\mathrm{SR}_{i,k}\frac{d^*_{i,k}}{\max\left(d^*_{i,k},l_{i,k}\right)}\]其中 $l_{i,k}$ 为智能体在阶段 $k$ 实际耗费的移动步长。
此外,为了剔除前期任务失败引发的样本衰减噪声,基准明确区分了条件指标(Conditional Metrics)与全局指标(Global Metrics)。条件成功率 $\mathrm{SR}^{\mathrm{cond}}{k}$ 与效率 $\mathrm{SPL}^{\mathrm{cond}}{k}$ 专门衡量“在成功完成前 $k-1$ 个目标的前提下,智能体完成第 $k$ 个目标的纯粹能力”:
\[\mathrm{SR}^{\mathrm{cond}}_{k}=\frac{\sum_{i=1}^{N}\mathrm{SR}_{i,k}}{\sum_{i=1}^{N}\mathrm{SR}_{i,k-1}},\qquad \mathrm{SPL}^{\mathrm{cond}}_{k}=\frac{\sum_{i=1}^{N}\mathrm{SPL}_{i,k}}{\sum_{i=1}^{N}\mathrm{SR}_{i,k-1}}\]这一指标精准隔离了前序子任务失败的累积偏差,成为衡量持久记忆对后续任务增益的核心指标。
实验结果与深度剖析:3D 记忆究竟带来了什么?
在硬件方面,所有评测统一在单张 NVIDIA RTX 5090 GPU 上完成。作为对照的基线模型,选取了多目标连续导航领域的代表性开源方案 OneMap(基于 2D 平面持久特征图)。
连续导航与跨楼层能力全面碾压
实验数据表明,LifelongCrossNav 在全量 HM3D-MFMON 基准以及 CFR 跨楼层必须子集上,均展现出了相较于 2D 方案的代际优势。
在包含 927 个序列的全量任务中,LifelongCrossNav 实现了极其显著的序列完成度提升。而在最为硬核的 288 个 CFR 跨楼层子集上,差距被进一步拉大:2D 基线模型由于将楼梯与墙壁扁平化、将多层天花板与地板压缩在同一平面,在遇到跨楼层需求时几乎寸步难行,阶段 2 和阶段 3 的全局完成率暴跌至极低水平;而 LifelongCrossNav 凭借支撑感知 3D 体素与楼梯拓扑理解,能够极其从容地规划穿过楼梯间、跨越楼层的三维轨迹,顺利完成多目标连续转移。
历史兴趣点(History POI)的核心价值:消除重复探索
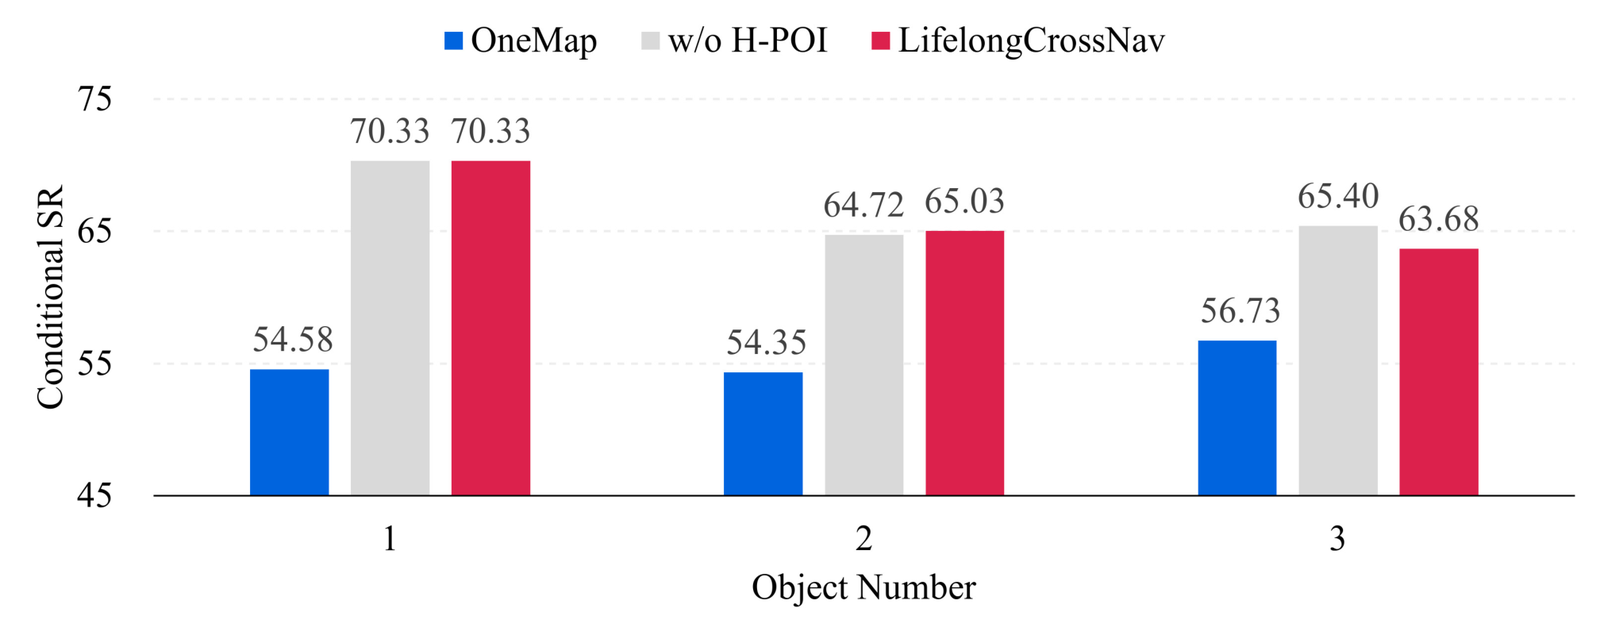
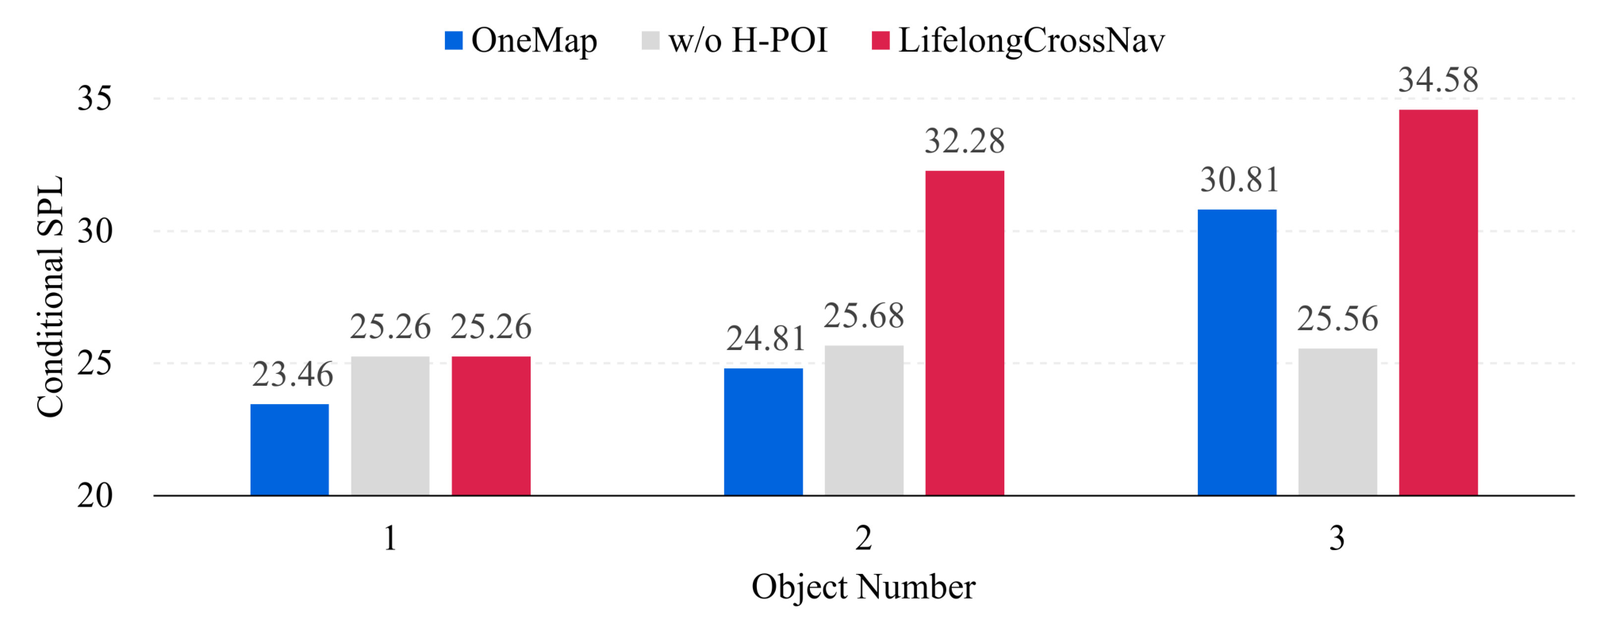
在消融实验中,研究团队测试了禁用历史兴趣点检索(w/o H-POI)的模型变体。结果展现了一个极具启发性的现象:
当禁用 H-POI 时,模型在后续阶段的路径效率指标(Conditional SPL)出现了大幅度滑坡。这意味着,如果没有 3D 语义记忆检索,智能体每接到一个新目标,哪怕这个物体在寻找上一个目标时早就被相机清晰记录过,智能体也只能像失忆一样,被迫重新启动大范围的前沿盲探。
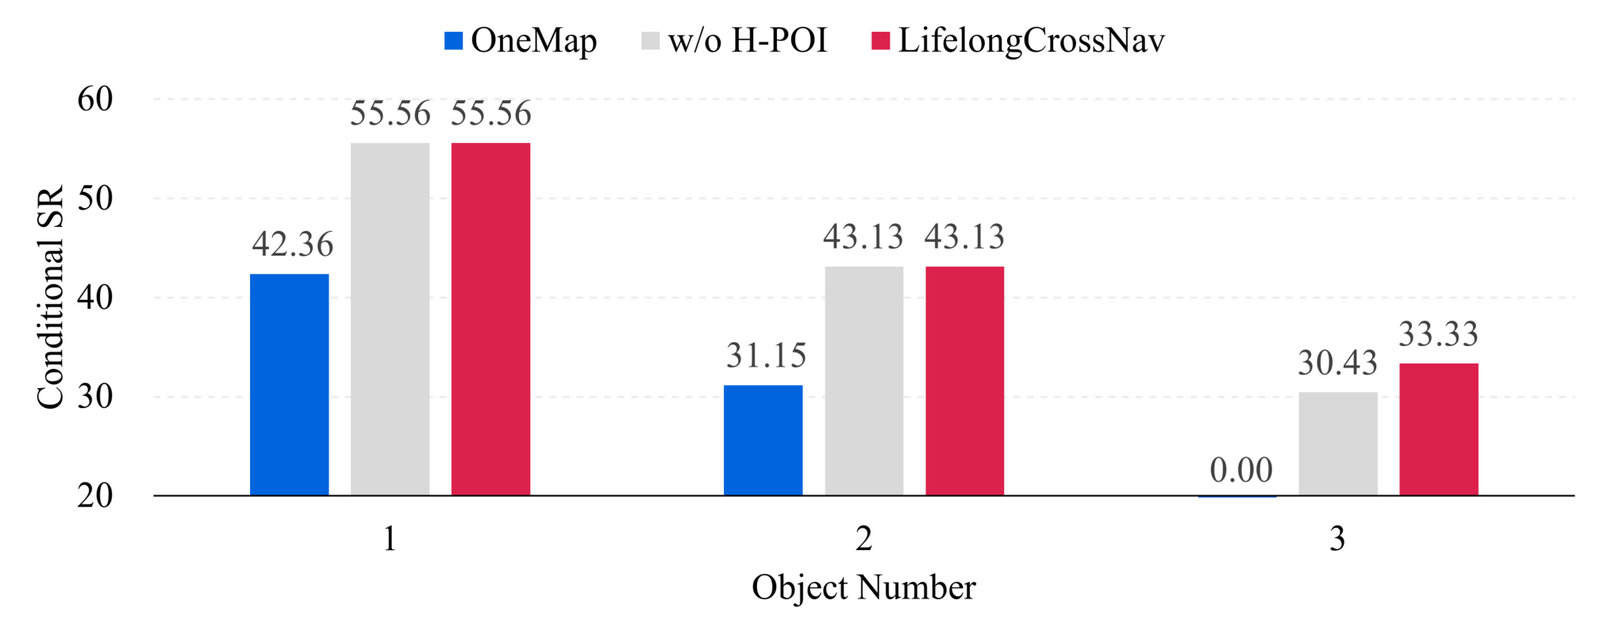
从上方两张展示 CFR 跨楼层子集的阶段式图表可以看出,启用持久 3D 记忆后,随着任务阶段推进至第 2、第 3 目标,智能体的条件 SPL 表现出了强劲的坚韧性,历史记忆极大缩短了后续目标的迂回距离。
严谨的失效模式分析(Failure Analysis)
在消融实验的数据中,出现了一个反常的微小细节:w/o H-POI(禁用历史检索)的某些变体在绝对成功率(SR)上反而比完整版高出了约 1 个百分点。研究团队没有回避这一异常,而是对数百个失败 Episode 进行了细致入微的成对(Paired)轨迹归因分析,揭示了极有价值的系统机理:
通过细分失败类型统计,启用 H-POI 使得因“局部路径规划卡死”、“探索不完全”以及“候选点不可达”导致的失败数量大幅下降。这强力证明了 3D 语义回忆为智能体提供了清晰而极具方向性的导航线索,彻底根治了乱跑乱撞的低级错误。
然而,绝对成功率的微小倒挂,完全源于下游目标检测器在不同视角下的假阳性错检(False Positive Detections),其中最为典型的受害者是“床(bed)”这一类别:
-
当智能体盲探时,它往往从远端开阔视场正面观察卧室,YOLOv7 能够准确辨识床铺;
-
但当智能体被 H-POI 精准导流到床铺侧后方或者复杂立面角落等非典型视角时,检测器偶尔会将床铺误判为视觉结构高度相似的“沙发(sofa)”,或者将沙发误判为床;
-
这种由于空间检索引流导致的角度偏移,诱发了后续目标多重验证阶段的失败,智能体在近距离核验中因误判而放弃,最终导致任务超时。
这一深度失效分析不仅没有削弱 3D 语义记忆的理论价值,反而为具身导航社区敲响了警钟:在长序列导航系统中,空间导航决策模块的上限,正在受到下游静态视觉检测器视点鲁棒性的制约。提升目标验证器在任意视角和遮挡下的鉴别力,是未来解锁 3D 记忆全部潜力的关键一环。
迈向全三维物理世界的具身智能
LifelongCrossNav 的核心价值不仅在于刷新了若干百分点的测试指标,更在于它指明了具身导航从“二维玩具世界”迈向“真实建筑空间”的必然技术路径。
长期以来,具身导航研究者为了计算便利,大量依赖 2D 栅格与单层简化假设。然而,真实世界是由标高、坡度、台阶、跃层与竖向连通性构成的复杂连续体。LifelongCrossNav 证明了:
-
稀疏 3D 体素完全能够在边缘算力可承受的前提下,优雅组织复杂的跨楼层几何与垂直支撑拓扑;
-
任务无关的高维视觉语言特征可以直接驻留在真 3D 空间中,作为跨周期、可迭代检索的永久心智地图;
-
结合稳健的物理校验机制与阶段式评估体系,具身智能体完全有能力在未知的大型立体建筑中展现出类似人类的“空间记忆与按图索骥”能力。
随着大模型与空间智能(Spatial Intelligence)的进一步收敛,将这一套 3D 几何-语义记忆系统从仿真环境推向物理四足机器人、双足人形机器人的真机落地部署,并在更恶劣、动态变化的非结构化楼宇中维持长效鲁棒运行,必将成为下一代自主智能体演进的最前沿战场。