Lingjing:统一三大物理引擎,12款多模态模型实测开放城市多具身协同
Lingjing: A Simulation Testbed for Multi-Agent Embodied Tasks in Open-Ended Cities
当具身智能(Embodied AI)的研究视野从封闭的室内桌面、起居室,逐步拓展到真实的城市街区时,研究者们面临的现实困境往往远超算法本身的复杂度。在现实城市中部署无人机(UAV)、自动驾驶车辆(CAR)与地面四足机器人协同作业,不仅成本高昂、危险度极高,而且几乎无法复现偶发的突发事故以排查究竟是哪一环决策脱节。更棘手的是,现有的具身模拟器大多处于“各自为政”的分裂状态:车辆模拟器不懂机械动力学,四足机械狗仿真器容纳不下整座城市的宏观尺度,而专长于无人机空气动力的引擎又无法与高精度的地面交通流顺畅交互。
ArXiv URL:https://arxiv.org/abs/2608.08045v1
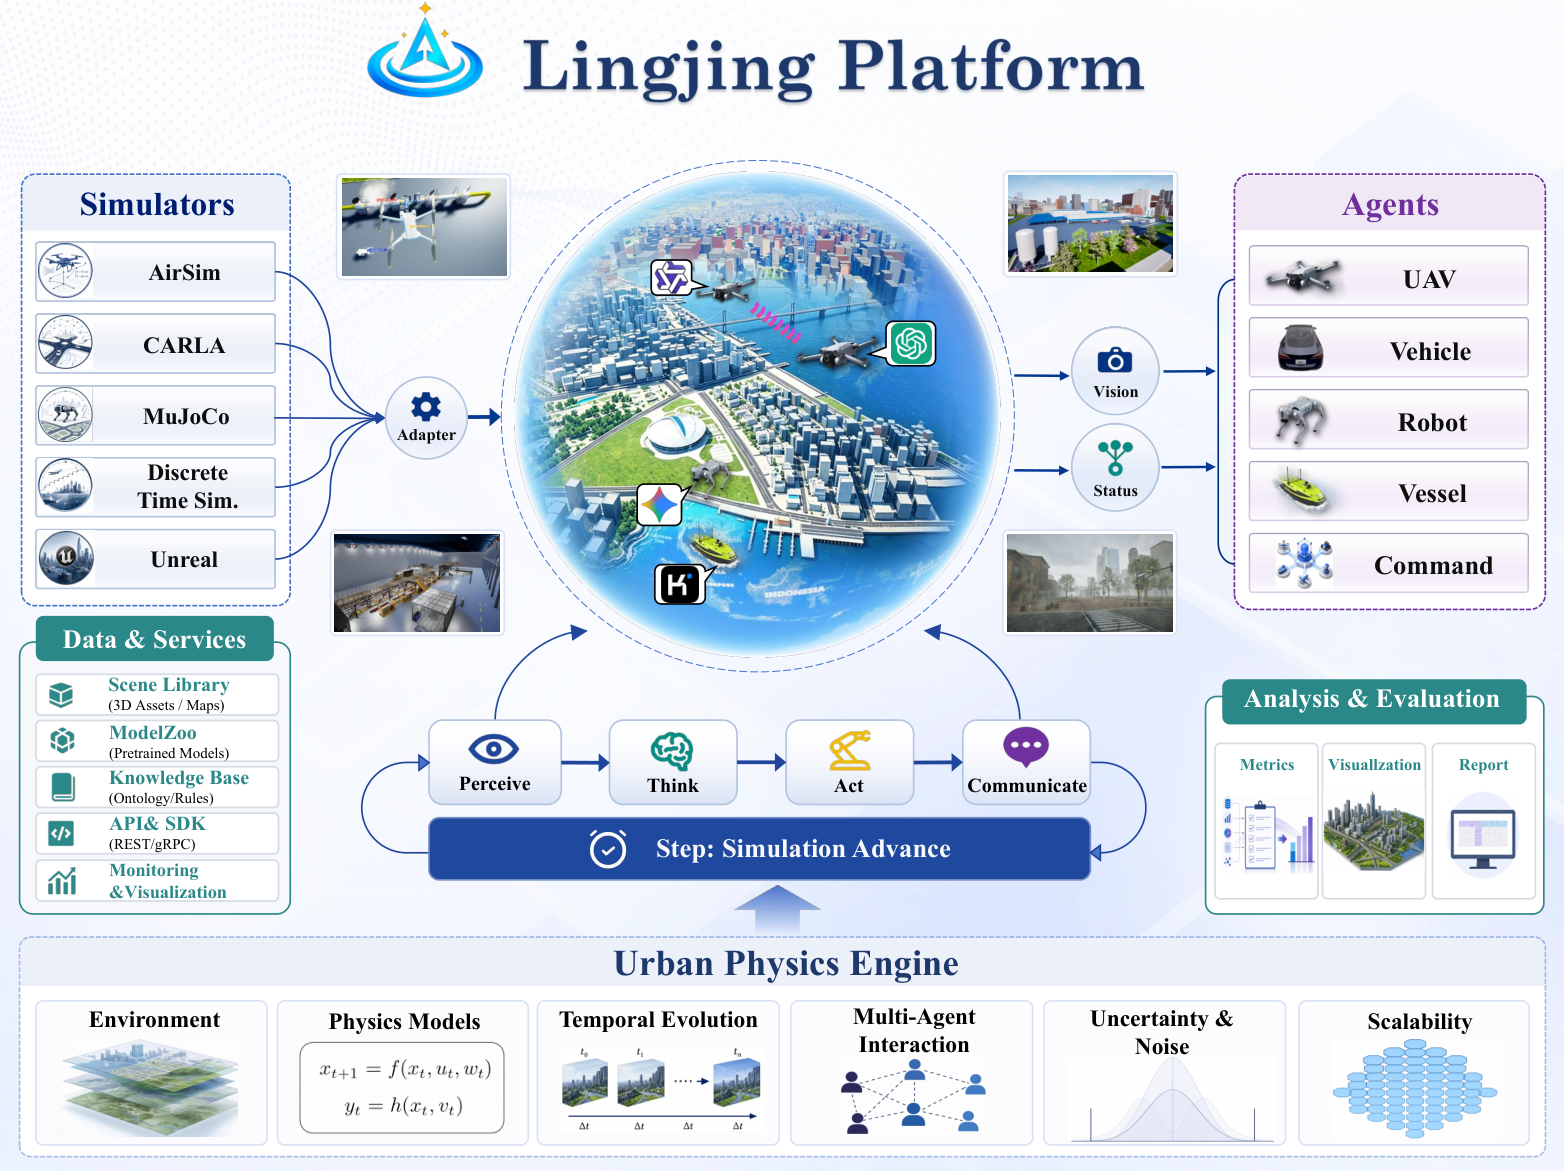
由中国科学院空天信息创新研究院、目标认知与应用技术重点实验室以及上海交通大学人工智能学院等机构组成的研究团队,提出了名为 Lingjing(灵境)的开放城市异构多智能体具身仿真评测平台。这项工作首次在统一的地理空间坐标与渲染管线下,跨内核同步了 AirSim、CARLA 与 MuJoCo 三大专业物理引擎,并接入海事模拟系统。研究团队设计了一套支持角色解耦与多种通信拓扑的 Gym 风格交互接口,推出了覆盖导航、巡检、物流配送、应急救援等 9 类高难度城市任务的基准测试,并以此对 12 款主流商用与开源多模态大模型(MLLM)进行了系统评测。
实验结果揭示了多模态模型走向复杂实体世界的核心软肋:即便能力最强的 GPT-5.5,在整套开放城市任务中的综合任务成功率(TSR)也仅为 66%;绝大多数模型并非“看不懂”图像,而是在从视觉检测跨越到空间绝对定位(Grounding & Localization)的环节出现断崖式性能衰减;此外,多智能体协同并不遵循“通信越自由、效率越高”的简单直觉,任务本身的依赖拓扑往往决定了星型统筹与广播分发的效率分野。
破碎的模拟孤岛:城市具身为何必须跨引擎?
现存的具身智能评测体系中,室内交互模拟器(如 Habitat、AI2-THOR、BEHAVIOR)擅长刻画微观的物体操纵与室内导航,却受制于孤立的静态房间边界;自动驾驶模拟器(如 CARLA)虽然提供了逼真的城市路网与交通流,但其底盘与传感器抽象无法直接移植给低空飞行的旋翼无人机或越障行进的四足机器人;以城市群体仿真见长的系统(如 CitySim、OpenCity)虽然能驱动上万个智能体进行宏观日常轨迹模拟,却大多依赖文本或抽象图结构,完全割裂了视觉传感器的闭环物理渲染。
真实的现代城市治理与应急任务天然具有异构性。比如在一场高危化工厂泄漏事故中,必须由高空无人机快速建立宏观视野并确定受损区域,由消防指挥车穿越交通管制作出地面响应,再由四足机器狗携带防爆传感器深入管网阀门完成封堵与检修。在这个链条中,空中空气动力学、地面车辆动力学、足式机器人关节刚体碰撞动力学缺一不可。
Lingjing 解决这一结构性矛盾的核心策略,在于搭建了一个多物理引擎联合运行架构。研究团队并没有试图从零重新编写一套万能却平庸的物理内核,而是以真实世界地理空间数据为基底,构建了能够容纳不同物理特性的共享时空基座。平台依托高精度的地理空间影像与矢量数据(实验中精确重建了内蒙古鄂尔多斯与上海典型城区的开放环境),结合 ArcGIS CityEngine 生成具有逼真建筑高度与立面材质的三维城市模型,并在 Cesium WGS84 全球大地坐标系下建立时空参考基准。
在底层运行管线中,Unreal 引擎负责提供全局统一的物理渲染,实时生成 RGB、深度与语义分割等多模态传感器视角。与此同时,AirSim 负责接管无人机的空气动力学状态计算,CARLA 推进复杂路网下的车辆运动与环境交通流仿真,MuJoCo 则精细化解算地面四足机器人的多关节接触力学。三套专业引擎的状态更新被精确对齐到主内核的时钟周期(Kernel Tick)内,任何一个引擎中智能体引发的物理变化,都会在下一拍被其他所有智能体的传感器捕获并映射为统一的结构化城市状态。这种跨引擎同步不仅保留了各物理域的解算保真度,更为跨模态多智能体的协同决策提供了首个可信的开放物理世界接口。
架构解耦:从物理世界到归因诊断的闭环
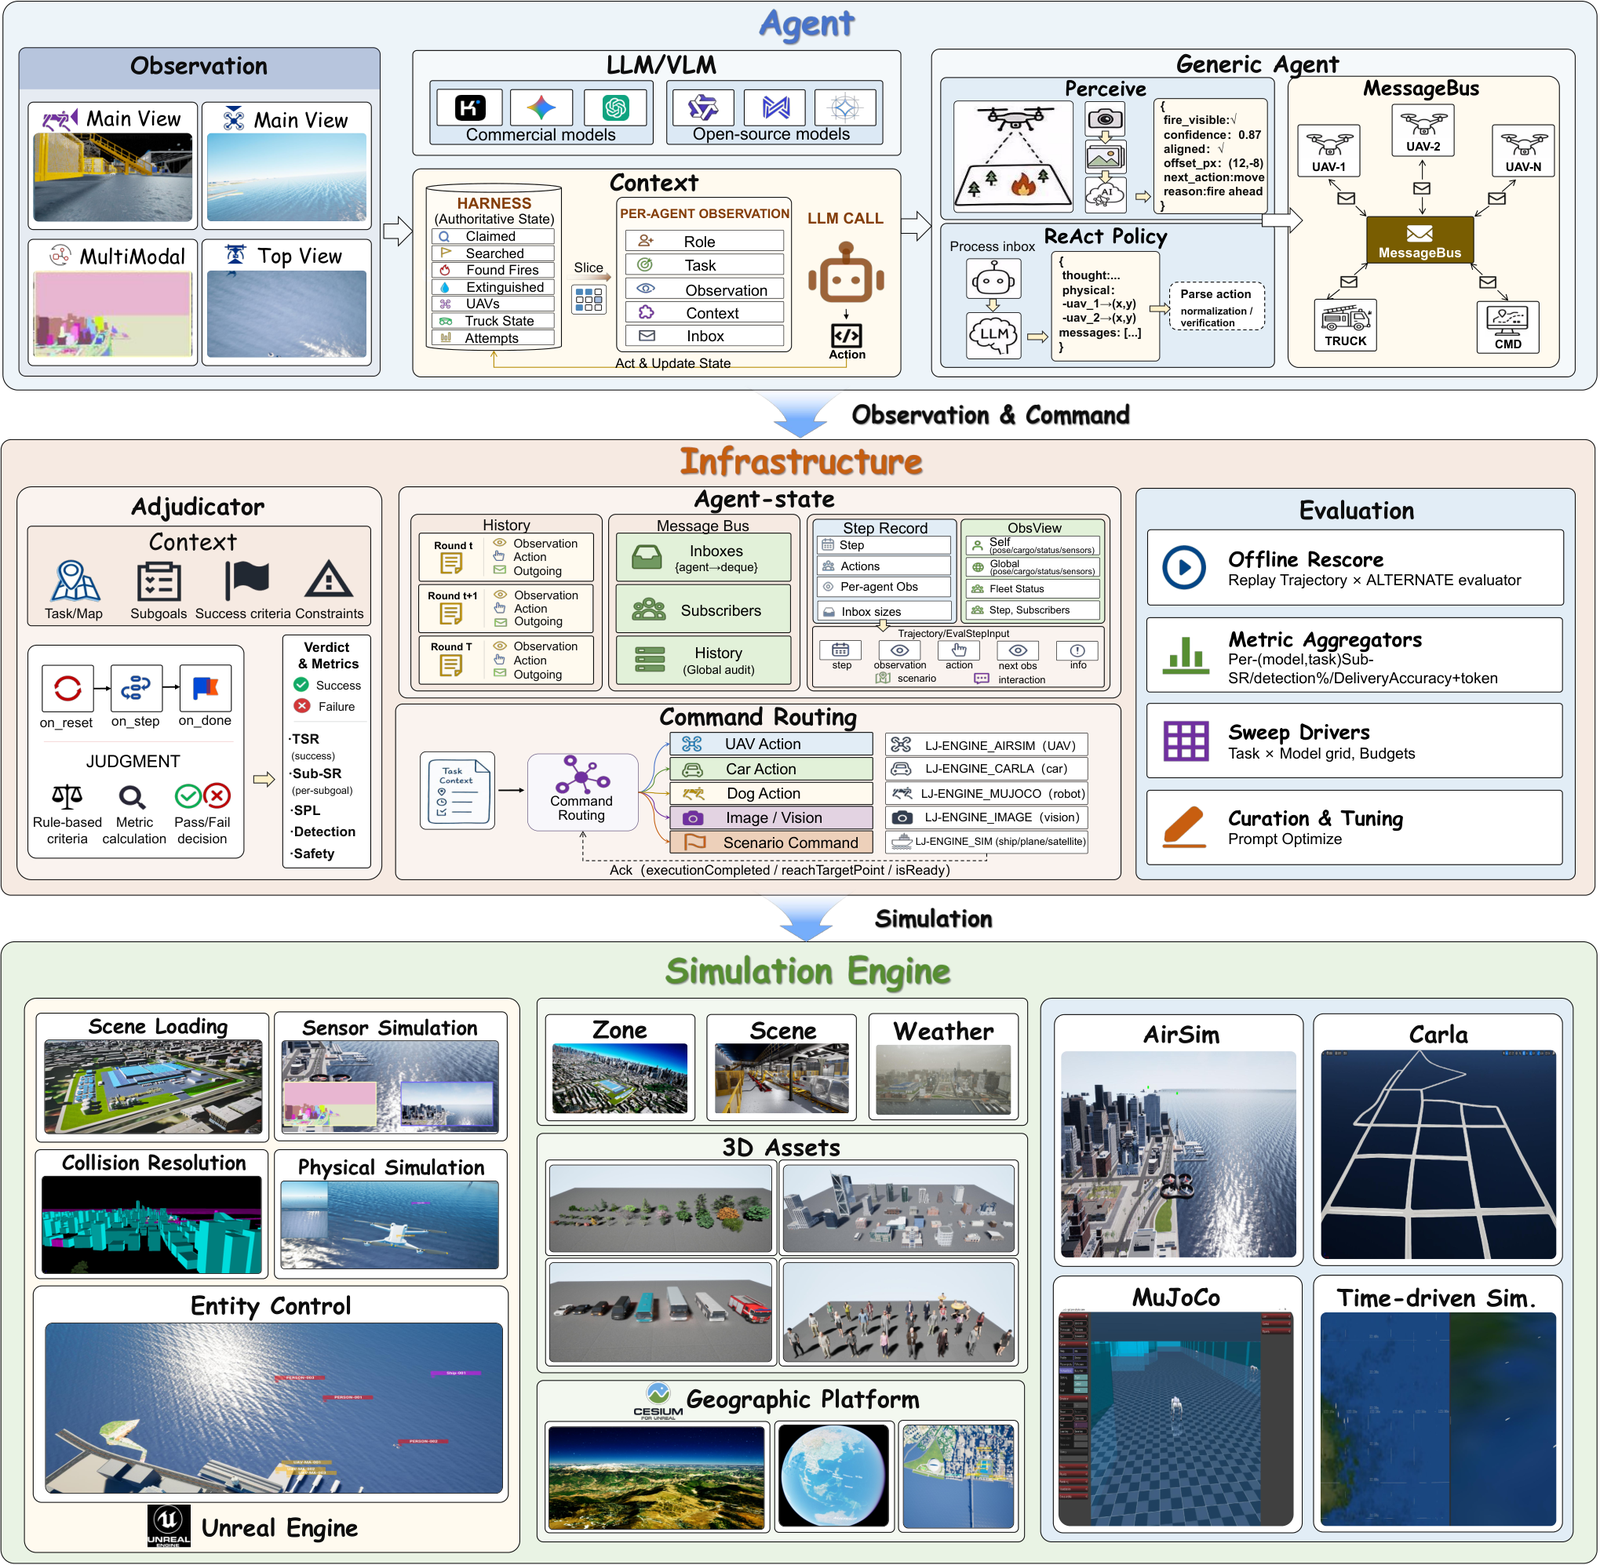
整个 Lingjing 平台的体系设计被清晰地解构为三层:底层的城市物理引擎、中层的共享基础设施,以及顶层的异构智能体框架。这种分层架构彻底切断了过去具体任务、具体机器人形态与底层算法模型之间的硬编码绑定。
共享基础设施层充当着实验控制器与严苛裁判员的角色。它包含调度内核、总线路由、物理状态仲裁器(Adjudicator)以及全链路归因记录器。传统的具身模拟实验往往只记录最终任务是否超时或失败,极难定位长程时序任务中“究竟哪一步决策埋下了祸根”。Lingjing 引入了“支持因果归因的回放机制(Attribution-ready Replay)”。在每一个时钟步内,记录器不仅会保存各个智能体摄取的视觉画面与结构化路网信息,还会完整固化其提示词上下文、大模型输出的文本思考链路、各智能体间交互发送的消息载荷、任务关系图的变化轨迹,乃至每一次大模型调用的 Token 消耗与推理延迟。
一旦智能体做出决策,内核判定器直接基于物理引擎的底层精确真值(如泄漏阀门的密闭状态、救生圈与落水者的欧式物理距离)来客观结算任务事件,杜绝了大模型在评测阶段“自说自话”判定成功的幻觉。当任务失败时,分析者可以像使用调试器单步回退代码一样,回溯整个长程任务执行链条,精准剔除感知漂移、通信丢包、空间误判或下游动作执行失调等不同维度的错误诱因。
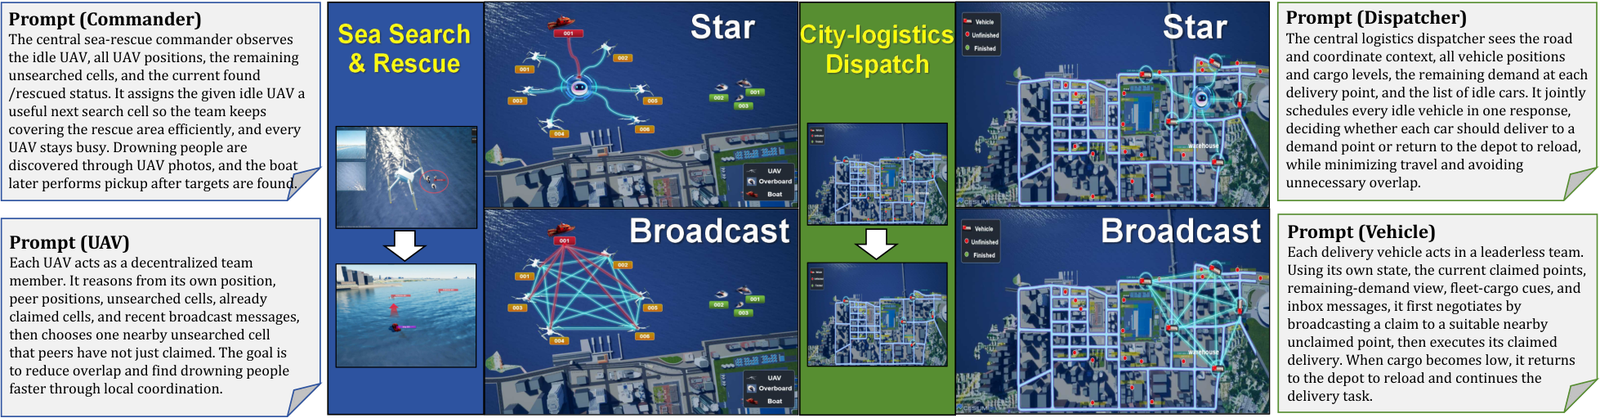
在顶层的智能体框架中,Lingjing 暴露出了标准化且兼容 Gym 的环境交互接口,将智能体统一定义为基于 ReAct 模式(Reasoning and Acting)的认知循环。在这个契约下,智能体的物理形态与其在团队中承担的逻辑角色、通信权限被彻底解耦。同一个四足机器人接口,既可以单兵运行基础导航策略,也可以接入由无人机充当“空中指挥官”的搜救小队,而无需对底层控制代码进行推倒重构。平台在任务定义中支持两种基础的多智能体通信拓扑:一种是以任务分配者为中枢的星型通信(Star),另一种是去中心化的广播通信(Broadcast)。这种完备的抽象规范,使得不同规模的多模态模型能够直接接入统一评测管线。
协同拓扑的权衡:星型统筹与广播共享的博弈
为了全方位度量智能体在长程规划、复杂感知与多机协作上的能力边界,Lingjing 设计了 9 项极具代表性的城市级任务。这些任务覆盖了从单机巡检到海陆空一体协同的广泛场景,包括大范围建筑外观巡检(BI)、动态道路拥堵下的车辆路径重规划(CR)、长程多阶段末端物流配送(LD)、无人机高空导引下的地面管道抢修(UPR)、空地协同火灾应急响应(UFR)、海上空海联合搜救(SSR)以及复杂城市物流多点调度(CD)等。
在涉及多机合作的任务场景中,研究团队形式化定义了五种核心的智能体间关系原语:
-
信息交接(Information Handoff):上游感知智能体向下游执行智能体传递关键证据,如无人机在空中巡查发现交通阻塞后,将路况证据交接给地面转运卡车;
-
合作(Cooperation):不同形态的智能体分工互补,卡车负责干线长途运输,机器狗负责翻越台阶完成最终交付;
-
竞争(Competition):多个智能体在有限资源(如充电桩、特定通道或时间窗口)下的协同调度;
-
引导(Guidance):高空视角为地面盲区中的执行单元动态生成可通行的路径点;
-
依赖(Dependency):强时序因果约束,只有当前序目标被准确定位并交接后,下游动作才被允许激活。
在海难搜救(SSR)与城市物流调度(CD)两项典型任务中,研究团队深入对比了星型与广播两种通信拓扑对多模态模型表现的影响。在过去许多研究者的直觉中,去中心化的广播通信往往因为信息透明度高、智能体间能直接对齐信息而更具优势。然而,在 Lingjing 提供的精准定量监控下,真实情况展现出了显著的任务依赖性。
在包含强时序依赖与资源分配约束的城市物流配送(CD)任务中,智能体需要在多个运力与不同重量的订单间做出最优匹配。固定使用 Qwen-3.7-Plus 作为基座模型的对照实验显示,星型拓扑由中央调度器集中收集各机状态并统一规划派单,能够将最终的任务成功率(TSR)从广播模式下的 48% 大幅提升到 62%。更为关键的是,由于避免了智能体之间无休止的点对点试探与协商冲突,星型通信下的总交互消息数从广播模式的 38 条骤降到 6 条,有效通信数据量从 55.4 KB 削减至 11.2 KB,收敛轮数从 6.1 轮缩减至 1.0 轮,甚至任务分配与理论全局最优解之间的差距(Assignment Gap)也由 22% 显著收窄到 10%。在存在运力上限的订单(如 250 kg 超重件)面前,广播通信极易出现互相推诿或并发抢单导致的死锁,导致订单彻底无人承接;而星型模式则能高效做出拆单分配。
相反,在海上搜救(SSR)或火灾初期的应急响应(UFR)等时间敏感型任务中,核心诉求是在开阔区域内快速消除不确定性并同步隐蔽目标状态。此时,广播拓扑能够让任何一架巡航无人机在发现疑似目标的一瞬间通知全网,使搜索重访率大幅降低。尽管广播模式在火灾响应中让交互消息量从星型的 6 条暴增至 61 条,但它在 12 款测试模型中的 8 款上带来了绝对的任务成功率增益。这一鲜明对比清晰表明,大模型在城市多智能体系统中不能盲目套用去中心化架构,通信拓扑的选择必须与底层任务的关系拓扑紧密匹配。
12 款多模态模型横评:谁能真正驾驭物理世界?
Lingjing 评测框架横向测试了当前极具代表性的 12 款多模态大模型,涵盖 5 款商用前沿闭源 API(GPT-5.5、GPT-5.4、Gemini-3.1-Pro、Kimi-K2.5、Qwen3-VL-Flash)与 7 款主流开源权重模型(Qwen3-VL-2B/4B/8B、InternVL3.5-8B、MiniCPM-V-4.5、Gemma-3-4B、Pixtral-12B)。所有模型在零微调的前提下,均采用同一套感知输入编码、提示词工程模板与动作空间定义,由底层物理引擎进行终局裁判。
综合性能第一梯队毫无悬念地被顶级商用模型占据。GPT-5.5 以九项任务综合平均 66% 的任务成功率稳居榜首,Gemini-3.1-Pro 与 GPT-5.4 分别以 64% 和 63% 紧随其后。在细分任务中,GPT-5.5 在 12 个评测列中夺得 5 项第一,Gemini-3.1-Pro 斩获 4 项冠军,展现出了相对稳固的通用空间理解与推理规划韧性。
在开源阵营中,阿里巴巴的 Qwen3-VL-8B 表现抢眼,以 45% 的平均成功率不仅在所有开源模型中拔得头筹,更直接追平了商用规模的 Kimi-K2.5,大幅超越了自家的 4B(36%)与 2B(30%)版本。然而从全局数据来看,模型的参数规模与其在具体具身任务上的表现并不呈现绝对的线性单调递增。在复杂的长程任务面前,不同模型的技术路线展现出了鲜明的风格差异与不可预测性。
无论是顶级闭源还是开源模型,所有受测大模型在三项任务上均遭遇了系统性溃败:建筑高精度外观巡检(BI)、复杂管道维修(UPR)以及末端微操纵物流配送(LD)。在这三项任务中,全行业顶尖模型的最高任务成功率分别被压制在 40%、50% 和 52%。这些场景的共性特征在于:它们不仅要求模型从高空或远景中发现目标的存在,还严苛依赖空间三维坐标的毫米/厘米级推断、强物理约束下的连续长程路径决策,以及跨智能体动作依赖的严格执行。这充分暴露出当前的多模态大模型本质上仍是“视觉认知上的巨人,物理交互中的跛子”。
深入失败根源:从目标检测到空间接地的惊人断崖
为了穿透模型输出的表面文本,彻底探明长时序物理任务失败的本质诱因,研究团队在相同的任务随机种子与环境下,固定以 Qwen-3.7-Plus 为决策中枢,对百次模拟任务进行了细粒度的子任务因果追溯链(Subtask Provenance Chain)解构。以无人机引导管道维修(UPR)、空地火警处置(UFR)和海难搜救(SSR)三项任务为例,研究将端到端流程切分为四个严格的前后依赖阶段:
-
目标检出(Detection):模型在连续观测流中至少一次准确识别出目标实体的存在;
-
空间接地与定位(Localization):模型在识别出目标后,能够输出符合物理引擎容限的世界空间坐标;
-
信息交接(Handoff):定位信息被下游执行智能体成功接收并完成解析转换;
-
实体执行(Execution):地面消防车、维修机械臂或救生艇最终在物理空间内抵达指定位姿并完成物理状态闭环交互。
数据揭示了一个令人震惊的现象:整个长程任务链条中最大的一次衰减,并非发生在下游异构智能体的交接或底层运动控制上,而是发生在从“检测到目标”向“输出准确世界坐标”的空间接地(Grounding)阶段。
在管道维修(UPR)任务中,从检出到准确定位的单步成功率暴跌了整整 28 个百分点;在火警响应(UFR)与海难搜救(SSR)中,这一断崖式落差也分别达到了 19 和 14 个百分点。与之形成对照的是,一旦准确定位达成,后续从定位到最终物理执行完毕的累积损耗反而收窄到了 8 至 15 个百分点。
深入到单帧感知诊断的定量评估更进一步强化了这一论断。在海难搜救与管道识别任务中,受困人员或管道裂缝在广阔场景中像素占比极小,导致单帧漏检率(Miss Rate)一度高达 71% 和 74%。但得益于智能体在城市或海域上空的持续机动巡航,多模态模型依靠海量的序列帧采样,最终实现了 88% 到 96% 的惊人全局检出率——也就是说,模型在宏观上几乎没有漏掉任何危险事件。然而,当要求模型将相机像素平面的特征解算为真实的 3D 绝对空间坐标时,其内在几何推断能力的脆弱性暴露无遗。在 100 米巡航高度下,模型推断出的受难者世界坐标中位欧氏误差竟然达到了 190 米,这一严重的定位漂移直接使得下游派遣的救援船开往了完全错误的坐标点,从而在物理判定层面判定彻底超时或失败。
在对巡检高度、搜索网格细度与动作预算的缩放控制实验中,研究还指出了具身部署中广泛存在的“边际效用递减”现象。当搜救无人机巡航高度从 60 米提升至 140 米时,单帧视场覆盖率虽然从 64% 飙升至 90%,但模型输出的定位误差也随之从 112 米剧烈恶化至 286 米;给长程配送任务(LD)的模型配置更充裕的动作步数预算时,将步数从紧张状态放宽至默认值能够换取 8 个百分点的成功率提升,但进一步放宽到宽松预算时,收益仅剩 5.5 个百分点。在多智能体系统面对更大并发任务负载(Workload Sweeps)时,模型的协同混乱度呈非线性加剧,任务成功率遭遇全面折损。
城市具身智能的新起点
Lingjing 的落地打破了过去具身智能研究中“单一算法刷单一特定仿真场景”的狭隘局面。通过用地理信息基座锚定并同步 AirSim、CARLA 与 MuJoCo 三大主力引擎,该平台让真正意义上的海陆空异构协同物理闭环仿真成为可能。更重要的是,其实验过程所提供的因果归因机制,戳破了多模态大模型在复杂现实空间决策中的虚幻表象。
这项研究清晰地告诫后续的具身多智能体系统构建者:想要让大模型接管城市级基础设施与应急系统,单纯堆砌多模态对话预训练参数、或者单纯增加无序的智能体通信带宽是远远不够的。未来的突破口必然在于模型底层 3D 空间几何接地能力的本质强化,以及根据城市任务内在物理依赖关系对通信拓扑与协同契约进行的精细化数学重构。Lingjing 所搭建的开源评测基座与全链路诊断框架,正是朝向这一终极目标迈出的坚实一步。