u-OPSD:无需任何外部监督,仅靠自身多数投票反超全监督蒸馏!
On-Policy Self-Distillation without Any Supervision
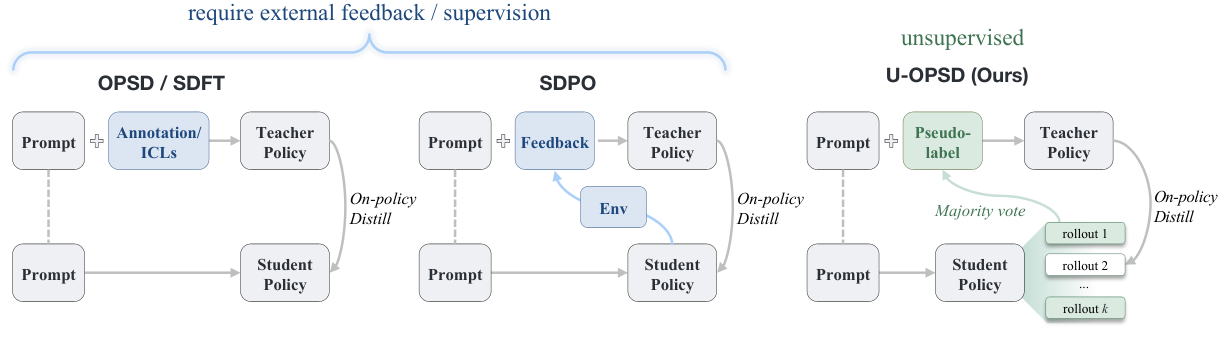
在大语言模型的后训练(Post-training)演变中,我们经常陷入一种关于“自我提升(Self-Improvement)”的认知误区。过去一年里,在强化学习(RLVR)与在线自蒸馏(On-Policy Self-Distillation, OPSD)的推动下,模型推理能力取得了跃升。然而,这些方法通常保留了一个不可或缺的外挂:要么需要昂贵的人工标注真值(Ground Truth, GT)提供最终奖惩,要么需要一个能力更强的“闭源大模型”充当教师,甚至需要极其严苛的环境反馈。这种形式的“自蒸馏”,在很大程度上只是教师与学生共享了模型参数,真正提供知识增量的本质信息依然来自模型外部。
ArXiv URL:https://arxiv.org/abs/2608.06296v1
近日,来自字节跳动、佐治亚理工学院、加州大学圣地亚哥分校(UCSD)以及马里兰大学帕克分校的研究团队提出了一项颠覆性的训练范式:无监督在线自蒸馏(Unsupervised On-Policy Self-Distillation, u-OPSD)。该方法完全剥离了外部答案和环境反馈,仅利用模型自身的内部一致性(Internal Consistency)来构建特权上下文,实现模型的自发纠错。在数学推理基准测试中,u-OPSD 展现出了惊人的泛化性能,在非长思考(non-thinking)模式下不仅大幅提升基础模型 8.5 至 10.7 个百分点,更在完全无监督的前提下全面打平甚至超越了依赖真值标签的全监督 OPSD 和 GRPO。
自蒸馏的“外挂”困境与一致性破局
强化学习与在线蒸馏之所以能显著改善大模型的推理逻辑,关键在于缓解了离线自回归微调(SFT)中严重的暴露偏差(Exposure Bias)与灾难性遗忘。在线自蒸馏(OPSD)更是向前推进了一步,让同一个模型同时兼任“教师”与“学生”:学生在给定问题 $x$ 的情况下进行前向生成,而教师则在上下文额外拼接了标准参考答案 $y^{\star}$(即所谓的“特权上下文”),随后计算教师与学生在全词表上的输出散度(例如前向 KL 散度)实施密集的 Token 级监督。
问题在于,这个提供信息优势的“特权上下文”极度依赖外界喂养。一旦脱离了数学、编程等拥有现成形式化验证机制的领域,高质量的数据集不仅标注成本高昂,且不可扩展。研究团队提出的核心问题直指这一命脉:在线自蒸馏的教师,真的必须依赖人类给出的真值答案吗?模型能否仅凭自身采样的共识,构建专属于自己的有效特权上下文?
答案隐藏在模型多路采样的内在一致性中。单次推理可能出现逻辑幻觉,但如果模型就同一个复杂问题独立生成多个解答路径(Rollouts),这些路径通过多数投票聚合出的答案,蕴含着一种非常稳健的内生置信度信号。这为彻底抛弃外部标签提供了可能。
拆解 u-OPSD:如何让模型在自己“自信犯错”的地方纠错?
u-OPSD 并没有去设计一套复杂的奖励模型,而是将极简的自洽性机制与精细的分布蒸馏深度绑定,整个流水线可以用一个闭环来概括。
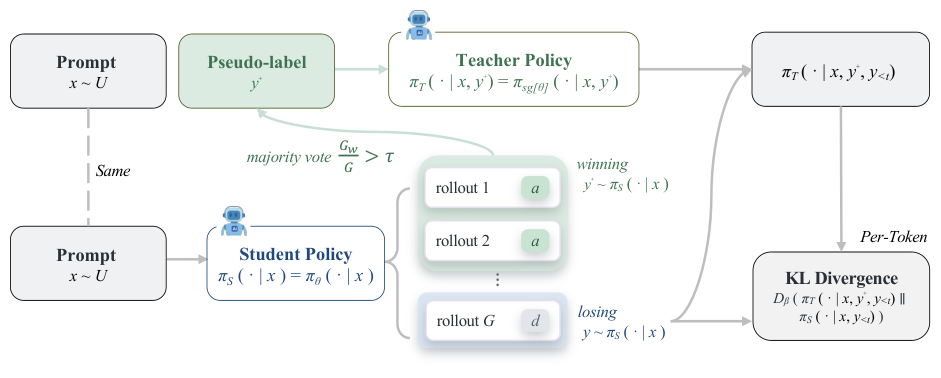
在训练开始时,系统输入一个无标注的问题 $x\sim\mathcal{U}$,当前的冻结副本策略 $\bar{\pi}$(即带有梯度截断的原模型)会独立采样出 $G$ 条推理轨迹 $y^{(1)},\ldots,y^{(G)}$。通过专用的解析函数抽取出各自的候选答案 $a^{(g)}$ 后,算法利用多数投票机制找出得票最高的胜出答案,作为“伪标签(pseudo-answer)” $\tilde{a}(x)$:
\[\tilde{a}(x)=\operatorname*{arg\,max}_{a}\sum_{g=1}^{G}\mathbf{1}\!\left[a^{(g)}=a\right]\]接下来,所有的生成轨迹被二分为两组:赞同多数票的一组 $\mathcal{Y}^{+}{x}$,以及反对多数票的一组 $\mathcal{Y}^{-}{x}$。当投票支持率越过设定的自洽性阈值 $\tau$ 时,系统从同意组中选取一条作为“伪解(pseudo-solution)” $y^{+}$,并将其拼接到教师模型的输入端,形成教师独有的特权上下文 $(x, y^{+})$。
真正的核心分歧在于学生轨迹的选取。以往的无监督或自训练策略,通常会直接对同意组中的轨迹做 SFT,或者将伪答案转为标量奖励训练强化学习。但 u-OPSD 的思路完全相反:赞同组用来打造一个更有能力的虚拟教师,而反对组 $\mathcal{Y}^{-}_{x}$ 则作为学生的真实困境路径。教师模型以同意轨迹为指引,沿着反对组轨迹的前缀进行逐 Token 条件概率评估,再将其全词表分布蒸馏给仅能看到题目 $x$ 的学生模型:
\[\mathcal{L}_{\textsc{u-OPSD}}(\theta)=\mathbb{E}_{x\sim\mathcal{U}}\,\mathbb{E}_{\{y^{(g)}\}_{g=1}^{G}\sim\bar{\pi}(\cdot\mid x)} \Bigg[\mathbf{1}\!\left[\mathcal{Y}^{-}_{x}\neq\emptyset\right]\frac{1}{\lvert \mathcal{Y}^{-}_{x} \rvert}\sum_{y^{-}\in\mathcal{Y}^{-}_{x}}\frac{1}{\lvert y^{-} \rvert}\sum_{n=1}^{\lvert y^{-} \rvert} D_{\beta}\!\left(\bar{\pi}\!\left(\cdot\mid x,\,y^{+},\,y^{-}_{<n}\right)\,\middle\|\,\pi_{\theta}\!\left(\cdot\mid x,\,y^{-}_{<n}\right)\right)\Bigg]\]这种机制精妙地切中了模型在犯错瞬间的“逻辑分叉点”。学生在生成错误答案的前缀时,教师因为在特权上下文中看到了正确的逻辑路径,能在每一个词的位置上输出一个具备矫正倾向的高维概率分布,从而在模型“自信地走入歧途”时精准施加拉回力。
实验评测:无监督打平乃至反超全监督
研究团队在 AIME24、AIME25、HMMT25、MATH500 以及 AMC23 等 5 个高难度数学推理基准上进行了严苛的实验。基座模型选用了 Qwen3 家族的不同规模与模式变体,包括 Qwen3-4B、8B 的普通模式与思考(thinking)模式,以及 Qwen3-4B-Instruct-2507 和 30B 规模的混合专家模型 Qwen3-30B-A3B-Instruct-2507。训练集采用从 OpenThoughts 抽取的 3 万条题目,但 u-OPSD 严格弃用了所有解答字段,仅保留题目文本。
在非长思考(non-thinking)模式下,u-OPSD 的表现尤为亮眼。在 Qwen3-4B 上,模型平均得分达到 49.49,相较基础模型跃升了 8.5 个点;在 Qwen3-8B 上更是达到 54.31,净增 10.7 个点。最耐人寻味的是,这个没有使用任何标准答案的方案,反而在最终得分上不仅大幅拉开了无监督强化学习基线,还分别超越了使用人类真实解答监督的 OPSD 达 3.2 和 2.3 个百分点。究其原因,多数投票筛出的伪解天然贴合模型自身的表达空间与推理习惯,与真实但风格差异巨大的外部黄金解相比,消除了分布漂移带来的负面扰动。
在长思考(thinking)模式的对抗中,由于基座模型本身体量充足、推理链条极长,各家留下的提升空间相对收窄。尽管如此,u-OPSD 在 Qwen3-4B 和 8B 上的得分分别达到 77.05 与 77.99,相较基础模型仍有 2.2 和 1.9 点的提升。在这类极度强调长链条反思的模型中,u-OPSD 依然全面领先基于人类真值奖励的 GRPO(分别超出 0.7 与 1.1 个百分点),并完全打平了全监督的 OPSD。在 30B MoE 架构的 Qwen3-30B-A3B-Instruct 评测中,u-OPSD 将 pass@1 分数从 75.77 推高到 77.46,验证了这套流程在超大规模复杂网络中的通用扩展性。
从训练动态的监控曲线来看,非思考模式下的 u-OPSD 从一开始就与基线拉开了肉眼可见的差距,并在非常早期的检查点(第 50 步左右)就迅速攀升至性能顶峰。相比之下,传统的自奖励强化学习基线则在原点附近徘徊,充分证明了将“共识”作为高维条件上下文实施 Token 级蒸馏,其信息传递效率远非扁平化的离散标量奖励可比。
深入剖析:什么在支撑内部蒸馏的有效性?
论文作者进一步对算法构件开展了一系列消融研究,解构了这项无监督蒸馏方案之所以奏效的本质要素。
首先是关于伪标签质量的定量观察。当采样数 $G=8$、阈值 $\tau=0.5$ 时,约 94.0% 的题目可以成功生成通过门槛的伪标签,而其中的 86.7% 与数据集中未被公开的真实金牌答案一致。更加关键的是,反对多数票的无效路径占比不足 10%。这意味着反对轨迹的集合规模小而高质,使得蒸馏目标得以高度聚焦于少量但致命的错误决策节点。
其次是对特权上下文内容的严格对照。实验证明,如果仅仅将投票选出的最终“纯答案”作为特权上下文提供给教师,模型的推理得分将出现断崖式暴跌(跌幅高达 11.4 至 15.6 点),甚至低于未训练的基础模型。这说明,如果教师只知道“结果是什么”,它根本无法推导出一套有理有据的过渡概率分布来指导错误的学生;教师必须阅读完整的、一步一步的思考路径,才能在学生踩坑的瞬间提供合乎逻辑的引导。
此外,针对超参数与架构选择的消融还揭示了三条重要规律:
-
自洽性阈值的选择: 令人意外的是,将阈值提高到 $\tau=0.9$ 试图获得极其纯净的伪标签,反而导致性能严重下滑至 44.40;而在阈值设为 0(即全盘接受所有投票结果)时模型表现反而最优。这反映出在大模型自蒸馏语境下,过滤带来的有效训练样本损失,其代价远大于伪标签本身微弱噪声的负面影响。
-
采样候选数 $G$ 的边际效应: 随着每题采样数从 4 扩展至 12,多基准平均得分显著提升了 4.7 点,但增加至 16 时表现反而有所回落,说明采样数在 8 到 12 之间具备极佳的性价比。
-
教师更新机制(EMA): 相比于完全冻结初始权重(Frozen),采用指数移动平均(EMA)策略让教师以 0.995 的平滑衰减率跟随学生权重缓慢演进,能在基础设置上带来额外的 2.4 至 4.1 点增益,使教师得以随着学生的强化动态进化出更敏锐的纠错视野。
迈向真正自闭环的后训练
u-OPSD 的成功为后训练范式提供了一个全新的技术支点。长期以来,社区普遍默认“知识迁移必须依靠外部信息注入”,哪怕是自蒸馏,也习惯于向真实标签借力。而这项研究用坚实的数据证明:大语言模型在预训练阶段所积累的庞大先验,其潜在能力远未通过单次贪心解码完全释放。
通过让多路径共识构建具备引导力的“自我教师”,并专门把蒸馏算力倾斜在那些“走岔了的自产路径”上,模型完全可以在没有人类金牌题解、没有编译器环境反馈、也没有昂贵闭源接口的绝对无监督环境下实现高效的自我净化与跃进。这不仅大幅压低了将推理模型拓展到冷门领域的技术门槛,也为构建全自主、可自进化的下一代大模型体系揭开了一条极具前景的实用路径。