PhysMind:让大模型把视频变成“可执行世界”,反事实物理推理超 GPT-5.5 达 19 分
PhysMind: From Video to Executable Worlds for Training-Free Physical Reasoning
当前的视觉语言大模型(VLM)在看图说话、常识问答甚至长视频摘要上已经表现出惊人的能力,但只要把问题换成看似简单的“基础物理模拟”,它们的表现就会断崖式下跌。比如:在这个碰撞场景中,如果提前撤走那个红色小球,后面的两个立方体还会相撞吗?在光滑斜面上滑下的小车,最终会停在哪个物体的左侧?
ArXiv URL:https://arxiv.org/abs/2608.04575v1
面对这类涉及反事实(Counterfactual)干预和动力学推演的问题,即便是顶级的专有大模型,也往往只能依赖文本链式思考(Chain-of-Thought, CoT)进行“盲猜”。缺乏对三维几何、连续状态和接触机制的显式建模,模型输出的不仅是幻觉,更是违背物理常识的离谱结论。
来自香港大学与清华大学的研究团队提出了 PhysMind。这套完全免训练(Training-Free)的智能体框架改变了以往直接让 VLM 端到端脑补的做法:它为每段视频仅构建一次可复用、与具体问题无关的“可执行物理世界”,随后借助解析动力学系统辨识,让模型在面对解释、预测或“如果……会怎样”的反事实提问时,通过直接在可交互世界中检查、推演或编辑物理状态来得出结论。
在物理推理基准 CLEVRER 上,PhysMind 相比同底座模型的直接 CoT 准确率暴增了 38.23 个百分点;在反事实推理任务上,它甚至直接超越了 GPT-5.5 达 19.25 个百分点。
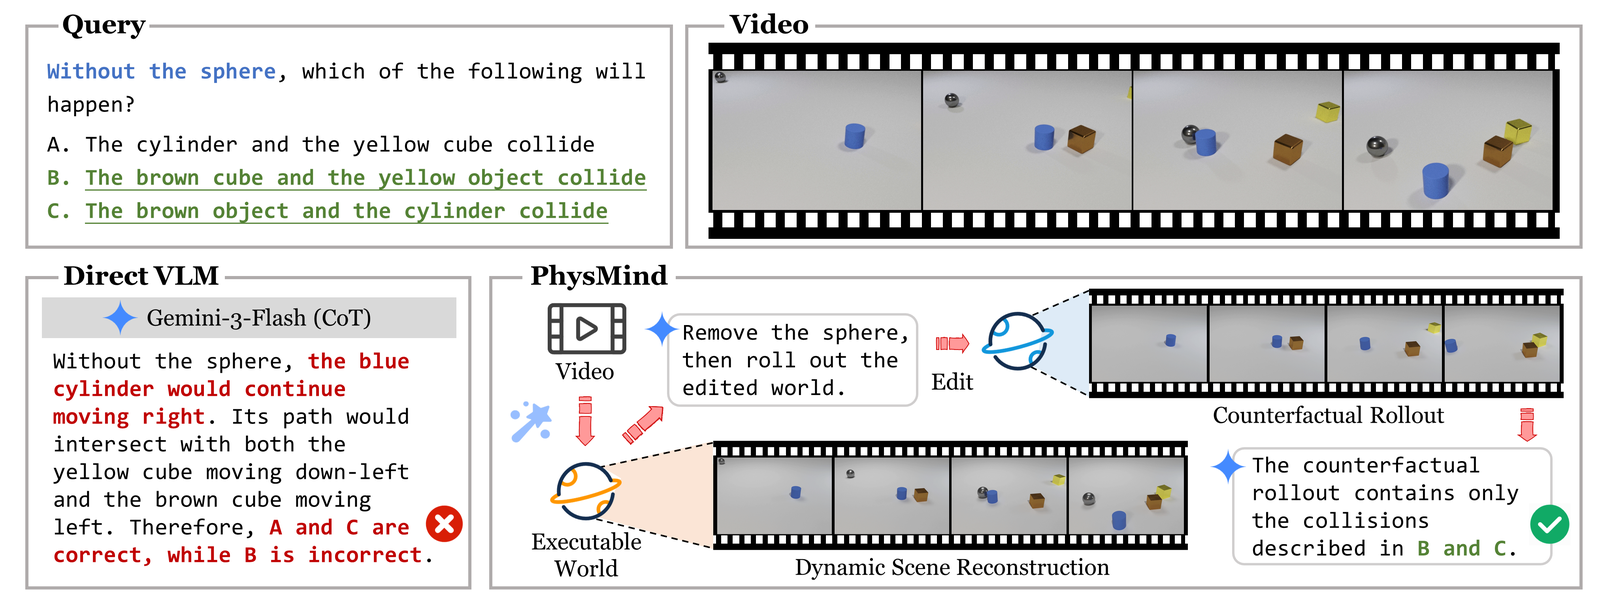
端到端脑补的局限:物理规律无法凭空幻觉
让大模型理解物理为什么这么难?
过去的探索大致可以分为两类。一类是针对物理问答做监督微调(SFT)或强化学习(RL),试图将物理先验内化进模型权重。但这种方式成本高昂,不仅难以泛化到未见过的动力学组合,还极易损害通用大模型原有的跨领域能力。另一类是免训练的推理增强方案,例如为模型配备帧记忆检索工具,或是用黑盒优化器去调用现成的物理引擎(如 MuJoCo 或 PyBullet)。
但这些方法的核心瓶颈在于:它们依然缺乏对所观测场景的显式状态转移模型。黑盒物理仿真器在进行参数搜索时,通常依赖固定的时间步长(Time-stepped)逐步离散积分,不仅计算极为沉重,长时序下碰撞带来的梯度断裂更会导致优化彻底失效。更重要的是,现有方案大多针对特定提问做临时线索搜集,换一个问题就得从头跑一遍。
PhysMind 的思路完全不同。既然物理世界本质上由几何形状、运动轨迹以及潜藏的质量、摩擦力、恢复系数等属性共同决定,那么最优解就是:在看到视频的第一时间,把场景内的物体“逆向工程”成一个带有真实物理属性的 3D 模拟环境。这个环境是一次性构建的,后续无论来多少个提问,都可以反复调用、修改和推演。
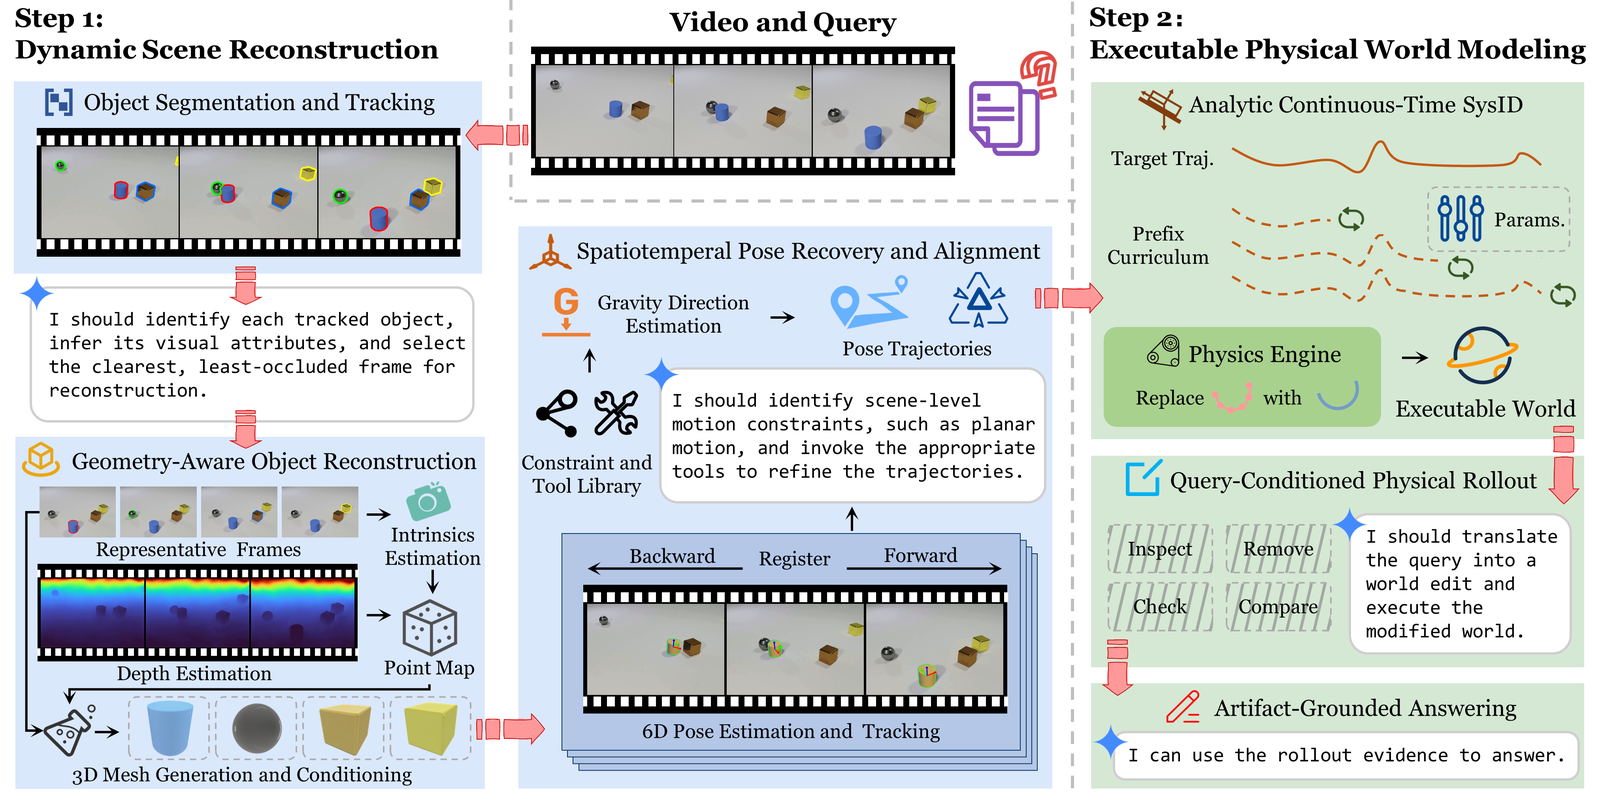
核心机制:从像素追踪到连续解析动力学
如上方架构图所示,PhysMind 的运行逻辑分为两个核心阶段:动态场景几何重建,以及可执行物理世界建模。
1. 动态场景三维重建(Dynamic Scene Reconstruction)
给定一段视频输入,模型首先需要厘清“场景里究竟有什么、它们在哪、如何运动”。
-
物体分割与身份追踪:PhysMind 使用 SAM 3 对整段视频进行宽泛目标提示,提取出物体的匿名掩码轨迹(Mask tracks)。随后在每个物体的轨迹中,算法会挑选出视野遮挡最小、最具代表性的一帧,并调用底座 VLM 为其赋予颜色、材质与基础类别等语义标签。
-
度量几何重建:利用 MoGe-2 评估抽样视频帧的相机内参,并通过组件中位数聚合成全局一致的相机矩阵 $K$。配合 Metric Video Depth Anything 提供的连续时序度量深度图,系统将关键帧的像素坐标 $\mathbf{u}=(u,v,1)^{\top}$ 反投影为度量点云:
\[\mathbf{P}_{k_{i}}(\mathbf{u})=D_{k_{i}}(\mathbf{u})K^{-1}\mathbf{u}\]该点云与掩码结合,送入 SAM 3D Objects 中恢复带颜色的规范化网格(Canonical Mesh)。
-
6D 位姿轨迹解耦与对齐:有了几何模型后,算法采用 FoundationPose 分别进行双向(前向与后向)姿态追踪,从而拼接出连续的 6D 空间位姿估计轨迹 $\widetilde{X}{i,t}=[\widetilde{R}{i,t}\mid\widetilde{\mathbf{p}}_{i,t}]$。借助 GeoCalib 对齐全局支撑平面,消除了视角畸变带来的累积误差。
2. 解析连续时间系统辨识(Analytic Continuous-Time System Identification)
有了 3D 轨迹并不等于有了物理引擎。单纯的几何外插无法预测碰撞和减速,必须反推出物体的初始速度、地面摩擦系数、两两之间的质量比以及弹性恢复系数等潜在参数(统称为参数集合 $\Theta$)。
传统的做法是用时间步长 $h$ 离散推进(即逐步数值积分),但这不仅在反向传播时带来极长的计算链条,而且遇到剧烈碰撞时极易出现数值不稳定。PhysMind 采用了解析形式的连续时间分段表征:将整个运动切分成若干平滑区间,各区间之间由瞬时冲量碰撞连接:
\[\mathbf{z}(t)=\Phi_{k}(t-t_{k};\mathbf{z}_{k}^{+},\Theta),\quad t\in[t_{k},t_{k+1})\] \[\mathbf{z}_{k+1}^{+}=\Delta_{k+1}(\mathbf{z}_{k+1}^{-};\Theta)\]在任意两物体发生接触的瞬间,直接通过碰撞动量守恒公式解析计算冲量标量 $j_{ij}$:
\[j_{ij}=-\frac{(1+e_{ij})(\mathbf{v}_{i}^{-}-\mathbf{v}_{j}^{-})^{\top}\mathbf{n}}{m_{i}^{-1}+m_{j}^{-1}},\quad \mathbf{J}_{ij}=j_{ij}\mathbf{n}\]最终的参数优化目标极为优雅:它直接最小化解析预测轨迹与视觉追踪轨迹之间的欧氏距离与对称感知旋转误差,同时引入接触几何惩罚项与软接触先验正则:
\[\Theta^{*}=\arg\min_{\Theta}\Bigg[\sum_{i,t}w_{i,t}\|\widehat{\mathbf{p}}_{i}(t;\Theta)-\mathbf{p}_{i,t}\|_{2}^{2} +\lambda_{R}\sum_{i,t}w_{i,t}d_{R}\!\left(\widehat{R}_{i}(t;\Theta),R_{i,t}\right)^{2} +\lambda_{\mathrm{contact}}\mathcal{L}_{\mathrm{contact}}(\Theta)+\lambda_{\mathrm{reg}}\Omega(\Theta)\Bigg]\]这种绕开固定步长离散模拟的解析推导,不仅在长时序追踪下保持了数学梯度的干净完整,更将参数拟合速度提升到了实时可用的级别。
3. 查询驱动的推演与问答(Query-Conditioned Rollout)
到这一步为止,整个物理世界的建立过程完全不依赖用户的具体提问。
当问题到达时(例如:“如果绿色的球没有出现,灰色的圆柱体会撞到紫色的方块吗?”),底座 VLM 充当调度器:
-
解释类问题:直接审查物理世界历史记录中的瞬时状态与接触点;
-
预测类问题:将当前动力学系统继续沿时间轴解析外推(默认外推观测时长的 20%);
-
反事实类问题:直接“克隆”已建好的基础世界,将指定的物体实体在时间初始处剔除或改变参数,然后调用物理引擎重新跑一遍推演。
最终,推演生成的结构化物理事件记录(包含运动轨迹、碰撞发生时间、接触点坐标等事实)被打包送回 VLM,由大模型负责语义总结输出最终答案。大模型不再负责物理层面的“脑补推演”,只负责做事实归纳。
实验评测:反事实问答大幅领先
团队在两个具有代表性的基准上进行了详尽测试:涵盖复杂因果、预测与反事实场景的 CLEVRER,以及专注于潜在物理属性推断的 Physion++。底层驱动 VLM 统一使用 Gemini-3-Flash,并且全流程未针对评测集进行任何有监督微调。
1. CLEVRER 上的统治级表现
在 CLEVRER 验证集(1,000 个场景,4,280 个问题)上,评价指标包括按选项独立准确率与极度严苛的整题准确率(Per-question accuracy,要求该问题的所有选项必须全对)。
实验数据表明,PhysMind 获得了 72.55% 的整题准确率和 87.22% 的单选项准确率。与采用相同 Gemini-3-Flash 底座的直接 CoT 相比,整题准确率整整提升了 38.23 个百分点;相比当前最强的大模型基线 GPT-5.5,PhysMind 也保持了 5.31 个百分点的全面领先。
尤其引人瞩目的是在反事实推理(Counterfactual)分类下:直接 CoT 的表现形同虚设,而 PhysMind 凭借真实的世界可编辑推演,在整题准确率上高出同一底座 CoT 53.95 个百分点,高出 GPT-5.5 整整 19.25 个百分点。这强有力地证实:对于现实中从未在视频画面里出现过的潜在碰撞,大模型仅凭语言上下文和纯视觉潜空间表征根本无法准确推算,必须依赖显式的动力学仿真。
而在简单未来预测任务上,GPT-5.5 依然占优(领先 PhysMind 18.75 分),论文分析指出了原因:纯预测问题往往只需将视频最后一刻可见的速度向量简单外推,通用大模型容易凭视觉流感知直接押中,但反事实推演所必须的“因果干预评估”,则是传统黑盒模型难以逾越的鸿沟。
2. Physion++ 潜在动力学参数推断
在 Physion++ 的 5 类刚体碰撞与摩擦任务中,PhysMind 的场景平均准确率达到 59.64%,比同底座 CoT 提升了 8.08 个百分点,并超越了 GPT-5.5。
分项分析表明,PhysMind 的优势主要爆发在涉及复杂动力学耦合的场景:在摩擦力-碰撞(Friction-Collision)任务上相比 CoT 提升了 17.18 个百分点,在质量-碰撞(Mass-Collision)任务上提升了 10.93 个百分点。当物理结果高度依赖两两物体之间的动量交换时,解析碰撞建模的作用不可替代。
3. 极具竞争力的推理成本
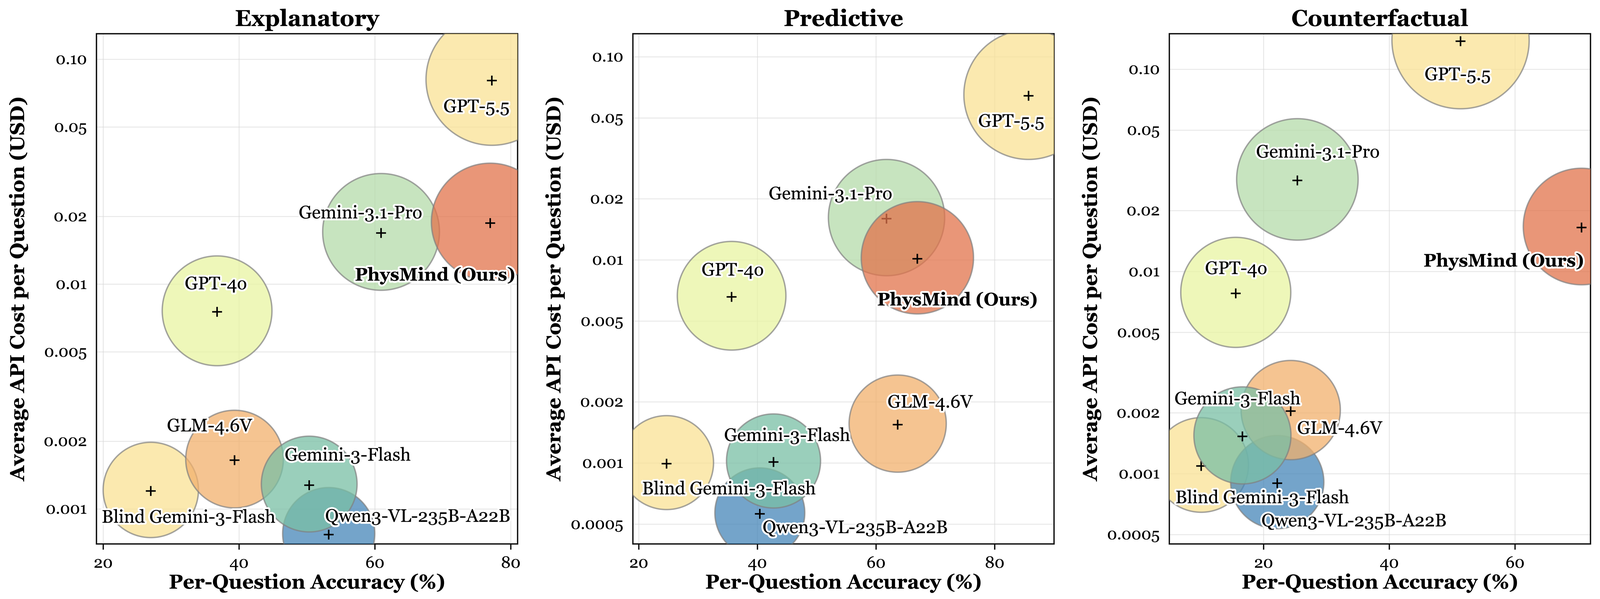
由于构建的世界模型是场景级(Scene-level)且完全可复用的,PhysMind 极大地摊薄了 API 交互成本。如上方图表所示,平均每道评测题目,PhysMind 的总 Token 成本仅为 0.01654 美元。相较而言,GPT-5.5 的调用成本是 PhysMind 的 6.30 倍,且准确率更低;而相比 Gemini-3.1-Pro,PhysMind 在准确率高出 27.08 个百分点的同时,成本反而节约了 24.7%。
消融实验:各模块究竟贡献了什么?
为了厘清各个设计环节对物理推理的实际价值,作者团队在 100 个 CLEVRER 场景子集上实施了细致的消融分析。
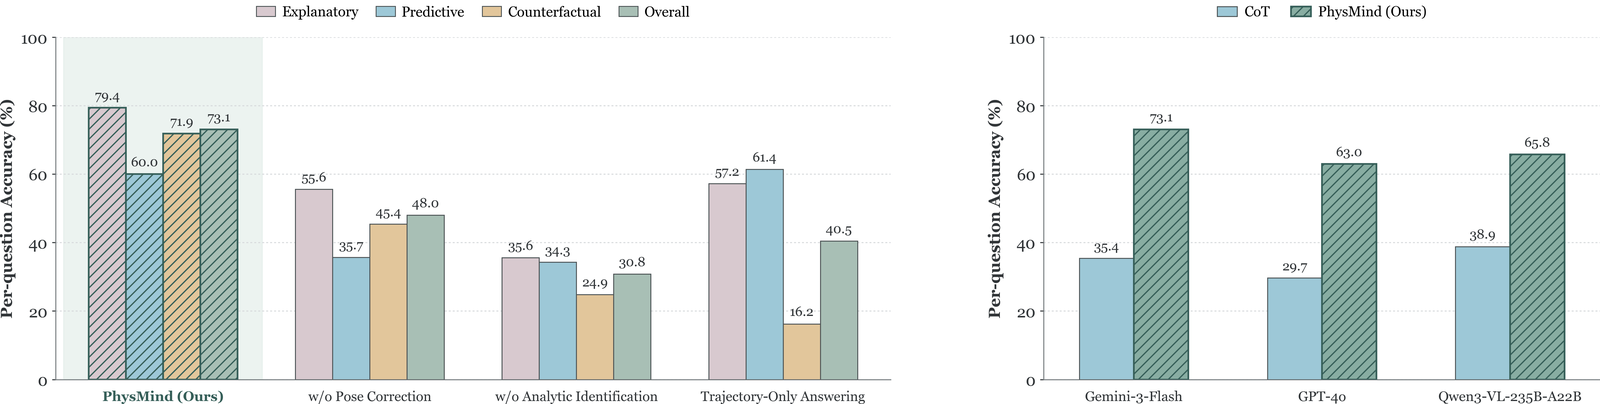
从上方的消融数据中,可以得出两项非常关键的结论:
第一,解析动力学辨识(Analytic Identification)是全套系统的生命线。如果把本文提出的连续时间解析解替换为常规的固定步长数值积分,系统的整体整题准确率会从 73.10% 暴跌至 30.80%,跌幅高达 42.30 个百分点。其中反事实和解释类任务跌幅最大(均超过 43 分),这证明数值步长积分累积的阶段误差和接触不连续性,会直接摧毁长时序推理的基础。
第二,可执行仿真推演(Execution)是破解反事实任务的核心钥匙。如果“只追踪轨迹而不执行后续仿真”(Trajectory only),模型的预测类任务准确率甚至有微弱上升(从 60.00% 变为 61.43%),因为纯轨迹拟合没有引入额外的仿真不确定性;但在需要对物体做假设剔除的反事实任务上,准确率直接从 71.89% 跳水到 16.22%,断崖式下跌 55.67 个百分点。没有显式世界的可执行干预,大模型对“如果当时不发生”的判定就会退化为纯粹的瞎猜。
此外,当研究人员将 PhysMind 的代理大脑替换为 GPT-4o 或 Qwen3-VL-235B 时,系统均在各自基线之上取得了 26.9 到 37.7 个百分点的跨越式提升,说明这套可执行世界建模机制能够稳定解耦并赋能于任何主流 VLM。
误差归因与未来物理世界的思考
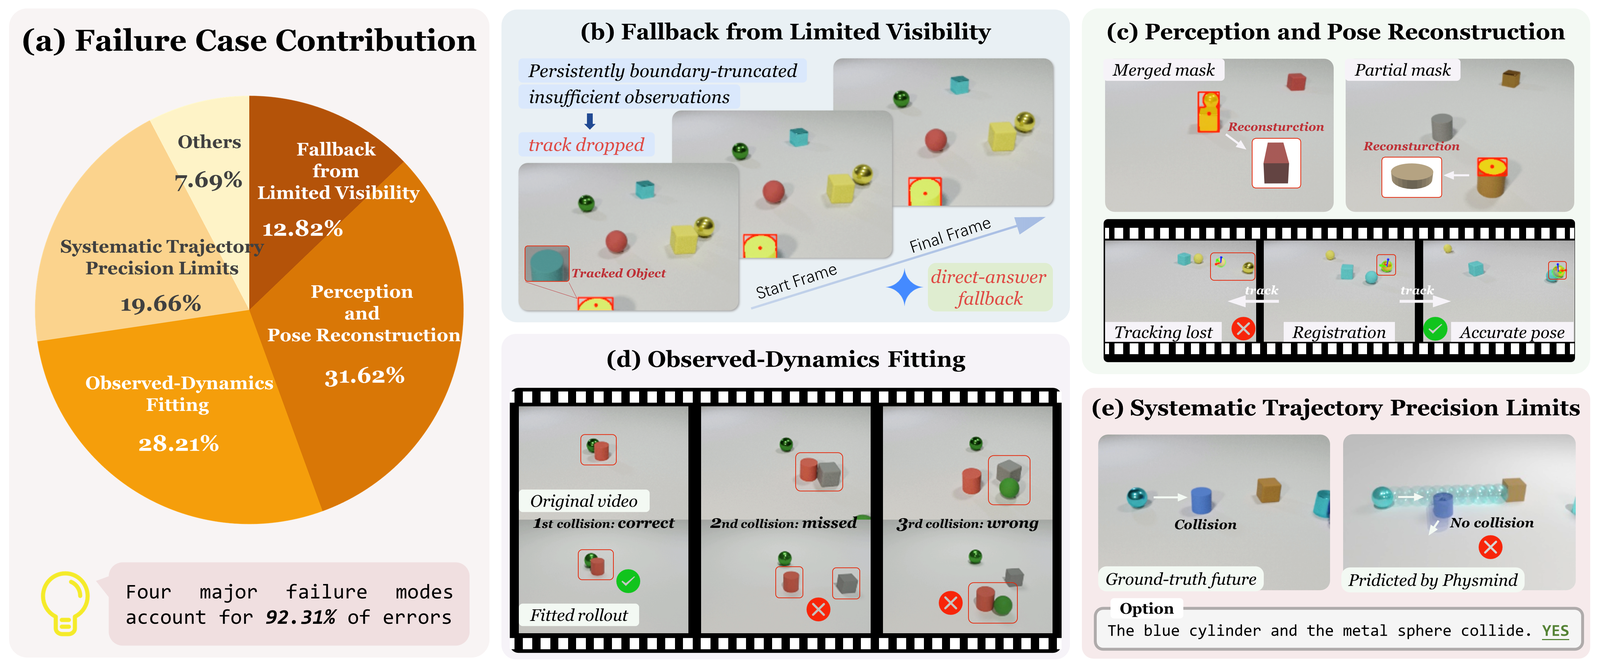
在针对失败案例的手工归因分析中,研究者将 117 处错误追溯到了最早出现的可见不一致阶段。如图所示:
-
感知与位姿重建错误(31.62%):属于最主要的瓶颈,例如物体遮挡导致掩码粘连或长条物体的网格朝向误判;
-
动力学拟合错误(28.21%):主要发生在复杂连环撞击下,碰撞时间拓扑结构的估计偏差;
-
轨迹系统精度极限(19.66%):长时序累积的微小位移漂移导致了后续接触检测的虚警或漏检;
-
边缘可见度受限回退(12.82%):镜头边缘快速滑入滑出的物体无法被稳定捕捉。
四类与“世界构建”相关的上游误差合计占据了 92.31%。反过来讲,只要前端成功构建出了合格的可执行物理世界,后端的大模型在绝大多数情况下都能做出完全正确的逻辑判断。
这为物理具身智能(Embodied AI)与大模型推理提供了一个极具启发性的思路:试图用万亿参数去端到端“内化”重力、摩擦与刚体碰撞,或许并不是性价比最高的技术路线。将感知大模型、三维几何工具与解析物理系统辨识有机编排,将视频升维还原为可验证、可交互、可因果干预的可执行世界,才是通向可靠物理常识推理的有效路径。