HumanCLAW:瓶颈不在视觉而在身体意识,最强VLM成功率仅16.8%
HumanCLAW: Can Vision-Language Models Act Through a Body?
当多模态大模型(VLM)在各类视觉问答、空间关系与推理基准上屡创高分时,一个根本性问题随之浮出水面:如果给这些模型接入一具逼真的物理肉身,让它以第一人称视角探索物理世界,它究竟能否把互联网上学来的通用推理能力,转化为每时每刻连贯、合理的物理动作?
ArXiv URL:https://arxiv.org/abs/2607.27180v1
由 Meta、布朗大学、华盛顿大学、南洋理工大学以及西北大学联合提出的评估框架 HumanCLAW,给出了一个颇具颠覆性又引人深思的答案。研究团队将未经过特定具身微调的现成(off-the-shelf)前沿模型置于闭环控制中,构建了包含 1,218 个室内长程任务的基准 HumanCLAW-Bench。评测涵盖的 9 款前沿大模型全军覆没:最强的 Gemini-3.1 最终全流程任务成功率仅有 16.8%,甚至有近半数模型的成功率接近 0%。
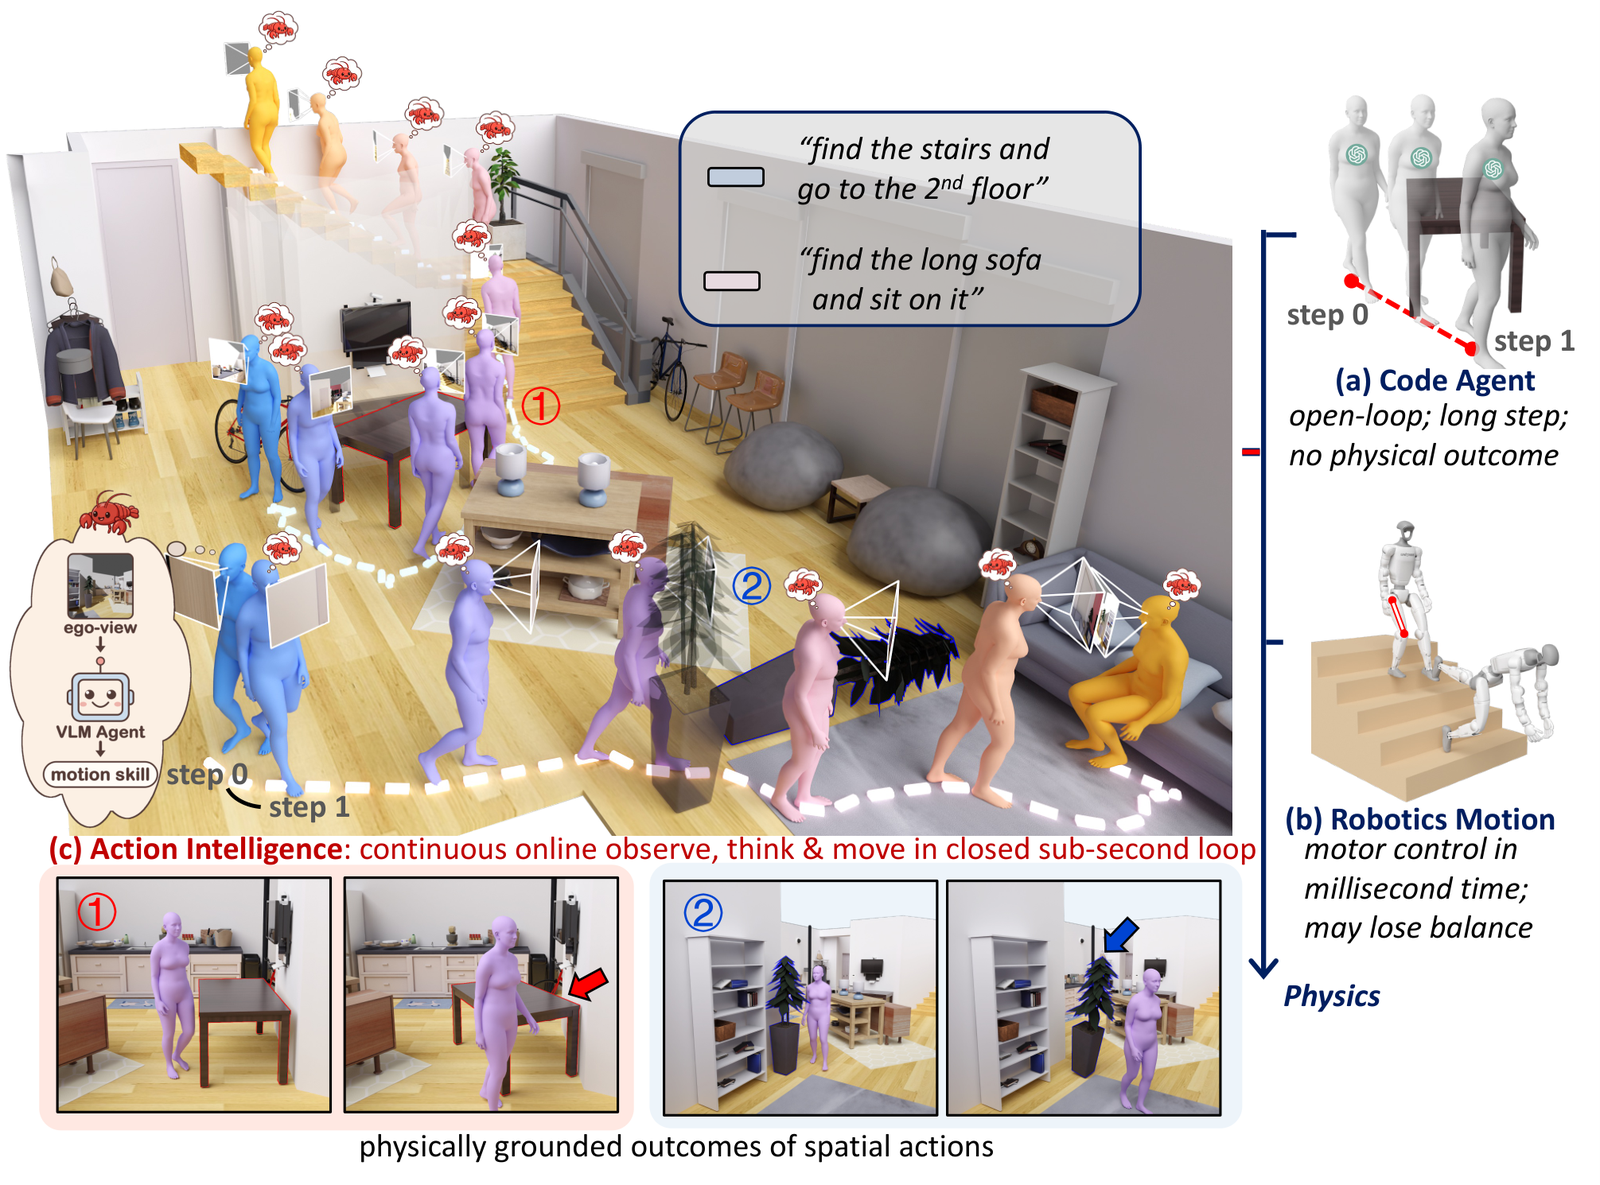
更关键的发现不是模型“不行”,而是模型“为什么不行”。实验表明,现有 VLM 的瓶颈根本不是看不懂环境或找不到目标——在视野中渲染出目标物体时,顶尖模型识别目标的准确率与真实情况相差无几。真正的鸿沟在于具身自我意识(Embodied Self-Awareness)的全面缺位:模型就像是一个游离在空间中的幽灵,看得见万物,却完全感知不到自己所操控的那具躯体,不知道四肢停留在哪里、行动是否撞上了桌角、甚至不知道自己是否已经走到了目标身旁。
为什么具身评测长期深陷“两难困境”?
要衡量一个大模型是否具备“行动智能”(Action Intelligence),现有的研究通常卡在两个互不相通的极端。
一种是传统的 Agent 仿真环境。在这类环境里,模型的动作被高度符号化和脚本化,例如输入一条指令“走近沙发并坐下”,仿真器就会通过预设动画瞬间完成这一系列动作。这种设定完全抹平了真实人体的运动学约束,模型根本不需要面对步态调整、减速缓冲或转向半径等真实物理反馈,测出的不过是高层文本规划,算不上真正的具身决策。
另一种极端是端到端具身智能(VLA)。这类方案虽然直接预测底层电机或关节点动作,但由于策略网络与特定硬件动力学深度交织,一旦机器人摔倒或任务失败,人们很难厘清根源到底是大脑决策失误,还是底层的运动控制器失去了平衡。在双足或全身人形机器人中,上下楼梯时轻微的重心失衡就可能导致跌落,这直接掩盖了模型认知层面的真实推理能力。
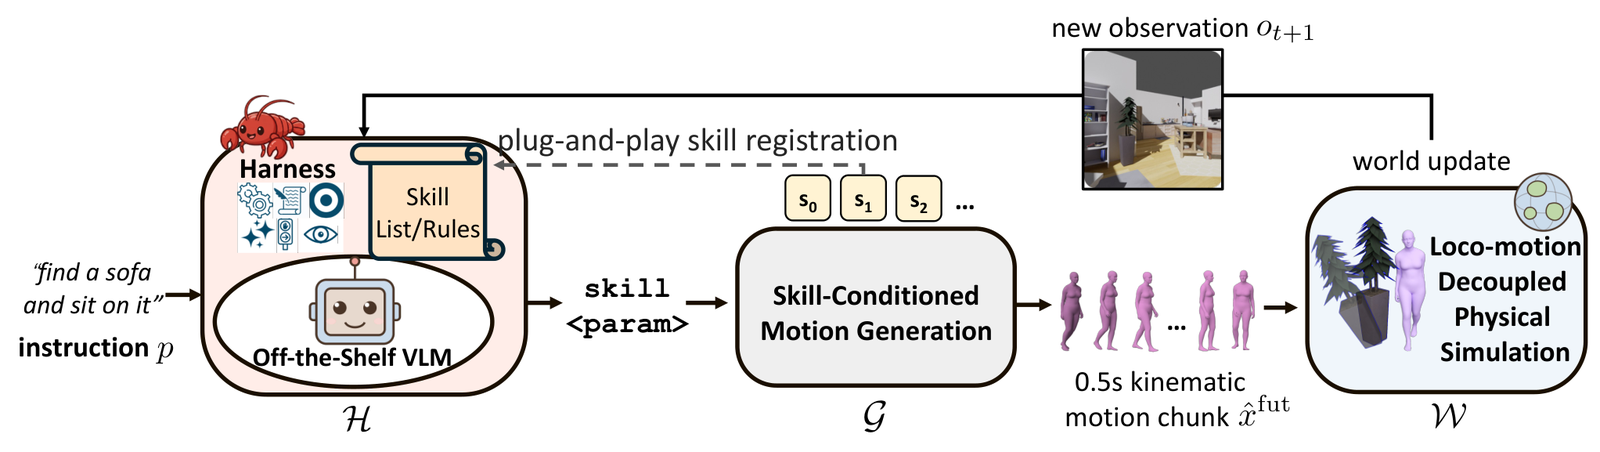
HumanCLAW 的突破性就在于提出了动作决策与运动控制的解耦机制。它既不把物理动作简化为瞬移代码,也不让底层的姿态平衡干扰对决策层的检验。它将现成 VLM 接入一个每秒触发两次(0.5 秒一步)的密集闭环:模型输出原子级的身体技能,底层的动作扩散生成器将其即时渲染为上百自由度的逼真人体姿态,再经由半物理仿真器结算重力与碰撞。模型每走一步,真实的物理后果(撞墙受阻、碰倒物体)都会如实反馈到下一帧的第一人称视觉中。这一机制把评测的焦点牢牢钉在决策本身——每次失败,都只能归咎于大模型做出了错误的行动抉择。
从原子指令到半物理仿真:HumanCLAW 如何运作?
为了让大模型在不经过针对性微调的情况下操控身体,HumanCLAW 围绕感知、决策支架、动作生成和物理反馈建立了一套精巧的流水线。
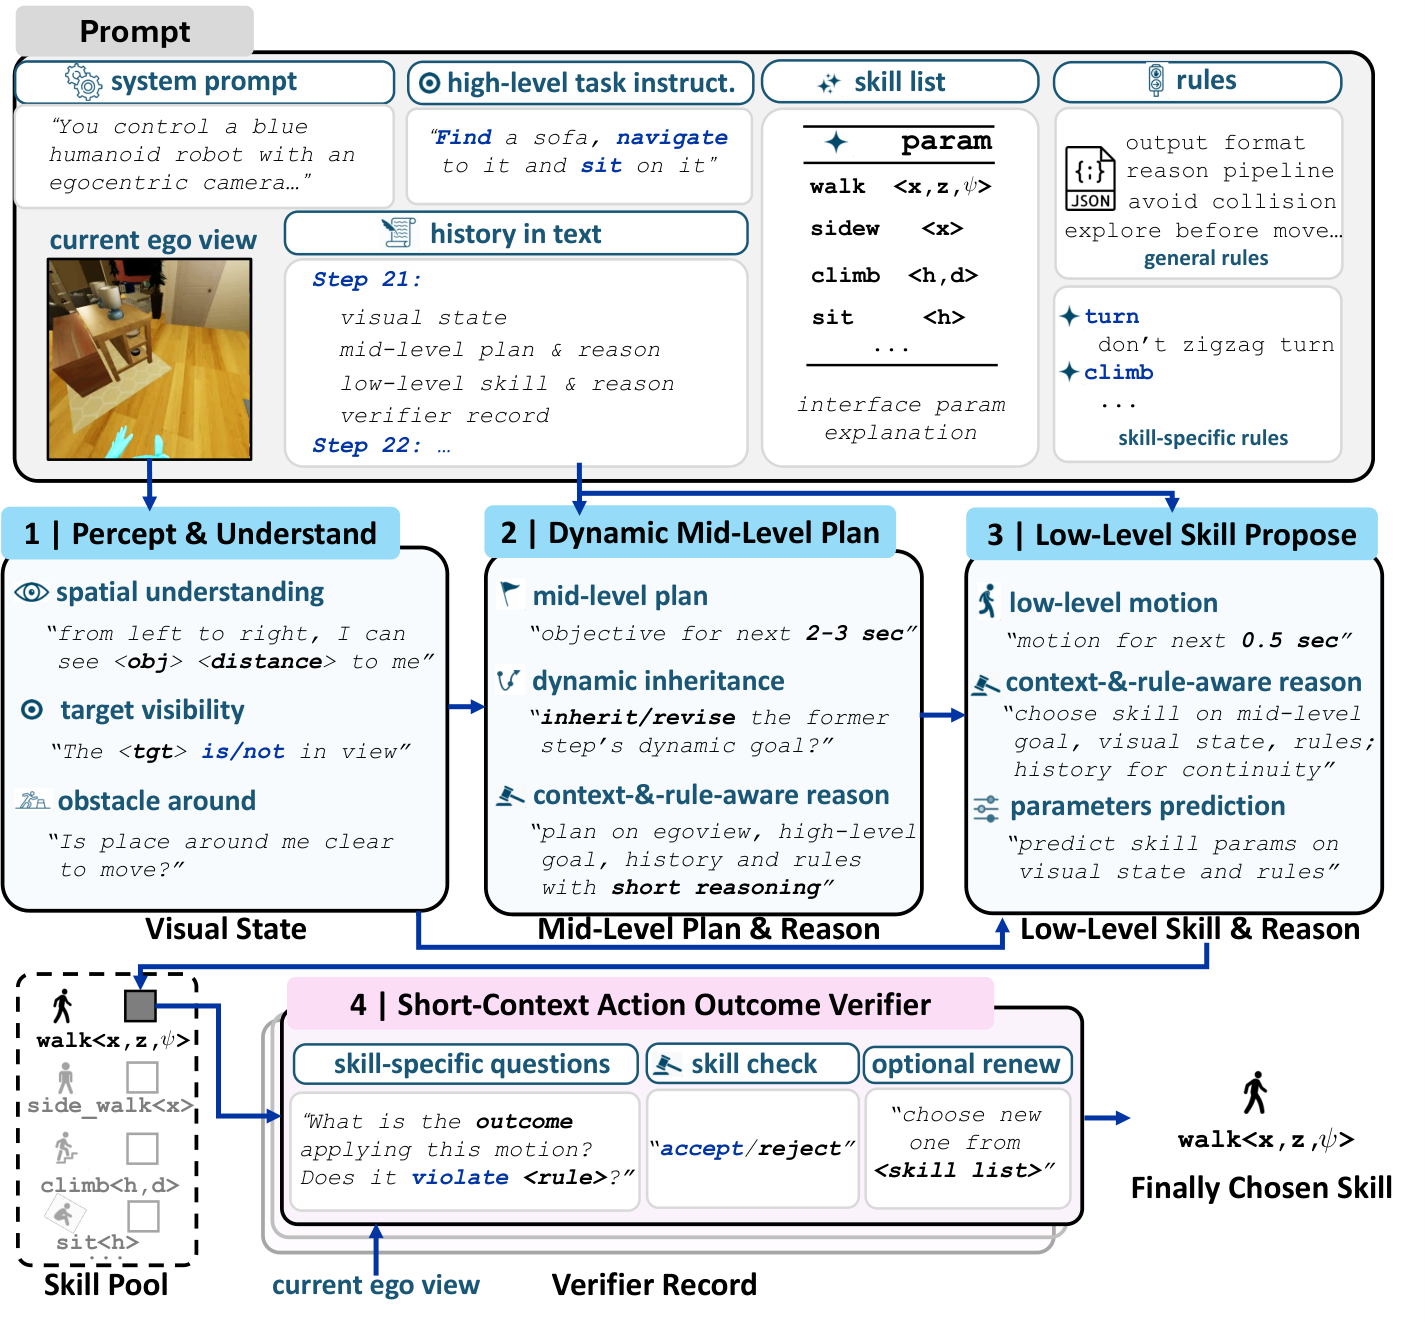
在决策端,研究团队为 VLM 搭建了一个名为 Harness 的认知支架。人类行为不是无端跳跃的,因此该支架引导模型遵循“高层环境理解 $\to$ 中层阶段目标 $\to$ 底层原子动作”的三层阶梯式推理。这里最关键的设计在于原子化技能(Atomic Skills)。模型不能直接输出“坐到马桶上”这样把搜索、靠近、转身、屈膝打包在一起的模糊复合动作,而只能调用最基础的物理原语,例如:
\[\texttt{walk}(x,z,\psi),\quad\texttt{side\_step}(x),\quad\texttt{turn\_in\_place}(\theta),\quad\texttt{sit\_in\_place}(h),\quad\texttt{stop}\]这种限定强迫大模型必须在每一步的思维链中,自行负责把长程任务拆解并缝合成连贯的物理过程。在动作被实际执行前,一个规则化的技能校验器(Verifier)还会进行空间安全性与合理性过滤,剔除那些明显不可能完成的荒谬动作。
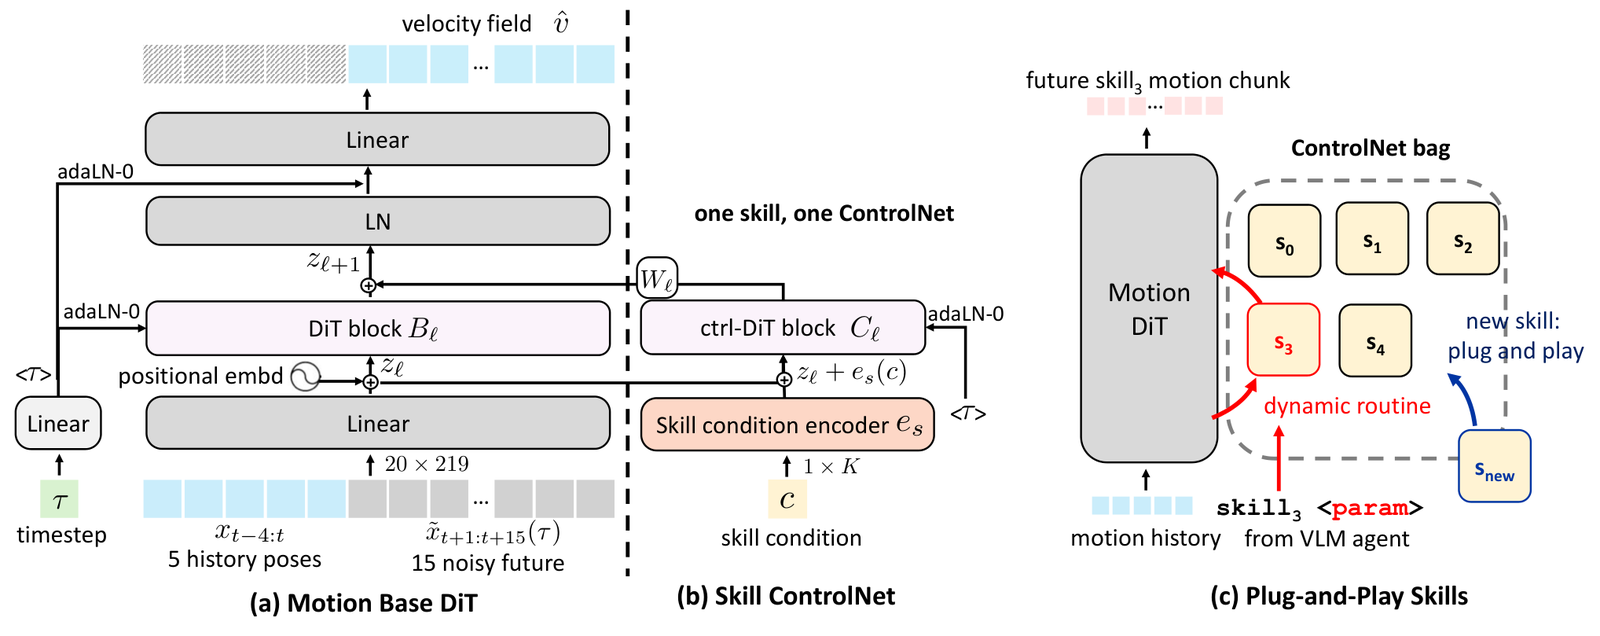
紧接着,选定的参数化原子动作被送入技能条件运动生成器。人类的真实运动包含惯性、重心转移与过渡姿态,不可能像机械臂那样瞬时转向。团队基于 AMASS 和 BABEL 数据集,训练了一个以流匹配(Flow Matching)为核心的动作基础 Diffusion Transformer(Motion Base DiT),并为每种原子技能外挂了一个零初始化的 ControlNet 适配器。这种架构在保持基础运动自然性的同时,实现了即插即用的动作保真度——无论是指定步幅的行走,还是指定高度的屈膝下坐,动作达成率均在 0.97 至 1.00 之间,几乎没有方差。
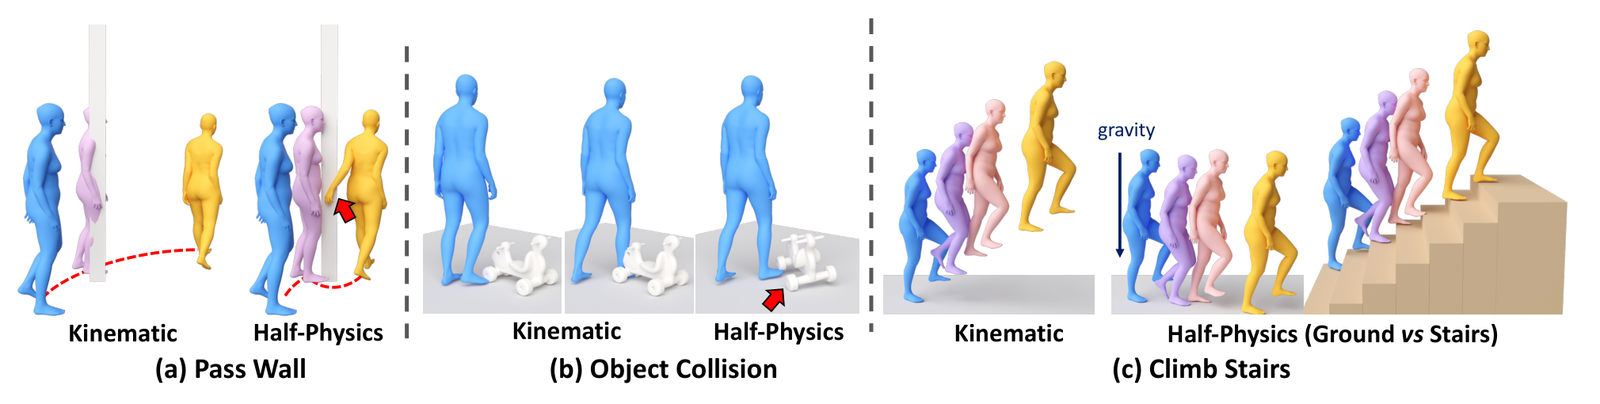
最后一步是半物理仿真(Half-physics Simulator)的落地。纯粹的运动学播放是无视环境的,会导致虚拟人直接“穿墙而过”或在空中踩楼梯;而全刚体动力学仿真又充斥着因微小接触误差导致的滑倒摔跤。HumanCLAW 巧妙地将运动学速度场注入物理引擎,同时让身体受到重力、障碍物碰撞箱阻挡以及可移动物体位移等真实物理定律约束。身体撞上墙壁会被切实挡住,双脚踏上台阶会被重力与支持力稳稳托住,模型如果盲目后退,还会碰翻身后的椅子。这一设计完美剥离了电机控制的不稳定性,使得长程任务的推进完全受制于物理合理性。
9 大前沿大模型横评:全线碰壁与关键指标
基于这一系统,研究团队在包含 41 套复杂真实户型的 HSSD 数据集中,构建了 1,218 个涵盖“寻找–导航–交互”(Find-Navigate-Interact)的全流程长程场景。每个任务不仅要穿过多间房屋、避开障碍物找到特定目标(如床、沙发、马桶、盆栽),最后还必须将身体调整到正确朝向并成功坐下。
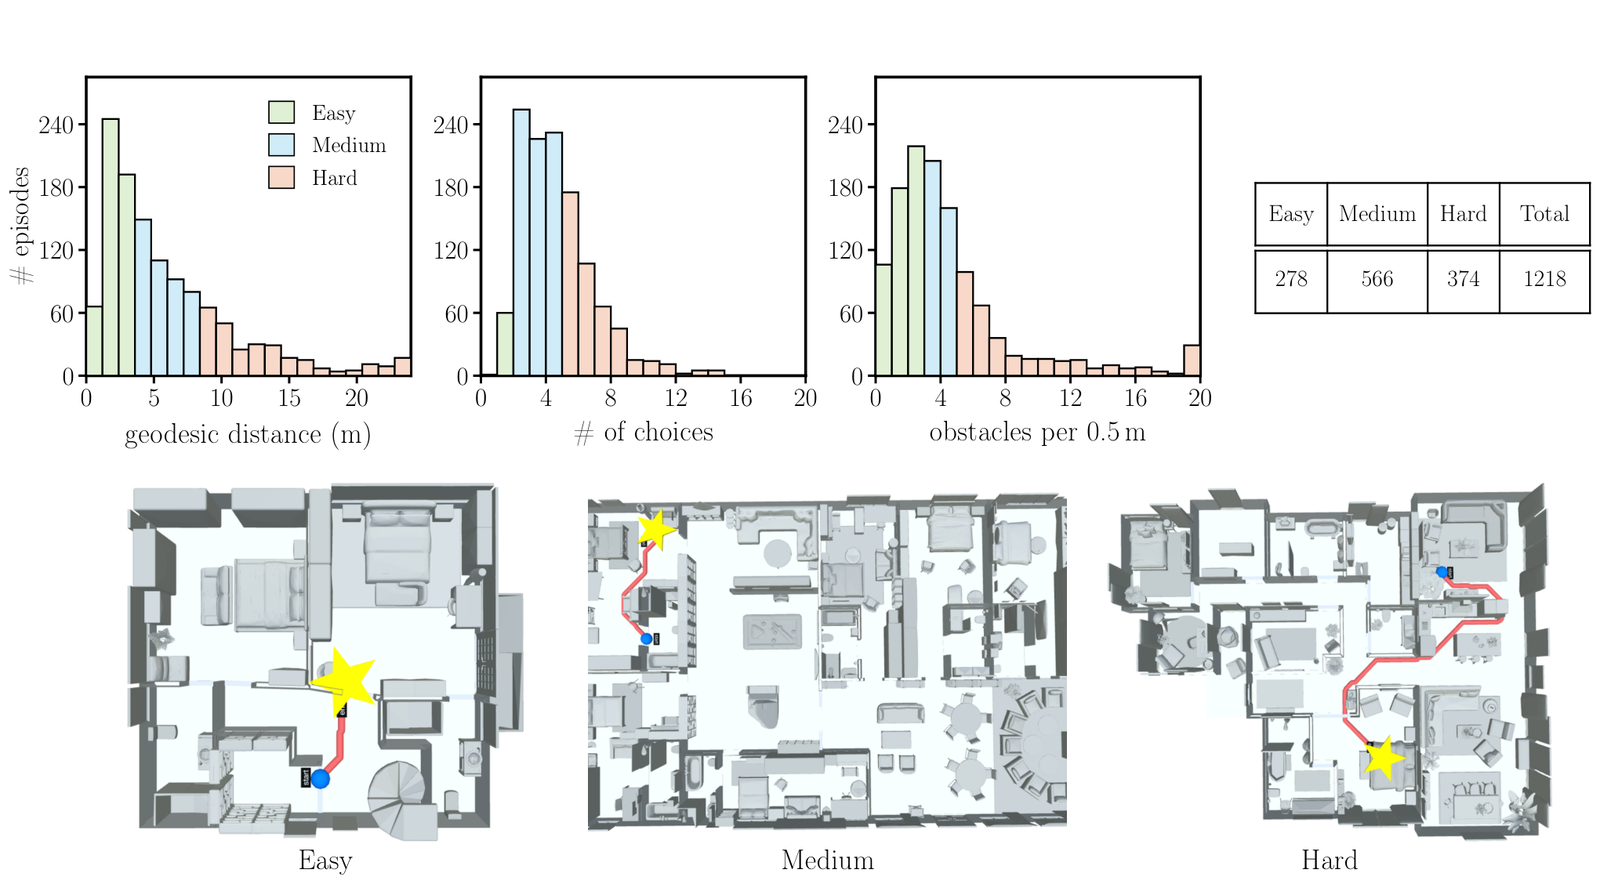
评测涵盖了目前业界最顶尖的商业模型与开源模型,包括 Gemini-3.1、Gemini-2.5、GPT-5.5、Claude-4.8,以及 Gemma-4-31B、InternVL3.5-38B、Qwen 系列等。综合各家表现,实验呈现出几组极具冲击力的对比:
-
断崖式溃败的全流程成功率:在最终需要坐下的高阶子集中,表现最好的 Gemini-3.1 成功率仅为 $16.8\%$;紧随其后的是开源模型 Gemma-4-31B,达到 $11.1\%$;而 GPT-5.5 仅有 $5.8\%$,Claude-4.8 跌至 $0.8\%$,InternVL 与 Qwen 系列的部分模型更是直接交出 $0\%$ 的白卷。
-
“看得到”与“到得了”的巨大裂隙:大部分模型都能较好地发现目标,各模型的发现成功率(FindSR)分布在 $32.6\%$ 到 $64.9\%$ 之间。但一旦要求将身体移动到目标跟前(NavSR),转化率就出现断崖式下跌。Gemini-3.1 的“着陆率”(即找到目标后真正能走过去的比例)仅有 0.65,Gemma-4-31B 为 0.49,而 InternVL3.5-38B 仅有可怜的 0.02。
-
开源力量紧追技术前沿:31B 参数的开源模型 Gemma-4-31B 不仅全面压制了参数更大的部分开源竞品,其三项核心阶段成功率(58.1% 发现、28.7% 导航、11.1% 交互)甚至全面击败了 GPT-5.5 和 Claude-4.8,成为仅次于 Gemini-3.1 的存在,证明在具身逻辑编排上,开源架构同样孕育着极大潜力。
除了任务胜负,研究团队还引入了一个非常有趣的动作质量评估指标——动作抖动度(Motion Jerk)。它测量虚拟人骨盆轨迹在三阶导数层面的平滑性,用来捕捉模型调用动作时的逻辑混乱程度。测试发现,GPT-5.5 表现得最为“优雅”,动作抖动度仅为 4.2,步态井井有条;而一些成功率尚可的模型(如 Gemini-2.5)抖动度高达 8.7,在行进中反复出现无意义的左右横跳与频繁掉头;Qwen3.6-35B-A3B 则时常陷入原地陀螺式旋转。这揭示出不少模型即便偶尔完成任务,其底层决策逻辑也充满了慌乱与随机抽搐。
拆解消融:视觉与记忆的“认知陷阱”
面对集体低迷的成绩,大家的第一反应往往是:是不是提示词给的信息不够?是不是模型历史视野太短?
针对这些假设,研究团队在消融实验中发现了一系列反直觉的认知规律。首先,技能校验器(Verifier)是闭环系统的定海神针。如果把安全校验逻辑撤下,模型的导航成功率直接从 $27.0\%$ 暴跌至 $2.0\%$,交互成功率彻底归零。缺乏校验器的模型常常在距离目标尚有数米之遥时就自信地宣布“已到达”并开始原地坐下,导致任务半途而废。
其次,长记忆与多帧视觉反而可能成为毒药。实验显示,保留 10 步左右的紧凑文本动作历史表现最优;将历史记录无脑拉长到 50 或 100 步,不仅使每步消耗的 Token 暴增至上万级别,最终成功率却毫无长进甚至出现下滑。视觉输入同样如此:在当前单帧第一人称图像之外叠加更多历史画面(如增加到 10 帧历史视角),导航成功率反而从 $27.0\%$ 锐减至 $13.0\%$,交互成功率跌至 $3.8\%$。大模型在处理物理世界的动态决策时,其瓶颈在于如何精准理解“当下的这幅画面与身体的关系”,过载的视觉历史反而严重稀释了注意力,诱发了更严重的决策漂移。
核心病灶:为什么 VLM 操控身体像个“幽灵”?
当排除了执行层面的控制器失效、排除了底层运动的生硬畸变,最终的错误归因将现有 VLM 的致命软肋暴露无遗。
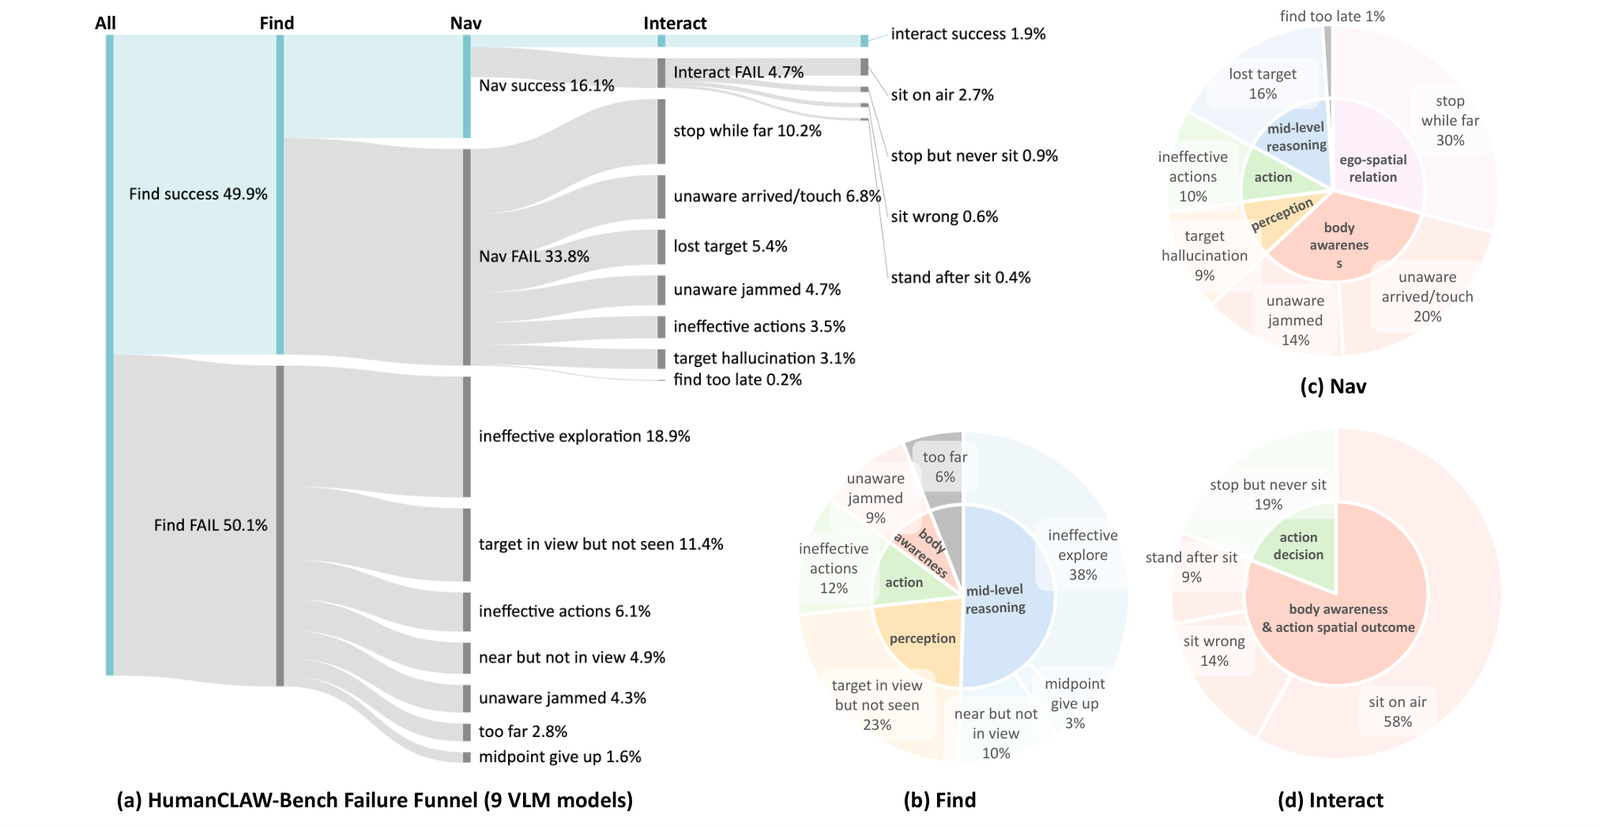
这篇论文最深刻的洞察在于提出了大模型在物理交互中的具身自我意识缺失。在传统文本与图像问答中,模型扮演的是全知全能的画外旁白;但在具身世界里,模型必须意识到“我”的存在,以及“我所占据的体积”。
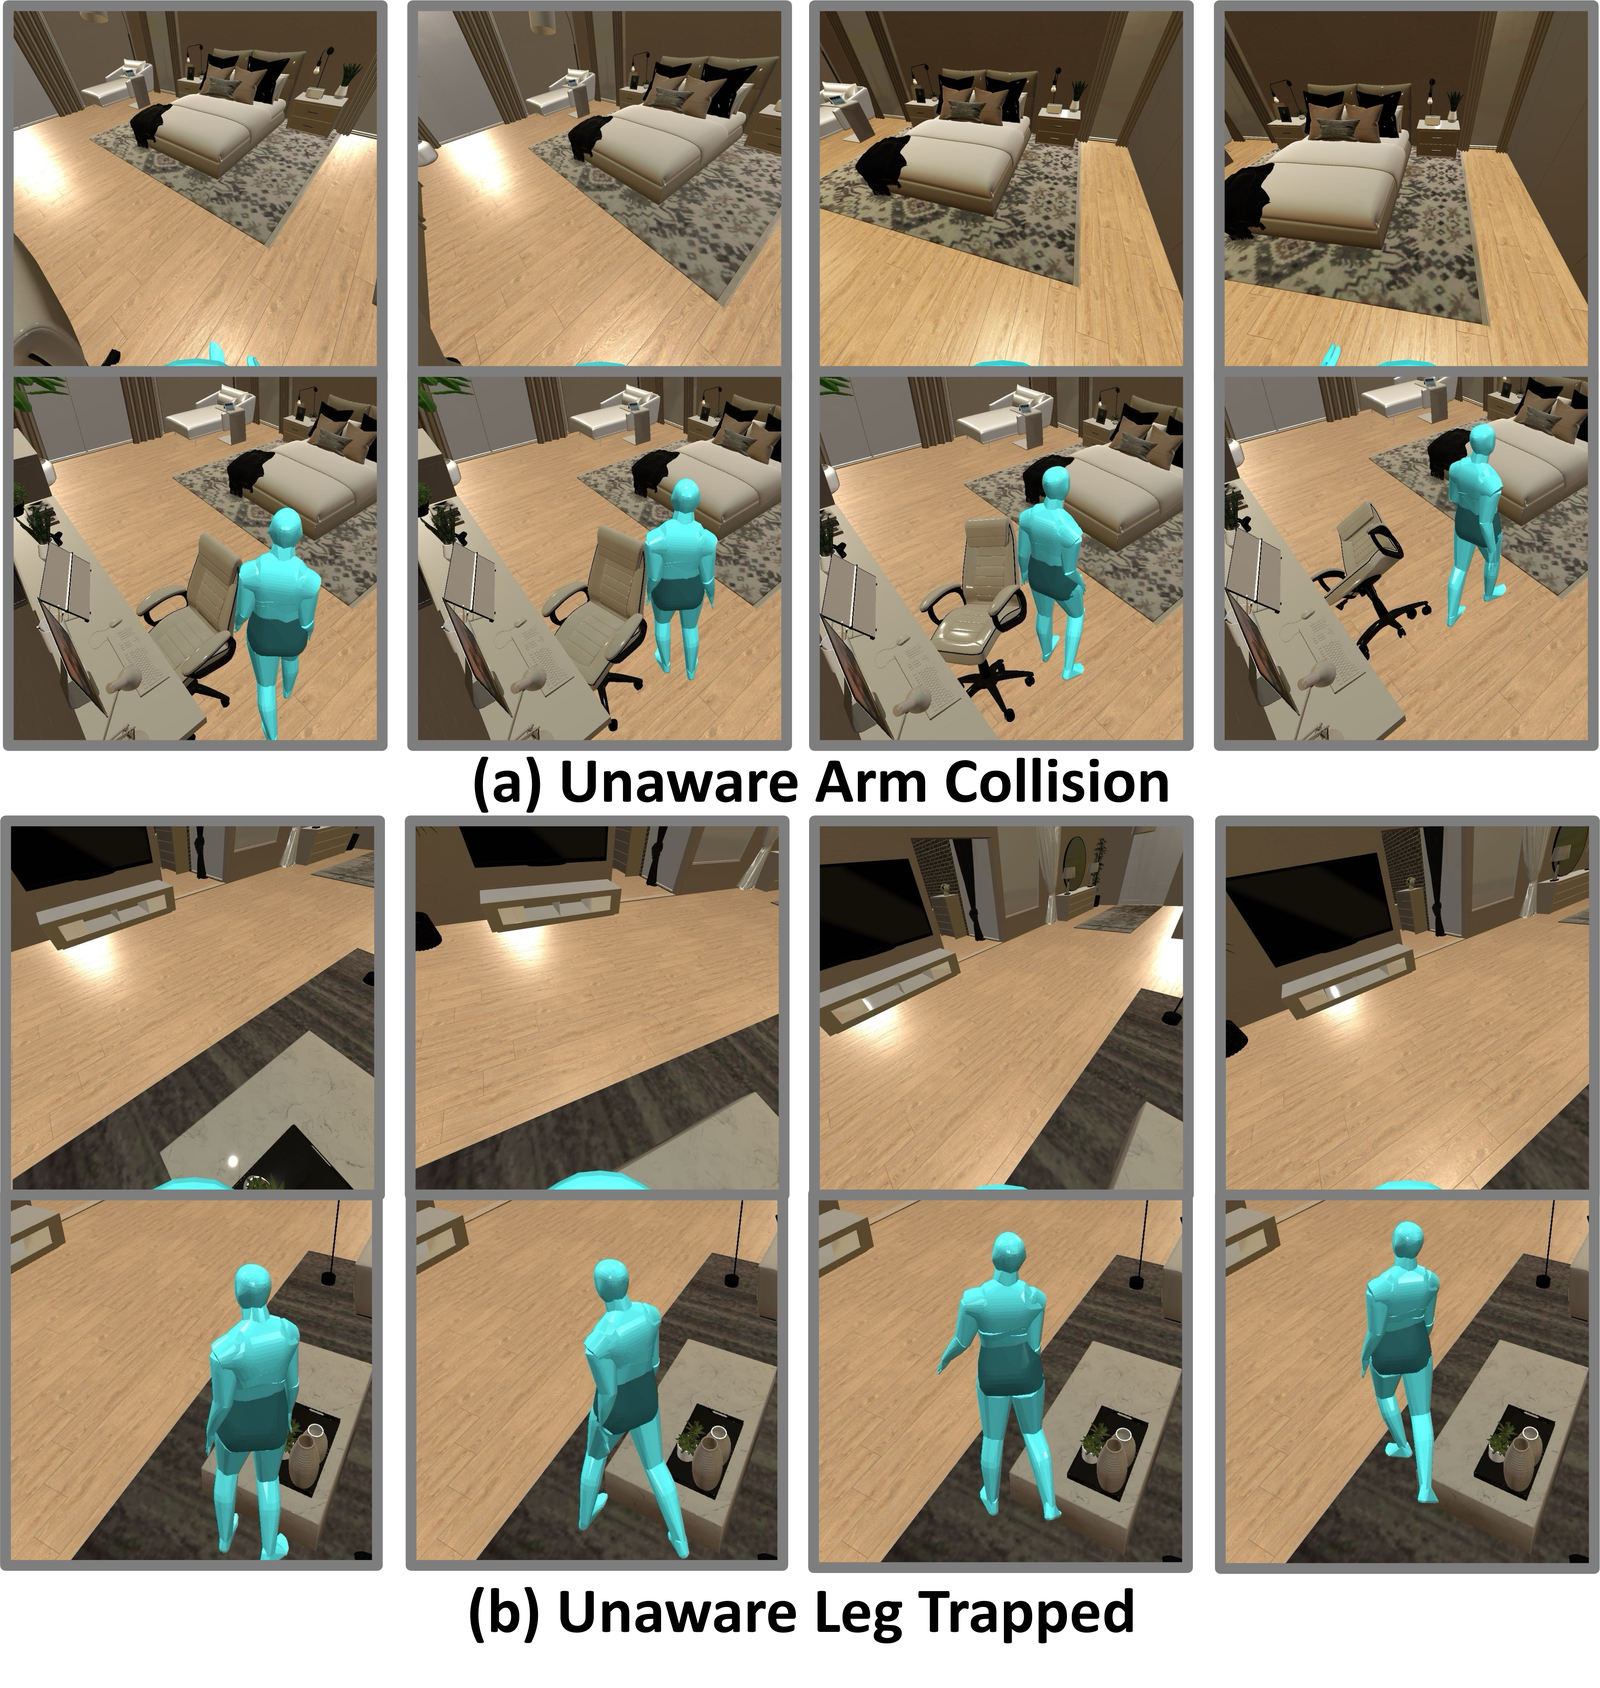
统计各部位的物理碰撞概率可以清晰地看到这种认知的割裂:在所有 9 款模型中,双腿和双脚的碰撞频率最高,占据了步数的 $28\%$ 到 $45\%$;手臂和双手的碰撞紧随其后($20\%$ 到 $35\%$);而头部由于位置较高且远离低矮障碍,碰撞率低于 $7\%$。
这种现象直观地映射在回放中:模型看到前方有一张椅子,视野正中央一清二楚,但它在向前迈步时完全不会考虑自身躯干和骨盆的横向宽度,直愣愣地用大腿把椅子撞翻;又或者,在转身通过狭窄走道时,模型的手臂早已挂在身后的门框或墙角上,导致身体卡死动弹不得,而模型在后续的推理文字中却仍在不断规划“继续向前走”。
现有的 VLM 根本没有本体感觉(Proprioception)。它不知道自己的脚正踩在什么高度,不知道双臂在视野之外伸展到了何处,更无法将上一秒发出的“右跨一步”动作与眼前视角的变化建立因果对应。它能精准识别那张椅子是一张红色的巴塞罗那椅,却算不准自己的膝盖会不会在 0.3 秒后磕上去。
走向真正的行动智能
HumanCLAW 为具身智能的发展撕开了一道关键切口。过去几年,学界与工业界在追求大模型具身化的过程中,常常把资源过度倾斜在海量机器人轨迹数据的模仿学习上,寄希望于让模型暴力记住机械臂或灵巧手的点位;或者沉浸在语言规划基准的虚假高分里。
HumanCLAW 证明了:能看懂世界,绝对不等于能驾驭肉身。大模型的通用推理能力要真正跨入物理世界,核心短板不再是扩充视觉骨干的参数量,也不是背诵更多的物体名词,而是必须补全关于自身形体、空间占据、动作动力学反馈的内在建模。让大模型学会实时估算自身躯体状态与周围环境的几何边界,从一个“悬空的旁观视角”蜕变成一个“拥有物理实体感知能力的行动主体”,将是下一代多模态物理智能体必须跨越的真正分水岭。