SHAPER:不改权重也能自进化!微软演化技能与脚手架超越微调10.5分
Self-Evolving Embodied Agents via Skill-Harness Evolution
在具身智能(Embodied AI)的研究与工程实践中,让一个机器人适配新的操作环境或未见过的任务,主流路径一直非常依赖参数更新。无论是通过收集示范数据进行有监督微调(SFT),还是利用强化学习(RL)进行策略后训练,本质上都是通过反向传播将环境反馈硬编码进神经网络权重中。然而,这种范式在实际落地时成本高昂:底层多模态大模型和动作策略模型的参数规模越来越大,微调既需要昂贵算力,又要求大量带有精准标注或奖励函数的交互数据;更现实的阻碍是,很多前沿基座模型仅以黑盒 API 形式提供,开发者根本无法触碰权重。
ArXiv URL:https://arxiv.org/abs/2608.11350v1
与此同时,免训练(Train-free)的智能体方法逐渐兴起。但以往的免训练方案大多将代码视为控制的核心媒介,依赖环境提供完备、可编程且带调试钩子的机器人 API。一旦面对底层接口固定、无法直接暴露底层控制函数的黑盒环境,纯代码生成方案便会陷入僵局。
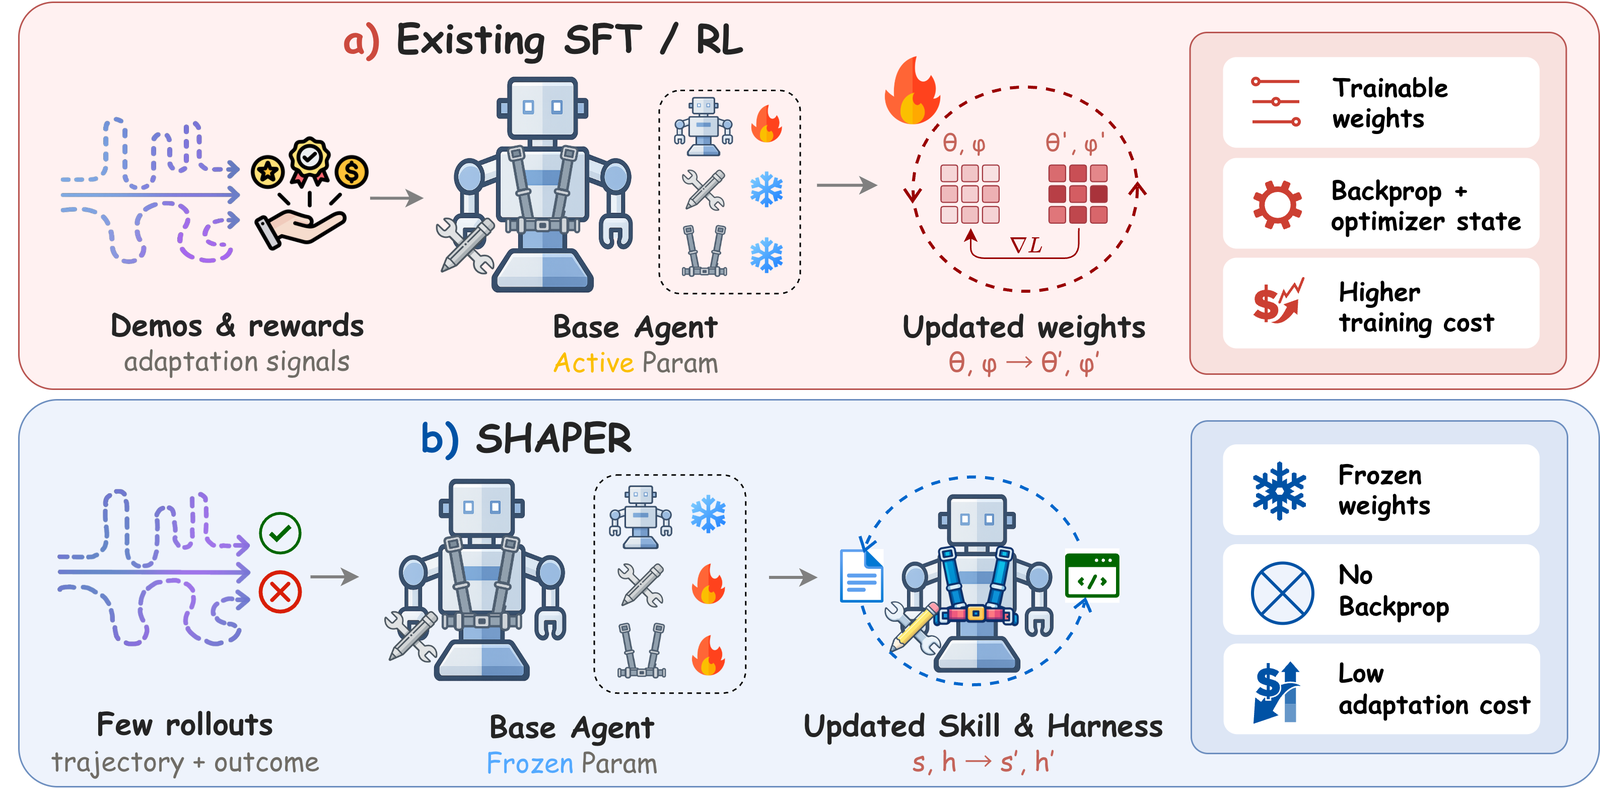
来自微软研究院和东北大学的研究团队在最新论文中提出了一个跳出传统思路的解法:SHAPER。该框架指出,现代具身智能体本质上是一个围绕基座模型构建的复杂系统,其执行表现不仅由模型权重决定,更受外部程序化指导(技能 Skill)以及上下文组织代码(脚手架 Harness)的直接制约。
SHAPER 在整个生命周期中保持高层规划模型和底层执行器完全冻结,仅仅利用目标环境中收集的极少样本(例如 10 到 15 个轨迹),让同一个基座模型扮演“优化器”角色,联合进化其外部的文本技能与上下文代码脚手架。在长程具身操作基准 VLABench 和具身主动感知基准 ESI-Bench 上的实验表明,这种完全不碰参数的演化机制,成功将 VLABench 的任务成功率提升至 34.50%,不仅超越基线智能体 6.25 个百分点,更大脑超越同数据量下的监督微调 10.50 个百分点;在 ESI-Bench 上,微平均(Micro)准确率从 32.5% 跃升至 49.8%,演化的单次 API 等价成本仅需两到三美元。这项成果表明,具身智能体的自进化不必死磕参数,演化模型外部的系统资产同样是一条可行且极具性价比的路径。
具身智能体的四元解耦:从单一策略到系统资产
要理解 SHAPER 的运转机制,首先要看它如何重新形式化定义具身智能体系统。传统做法往往把机器人策略视为一个从多模态输入直接映射到底层动作的端到端黑盒。但 SHAPER 将具身系统严谨解耦为四个相互协作的核心组件:
高层规划器 $M_{\theta}$(通常是一个冻结的多模态大模型 VLM,如 Qwen3.6-27B)、底层执行器 $\mathcal{A}_{\phi}$(如预训练的 VLA 模型 $\pi_0$ 或固定的环境动作 API)、可复用的文本技能 $s$、以及上下文构建脚手架 $h$。
在具身决策的每个决策轮次 $t$,高层规划器接收环境目标 $g$、当前视觉观测 $o_t$、外部技能 $s$ 以及由脚手架函数处理后的历史轨迹上下文 $h(\tau_{<t})$,生成一个文本形式的子目标或决策 $y_t$。底层执行器 $\mathcal{A}_{\phi}$ 随后将该子目标与观测转化为底层连续动作或 API 控制流 $a_t$:
\[y_t \sim M_{\theta}\!\left(\cdot \mid g, o_t, s, h(\tau_{<t})\right), \quad a_t = \mathcal{A}_{\phi}(y_t, o_t)\]在此框架下,模型参数 $\theta$ 和 $\phi$ 严格保持不变,动作接口和环境解析器也固定不动。优化的目标转向寻找一组最优的外部资产 $(s^\star, h^\star)$,使得智能体在目标任务分布上的累积奖励期望 $J(s, h)$ 最大化:
\[(s^\star, h^\star) = \arg\max_{s\in\mathcal{S},\, h\in\mathcal{H}} \mathbb{E}_{g\sim\mathcal{D}}\left[R\bigl(\tau^{(s,h)}(g)\bigr)\right]\]这里的技能 $s$ 并不是底层电机控制代码,而是高层程序性认知指引。它包含场景检查原则、任务拆解逻辑、针对底层执行器偏好的指令格式、错误检测与恢复机制以及终止条件。
而脚手架 $h$ 则是用 Python 代码显式实现的上下文构造函数。具身任务往往跨越数十上百步,每一步都包含高分辨率多视角图像与长程文本交互。究竟哪些视觉帧代表关键里程碑?哪些历史文本是引起漂移的幻觉噪音?应该如何对特定图像区域进行动态高分辨率裁剪?这些决定了输入给 VLM 规划器的“信息流质量”。以往的研究要么仅手工编写静态 Harness,要么只演化 Prompt 提示词,SHAPER 则首次将“高层认知逻辑”与“动态信息滤镜代码”放在统一框架中进行联合演化。
层级诊断与两阶段演化:文本梯度的生成
确定了优化对象后,核心挑战在于:如何在不借助反向传播的前提下,从少量交互轨迹中提炼出有效的“演化方向”?如果直接把长达数十步、带有大量图像的完整交互日志一股脑塞给优化模型,极易因上下文过载而丢失因果线索,优化器无法判断究竟是第几步的哪个子目标导致了最终失败。
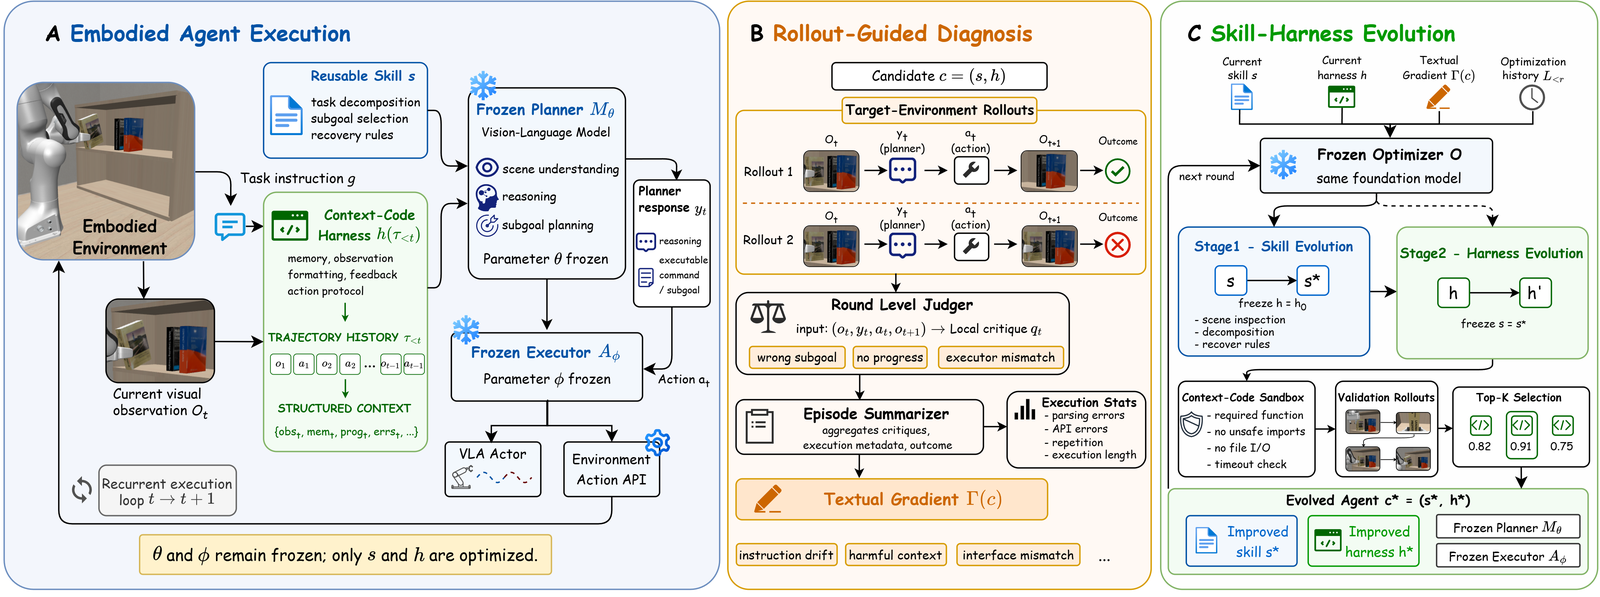
为此,SHAPER 建立了一套自下而上的层级化诊断机制,如图 2 所示。在每个优化轮次 $r$,候选资产会在极小批量的目标环境任务(如 4 个 Rollouts)上运行。诊断系统先在单轮次级别(Round-level)展开局部评判:将规划器输出的子目标 $y_t$、执行动作 $a_t$,与执行前后的即时观测 $o_t$ 和 $o_{t+1}$ 并置比对,利用判别器输出即时评判反馈 $q_t^c(g) = \mathrm{Judge}(o_t, y_t, a_t, o_{t+1})$。该机制能够精准捕捉子目标是否得到了执行、机械臂是否抓空、或者视野是否脱离了目标物体。
随后,在整幕级别(Episode-level),系统将各个单轮次的评判、执行历史摘要以及最终任务奖励 $R$ 汇总,生成该幕的深层失败根因分析 $e^c(g)$。最后,把一个 Minibatch 内所有轨迹的诊断结果与聚合统计数据拼接,形成全局的“文本梯度”(Textual Gradient)$\Gamma(c)$。这份文本梯度直击痛点,专门暴露无意义循环、指令语义漂移、缺乏进展跟踪、上下文冗余干扰、以及输出格式解析错误等具身场景特有的系统病灶。
在演化算法上,SHAPER 采用两阶段优化的束搜索(Beam Search)策略,维持一个容量为 $K$ 的精英候选池。值得注意的是,扮演优化器角色 $\mathcal{O}$ 的不是昂贵的闭源专有模型,而是与规划器完全相同的同一个冻结 VLM。研究人员仅通过切换专用的“优化器 Prompt”,让模型审视当前的技能代码、文本梯度和历史演化日志:
在第一阶段,固定初始脚手架 $h_0$,全面演化文本技能 $s$,重点解决任务理解、子任务粒度控制和底层执行器兼容性;当技能演化收敛并选出最优技能 $s^\star$ 后,流程进入第二阶段,冻结 $s^\star$,专项演化上下文构建函数 $h$。
每个生成的代码候选都会在沙盒环境中执行安全性检验,并在固定的验证集上执行完整评估 $\widehat{J}_{\mathrm{val}}(c)$。系统通过保留验证性能最高的 Top-$K$ 资产进入下一轮演化,最终输出表现最稳健的 $(s^\star, h^\star)$ 组合。
操作任务检验:为何能击败微调与推理缩放?
在具身操作基准 VLABench 上,测试任务强调隐式指令理解、常识迁移以及长序列推理。环境配置采用 Qwen3.6-27B 作为高层 VLM 规划器,底层执行器则使用在基准底层任务上微调过的 $\pi_0$ 策略模型(通过 OpenPI 调度,以 5 个动作为一组 chunk 进行闭环控制)。整个任务要求智能体在最多 10 轮高层规划和 400 步低层环境交互内完成。
实验结果揭示了极具启示性的对比。在完全相同的 15 个训练任务片段上,直接让底层 $\pi_0$ 策略执行的成功率为 23.25%;对其进行参数监督微调(SFT)后,成功率仅微弱提升至 24.00%。而搭建了未演化 Seed Agent 系统的高层规划器后,成功率直接来到 28.25%。当应用 SHAPER 进行完整的技能与脚手架演化后,在 800 个测试集上的整体成功率跃升至 34.50%,大幅超出基线微调模型 10.50 个百分点。
更值得关注的是与测试期推理缩放(Test-Time Scaling, TTS)方法的对比。近年来,在数学和代码领域大放异彩的推理解码缩放,通过采样多条轨迹并利用验证器(Verifier)或投票机制(Voting)进行筛选。然而在具身操作中,此类方法却遭遇了滑铁卢:直接应用于 VLA 动作层的 MG-Select 和 VOTE 成功率分别下跌至 21.38% 和 22.00%,低于直接执行;即便应用在未进化的高层规划器上,成绩也仅有 24.38% 和 23.50%,反而削弱了原有系统的表现。
这说明具身环境下的长程物理交互具有强烈的连续状态依赖,简单的输出采样重选无法修补系统性认知缺陷。如果规划器本身缺乏对物理约束的自省能力,多次采样只会重复同质化的逻辑漏洞。相反,SHAPER 是在系统层面永久性地修正了认知与上下文机制。
从泛化能力来看,VLABench 包含四个难度切片:C1(域内基准)、C2(未见过的操作物体)、C3(未见过的任务形式但物体已知)、C4(任务形式与物体皆未见过)。SHAPER 的优势在面对分布外漂移时尤为显著:在面对全新任务形式的 C3 上,成功率直接从 Seed 版本的 40.0% 飙升到 50.0%(提升 10.0 个百分点);在双重未知的最难切片 C4 上,亦取得了 6.5 个百分点的显著净增长。
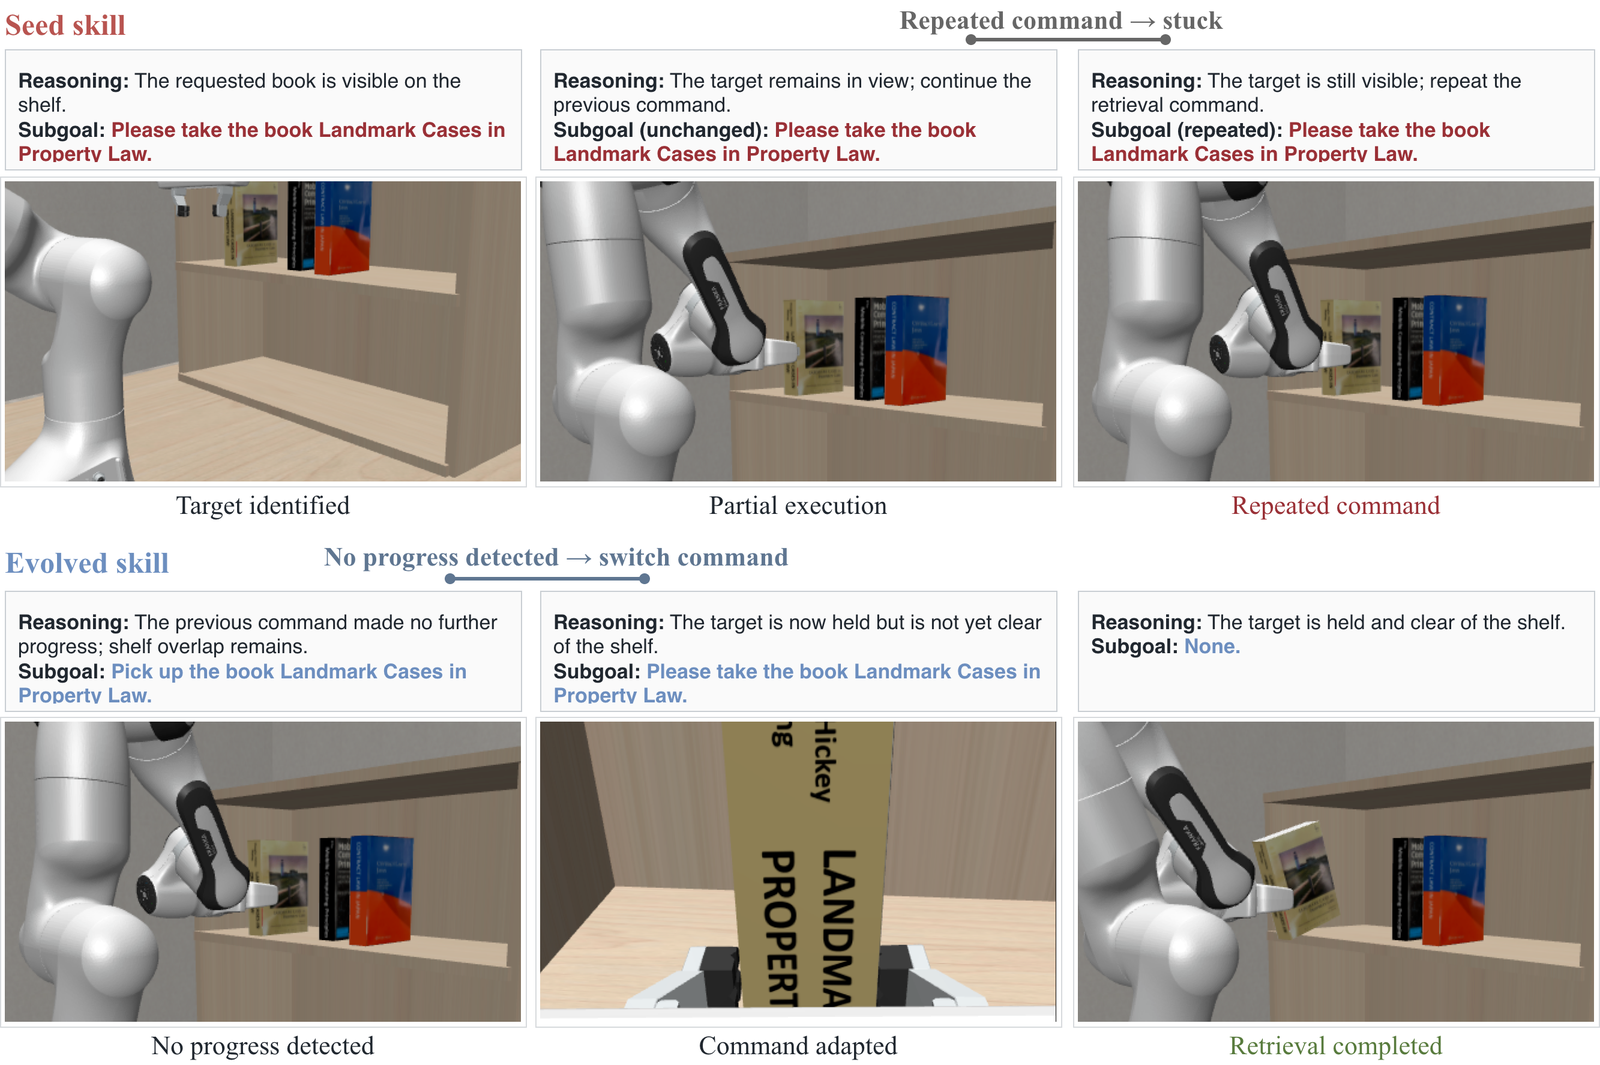
图 3 所示的 select_book/ep_024 任务直观展示了演化后的技能究竟改变了什么。初始的 Seed 技能只泛泛地要求智能体“观察环境并分解任务”,规划器不清楚底层 $\pi_0$ 执行器的控制偏好,在机械臂已经将目标书籍从书架中拉出一半时,由于视角内依然能看到书脊,规划器错误地将其判定为“抓取尚未发生”,从而连续三轮下发完全相同的拉取指令,导致机械臂在原地反复试探,最终触发 400 步超长耗时而失败。
而在经历环境回放诊断后,演化出的新技能增加了“执行器感知”与“进度增量确认”机制:明确要求规划器识别底层动作的物理反馈,严格区分选取(Selection)、检索(Retrieval)与放置(Placement)的语义边界,并强制在连续指令间进行环境变化校验。进化后的智能体在第一轮拉动完成后,立刻识别出书本位移已满足阶段目标,果断切换至下一阶段控制,干净利落地完成了长程操作。
复杂空间感知与镜面反射:脚手架代码的关键跃升
如果说 VLABench 凸显了文本技能演化对高层决策逻辑的梳理,那么在强调主动具身视觉感知的 ESI-Bench 上,上下文脚手架代码的演化则展现出了不可替代的作用。
ESI-Bench 要求智能体在三维模拟场景中主动移动机位、调整姿态,解决涉及物理结构、度量对比、空间关系以及镜面反射等极度依赖精确视角的长程推理问题。在这一基准的 231 个代表性测试子集上,仅演化技能使得微平均准确率从 Seed 的 32.5% 提高到 41.1%,而在此基础上加入脚手架演化后,微平均成绩进一步暴涨至 49.8%(宏平均 Macro 达到 42.9%)。作为对比,基准原论文中公开的被动单视角高算力模型 GPT-5 PS 宏平均成绩为 40.3%。一个冻结的开源 27B 参数模型,凭借自演化的外部程序资产,在具身感知指标上达到了极具竞争力的水平。
脚手架演化的惊人提升,高度集中在极其考验视觉证据留存的硬核类别上。其中,镜面反射(Specular Reflection)准确率直接从 20.0% 暴增到 60.0%,空间关系推理从 37.3% 提升至 54.9%,感知定位从 59.2% 攀升至 69.4%。
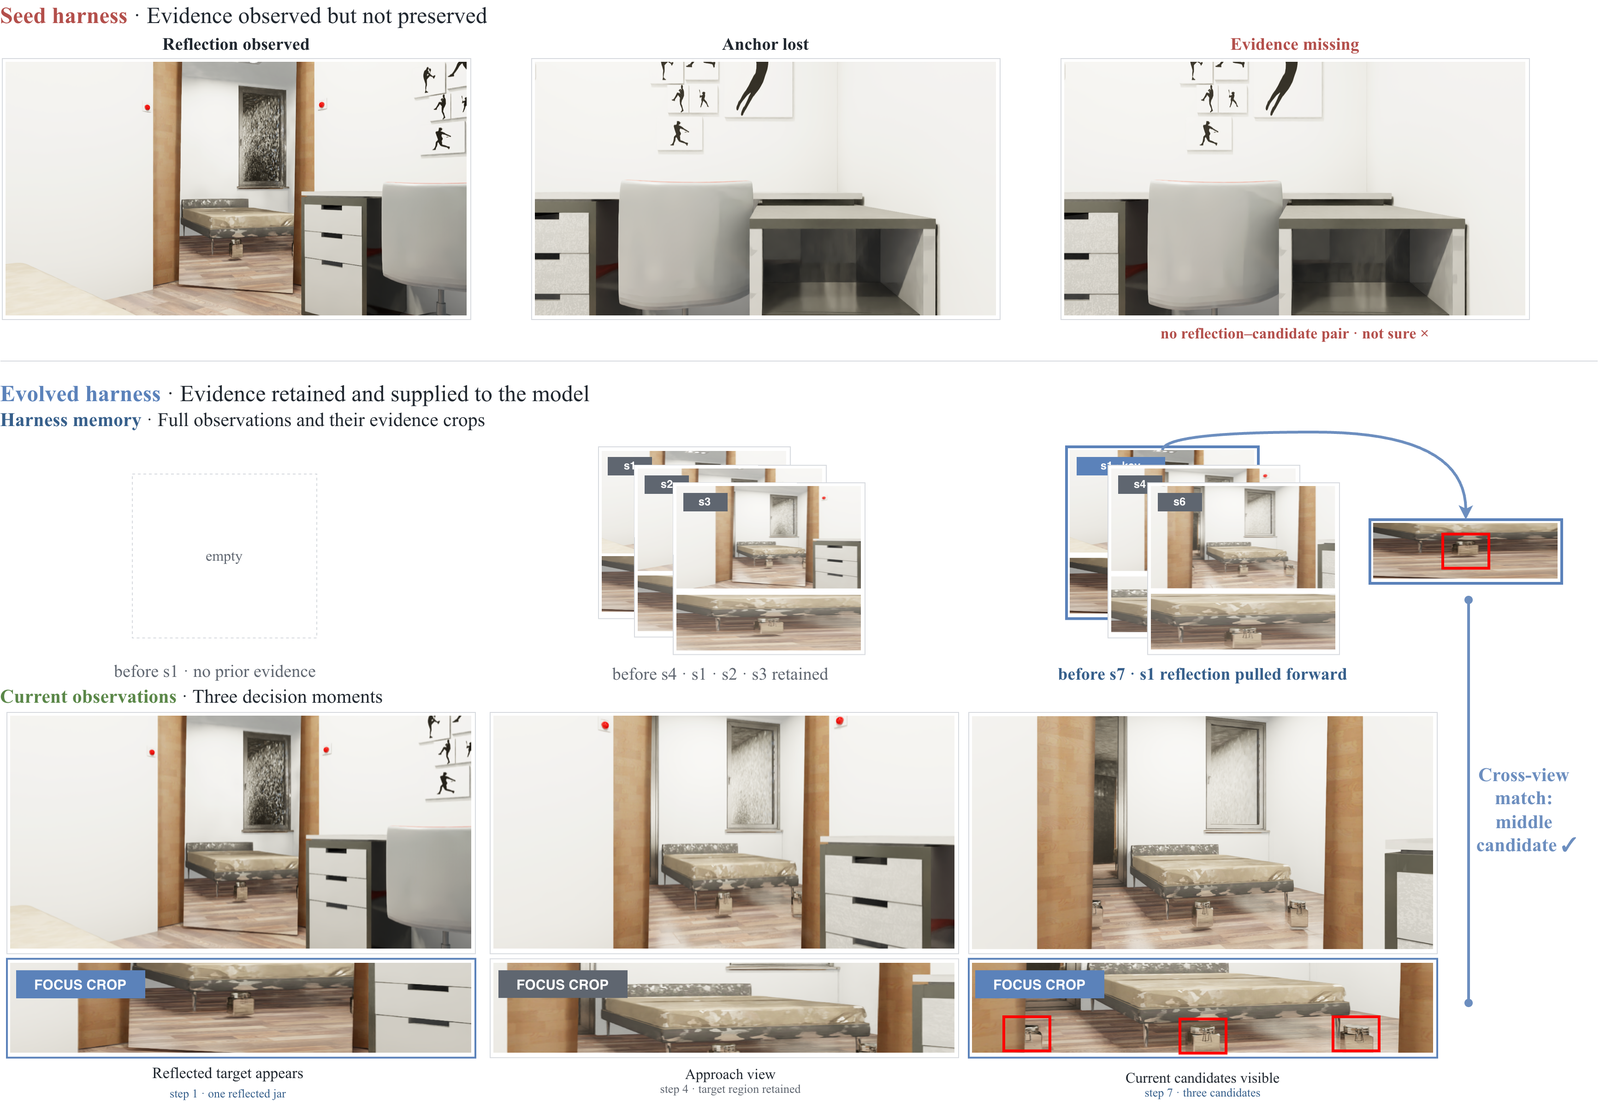
图 4 所展现的“镜面面条罐匹配”案例极其深刻地揭示了脚手架演化的必要性。任务要求智能体观察镜子中的面条罐倒影,在房间内的主动探索中找出对应的真实物体(左、中、右哪一个)。在未进化的脚手架代码中,系统使用极其简陋的固定滑动窗口机制,简单粗暴地将完整动作历史文本拼接在一起,却只机械保留最近的 5 帧 RGB 图像。
这种无视因果重要性的时间窗口机制在具身探索中是致命的:智能体在探索的第 1 步就看到了镜子里的目标镜像特征,但为了确认三维位置,智能体在场景中四处移动,到了第 7 步看到三只真实面条罐并列出现时,第 1 步包含决定性倒影证据的图像帧早已被滑出上下文窗口!失去视觉锚点的智能体在房间内原地打转,反复左转右转多达 27 次,耗尽 30 步步数预算后无奈输出“无法确认”。
而经过演化后的脚手架函数彻底重构了内部的视觉记忆管理逻辑。生成的 Python 代码引入了证据感知稀疏记忆(Evidence-aware Sparse Memory):
它根据图像帧之间的视觉多样性与信息量,自动筛选并持久固化最多 3 个关键帧;同时利用无参数图像处理算子(基于图像对比度、边缘密度和局部锐度),对视野中的候选目标自动执行确定性的局部高分辨率对齐切片(Focus Crops),并且显式压缩历史轨迹中的重复移动指令以避免上下文污染。
在更新后的代码过滤下,智能体在第 7 步依然可以同时看到第一步保存的镜面反射特写与当前的三个候选实物。通过清晰的高分辨率外观纹理对比,规划器仅消耗 6 次前进移动,就以 0.90 的高置信度给出了“中间那只”的正确判定。整个过程中没有任何外部传感器先验介入,全靠进化出的代码从普通 RGB 流中自主提炼结构化事实。
从死磕权重到资产进化:具身智能的新解法
演化模型外部的技能与代码脚手架,在计算能耗和落地工程上也体现出了非同寻常的经济性。
在 SHAPER 的测试流程中,所有演化开销均发生在线下且属于“一次性成本”。根据论文记录的 Token 消耗核算,VLABench 的演化过程折合调用 API 成本仅约 2.25 美元,ESI-Bench 约为 2.83 美元。经过少许回合搜索选出的最优技能 Prompt 与上下文构造 Python 函数,在部署阶段直接作为全局资产固化下来,执行推断时完全不再产生任何额外的束搜索或回滚开销。
这与测试期缩放方案形成了极其鲜明的对照:推理期采样搜索方法的计算成本会随着部署任务量呈线性剧烈膨胀,每次执行任务都要耗费大量采样 Token,且具身场景无法像写代码那样随意回滚物理世界;而 SHAPER 将算力投入在离线阶段演化出高泛化、高质量的轻量化系统配置,把推理时延和计算开销降到了最低。
从长远来看,SHAPER 为具身智能体的迭代范式提供了一个全新的视角。以往学界习惯于将模型的参数权重视为智能演进的唯一载体,每一次环境迁移都伴随着收集数据、配置损失函数、启动集群重新微调的繁重流程。然而,真实机器人系统是由视觉模型、逻辑规划器、电机执行器、接口协议和上下文流深度咬合的工程实体。
将可复用的程序性操作知识抽离为“技能提示词”,将复杂的时空感知数据流约束为“脚手架过滤代码”,并利用基座大模型强大的自省能力对其进行自动化迭代演变,证明了系统级外部资产的自演化同样能够产生不输甚至超越微调的泛化威力。当具身模型逐渐庞大到无法轻易重训时,这种轻量级、模块化、可解释且成本微薄的进化策略,或许正是让机器人走向真实复杂物理世界的关键助力。