Code-with-Image:代码即推理,多模态准确率从30%升至67%
Self-Evolving Code-with-Image Reasoning
多模态大模型在处理视觉任务时,正越来越频繁地调用外部工具。裁剪、放大、调亮或旋转等操作,构成了如今主流的“像人一样看图”(Thinking-with-Images)范式。但学术界和工业界逐渐察觉到一个难以逾越的瓶颈:工具本质上只是在为语言模型暴露更多的感知线索,真正的推理依然停留在语言层面;如果某个问题原本就无法通过“肉眼扫视”来得出答案,无论模型怎么缩放图片,最终的推理链条依然会断裂。
ArXiv URL:https://arxiv.org/abs/2608.11292v1
现实中存在大量需要跨越像素进行多步数学和算法运算的视觉问题。面对图像取证、微小仿射变换对齐、通道重混或是周期性位移,模型常常能用自然语言准确报出算法名称,却依然给出错误的数值。原因在于,语言思维链可以描述算法,却无法执行算法。
由诺基亚、香港理工大学以及佐治亚大学联合提出的 Code-with-Image 框架,彻底推翻了以往“工具提供视觉碎片、语言产出最终答案”的协作逻辑。研究团队给大模型配置了一个纯粹的 Python 解释器,没有任何预设的高层视觉 API:图像直接以底层数据形式进入沙箱,推理过程被完整具象为模型编写并执行的多步视觉算法,程序的运行输出直接作为最终答案。配合一套无需更新权重、基于执行反馈的技能自演化循环(Self-Reflection over Executable Reasoning),大模型在全新的程序原生基准 CwI-Bench 上实现了跨越式提升:即便是代表前沿水平的 GPT-5.6-luna,在纯语言思维链下准确率不足 30%,接入裸解释器后升至 43.0%,而在通过自我可执行反思进化出技能库后,准确率飙升至 66.6%;开源的 27B 模型也走出了从 9% 到 33% 再到 56% 的强劲跃升。
从感知增强到算法执行:视觉推理的范式位移
当前多模态智能体的主流路线可以概括为对视觉感知的修补。当遇到目标过小的问题时,智能体裁剪放大;遇到光照不佳时,调整亮度和对比度;遇到知识盲区时,调用网页搜索。这一范式的核心假设是:环境返回更清晰的视觉特征,模型再用自然语言接管后续的推导。然而,近期多项审计研究揭示了一个尴尬的事实:在这类评测基准上,智能体利用工具解决的问题中,有 93% 到 96% 本就可以不借助工具直接回答,工具调用仅仅带来了 2% 到 5% 的边际增益。
之所以存在这层天花板,是因为许多精确的视觉问题在本质上不是感知受阻,而是计算缺位。以图像伪造检测为例:一张照片是否经过拼接?两张曝光是否发生过融合?色彩通道是否经历了矩阵置换?拼接区域在亚像素级别偏移了多少个像素?这类问题的答案完全由底层像素矩阵决定,但人类或模型盯住屏幕看多久都无法看出来。它需要的是对整幅图像执行一连串阵列运算,每一步的中间产物都是多维张量或频谱数据,无法被压缩进自然语言的上下文中。
语言思维链擅长搬运词汇,但这类任务需要搬运和变换数据。现有的工具箱根本无法预置应对所有未知任务的固定算子,唯一的解法是让模型自己编写算法。
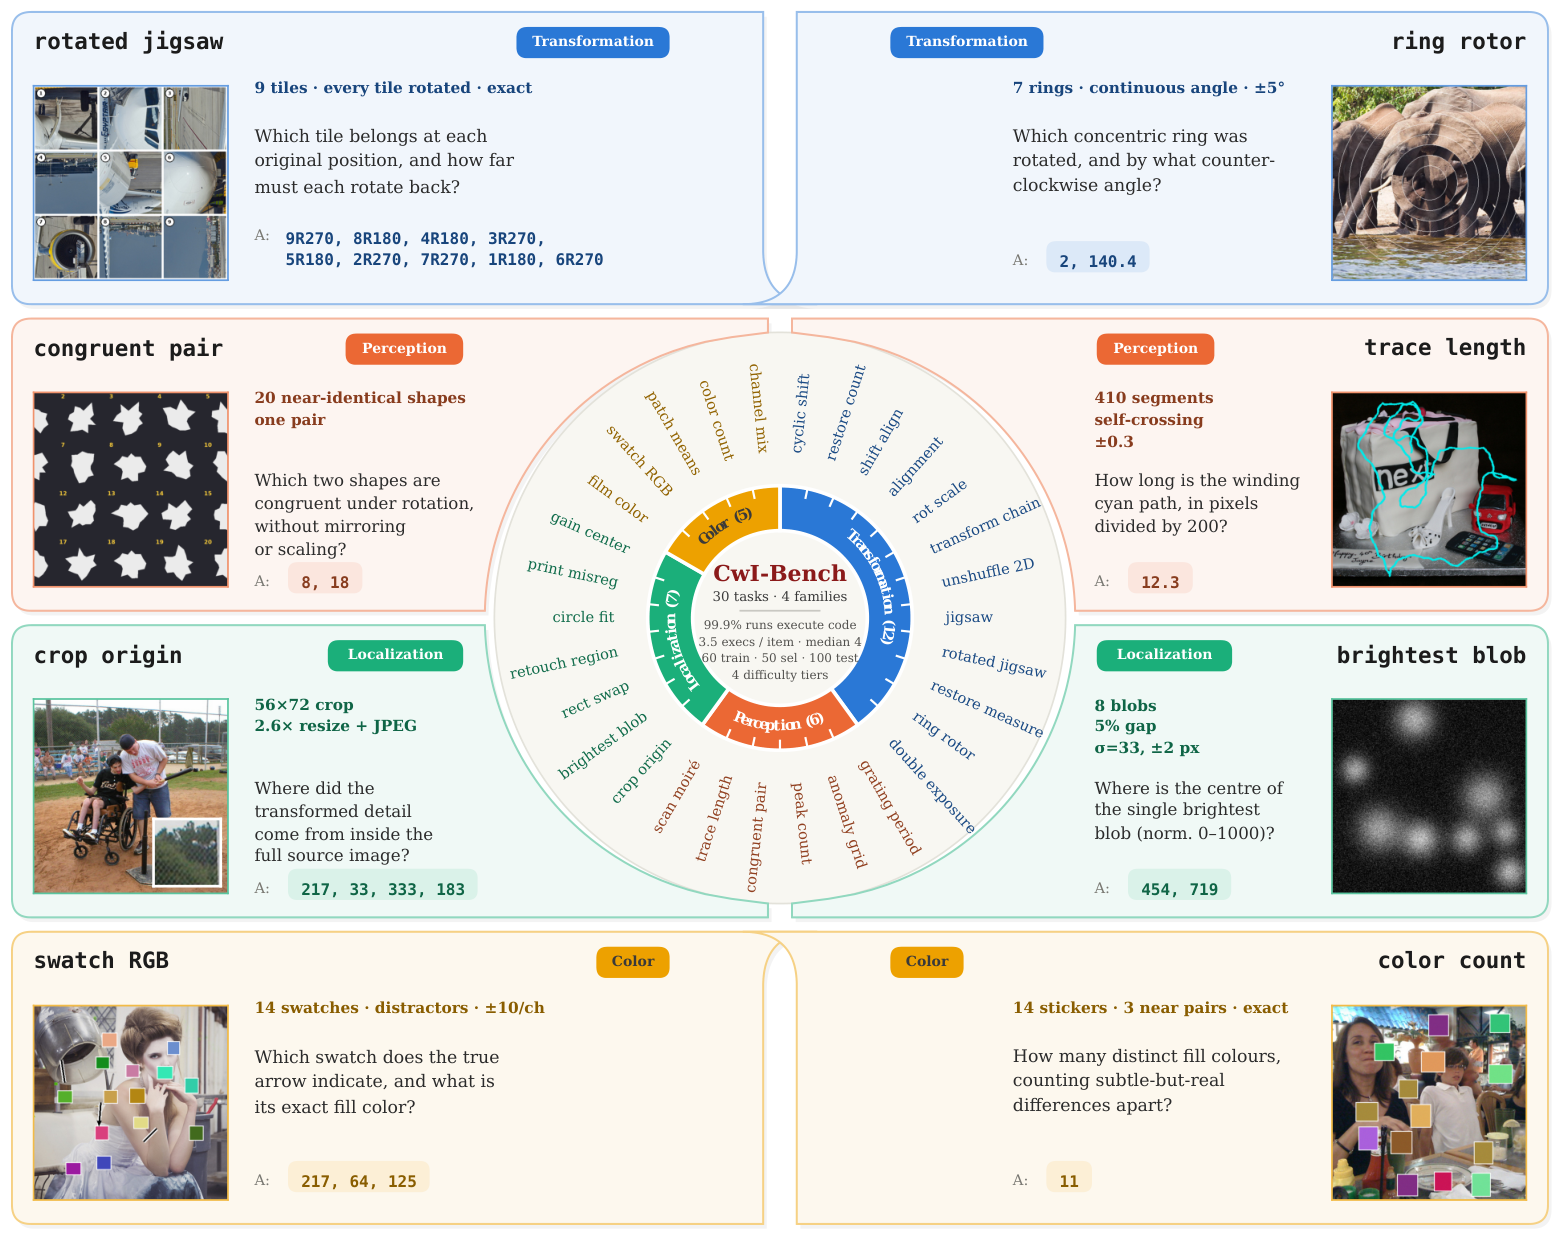
为了明确界定这种“无法依靠肉眼观察、只能依赖程序执行”的任务空间,研究团队构建了 CwI-Bench。该基准包含 30 个任务簇,涵盖图像位移、通道排列、精细定位、色彩混合和信号度量等领域。与依赖人工标注的传统多模态评测不同,CwI-Bench 的每个样本都基于目标数值通过程序逆向合成,天然具备无噪声的严格真值,并且能够无上限生成。最关键的是,在评测精度要求下,没有任何一道题可以通过人眼直接判断。实验表明,即便是开启思考模式的顶级商业模型,仅靠语言也难以突破 30% 的准确率,因为模型缺少的是执行像素级计算的基础媒介。
在 Code-with-Image 范式下,环境不提供现成的 OpenCV 复合流水线,仅提供通用的 Python 代码执行环境。语言模型的职责从“在头脑中推理”转变为“将推理逻辑编码为程序”,解释器在多轮交互中保存持久状态,而最后一次运行的控制台输出直接被采纳为最终结果。
为什么光给代码解释器还不够?
当计算媒介的问题解决后,瓶颈迅速转移:从“模型无法执行算法”变成了“模型不知道该写什么算法”。
多模态模型虽然具备编写 Python 代码的基础能力,但在面对陌生的像素计算问题时,往往会遭遇隐蔽的实现陷阱。无符号整型的溢出回绕、图像接缝处的离散索引偏差、微小旋转中的插值失真,都会导致代码能够正常跑通,却输出一个差之毫厘的错误数值。因为没有抛出 Python 语法报错或运行时异常,模型在纯文字上下文中往往完全意识不到计算已经偏离正轨。
常规的语言反思(Language-based Reflection)在此时完全失效。若只让大语言模型重读先前的提示词和错误输出文本,模型往往只能空泛地变换措辞,甚至把原本正确的算法换成完全错误的逻辑。如果代码承载了推理本身,那么排查推理故障的唯一途径,就是去排查和调试代码。
作者为此设计了一套无需微调模型权重、完全由执行信号驱动的自反思演化循环(Self-Reflection over Executable Reasoning)。这套系统通过将大模型的试错结果沉淀为纯文本的技能库(Skill Library),让固定的基座模型学会在特定任务簇上写出稳健的代码。
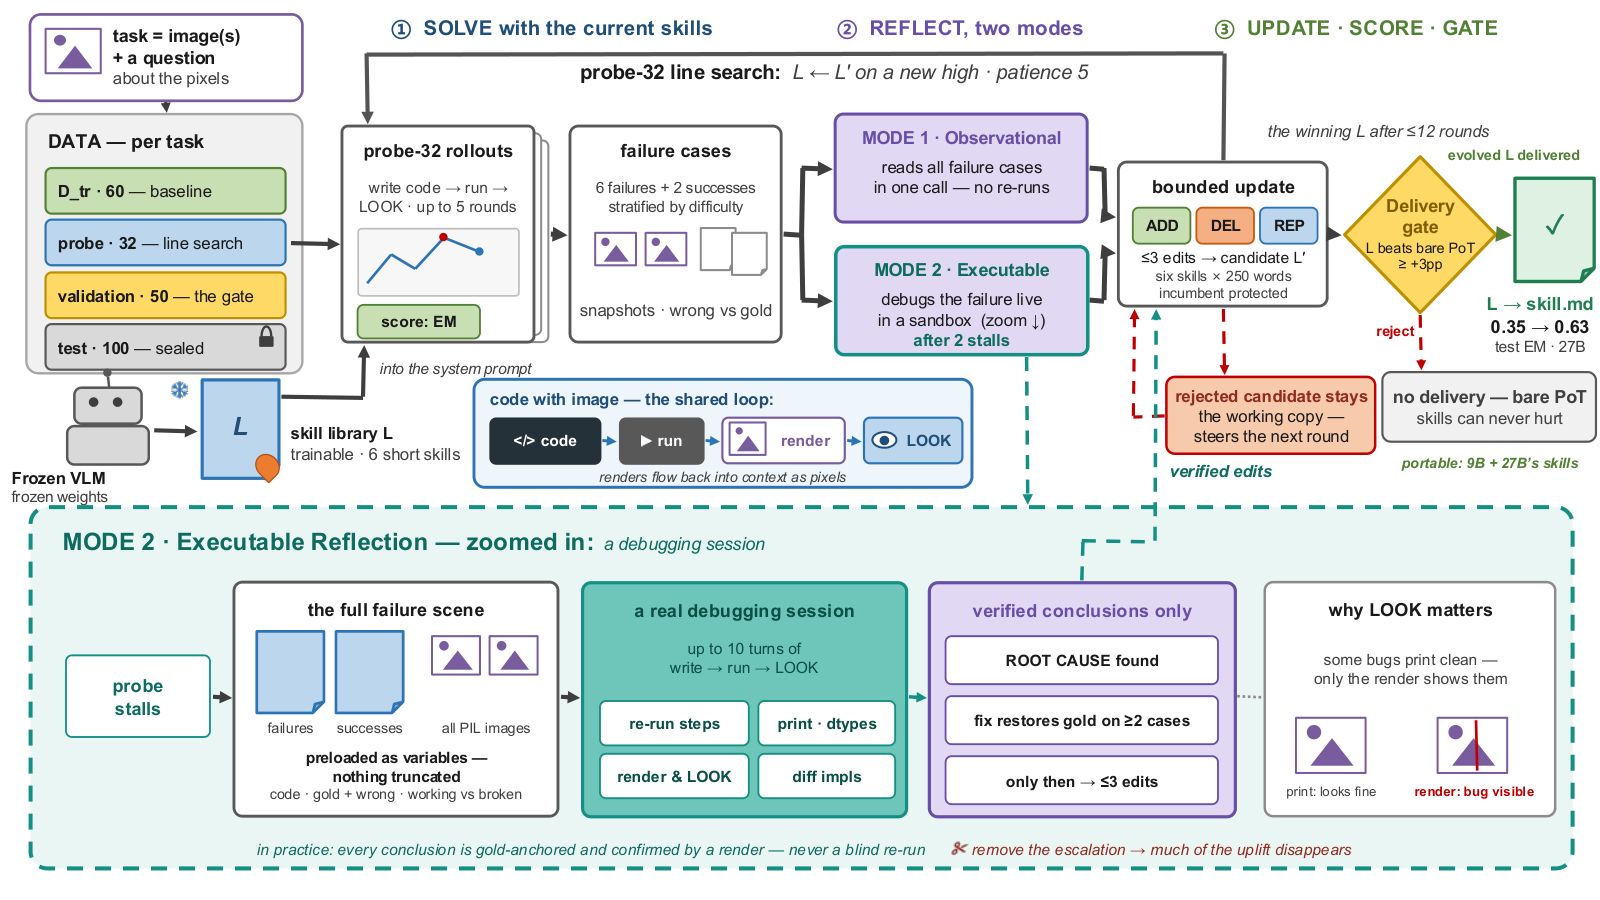
整个演化流程在逻辑上划分为两个层次分明的反思模式,兼顾了搜索成本与诊断深度:
-
观察性反思(Observational Reflection):在初期阶段,反思模块以只读方式审阅失败样本的执行轨迹,包括提示词、模型写的代码、控制台输出以及渲染出的中间图像。如果问题出在宏观策略层面(例如没有加入结果合理性校验分支,或是遗漏了数据归一化),纯文本层面的审阅足以指导模型对技能库发起局部修改。
-
可执行反思(Executable Reflection):当纯文本阅读带来的性能提升陷入停滞时,系统自动切换为深度诊断模式。失败案例的原始图像、错误代码以及对应的真实标签会被重新加载到一个调试沙箱中。模型被赋予连续多次交互的权限,它像人类程序员调试 Bug 一样,主动编写探测脚本:重新运行有疑点的代码段、打印中间数组的形状与数值范围、将中间生成的特征图渲染出来重新观察,并在已知真实答案的样本上逐行验证修复代码。只有在多个独立失败案例上均被验证有效的经验,才会被格式化为技能条目,并入候选技能库中。
这套反思机制实质上构成了一种离散文本空间下的零阶优化(Zeroth-Order Optimization)。在这个过程中,技能库的更新完全由外部验证集的准确率作为反馈信号。为了防止技能在探索过程中发生过拟合或退化,系统引入了严格的交付门禁(Delivery Gate):候选技能库必须在独立的验证集上超过裸代码求解器一定的阈值($\gamma = 3\%$),才会被正式交付;若未达标,系统将直接回退,在推理阶段继续使用裸解释器运行。
准确率阶梯跃升:从开源小模型到闭源旗舰
CwI-Bench 针对 30 个任务簇设立了严格隔离的训练集、验证集和测试集,且底层源图片杜绝了跨集合重叠。实验横向对比了无工具思维链(分为常规指令与开启原生思考模式)、主流工具调用代理(如 DeepEyes 等原生协议)、裸 Code-with-Image 以及融入自演化技能后的 Code-with-Image。
数据展现了极为清晰的阶梯式分化:
在无工具介入的纯文本推理模式下,即便是开源领域的优秀模型 Qwen3.5-27B,准确率也仅在 8.6% 左右徘徊,即使开启思考模式也难有本质改观;GPT-5.6-luna 在无工具思考模式下,也无法突破 30% 的准确率天花板。这直接佐证了前文的核心论点:当问题依赖像素数组的多步计算时,模型在参数空间内的自回归解码无法模拟高精度的数值运算。
一旦赋予模型基础的 Python 解释器,使其迈入裸 Code-with-Image 范式,所有模型的解题能力立刻展现出跨越式增长。Qwen3.5-27B 的测试准确率从 8.6% 跃升至 32.6%,GPT-5.6-luna 则从 12.9% 直接拉升至 43.0%。统计显示,在 27B 模型的测试轨迹中,有 99.9% 的题目自主触发了代码运行,平均每个测试样本调用代码执行 3.5 次。这表明代码并不是装饰性的辅助工具,而是成为了承载推理全过程的核心支柱。
更为剧烈的性能跃升发生在融入自反思演化技能之后。在无需微调任何模型参数的前提下,仅仅依靠模型在训练样本上自我调试沉淀出的纯文本技能提示词,Qwen3.5-27B 的整体准确率从 32.6% 暴增至 55.9%;GPT-5.6-luna 则从 43.0% 进一步攀升到 66.6%。在某些依赖精细数学变换的确定性任务上(例如图像循环位移计算),27B 模型的准确率甚至从最初的个位数飙升至 100%;图像对齐任务的准确率也达到了 97%。在这些任务中,那些最终胜出的关键算法技能,无一例外均是在可执行反思模式下被调试出来的。
值得注意的是,配备了自演化技能的 27B 开源模型,其 55.9% 的准确率不仅彻底甩开了未演化的裸 GPT-5.6-luna(43.0%),甚至开始逼近后者自演化后的水准。这表明,媒介与高质量的程序级策略引导,在很大程度上能够弥补模型绝对参数规模上的劣势。
技能的可迁移性:跨尺度与跨模型家族的复用
既然自反思沉淀下来的是通用的算法思路、数值校验边界以及特定数据格式的处理约定,那么这些技能条目便天然具备了平台无关性。作者团队进一步验证了这些自演化技能在不同模型尺寸、甚至不同架构家族之间的迁移能力。
实验结果揭示了两个极具实践价值的现象:
第一是小模型可以无缝继承大模型的调试成果。将 Qwen3.5-27B 演化出的技能库直接注入给仅有 9B 参数的 Qwen3.5-9B,后者的综合准确率直接从裸机状态下的 11.1% 飞跃至 34.5%。这一成绩不仅大幅超越了 9B 模型自行通过反思演化出的技能水平(30.6%),甚至直接超过了未配置技能库的 27B 裸机性能(32.6%)。在算法密集度最高的变换类任务(Transformation)上,借用大模型技能的小模型取得了 38.4% 的准确率,而其自演化仅能达到 30.1%。小模型本身不具备强大的自我调试和长程诊断能力,但只要拿到经过大模型在沙箱中千锤百炼出的代码方案与避坑准则,它同样能够准确执行并解决问题。
第二是技能具备跨家族的通用性。研究人员将 27B 模型在 Qwen 体系下演化出的技能库,直接灌入采用原生工具调用格式的 gemma-4-26B-A4B 中。结果显示,gemma 的基准表现从 27.7% 直线上升至 45.0%,与 gemma 自身花费高昂算力演化出的技能上限(46.5%)仅相差 1.5 个百分点,且在部分任务家族上展现出更高的泛化性。这充分证明,可执行反思所萃取出的经验,触碰的是多模态视觉问题本身的算法结构与数值规律,而非针对特定大模型 Token 分布的提示词“玄学”。
不过,研究也观察到了一个有趣的现象:由最前沿模型 GPT-5.6-luna 演化出的技能,向下迁移给小模型时的增益幅度,反而不如 27B 模型演化的技能显著。例如,luna 沉淀的技能给到 9B 模型仅提至 17.9%,给到 27B 仅提至 40.3%。作者分析,这背后存在一种隐性的“代码风格共适应”机制:旗舰商业模型在可执行调试中偏好撰写复杂度极高、高度抽象或运用高级库特性的代码,这些代码对代码生成能力稍弱的受体模型构成了沉重的执行负担;相比之下,中等开源模型在自身能力约束下摸索出的调试方案往往更为质朴、易读且模块化,反而更利于在开源生态间扩散。
走向程序原生的多模态智能体
Code-with-Image 的探索给多模态大模型的发展带来了深刻的思维转换。长期以来,我们习惯于让模型扮演一个“坐在监控屏幕前的人”,通过不断索要局部放大图,再用自然语言组织逻辑得出结论。但在很多视觉领域——诸如显微分析、卫星测绘、工业瑕疵定位以及数字取证——人类专家解决问题的方式从来不是靠肉眼盯视,而是使用代码来构建精确的像素处理流水线。
这项工作证明,当我们将视觉数据还原为纯粹的矩阵,将推理的载体从易受幻觉影响的自然语言 Token 彻底让渡给严格受解释器制约的 Python 程序时,多模态推理的上限被实质性地拓宽了。更重要的是,它向社区展示了一种全新的无需更新模型权重的自我进化路线:模型不仅可以在沙箱中试错,还能像资深工程师一样,利用断点打印、数据可视化以及对照实验,把偶然修好的 Bug 提炼成确定性的方法论,并将其固化为永久复用的工程资产。当写代码成为推理的核心手段,调试代码便成为了调试智能本身。