上下文越长越好?JHU提出信息丰裕悖论:长窗口训练正在削弱大模型参数记忆
Information Abundance Paradox: Long-Context Training Undermines Parametric Knowledge
在过去两年的大语言模型研发竞赛中,“支持更长上下文”几乎被当作理所当然的技术演进方向。从最初的几千 Token 到数十万甚至数百万 Token,工业界普遍遵循着一个朴素的假设:训练时喂给模型的上下文越长、包含的信息越丰富,模型就能接触到更多长程依赖与复杂事实,从而整体变得更强大。然而,许多团队在实际评测时频频遇到难以解释的异象:同一个基座模型,经过长上下文扩展训练后,在长文本检索任务上的跑分上去了,但在传统的闭卷问答、常识推理或基础语言建模等常规基准上,表现反而明显落后于短窗口版本。
ArXiv URL:https://arxiv.org/abs/2608.12218v2
针对这一行业谜题,来自约翰斯·霍普金斯大学(Johns Hopkins University)的研究团队发表了一篇具有颠覆性质的论文,提出了“信息丰裕悖论”(Information Abundance Paradox)。研究表明,训练期间提供过于充沛且高相关的上下文,并不会让模型无休止地变强;相反,这会诱使模型改变底层的学习模式,系统性地放弃将知识编码进自身权重,转而高度依赖输入中的外力线索。作者将这种病态的依赖行为命名为“上下文成瘾”(Context Addiction):一旦脱离了上下文或者遭遇误导信息,模型的内在能力就会发生剧烈倒退。这一结论从优化机制层面揭示了当前大模型长文本缩放的潜在天花板,对预训练语料设计、指令微调乃至 RAG 系统架构提出了严肃的重新审视。
动机与反常现象:长上下文变体为何反而更弱?
在工业界公开的模型家族中,微软的 Phi-3 与 Allen AI 的 OLMo 3 表现出了一个长期被忽视但普遍存在的反常现象。Phi-3 的 128K 长上下文变体在常规的零样本和少样本基准测试中,成绩显著低于 4K 窗口的原生版本;同样,OLMo 3 的 65K 变体也落后于 8K 版本。在过去,很多工程师倾向于将此类性能衰减归咎为工程细节问题,比如长文本预训练数据的稀缺、位置编码(如 RoPE)的插值失真,或者是合成数据的质量不高。
但这种数据质量论无法完全自圆其说。因为在实际训练中,这些长文本版本往往额外消耗了海量优质长文本数据与更庞大的训练步数,在数据质量未见劣化的前提下,模型能力却发生了全面缩水。
为了解释这一现象,论文从信息压缩与预测机制的底层切入,将大模型的学习抽象为两种本质不同的路径:参数内化(Parametric Internalization)与上下文整合(Contextualization)。所谓参数内化,是指模型在预测下一个 Token 时,将世界规律和事实知识紧密压缩进前馈神经网络(FFN)等参数结构中,哪怕提示词空空如也,模型也能仅凭自身记忆回答问题;而上下文整合则是指模型利用注意力机制(Attention),从输入序列的前文抓取相关证据来完成预测。
信息丰裕悖论的核心假设就在于此:模型在训练过程中遵循最小努力原则。当训练上下文窗口拉长、且上下文中包含了大量与目标预测高度相关的线索时,通过注意力机制直接“抄答案”,其优化难度远低于在权重深处建立抽象的参数表征。长期以往,充沛的上下文信息剥夺了模型内化知识的动力,直接侵蚀了模型的参数记忆能力。
预训练与微调实验:倒 U 型曲线与脆弱的鲁棒性
研究人员首先在最基础的因果语言模型预训练阶段验证该假说。为了彻底排除“长文本由于拼接杂乱而破坏语义连贯”的干扰,作者从 Project Gutenberg 中严格筛选出单篇长度超过 65536 Token 的长篇书籍,构建了 10B Token 的训练集。实验横跨 20M、55M、259M 和 750M 四种参数量级,所有模型均基于标准 Llama-2 架构与 RoPE 编码,并严格固定全局 Token 预算(约 105 万 Token/批次,9537 个更新步数)。研究人员将训练窗口大小 $W$ 严格设置为 512 到 32768 之间的 7 个梯次进行对照,以实现完全匹配 Token 预算和更新步数的严格因果分析。
下游评测涵盖了语言建模基准(如 LAMBADA、WikiSPAN、PTB)、通用语言理解(SuperGLUE)以及测试纯闭卷参数记忆的单选题基准(如 ARC、CommonsenseQA、PIQA)。测试完全在零样本条件下进行,不向模型提供除问题本身之外的额外上下文。
实验结果呈现出了极其显著的“倒 U 型曲线”。随着预训练上下文窗口 $W$ 的扩大,模型各项指标先升后降:在 SuperGLUE 和多项单选问答中,性能在 $W=2048$ 附近便达到巅峰,随后开始不可逆地全面滑坡;在纯语言建模任务上,拐点稍后延至 $W=8192$,此后困惑度再度恶化。这一拐点在所有 4 种参数规模下均稳定复现,证明更大容量的底座并不能抵消超长训练窗口对闭卷能力的侵蚀。
随后,团队在监督微调(SFT)阶段开展了第二组实验,直接控制上下文的信息相关性。他们基于 Qwen3(涵盖 0.6B 到 14B 参数)并在 MMLU-Pro 的四个专业领域(医学、经济学、法律、心理学)进行微调。在固定 8 篇参考文档的总长度下,系统调整其中与题目真正相关的文档数 $k$($k=0, 4, 8$)。评测时,分别在有参考文档(Supporting)、无文档(No Context)以及故意掉包的冲突文档(Conflicting)三种场景下考察模型。
结果直观地展示了“上下文成瘾”的形成过程:在训练期喂入相关文档最多的模型($k=8$),在测试期同样提供支持文档时跑分最高;但一旦在测试期撤掉文档、要求它只靠内化知识答题时,它的表现远不如那些在训练期只看了无关背景甚至没看文档的模型。更危险的是,当测试期混入具有对抗性的虚假文档时,$k=8$ 的模型表现断崖式下跌,几乎毫无抵抗力地被错误上下文带偏。
理论诠释:上下文降低了优化的复杂度门槛
为什么优化算法总会偏向于依赖上下文,而非将知识刻进参数?论文在第四部分通过信息论方法给出了数学解释,建立了参数信息边界(Parametric Information Frontier)的单调性定理。
定义 $\mathcal{I}_k(\rho)$ 为模型在上下文长度为 $k$ 且泛化风险不超过阈值 $\rho$ 时,模型权重 $W$ 必须存储的关于任务的目标信息量的下界 $\inf I(W; \tau)$。论文在投影可测假设下证明了:若短上下文窗口是长上下文序列的对齐子集,则对于任意固定的风险容忍度 $\rho$,当窗口大小从 $k$ 增大到 $m$($k < m$)时,必定有:
\[\mathcal{I}_m(\rho) \leq \mathcal{I}_k(\rho)\]该定理表明,随着训练上下文的扩大,模型要达成相同的预测损失,其权重内部需要储存的知识量下界是单调递减的。上下文充当了预测特征的外部代偿通道,挤出了原本属于模型权重的记忆空间。
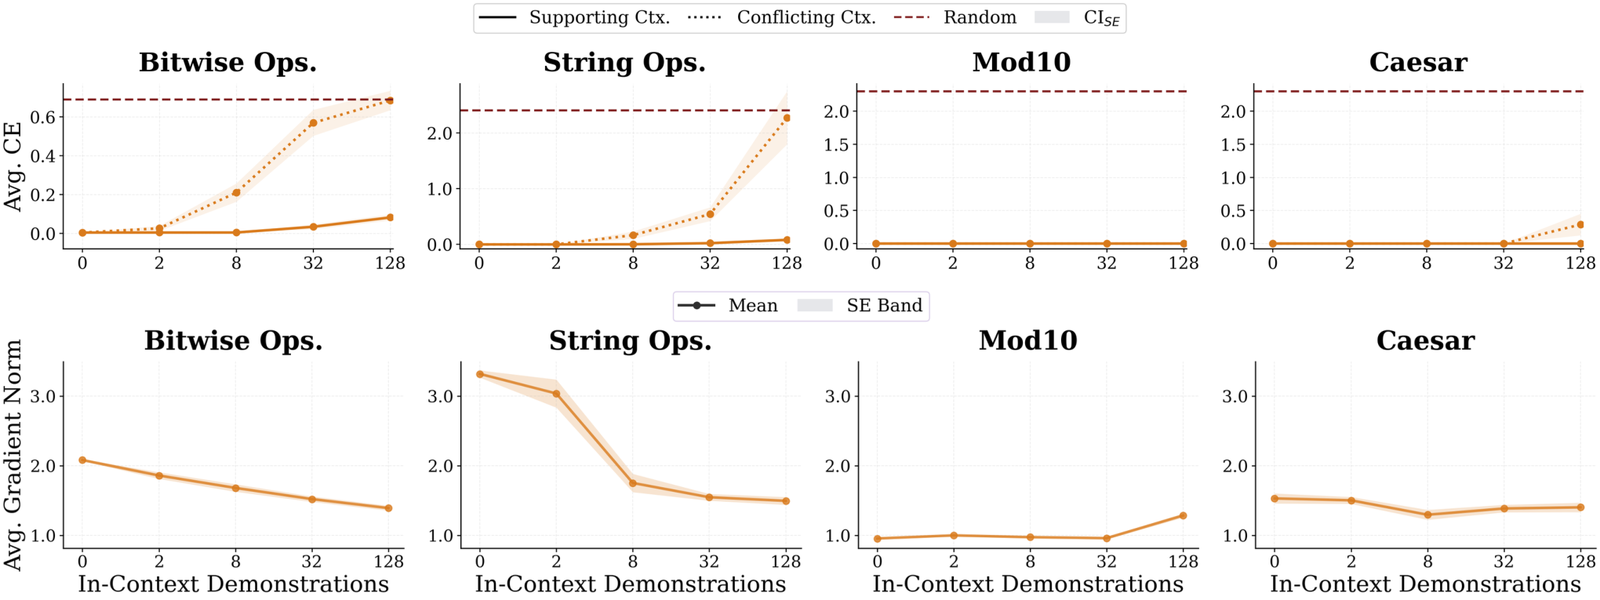
为了在纯粹的环境下验证这一假说,作者设计了包含按位取反(Bitwise Negation)、字符串操作、模十算术以及凯撒密码四种合成预训练任务。在模型规模达到 7.5M 的实验中,通过改变训练序列中 In-Context Demonstrations 的数量,同时监控模型在正确示例(Supporting)与假规则示例(Conflicting)之间的决策差距。
从上方对比图表中可以清楚地看到:在那些最终表现出严重上下文成瘾的任务中(表现为 Supporting 与 Conflicting 之间的准确率差异急剧拉大),平均训练梯度范数(梯度模长)伴随上下文数量的增加呈现出单调断崖式下跌。在深度学习的经验动力学中,梯度范数的快速走低往往是模型找到了更平坦、更易优化的低复杂度解的直观标志。实验有力地证实:利用上下文中的现成线索,在损失曲面上是一条阻力极小的捷径,优化器会不由自主地沿着这条路径滑落,从而放弃将规则参数化。
机制透视:梯度压力从 FFN 向注意力模块转移
从神经网络架构的物理分工来看,Transformer 的前馈网络(FFN)与自注意力层(Self-Attention, SA)扮演着截然不同的角色。前人研究普遍表明,多层感知机式的 FFN 层更偏向于作为键值存储器,储存世界知识与通用事实表征;而注意力模块则负责从上下文的不同 Token 位置中寻址并路由信息。
研究人员跟踪了训练全流程中,FFN 层梯度范数与注意力模块梯度范数的相对比例(FFN-to-SA Gradient Ratio)。结果发现,无论在预训练还是在微调阶段,只要增大上下文长度或提升上下文信息量,梯度压力就会发生全局性的空间转移:注意力模块获得的更新权重显著增加,而 FFN 层所承受的梯度更新压力大幅衰减。这意味着反向传播的动力学正在被“注意力寻址”主导,负责参数记忆的 FFN 没有得到充分的梯度训练。
为了证明这一机制与模型行为之间的因果联系,研究人员设计了“模块限制微调”(Module-Restricted Fine-Tuning)消融实验:在提供丰富上下文的 SFT 训练中,人为冻结一部分结构,分别强制模型仅更新 FFN 或仅更新注意力模块。
因果干预的结果极具说服力。被强制只更新 FFN 的模型,在无上下文的零样本评测中保持了坚挺的准确率,并且在面对充满误导性的冲突文档时展现出了极强的抗干扰韧性;与之相反,那些只更新注意力模块的模型,完全沦为了上下文的提线木偶——在有强提示时得分虽高,但面对冲突上下文时一触即溃。这证明 FFN 承担了知识内化的基本盘,而过度的上下文训练正是在物理上剥夺了 FFN 接收梯度的机会。
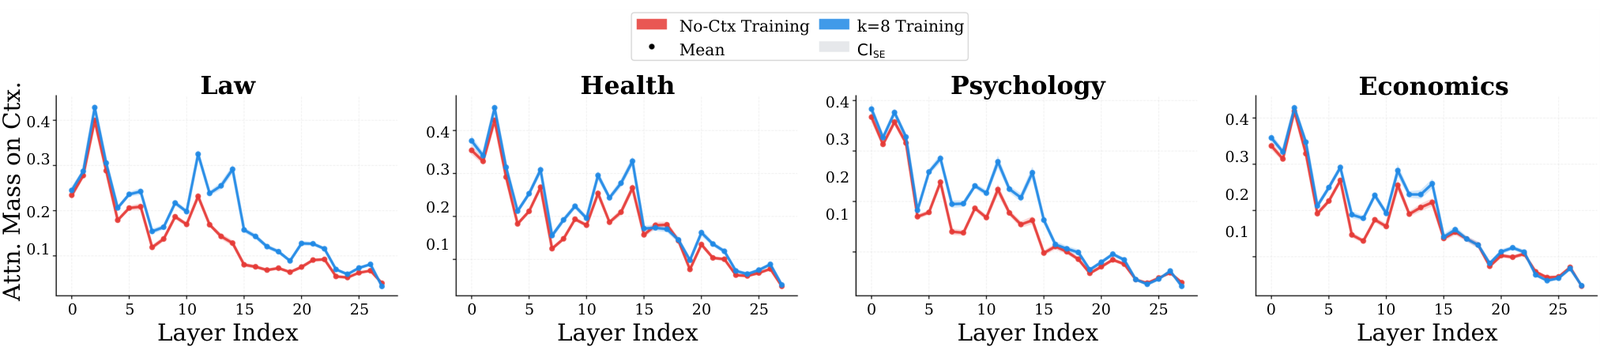
这种训练期梯度的倾斜,进一步投射到了推理期的注意力模式上。研究人员追踪了模型生成答案时,各层注意力头分配在输入参考文档(Context Tokens)上的注意力权重总和(Attention Mass)。
从上方图表展现的注意力热度可以看出,经过高度相关上下文微调的模型($k=8$),在 Transformer 的中间深层网络中表现出了极高的上下文敏感度。在特定的中间层中,某些专职检索和跨序列搬运信息的注意力头,其分配给上下文背景文档的注意力质量甚至接近 1.0 的理论上限;而无上下文微调的模型则始终保持分散、均衡的注意力分布。深层注意力完全被上下文牢牢俘获,从计算图的角度实锤了“上下文成瘾”的物理形成。
行业启示:无限制延长上下文并不是免费的午餐
长久以来,大模型领域的缩放定律(Scaling Laws)主要关注算力、数据量与参数规模三个主轴。在长文本技术爆发后,学术界与产业界产生了一种技术惯性,误以为“上下文长度”也可以作为第四条无损扩展的轴线:只要硬件显存撑得住、长文本数据足够多,训练窗口就应该无限扩大。
约翰斯·霍普金斯大学的这项工作用完备的实证与理论体系打破了这一幻觉。它明确指出了长上下文训练伴随的隐性代偿成本:模型从输入中获取信息的能力增强了,但独立思考与参数内化的能力被实质性削弱了。
这一发现对未来大模型的技术路线规划具有多维度的启发意义:
其一,在基座预训练的语料编排上,不能盲目采用极端长度的连续文本。如果预训练阶段为了迎合长窗口,将全局序列无差别拉长至数万甚至数十万 Token,可能会严重牺牲基础模型的逻辑常识与独立闭卷能力。更合理的方案可能是分阶段退火,或者对短文档、中长文本进行特定的受控混合,寻找各能力维度的帕累托最优窗口。
其二,在后训练(Post-Training)与 RAG 系统的设计上,需要重新审视微调数据的构建策略。如果微调阶段过度向模型灌输“只要有问题,答案一定在上文段落中”的高相关样例,模型就会退化为一个纯粹的检索搬运器,极易受到检索错误或者提示注入(Prompt Injection)的攻击。为了维持模型的判别力与内在鲁棒性,在构造 SFT 样本时,必须主动混入缺失上下文、含有无关噪音甚至存在冲突文档的反例,强制模型依赖 FFN 内化知识进行交叉核验。
长上下文让模型拥有了更宽广的视野,但若缺乏对优化机制的敬畏,充沛的信息反而会成为吞噬模型深层智能的温柔陷阱。探索如何在扩展信息视野的同时,守住参数知识的底线,将是下一代长序列基座架构必须攻克的核心命题。