Janus:算法与评估器协同演化,少用59.1%昂贵评测突破科学发现
Janus: An Algorithm-Evaluator Co-Evolution Framework for LLM-Driven Discovery under Expensive Evaluation Budgets
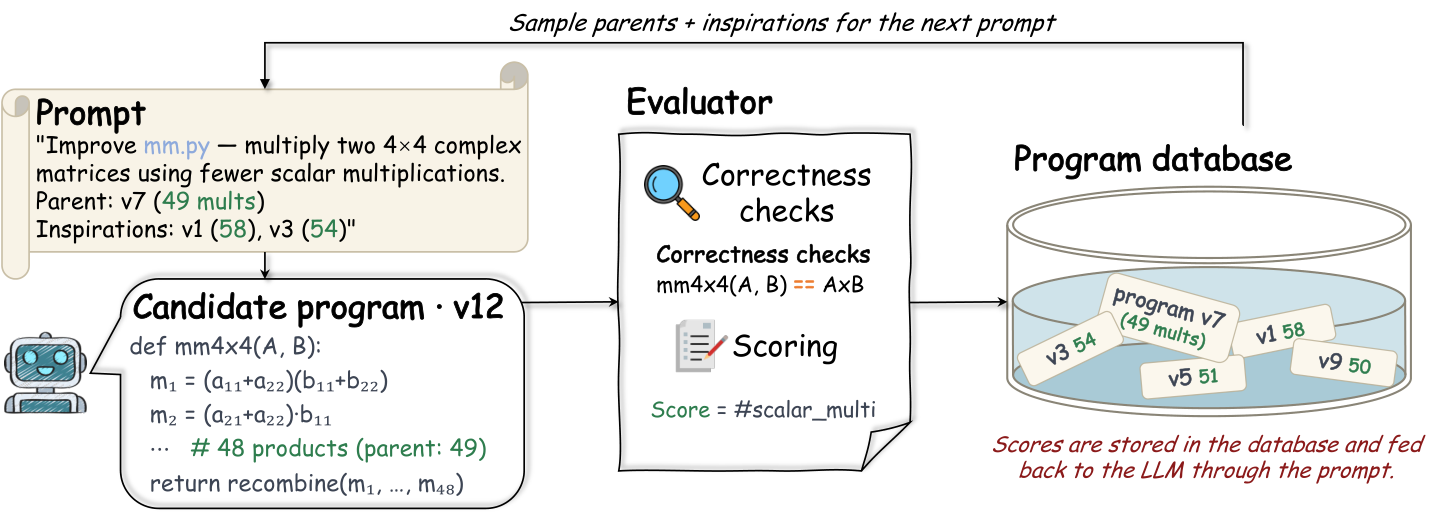
在大模型驱动科学发现与算法演化的前沿,以 FunSearch 和 AlphaEvolve 为代表的系统已经证明了代码自动演进的巨大潜力。它们将大语言模型置于“生成—评估—反馈”的闭环迭代中,通过数万甚至数十万次候选程序的演变,成功攻克了极具挑战性的数学组合优化与矩阵乘法难题。然而,这种闭环系统之所以能够顺畅运转,背后依赖一个极少在宣传中被强调的前提:候选程序的验证成本微乎其微。在纯数学或小规模矩阵运算中,算法的正确性与性能几乎可以在毫秒级内通过代数恒等式或测试用例予以确认。
ArXiv URL:https://arxiv.org/abs/2608.08189v1
但在真实的科学研究与工程优化场景中,这种低成本的“神谕评估器”(Oracle Evaluator)几乎是不存在的。无论是锂电池快充策略的电化学模拟、大规模数据中心网络拥塞控制协议的数据包级仿真,还是微纳光学器件的有限差分时域(FDTD)仿真,单次高精度评估往往需要耗费数小时、数天,甚至依赖昂贵的物理实验与硬件在环测试。在这种极端受限的评估预算下,直接让大模型无节制地生成代码并提交给真实仿真系统,无异于大海捞针,成本高到根本无法承受。
由百度、上海交通大学、西安交通大学与中关村学院等机构组成的联合研究团队,针对这一长期困扰 AI for Science 的根本瓶颈,提出了名为 Janus 的算法与评估器协同演化框架。Janus 打破了传统自动编程中“评估器是外部固定裁判”的思维定势,利用大语言模型不仅演化目标算法,同时让大模型演化“可执行的代理评估器”(Proxy Evaluator)。在保留真实高精度仿真作为最终守门人的同时,Janus 在五个严苛的科学与工程设计基准上,平均仅使用原有方法 40.9% 的真实仿真调用量(节省 59.1% 评估预算),就达到了基准搜索 99% 的优化上限,彻底打通了大模型在昂贵真实仿真场景下的自主探索路径。
为什么昂贵科学评估会拖垮大模型搜索?
为了看清 Janus 面临的核心困境,首先需要理解现有评估引导型大模型发现(Evaluator-guided LLM Discovery)在科学领域的失效机制。
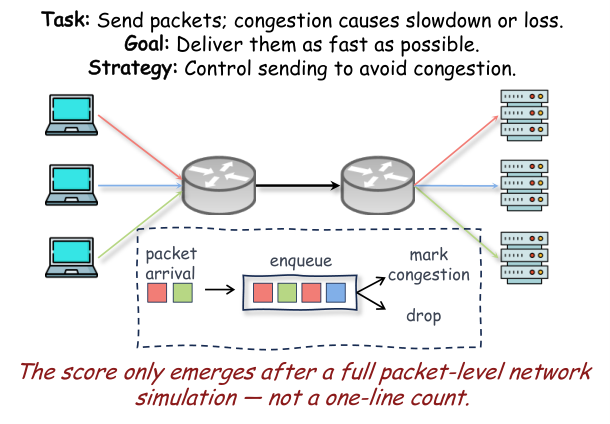
在算法演化系统中,大模型根据上下文池中的优秀母本生成候选程序,评估器返回量化分数与错误信息,大模型据此在下一步迭代中修正缺陷、探索新结构。在以 AlphaEvolve 发现 $4\times 4$ 复数矩阵乘法的新步骤为例,验证一个解法是否正确仅需几毫秒;然而,在网络拥塞控制协议的优化中,评估一个候选策略需要将其嵌入 ns-3 等仿真器中,覆盖成千上万个数据包的突发流、跨机架瓶颈链路以及不同的随机种子,单次评估动辄以小时计。
最直观的应对策略是引入“代理评估器”(Surrogate Evaluator),即贝叶斯优化和代理辅助进化算法中常用的思想:利用一个计算开销极小的预训练模型去近似真实的复杂仿真,大部分候选者由代理打分,只有少数高分者才去调用昂贵的真实评估器。
然而,固定的代理评估器在自由度极高的大模型代码生成面前会迅速崩溃,主要原因有二:
-
搜索诱导的分布漂移(Search-Induced Distribution Shift)与过度利用(Surrogate Exploitation):优化算法的本质是沿着代理评估器的偏好寻找极值。一旦固定代理存在局部的数值缺陷或逻辑盲区,大模型演化机制会迅速“黑进”这个漏洞,生成一系列在代理看来近乎完美、但在真实仿真中一败涂地的“作弊程序”。固定代理很快就会脱离它原本的训练分布,彻底丧失甄别能力。
-
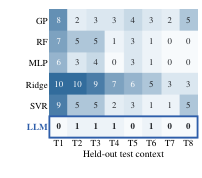
极度稀疏与有偏标签下的物理相变失真:能否在搜索过程中实时重新拟合代理?如果使用传统的高斯过程(GP)、随机森林或多层感知机(MLP),在真实评估极其昂贵的场景下,数据归档库(Archive)中的样本极度稀疏且高度有偏。更关键的是,许多工程物理系统存在剧烈的非线性突变。例如在网络流量调度中,当负载处于缓冲区容量之内时,网络呈现低延迟、零丢包的线性行为;一旦负载超过临界点发生拥塞崩溃(Incast),网络排队延迟和丢包率会发生雪崩式骤变。纯数据驱动的传统统计模型仅凭区区几十个历史点,根本无法捕捉这种跨越相变边界的物理行为。
Janus 的破局点:评估器即程序,双重协同演化
Janus 的名字源自罗马神话中的“双面神”,寓意算法探索与评估器构建互为表里、双向奔赴。Janus 并没有将代理评估器当作一个黑盒回归模型,而是创造性地提出了“评估器即程序”(Evaluator-as-Program)的范式。
在 Janus 框架中,一个代理评估器由两部分组成:$e = \bigl(g_{\phi}, \theta_{\phi}(\mathcal{A})\bigr)$。其中 $g_{\phi}$ 是由大语言模型生成的可执行 Python 程序骨架,负责从候选目标算法的执行痕迹中提取具有物理与工程意义的特征;$\theta_{\phi}(\mathcal{A})$ 则是在当前真实评估归档库 $\mathcal{A}$ 上经过校准的模型参数。
这种形式彻底释放了大模型在领域常识上的优势。面对一个复杂的电池充电任务,纯黑盒数据模型面对几十条离散曲线无从下手;但让具备深厚化学与物理工程先验的大模型编写评估代码时,大模型会主动在代理程序中加入对峰值温度、极化电压余量、SEI 膜生长速率等物理约束的检查逻辑。大模型负责生成结构与假设,真实的仿真反馈则负责标定参数并筛选去留。
在整个运行过程中,Janus 同时维护了两个演化种群:一个是目标程序种群 $P_{\mathrm{alg}}$,另一个是代理评估器种群 $P_{\mathrm{eval}}$。两者的协同演进形成了严谨的闭环架构。
1. 晋级对齐的元评估目标
如何判断一个由大模型写出来的代理评估程序是好是坏?传统的做法往往是计算代理预测值与真实值之间的全局相关系数(如 Spearman 系数)。但 Janus 指出,全局排序在演化搜索中毫无必要。开发者根本不在意一个代理能否准确区分“第 90 名”和“第 95 名”有多糟糕,真正致命的是它能否在候选池的前沿,精准把最有希望突破当前纪录(SOTA)的候选者挑选出来。
因此,Janus 设计了晋级对齐目标(Promotion-Aligned Meta-Objective):
\[F_{\mathrm{meta}}(e) = \lambda_{R}\bigl(1 - R_{k}(e)\bigr) + \lambda_{N}N_{k}(e) + \lambda_{\rho}\rho(e)\]该指标重点考核代理评估器在头部候选者上的召回率 $R_{k}$、排序增益 $N_{k}$(通过 $\mathrm{NDCG@k}$ 量化),并辅以适度的局部秩相关 $\rho$。通过强化头部辨识度,评估器能够集中有限的辨别力精准拦截平庸候选,锁定极少数潜在的跃迁者。
2. 区域条件组合与在线动态信誉
复杂的科学问题往往跨越多种物理机制与结构形态。单一评估器即使经过演化,也容易在某类特定形态下产生系统性偏见。例如在微纳光子学设计中,离散孔隙结构与连续流道结构的波导仿真误差表现迥异。
Janus 采用代码表征聚类,将候选程序划分到不同的形态区域 $r$ 中,并维持一个自适应评估器组合(Portfolio)。针对不同区域 $r$,评估器的权重不仅依赖全局表现 $F_{\mathrm{meta}}(e)$,还引入了在线信誉动态更新:
\[F_{e,r} = (1 - \alpha_{e,r})F_{\mathrm{meta}}(e) + \alpha_{e,r}g_{e,r}\]每当某个代理评估器推荐的候选程序通过了真实仿真的检验并创造了新高,该评估器在对应区域的信誉得分 $g_{e,r}$ 就会上升;若其推荐的候选者在真实仿真中崩溃或严重落空,其信誉就会被立即扣减。这种动态自纠错机制使得组合能够快速感知分布的变化,自动剥夺在当前搜索前沿失效的评估器的决策权。
3. 真实锚定的安全晋级机制
为了彻底杜绝任何形式的“代理被黑”(Surrogate Exploitation),Janus 确立了一条底线原则:代理评估器的预测永远只用于分配昂贵的真实评测预算,绝不能越权作为基准程序入库的依据。
在大模型批量生成候选代际之间,候选程序首先进入一个临时去重池,由当前的最优评估器组合进行打分。打分遵循获取函数 $\alpha(x)$,该函数综合权衡了预测效用、有效性概率、不确定性探索以及代码嵌入空间的区域新颖度。只有在获取函数中排名前列的高价值候选者,才有资格触发真实的昂贵仿真调用 $f_{\mathrm{real}}$。
一旦真实评估完成,所有的代理中间预测值全部被抛弃,唯有真实仿真测得的真实适应度与有效性标签,才能决定该程序能否载入最优记录、能否进入核心种群用于繁衍下一代。与此同时,为了防止当前的评估器组合出现“集体盲视”,Janus 还会周期性地抽取未经代理打分的原始候选程序直接送往真实评估,从而构筑起极强的安全防线。
覆盖五大严苛领域的全面验证
为了检验 Janus 在极端预算约束下的发现能力,研究团队构建了涵盖能源、通信、光学、化工与运筹学的五大代表性科学与工程设计任务:
-
PyBaMM(锂电池极速充电策略):使用电化学级别的物理模型模拟快充过程,不仅追求充电速度,更受到析锂、热失控与老化限制等极其苛刻的非线性边界约束。
-
AQM(数据中心主动队列管理):利用 ns-3 进行细粒度数据包级仿真,测试在大突发网络流量下的延迟控制与链路吞吐权衡。
-
FDTD Demux(微纳光学波长解复用器件设计):通过二维麦克斯韦方程组的离散求解,设计高透射率、低串扰的光子芯片结构。
-
Reactor(带约束放热反应器控制):复杂的非线性化工动力学仿真,控制算法稍有偏差就会引发反应失控。
-
Perishable IRP(易腐品随机库存路径规划):运筹优化领域的随机时序调度仿真。
在所有基准测试中,算法均在严格对齐的真实仿真调用预算下展开测试(例如网络仿真任务预算限制在区区数十次调用)。
对比实验包含了多条极具竞争力的基线:仅演化目标程序且不使用任何代理的基准(Alg.-Only);采用代码嵌入加高斯过程的传统代理方法(Embed-GP);以及基于近期顶会思路、直接在超长 Prompt 中堆叠历史运行结果让大模型直接估分的打分模型(Direct-LLM)。
实验结果揭示了几个具有颠覆性的结论:
首先是发现效率与上限的双重超越。在有限的仿真预算内,Janus 不仅在搜索曲线下面积(AUBC$\Delta$)上全面压制所有基线,最终收敛达到的最佳程序质量也普遍高于不使用代理或使用传统代理的方案。更具说服力的一组统计数据显示:Janus 平均仅消耗了纯算法演化基准 40.9% 的真实仿真开销(节省了 59.1% 的评测成本),就完全追平了基准方法耗尽全部预算才能达到的最终提升幅度(99%)。
其次是传统固定代理的彻底失效。在 PyBaMM、AQM 和 FDTD 等四个任务中,传统的 Embed-GP 甚至跑输了完全不用代理的纯算法演化。这一现象强有力地证明了前文的论断:基于静态语义距离的传统回归模型完全无法映射底层物理动态,盲目使用静态代理只会把演化搜索引入死胡同。
最后是显式的计算成本优势。虽然 Direct-LLM 在某些连续任务上勉强能提供粗略的优劣倾向,但它在超长提示词中不断塞入历史代码与数值,导致每完成一次真实评测平均消耗的 LLM Token 是 Janus 的 8.1 倍,而最终搜索表现依然大幅落后于 Janus。相比之下,Janus 将特征提取逻辑固化为 Python 程序骨架,不仅执行飞快、推理开销极低,还具备极其透明的代码解释性。
评估器是如何在演化中“变聪明”的?
Janus 能够大幅削减仿真开销的根源,在于其代理评估器在与目标程序的博弈中实现了同步进化。研究团队通过留出测试集(Holdout Candidates),对各个阶段生成的代理评估器进行了精准的度量。
在排序指标 $\mathrm{NDCG@3}$(即挑选前 3 个最具潜力的种子选手的精准度)上,演化后的评估器展现出了质的蜕变:
在 PyBaMM 电池任务中,代理评估器的 $\mathrm{NDCG@3}$ 从初始种子的 0.688 攀升至 0.970;在 FDTD 光学任务中从 0.612 跃升至 0.923;而在最易发生拥塞崩溃的 AQM 任务中,初始种子评估器的相关准确率完全是无序的 0.000,经过与目标控制器的共同演化迭代,最终评估器的 $\mathrm{NDCG@3}$ 直接暴增至 0.694。
深入剖析演化出的评估器 Python 代码,可以清晰地观察到评估逻辑的演进逻辑。在电池快充任务的初期,种子评估器仅仅计算电压是否超限这一基础指标;而经历数轮迭代后,大模型自发生成的成熟评估器代码中,已经构建出了一套完整的复合惩罚体系:精确积分计算高荷电状态(SOC)下的持续时间、实时估算固体电解质界面(SEI)膜的增厚阻抗、监测峰值温升速率。
这种演进并非人类专家手工灌输,而是大模型在观察到历史真实仿真的偏好与报错反馈后,自主写出、自主编译并经过真实数据筛选留存的程序结构。它把深奥的领域工程经验,凝练成了高效且免于高精度仿真的轻量级代码启发式。
在消融实验中,研究人员逐一剥离了评估器演化模块(S)、区域自适应组合(A1)、晋级对齐目标(M0)以及在线信誉更新(O0)。测试结果表明,去除任何一个环节都会导致性能出现显著滑坡(在 AQM 任务中,去除信誉更新机制会导致性能下滑超过 40%)。这印证了 Janus 内部各组件的高度互补性:演化负责拓宽代理的表达力,晋级目标确保关注前沿,区域划分规避形态盲点,而在线信誉则为不可避免的代理失真提供了实时止血阀。
走出“廉价评测温室”的 AI 科学探索
长期以来,基于大语言模型的程序发现研究存在一个隐形的“温室效应”:绝大部分惊艳的研究成果,都局限在能够无限次调用轻量解释器、拥有近乎免费评测环境的算法与数学问题上。一旦踏入需要高保真数值模拟或硬件在环验证的硬核科学工程无人区,大模型由于缺乏及时的方向指引,往往陷入漫无目的的试错陷阱。
Janus 的核心价值,在于它为算法发现系统构筑了一具“自带演化能力的感官器官”。它承认大模型先验知识的局限性,承认轻量代理可能出错的脆弱性,但通过将“代理代码化”与“双向演化机制”相结合,在低成本启发式预测与高成本真实世界锚定之间搭建了一座可自愈、自标定的动态桥梁。
随着大模型与各类工业仿真软件、自主实验室(Self-Driving Labs)的深度结合,评估成本将是摆在全自动科学探索面前最严峻的现实壁垒。Janus 所呈现的这套算法与评估器协同演进哲学,不仅证明了大模型不仅能“解题”,还能自主“出评分标准”,更为昂贵仿真环境下的自主科学发现提供了一套兼具理论严谨性与工程落地可行性的关键基础设施。