LabRobFail:攻克化学实验不可逆风险,具身智能故障检出率达90.8%
LabRobFail: A Benchmark for Robotic Failure Analysis in Chemical Self-driving Laboratory
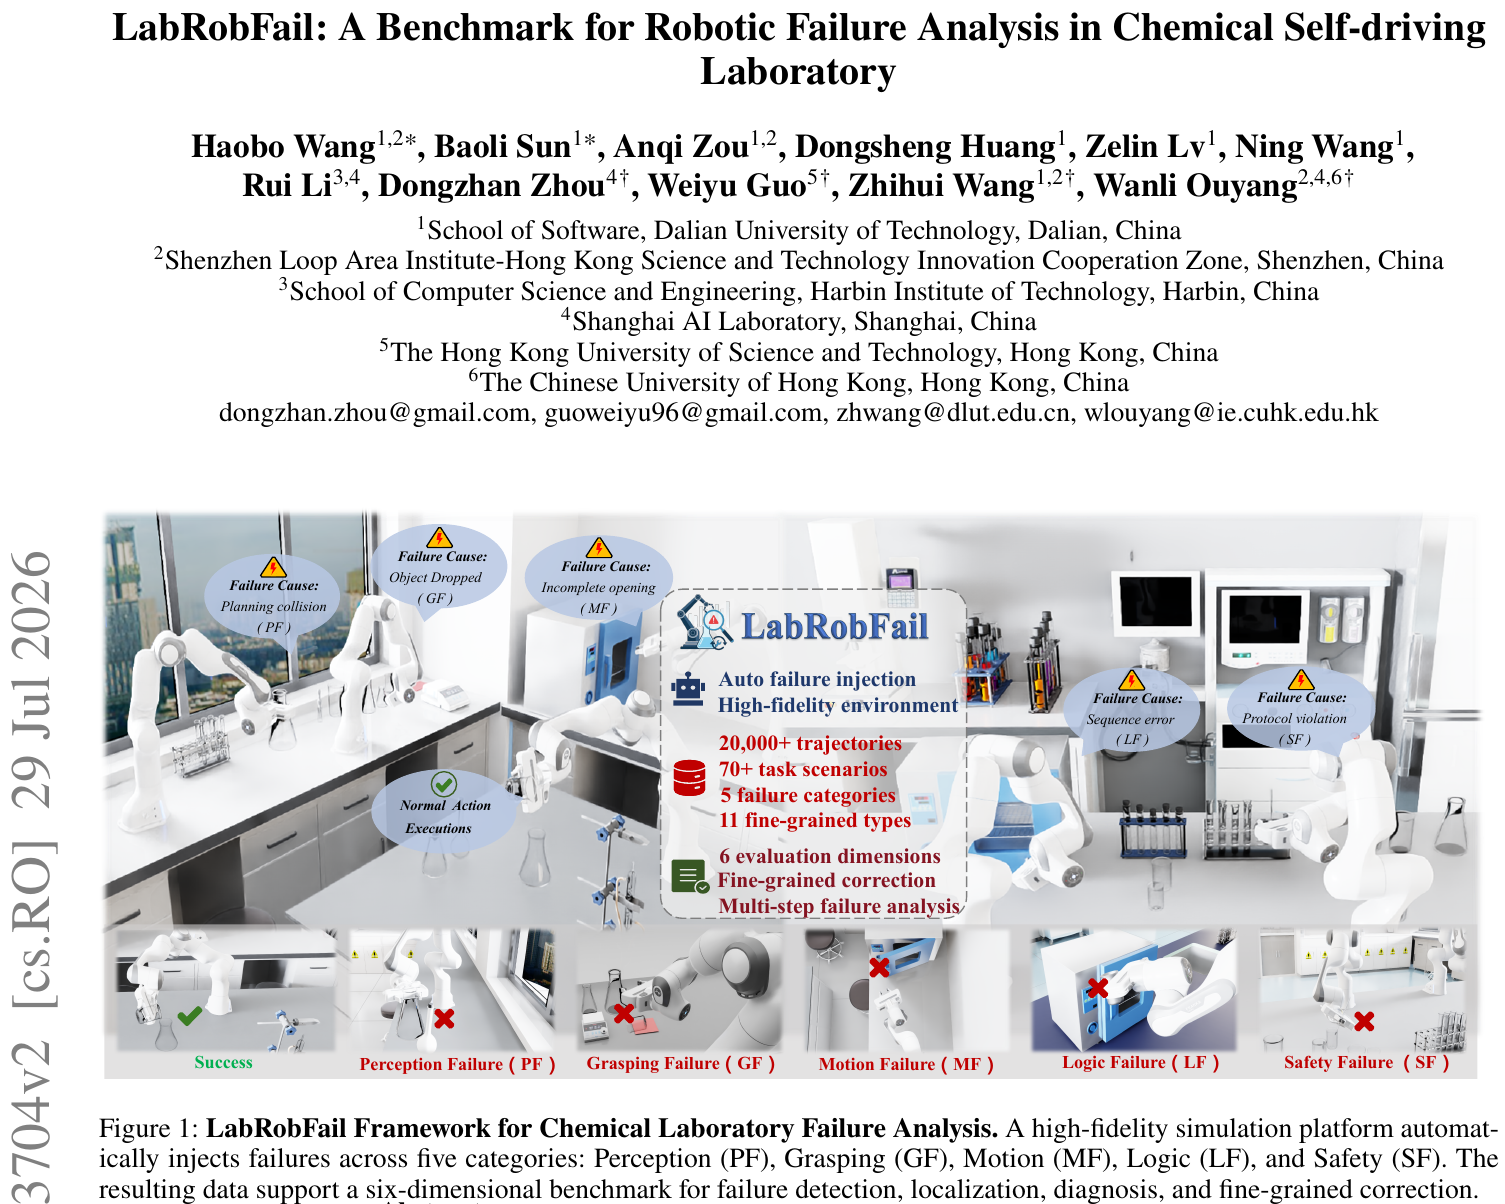
在具身智能走向现实世界的各类场景中,自驱实验室(Self-Driving Laboratories, SDLs)被普遍视为最具变革潜力的方向之一。通过将机械臂、移动底盘与大语言模型、视觉-语言-动作(VLA)模型结合,实验室内枯燥、重复甚至具有毒害性的试剂配制、移液和检测工作有望实现全流程自动化,进而指数级加速材料与新药的研发进程。
ArXiv URL:https://arxiv.org/abs/2607.23704v2
然而,实验室环境对机器人的容错率近乎苛刻。与家庭场景中“掉落苹果可以重新捡起”的强可逆性截然不同,化学实验具备高度的不可逆性与安全敏感性。微小的移液器对齐偏差可能导致昂贵样品的交叉污染,搅拌速度的轻度失控可能引发剧烈的液体飞溅甚至放热失控,长流程实验中任何一个子步骤的失效都可能让数小时乃至数天的前序工作化为乌有。目前主流具身模型普遍存在“幸存者偏差”,训练数据绝大多数来自成功的操作轨迹,面对偶发的物理滑动、感知失真或逻辑错乱,系统往往缺乏自我感知的“痛觉神经”,更无法在毫秒级时序内做出精准的挽救策略。
来自大连理工大学、哈尔滨工业大学、香港科技大学、上海人工智能实验室、深圳河套学院以及香港中文大学等机构的联合研究团队,针对这一长期被忽视的痛点,提出了专为化学自驱实验室设计的机器人故障分析框架 LabRobFail。该研究通过三层自动化故障注入机制构建了包含2万余条轨迹的大规模故障数据集,提出了六维度认知评测基准,并定制了领域专用的多模态模型 LabRobFail-VLM。在已知环境中,该模型实现了 90.83% 的故障检出准确率与 77.21% 的时序定位准确率;更关键的是,当它作为外部监考官介入执行端闭环控制时,机械臂在下游任务中的成功率显著提升了 4 到 16 个百分点。
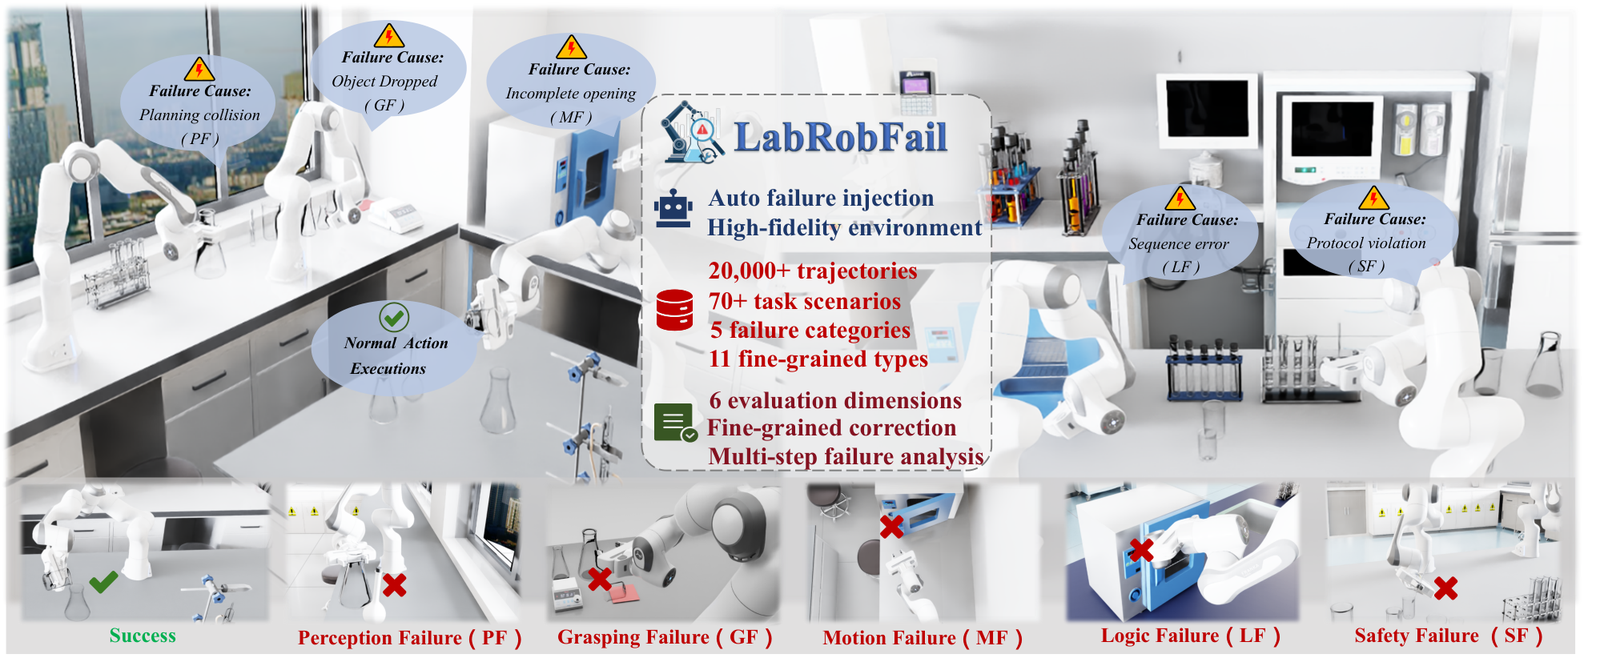
为什么化学实验机器人格外需要“懂失败”?
目前通用的机器人故障诊断方案大多依赖固定传感器的阈值监控,或者粗粒度的视觉二分类判断。这些方案迁移到化学场景时,暴露出两个根本性断层。
第一是高质量、多维度的故障数据极度匮乏。在真实化学实验室中人为制造事故是昂贵且极其危险的,没有团队能够承受频繁倾倒有毒试剂或摔碎精密玻璃仪器的代价;而现有的科学仿真平台(例如 LabUtopia 或 AutoBio)核心目标是还原“成功路径”,缺乏可控的异常生成机制。第二是评测标准的粗糙化。现有的家庭环境故障基准往往只判定“成功”或“失败”,即便给出纠错提示,也往往是模糊的自然语言描述(例如“请重新对准容器”),但在机械臂抓取试管或滴定注入时,控制器需要的是精确到厘米级、旋转弧度级以及夹爪开合状态的确定性干预。
为了打破这种“不敢错、没数据错、错后不知如何救”的恶性循环,研究团队建立了一套贯穿“仿真合成—数据集构建—多维基准—专用模型—闭环恢复”的完整技术链条。
自动化故障注入:在仿真中给物理与逻辑“下毒”
解决数据匮乏的第一步是建立一个高保真的失败生成引擎。研究团队在物理化学仿真平台 LabUtopia 的物理引擎基础之上,构建了 LabRobFail-Sim。该系统不仅模拟液体流动与仪器接触,更引入了一套解耦的多层扰动生成管道,避免了人工编写特定规则的局限。
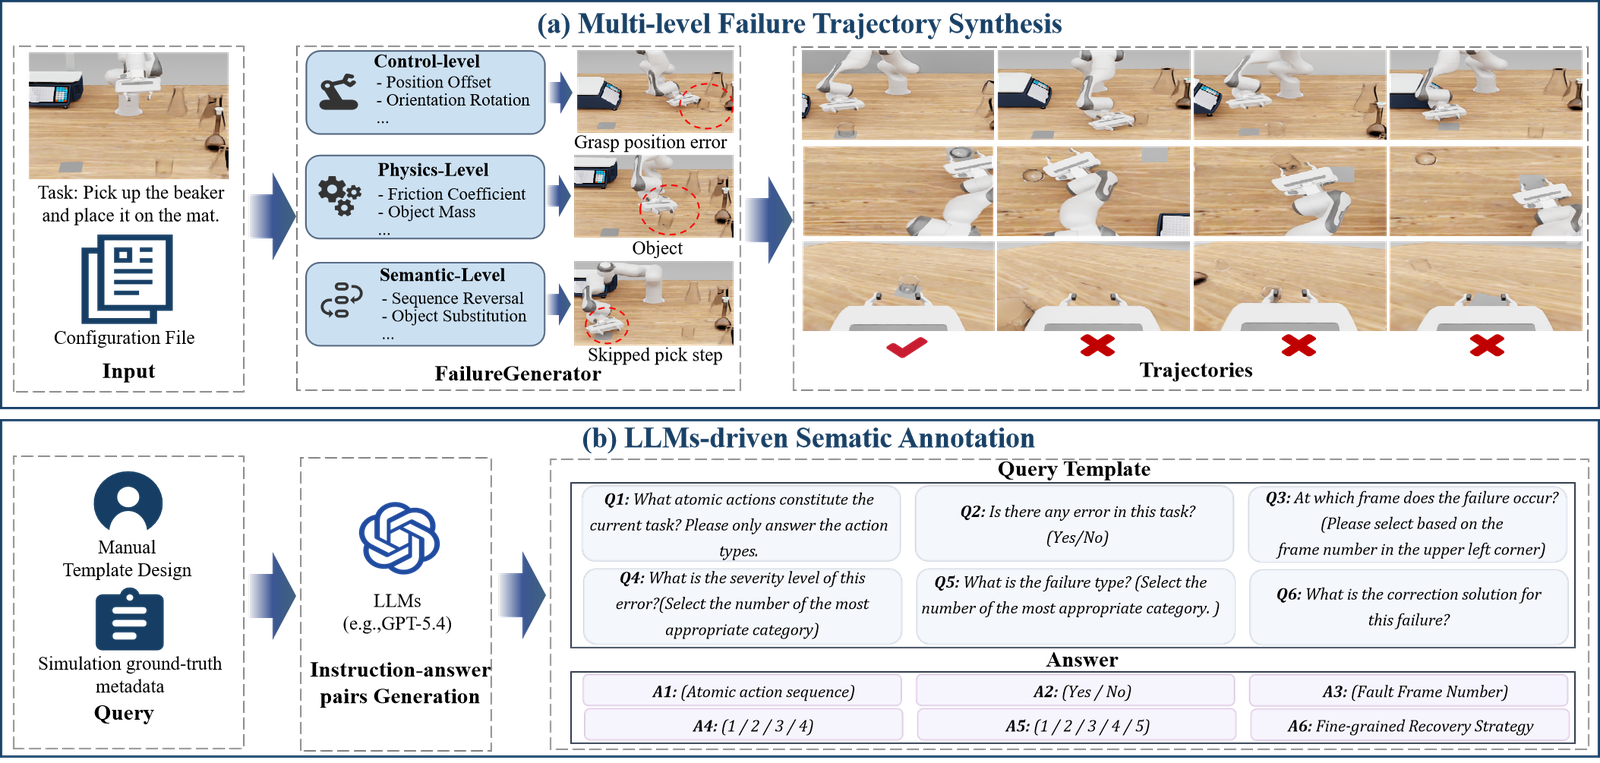
在技术实现上,研究人员将机械臂的操作技能抽象为稀疏关键帧序列 $\tau={(T_i, g_i, o_i)}_{i=1}^N$,其中 $T_i = (R_i, p_i) \in SE(3)$ 代表末端执行器的目标位姿(由旋转矩阵 $R_i$ 和平移向量 $p_i$ 构成),$g_i \in {0, 1}$ 表示夹爪开合,而 $o_i$ 则是被操作的化学器具。系统通过三级层次化函数 $\Phi$ 对轨迹进行系统性扰动:
-
控制层扰动(Control Perturbation):直接在末端执行器的位姿输入上施加平移与旋转噪声,形式为 $\tilde{p}i = p_i + \xi{trans}$ 以及 $\tilde{R}i = R_i \cdot \text{Exp}(\xi{rot})$。这一机制主要诱发机械臂“手抖”、微小定位失准、对不准烧杯口等运动执行误差。
-
物理层扰动(Physics Perturbation):动态干预接触面摩擦力、流体粘度、容器质量等物理属性 $\psi$,通过公式 $\tilde{\psi} = \psi \cdot (1 + \delta)$(其中 $\delta \sim \mathcal{U}(-\alpha, \alpha)$)随机缩放环境参数,模拟实验中因为器皿外壁湿滑导致的滑脱,或是液体粘度过高引发的吸样不足。
-
语义层扰动(Semantic Perturbation):打乱或修改高层任务逻辑,例如在加入试剂前遗漏开启瓶盖的动作,或者在未充分搅拌时提前进入下一阶段,生成违反实验安全规范的逻辑失效。
最终,受控轨迹以 $\tilde{\tau} = \Phi_{sem}(\Phi_{ctrl}(\tau))$ 的形式在受扰物理动力学环境 $\Phi_{phy}(\Psi)$ 中执行。伴随着物理运动,系统会自动记录下毫秒级的真值元数据。随后,研究团队引入 GPT-5.4 驱动的自动化标注模块,利用仿真导出的位姿突变点与物理接触事件,自动实例化问答对与结构化矫正指令,经过规则过滤和人工抽检,最终沉淀出高质量的评测与训练语料。
从感知到可执行纠错:构建2万条轨迹的六维基准
基于 LabRobFail-Sim,研究团队推出了迄今为止化学实验机器人领域颗粒度最高的故障数据集与基准:LabRobFail-Data 与 LabRobFail-Bench。
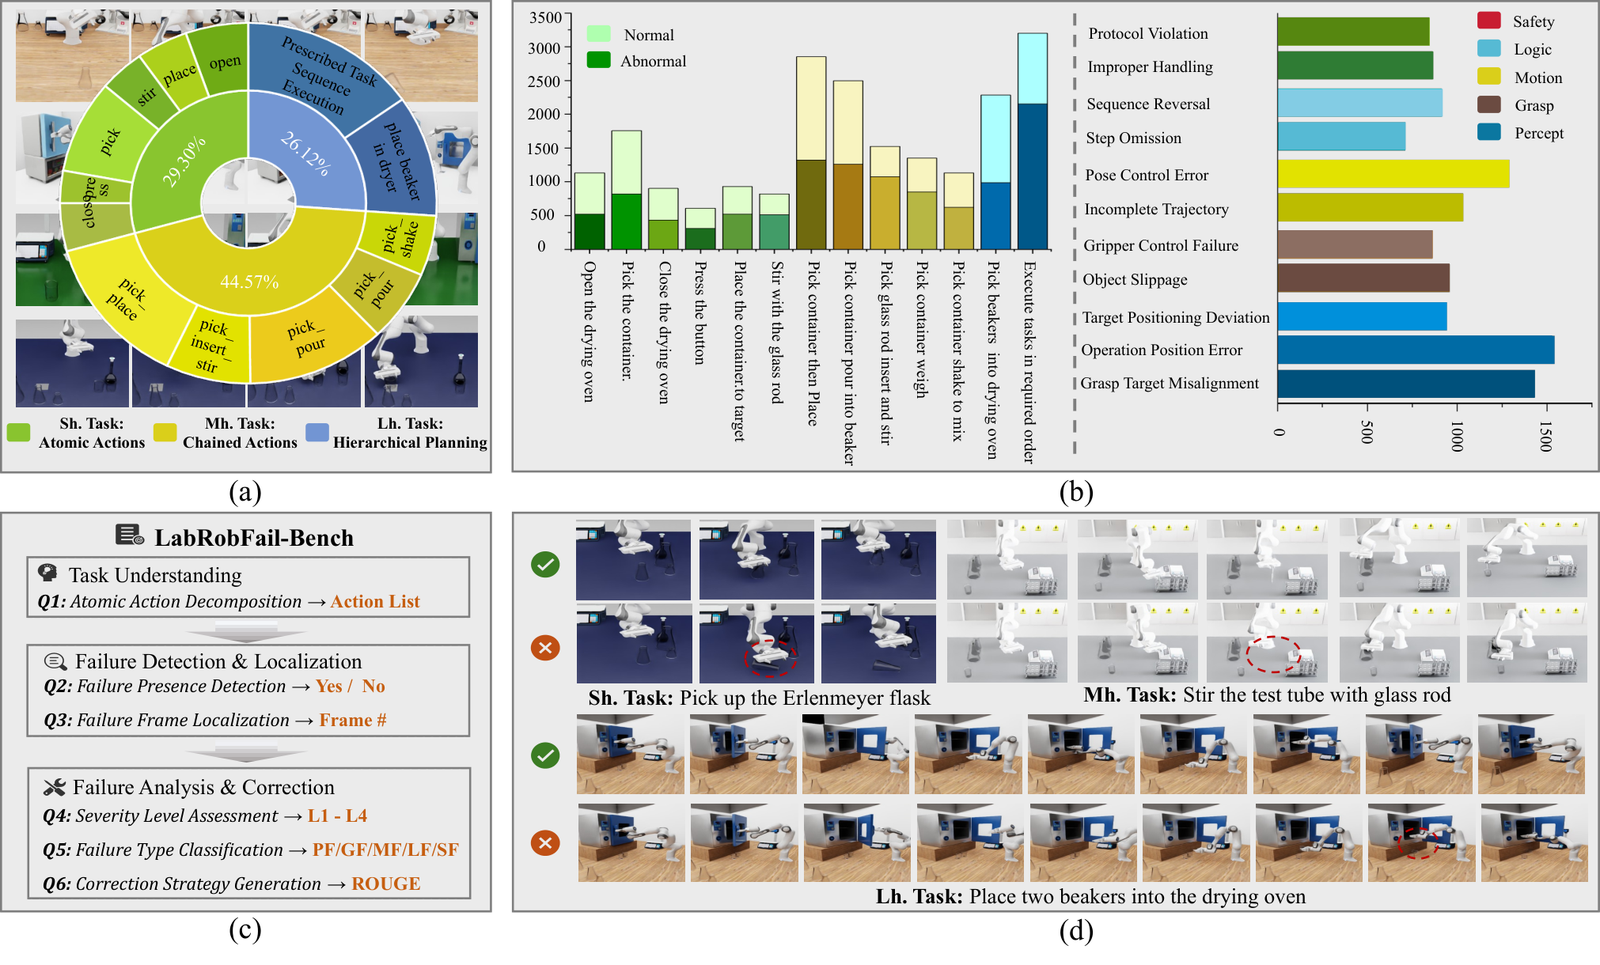
LabRobFail-Data 包含超过 20,000 条轨迹,覆盖 70 多个具体的化学操作场景,从短程的量筒抓取,到涉及多阶段长流程的稀释滴定一应俱全。更关键的是,该数据集采用了成对对比数据(Paired Contrastive Data)的设计理念:在完全相同的环境初始参数、光照和背景下,生成一一对应的成功与失败轨迹。这种极度严谨的对照消除了背景噪声带来的统计虚假关联,迫使模型去真正理解“正常操作”与“细微异常”之间的临界分界线。
数据集涵盖了五大宏观故障类别(感知异常 PF、抓取异常 GF、运动异常 MF、逻辑异常 LF、安全异常 SF),并进一步细分为11种具象故障类型。与之匹配的 LabRobFail-Bench 提出了三个递进认知维度的六项评测任务(Q1–Q6):
-
L1 任务理解(Q1):考察模型能否从给定的视频帧与场景中准确理解机械臂正在尝试完成的实验意图。
-
L2 异常检出与时序定位(Q2, Q3):Q2 判定轨迹中是否存在操作失败;Q3 则更进一步,要求模型指出故障首次发生在哪一个具体的关键帧时间点,杜绝“事后诸葛亮”式的模糊猜测。
-
L3 深度归因与纠错生成(Q4–Q6):Q4 对风险严重程度进行四级定级(Minor 轻微、Recoverable 可恢复、Critical 严重、Catastrophic 灾难性);Q5 输出细粒度的故障分类;而核心的 Q6 则要求模型给出包含末端执行器相对位移、姿态微调角 $\Delta R$ 以及夹爪开闭动作的可执行纠偏参数。
这种分层设计使得评测不再局限于“机器人有没有做对”,而是全面检验具身大脑是否具备识别风险、量化风险并指导身体自我纠错的完整链条。
LabRobFail-VLM:跨模态时空网格与非对称微调
为了验证在高度专业化的化学场景下模型究竟能走多远,研究人员基于开源多模态基座 Qwen3-VL-8B 开发了领域专用模型 LabRobFail-VLM。
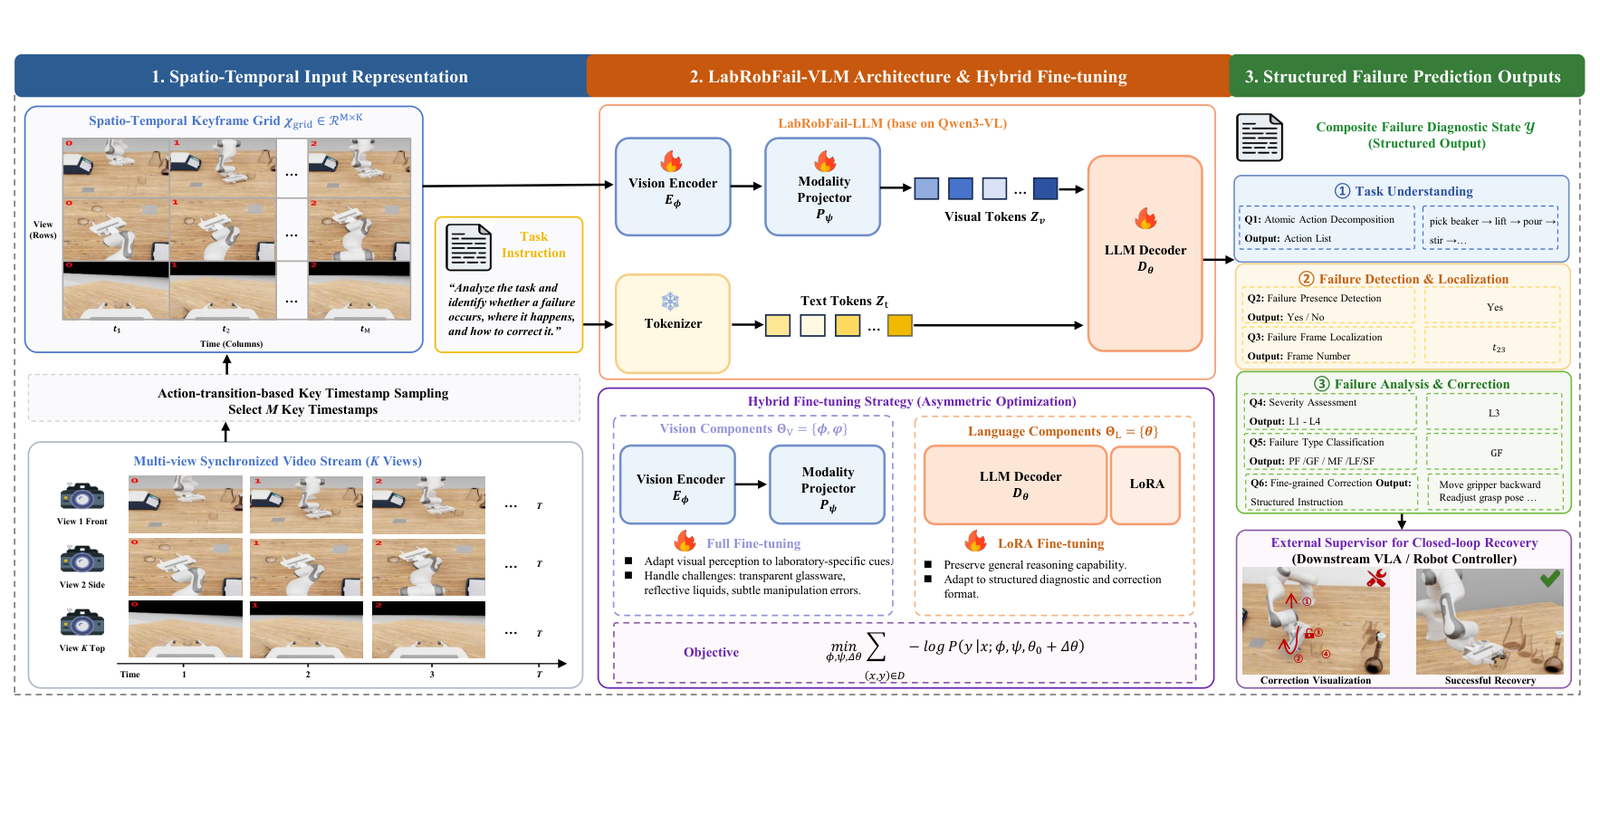
通用多模态模型直接处理多视角、长时序机器人操作视频时,往往会因为视觉 Token 数量剧增而导致上下文爆炸或注意力分散。为了平衡计算开销与信息保真度,团队提出了时空关键帧网格(Spatio-Temporal Keyframe Grid)表示法。系统根据机械臂动作切换点抽取 $M$ 个关键时间戳,并同步提取 $K$ 个机载与全局视角,将 $M \times K$ 个画面拼贴为一张高分辨率大图。为了让语言模型能精准感知物理世界的时序演进,图像左上角被强制渲染了显式的数字时间索引 $t$。消融实验证明,这个看似微小的渲染操作,直接将故障时序定位的准确率拉升了 6.63 个百分点。
面对化学实验室中独特的视觉挑战——透明的玻璃试管、液面反光折射、微弱的液体倾倒流痕——预训练在自然图像上的视觉编码器往往极度迟钝。为此,研究团队设计了非对称微调策略(Asymmetric Optimization):
\[\min_{\phi,\psi,\Delta\theta}\sum_{(\mathcal{X},\mathcal{Y})\in\mathcal{D}}-\log P(\mathcal{Y}\mid\mathcal{X};\phi,\psi,\theta_0+\Delta\theta)\]在优化过程中,研究人员选择将视觉编码器 $E_\phi$ 与模态投影层 $P_\psi$ 完全解冻进行全量微调,赋予模型重新学习透明器皿几何形态与液体边缘特征的能力;而对于体量巨大的语言解码器 $D_\theta$,则采用秩为 64 的低秩自适应(LoRA)模块 $\Delta\theta$。这种非对称设计取得了绝佳的平衡:既通过激进调整视觉底层攻克了特定领域的视觉感知鸿沟,又最大限度保留了通用大模型深层的符号推理与逻辑推演能力。消融实验表明,全量微调全部网络或全量冻结视觉前端均会导致性能断崖式下跌。
实验与闭环恢复:专精模型超越通用旗舰
在针对已知环境(Seen)的评测中,LabRobFail-VLM 展现出了大幅超越通用顶尖视觉-语言模型的故障分析能力。在故障检测(Q2)任务中,该模型取得了 90.83% 的 Top-1 准确率,时序定位(Q3)达到 77.21%,在细粒度纠错指导(Q6)的文本匹配指标上,BLEU-4 达到 0.7251。相比之下,参数规模更大且未经领域对齐的通用大模型虽然在基础任务理解上表现尚可,但在微小的机械碰撞和液体滑脱检测上频繁出现误报与漏报,更几乎无法生成符合控制规范的空间位姿补偿量。
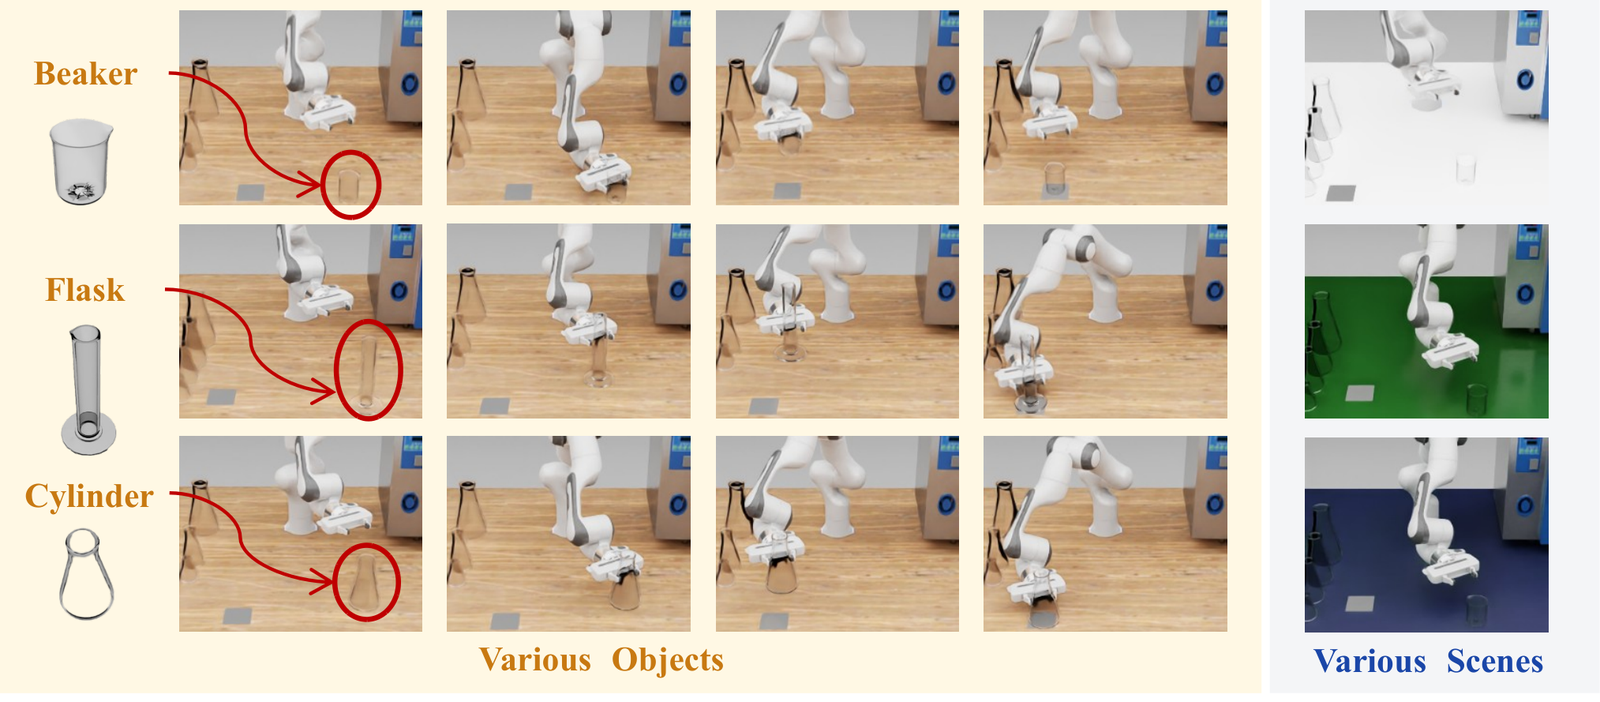
为了测试模型在面对真实世界变数时的泛化底色,研究团队在未见测试集(Unseen)上设置了三级难度梯度:引入未见过的化学试剂瓶(Novel Objects)、替换全新的实验台与实验室背景(Novel Scenes),以及两者同时变更的复合扰动(Both)。
实验表明,当场景与物体发生双重偏移时,由于环境特征剧烈变化,所有模型的表现均出现回落。通用模型如 Gemini-2.5-flash 的检出率跌落至 56.54%,而 LabRobFail-VLM 依然维持了 71.02% 的检出率,在指导纠错的 BLEU-4 指标上保持在 0.3269,远超各路基线(通用模型普遍低于 0.03)。不过,复合领域偏移导致的时序定位准确率下滑,也如实反映出具身智能在复杂化学视觉感知上面临的泛化硬骨头。
更加关键的一组实验落在具身闭环控制(Downstream Policy Recovery)上。研究团队将 LabRobFail-VLM 作为外部“高层监护者”,接入当下前沿的端到端动作策略 OpenVLA 与 ACT 中。当底层策略执行动作引发物理或控制异常时,LabRobFail-VLM 实时识别故障、定位时刻,并将生成的结构化校正参数通过预设的动作字典(Action Dictionary)转化为补偿控制信号。
在涵盖倒液、移液、抓管等多项复杂实验任务的评测中,介入该监护框架后的底层策略表现出显著的自愈韧性,下游任务成功率实现了 4 到 16 个百分点的净增长。尤其是在对流体动态极度敏感的倾倒液体(Pour)任务中,ACT 模型的成功率从原本孱弱的 32% 直接提升至 48%。这直接证明:故障推理不仅是事后的离线评估工具,更能直接作为高价值的前馈反馈信号,挽救执行中面临崩溃的物理轨迹。
此外,为了验证该数据集的领域迁移价值,研究团队将现有的通用故障分析模型 AHA 在 LabRobFail-Data 上进行先验预训练。结果显示,吸收了化学实验故障先验的模型,在通用操作域的检出精度单项提升了 4.1 个百分点。化学操作所涉及的非刚体相互作用(如液体震荡与润湿效应)为具身模型注入了极为罕见的物理先验。
走向真正可信赖的自驱实验
LabRobFail 框架的核心贡献在于:它不仅将具身智能的失败分析推向了高风险、高价值的自驱实验室场景,更通过体系化的工具链证明了细粒度、成对对比的故障推演能够转化为机械臂物理层面的自愈能力。它打破了以往具身系统依靠反复试错积累经验的低效逻辑,为化学、材料等不可逆实验场景确立了安全底线。
当然,正如作者在文中所指出的,当前系统在迈向真实化学大生产时仍有局限。模型现阶段训练完全依赖高保真仿真环境,虚实迁移(Sim-to-Real)中的光学细节差异仍需真机数据补充微调;同时,从多模态纠错文本到底层轨迹的转化目前仍依赖确定性动作字典,某种程度上压制了复杂自由度调整的灵活性。未来若能将 LabRobFail 的细粒度纠错直接内化为通用 VLA 模型的自回归 Token,让机械臂原生具备“预知风险、错即回调”的肌肉记忆,自驱实验室方能真正跨过安全鸿沟,承托起高通量科学发现的未来。