微软 Mage-VL:原生编解码削减75%Token,4B推理提速3.5倍
Mage-VL: An Efficient Codec-Native Streaming Multimodal Foundation Model
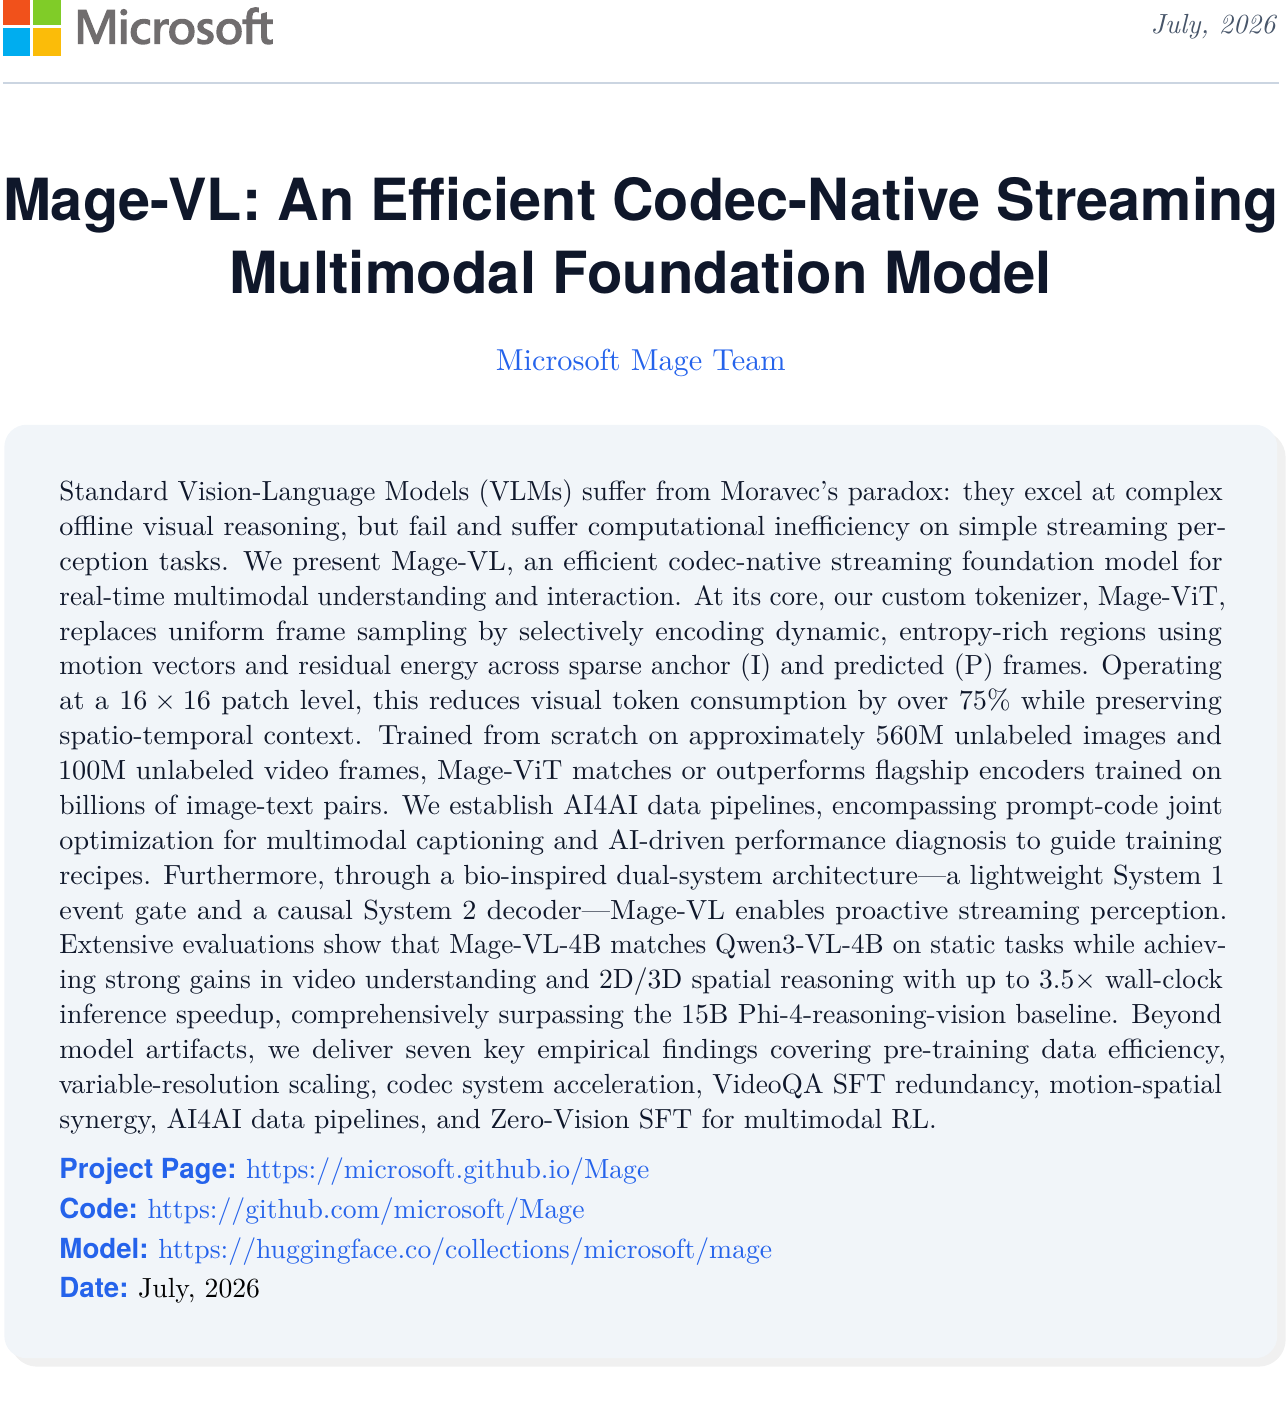
多模态大模型在今天面临着一个奇特的“莫拉维克悖论”:它们可以拆解极其复杂的代码、精准解析密集文档排版、甚至在几何奥数题上与人类一较高下;然而一旦面对连续的现实视频流,哪怕只是感知场景里细微的动态变化或做出及时的交互反应,模型就会变得异常迟钝,并消耗惊人的计算资源。
ArXiv URL:https://arxiv.org/abs/2607.24904v1
造成这种脱节的根源,在于主流视觉语言模型(VLM)处理时空信号的底层逻辑存在结构性缺陷。人类视网膜与大脑只对局部变化和动态边缘高度敏感,静态背景会被前级神经元自动过滤;但现有的 VLM 几乎全部沿用了静态图像时代的粗暴逻辑:把视频切成一张张固定帧率、固定分辨率的“幻灯片”,然后丢给在大规模静态图文对上预训练的视觉编码器做无差别的网格分词。在这个过程中,静止不变的背景像素被翻来覆去地重复编码,造成了海量的时空冗余,令长视频与实时流式感知的推理成本陡增。
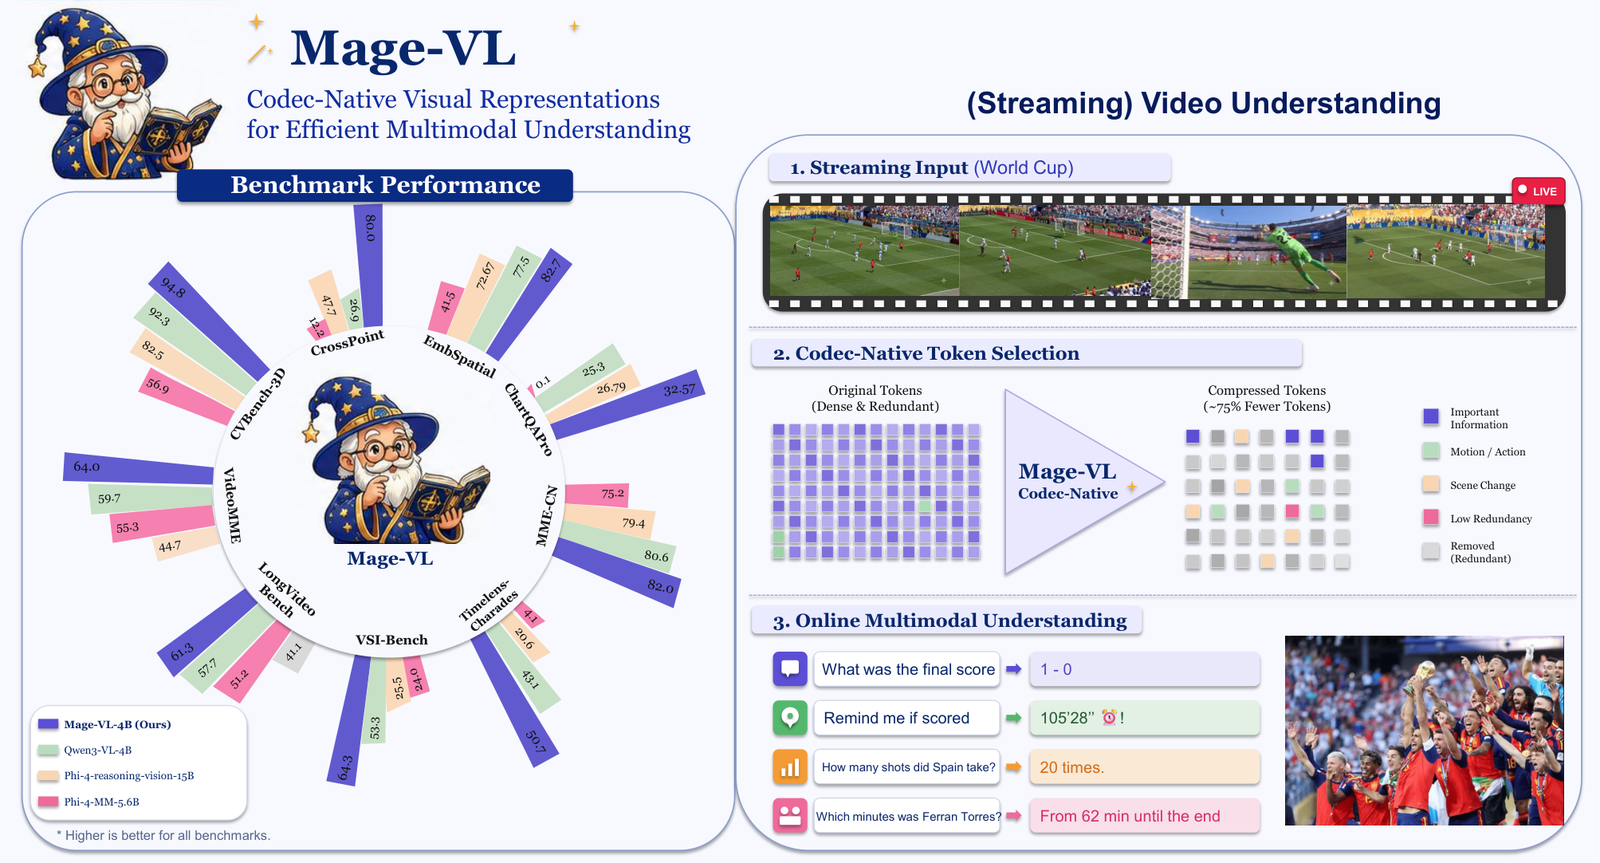
微软提出的 Mage-VL 试图从根本上颠覆这种帧级离线处理范式。它借鉴了现代视频编解码器与生物视觉的双系统机制,构建了一套“编解码原生(Codec-Native)”的流式多模态基座模型。其核心视觉编码器 Mage-ViT 利用运动向量与残差能量,动态识别场景中的信息熵分布,将预测帧的视觉 Token 削减超过 $75\%$;在此基础上,轻量级的“系统 1”事件门控与因果“系统 2”语言解码器协同,实现了主动触发式的实时流式交互。在多项评测中,仅有 4B 参数规模的 Mage-VL-4B 不仅在静态任务上追平了 Qwen3-VL-4B,在视频理解与空间推理上大幅领先,推理速度实现高达 3.5 倍的端到端飞跃,并在多模态综合能力上越级击败了参数量近其四倍的 15B 级别基准模型 Phi-4-reasoning-vision。
告别均值抽帧:编解码原理驱动的 Mage-ViT
想要摆脱冗余,最朴素的思路是在 Vision Transformer 内部做剪枝或聚类,但这些后处理方案依然需要先对海量无效像素完成密集的前向特征计算。Mage-VL 采取了一条更底层的路径:在视觉信号进入 Transformer 之前,就借用经典视频压缩算法的智慧完成天然降维。
现代视频编解码标准(如 HEVC/H.265 以及前沿神经编解码器 DCVC)的核心思想,是通过帧间预测来去除时间维度的冗余。视频被划分为完整保存静态场景基底的关键帧(I 帧,Anchor Frame)以及记录相对位移与变化的预测帧(P 帧,Predicted Frame)。Mage-ViT 正是建立在这一编码流之上的时空分词器。
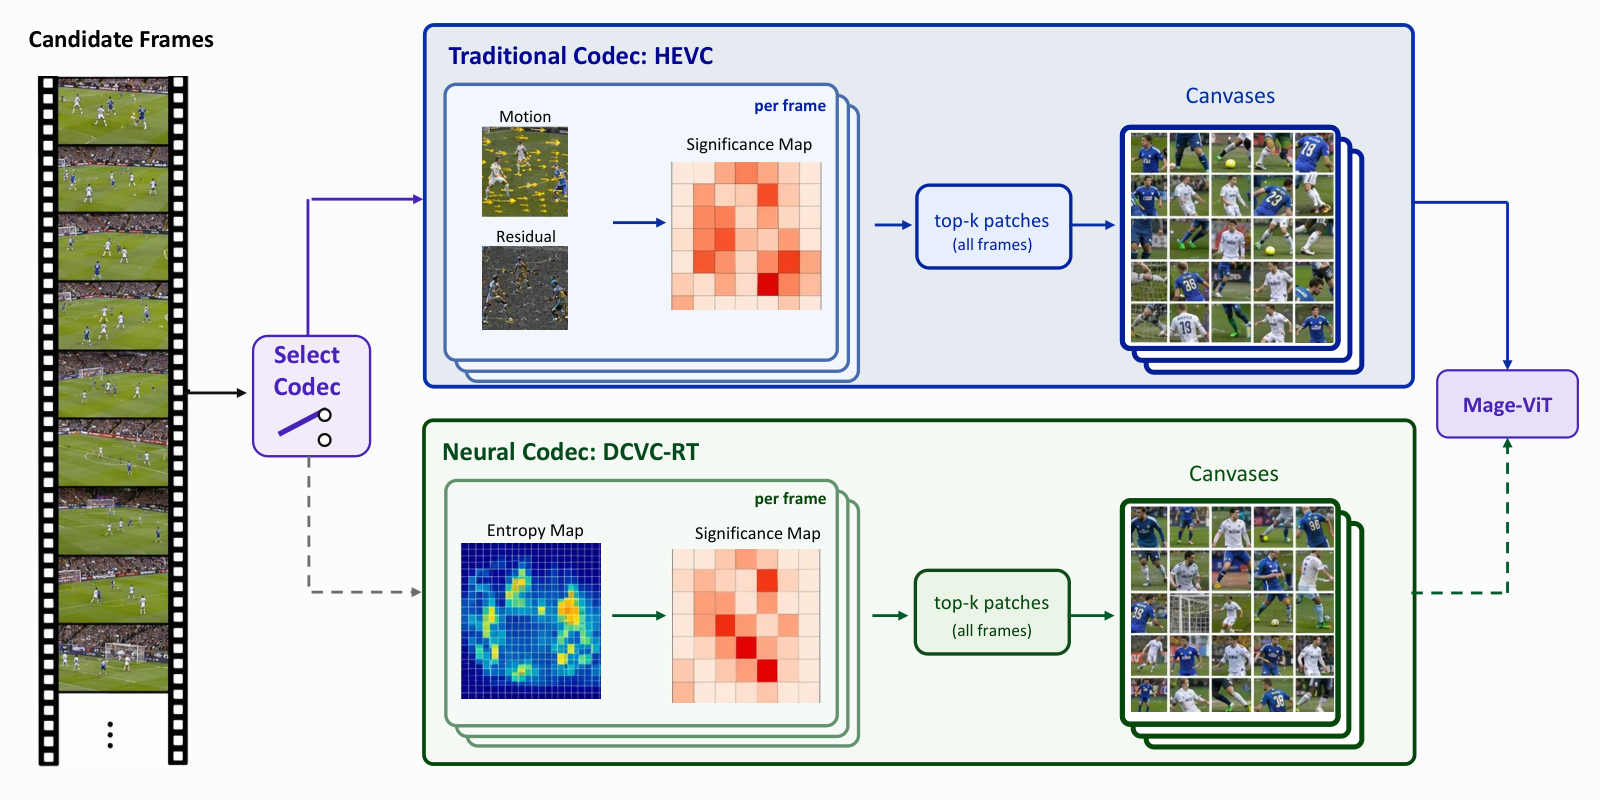
在输入阶段,输入视频流被划分为 $16\times 16$ 像素大小的网格。对于多帧序列,分词器首先为每个网格位置构建一个重要性张量 $S\in\mathbb{R}^{T\times H\times W}_{\geq 0}$,用于表征该时空区块在编解码过程中所消耗的信息比特量。在使用默认的传统编码器 H.265 时,$S$ 被定义为局部运动向量幅值与 P 帧残差能量的加权组合;而当切换到神经编解码器 DCVC-RT 时,$S$ 则直接对应网络学到的概率模型中各区块负对数似然。
这一重要性矩阵构成了衡量局部动态与信息熵的天然代理。对于关键帧 I 帧,模型完整保留其所有的 $16\times 16$ 补丁,建立全局场景参考;对于后续的预测帧 P 帧,模型则根据 $S$ 的得分进行稀疏采样,仅挑选变化最显著的 Top-$k$ 个动态补丁。在典型的 64 帧视频片段处理中,原始密集补丁总数会被精准压缩到 4096 个 Token 预算之内,瞬时减少了约 $75\%$ 的视觉分词量。
为了让下游 Transformer 能够正确感知这些被非均匀保留的碎片化动态,Mage-ViT 引入了覆盖整个未裁剪时空网格的共享 3D 旋转位置编码(3D RoPE)。即便大量的背景补丁在早期即被剔除,保留下来的补丁依然牢牢锚定在原本的时空坐标系中。在经过 24 层带有 Flash Attention 2 的 ViT 主干网络后,模型输出的视觉特征被紧凑地投影至大语言模型中。
更值得关注的是 Mage-ViT 的预训练数据效率。主流视觉编码器如 SigLIP2 动辄依赖百亿级别的超大规模静态图文对清洗过滤,而 Mage-ViT 则是完全从头(from scratch)训练:作者团队仅使用了约 5.6 亿张无标注静态图像和 1 亿帧无标注视频片段。训练目标摒弃了昂贵的多模态图文对齐,转而使用基于 MetaCLIP 特征提取后进行大规模 K-means 聚类的“视觉原型聚类判别”物方目标。实验证明,这种深植于时空连续性先验的设计,使得仅用较小数据规模训练出的 Mage-ViT,在多项视频与图像基准上全面媲美甚至超越了消费了数十倍数据的通用旗舰编码器。
双系统协同:从被动问答到主动流式交互
传统的视频问答大模型本质上依然是“请求-响应”式的被动系统:用户上传一段固定长度的切片,附带一个提示词,模型在离线状态下把整个上下文全部塞进显存,做一次沉重的全量自注意力,然后输出一段文本。但在自动驾驶、机器人操作、可穿戴设备等真实物理世界交互中,视频是永远在向前推移的连续因果流,大部分时间环境是平静的,模型必须知道“何时该保持沉默,何时该主动开口”。
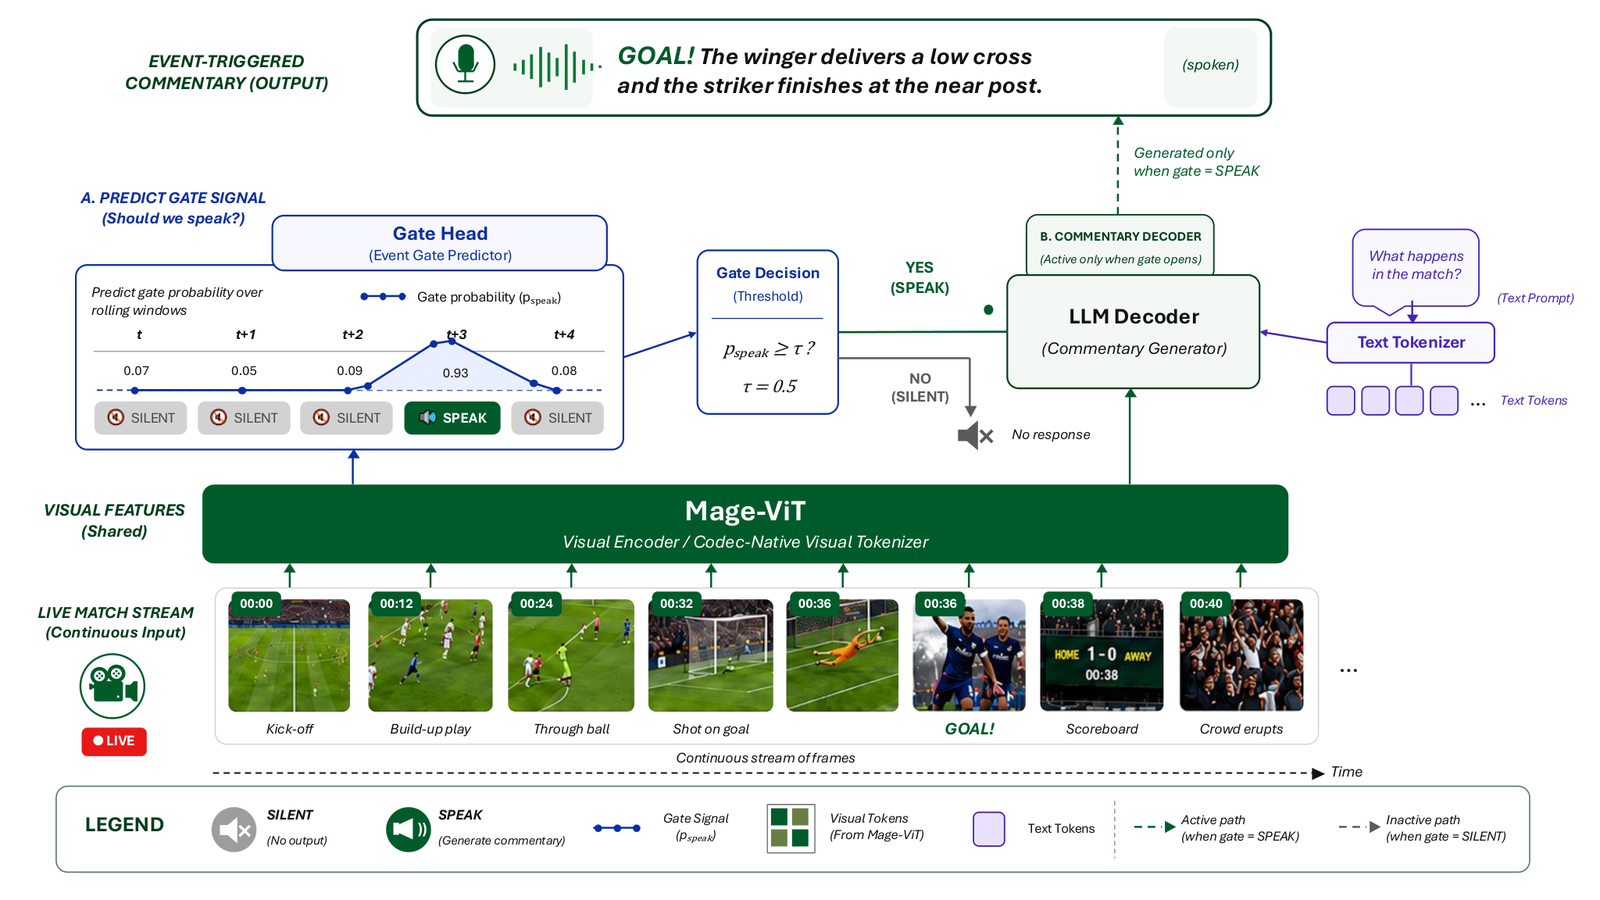
为了解决这一问题,Mage-VL 在架构上实现了生物启发的“双系统(Dual-System)”解耦:
-
系统 1(轻量事件门控): 部署在感知最前端,以极低延迟持续监控滑动窗口内流入的 Codec-Token 特征。该门控实时输出一个发言概率标量 $p_{\mathrm{speak}}=g(\mathbf{h}_t)$。当环境处于平缓背景或不值得反应的状态时,门控输出低于阈值 $\tau$,系统 1 默默维持低功耗记忆滚动,主解码器保持休眠,实现计算零浪费。
-
系统 2(因果语言解码器): 当视觉场景中发生关键动作突变、异常事件或达到用户指定的条件时,$p_{\mathrm{speak}}\ge\tau$,系统 1 瞬间触发警报,唤醒作为系统 2 的 Qwen3-4B-Instruct 因果语言解码器。解码器基于局部记忆窗口与当前输入提示,进行深度的因果推理并生成结构化回答。
在这一双系统机制下,Mage-VL 抹平了静态图像、长短视频与在线连续流输入的界限。对于普通静态图片,它退化为单块密集视觉 Prompt 的因果推理;对于长视频,它通过时间递进的 Codec 窗口维持全局因果演进;而在接入摄像头视频流时,它摇身一变成为具备主动感知能力、按需唤醒的智能代理。
阶梯式数据飞轮与 AI4AI 自动化流水线
架构上的精巧必须有极其考究的数据课程(Curriculum Learning)来驱动。为了让大语言模型真正掌握编解码稀疏表示并学会长时序事件关联,研发团队设计了五阶段渐进式训练方案:
在第一阶段,模型通过海量的高质量密集图像描述与短视频描述完成通用视觉语言热身,注入基础 OCR、物体识别与场景常识;第二阶段加入图像指令遵循、时空定位(Temporal Grounding)与空间监督数据,拉齐跨模态对齐能力;第三阶段引入多分钟的长视频详细描述,将视觉上下文窗口强行拉开,迫使模型建立事件先后顺序和因果链条的长期记忆;第四阶段则正式切换为编解码稀疏流监督,得益于补丁稀疏化机制将视觉 Token 压缩至传统方案的 $1/8$,模型得以在相同计算配额下吞吐时长扩充 8 倍的长视频;最后的第五阶段,将视频监督全面转为连续流式因果格式,联合训练系统 1 门控的主动触发判别与系统 2 的响应能力。
在这套庞大的数据工程中,另一大技术突破在于 AI4AI(人工智能驱动数据闭环)体系的落地。在早期预训练阶段,公开网络爬取的简短 Alt-text(替代文本)往往信噪比极低,充斥着无意义的水文。团队没有完全依赖人工标注或固定 Prompt 蒸馏,而是设计了一套自动化的闭环优化流水线。
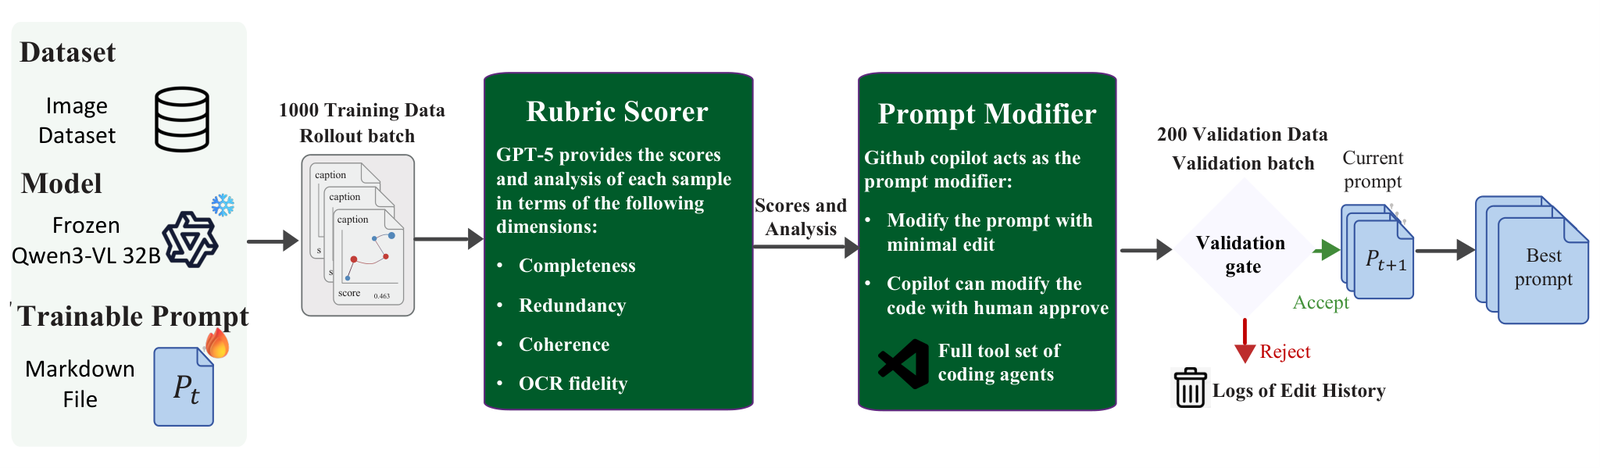
系统利用智能体工作流对描述生成的系统 Prompt 进行持续变异与评估。通过对下游 OCR、图表结构、空间几何关系以及密集细节多重维度的反馈打分,模型能够全自动迭代出具备极高信息熵捕获能力的重新标注系统。这一流程不仅保留了原生文本与多语言布局排版,还精确捕捉了前景背景物体的数量、微小距离变动与空间遮挡。实验表明,正是这种由算法自动化沉淀出的高密数据,为 Mage-VL 在极小参数体量下构筑了坚固的多模态表征底座。
关键实验评测:小体量撬动跨级战力
在由各类主流基准构成的全方位实验中,Mage-VL 展现出了超越模型参数体量的战斗力。与同为 4B 级别的领军开源模型 Qwen3-VL-4B 相比,Mage-VL-4B 在通用图像图表等静态理解维度上完全不落下风,在各项基准上互有胜负;然而一旦战线拉长到时空动态维度,局面便呈现出明显倾斜。
在代表性的长视频理解与动态追踪评测中,Mage-VL-4B 在多项视频基准(包括动作推理、事件时间线排序及细粒度问答)上取得了显著超越同级竞品的表现。更亮眼的是空间几何感知能力:得益于编解码流对物体相对运动轨迹的自然显化,Mage-VL-4B 在 2D/3D 空间关系推理基准上的得分不仅大幅超过 Qwen3-VL-4B,甚至连参数量高达 15B 的前沿推理模型 Phi-4-reasoning-vision 也被全面压制。
而在端到端真实吞吐测试中,Mage-VL 凭借在视觉前端砍掉的 $75\%$ 冗余 Token,实现了令人印象深刻的系统加速。在处理高帧率或长时序视频流输入时,系统端到端墙上时钟推理速度提升达到了 2.5 至 3.5 倍。这意味着原本只能勉强运行在数据中心机房的大模型流式推理,如今有希望部署在算力更受限的边缘终端上,维持极高帧率的低延迟持续监测。
颠覆直觉的七大经验性发现
除了提供开源模型构件外,作者团队还在论文中提炼了七项对多模态领域具有重要参考价值的实证结论,其中多处颠覆了当前社区的常规做法:
第一,视觉编码器并不迷信海量网络图文对。仅通过 5.6 亿张无标签图像加 1 亿帧视频,配合原型聚类对比学习,即可训练出足以支撑顶尖多模态大模型的视觉底座。数据的时空连续性结构远比盲目堆砌数十亿图文碎片重要。
第二,可变分辨率预训练具有单调可扩展性。允许视觉编码器自适应处理不同长宽比与动态分辨率,能在不产生性能坍塌的前提下,实现性能随着 Token 预算的平滑提升。
第三,编解码稀疏分词建立了更优的时空精度-算力前沿。将计算资源集中在残差能量与运动矢量高的地方,比机械地拉高全画幅采样帧率更加贴合自然视觉信息论,这使得以 3.5 倍加速换取更高下游精度的设想成为现实。
第四,长视频问答微调存在巨大冗余(VideoQA SFT Redundancy)。研究发现,以往耗费大量人力构造的长视频问答对其实并非必需品;只要模型在前期通过密集、带有显式时序演进的视频详细描述完成训练,配合少量短视频指令微调,就能自然泛化出极强的零样本(Zero-shot)长视频问答与事件长程推理能力。
第五,动态运动先验与静态空间推理存在天然协同效应。在视频流上学习运动矢量的变化,会反向强化模型对静态单帧中物体深度、相对遮挡和三维朝向的理解,这印证了认知神经科学中“通过运动解构空间”的理论。
第六,闭环 AI4AI 数据管线带来持续边际增益。自动化 Prompt 与标注代码协同演进,能够有效解决多模态大模型在细小文本、复杂结构图表等边缘用例上的表现瓶颈。
第七,跳过视觉 SFT 的多模态强化学习可行性(Zero-Vision SFT)。研究揭示,在进入强化学习阶段时,模型甚至可以直接绕过昂贵的图文混合 SFT,直接利用纯文本推理 SFT 后的底座接入多模态输入进行强化探索,这一机制极大地缩减了训练智能体级多模态模型的算力门槛。
迈向真正物理感知的下一代多模态
主流多模态模型在过去几年走了一条“以静态图文为中心、把时间当作切片集合”的捷径。这种捷径虽然让模型快速继承了大语言模型的泛化红利,却在物理世界的动态输入面前撞上了效率的高墙。
Mage-VL 的探索表明,大模型并不一定要以牺牲物理世界的时间流动性为代价来换取逻辑推理。将现代视频编码器几十年沉淀下来的时空压缩逻辑与 Transformer 架构深度缝合,辅以类似人脑“快慢双系统”的分流决策,大模型不仅能够瘦身卸负,反而能在动态感知与空间理解上变得更加敏锐。对于未来致力于构建智能座舱、具身机器人与空间计算 Agent 的研究者而言,这种从原生编解码与底层信息论出发的流式架构设计,指明了一条兼顾端侧轻量化与高阶智能的坚实落地路径。