OrchBench:多智能体并非越多越好!用1.3%代币精准评估编排成败
OrchBench: Evaluating Multi-Agent Orchestration Plans in Isolation via Deterministic Simulation
在复杂大模型应用的落地中,多智能体系统(Multi-Agent Systems, MAS)已经被广泛视为突破单模型推理瓶颈的关键形态。无论是协同编写复杂软件、拆解金融财报,还是多步骤科学文献分析,行业目前的通用做法都是让一个或多个主控 Agent 将任务拆解为子任务,分发给多个专业 Worker 并行执行。然而,一个长期被忽视但致命的工程问题是:当我们评估一个多智能体系统时,系统的最终表现究竟取决于任务编排调度(Orchestration)的优劣,还是 Worker 自身的推理水平、外部工具的稳定度以及环境本身的随机噪声?
ArXiv URL:https://arxiv.org/abs/2607.25656v1
在传统的端到端基准测试中,这些因素始终深度混杂在一起。为了跑完一个测试流程,开发者往往需要调用成百上千次 API,付出高昂的 Token 费用与漫长的时间等待;而一旦系统报错或结果劣化,工程团队很难定位这究竟是因为子任务调度混乱、信息在 Agent 间传递时被截断丢失,还是仅仅因为某个 Worker 模型在调用工具时偶发了格式错误。这种高成本且黑盒化的评测方式,极大阻碍了多智能体编排算法的系统性迭代。
来自复旦大学、伦敦玛丽女王大学与中关村学院的联合研究团队提出了 OrchBench,这是首个通过确定性仿真(Deterministic Simulation)将多智能体编排决策与实际执行完全解耦的评测基准。OrchBench 的核心思路非常明确:既然编排的本质是“任务依赖分配”与“跨上下文的信息流转管理”,那么完全可以让大模型仅输出一份全局编排计划,随后交由一个遵循真实调度规律的确定性仿真器进行推演,而无需真正拉起 Worker 跑完所有代码或工具交互。
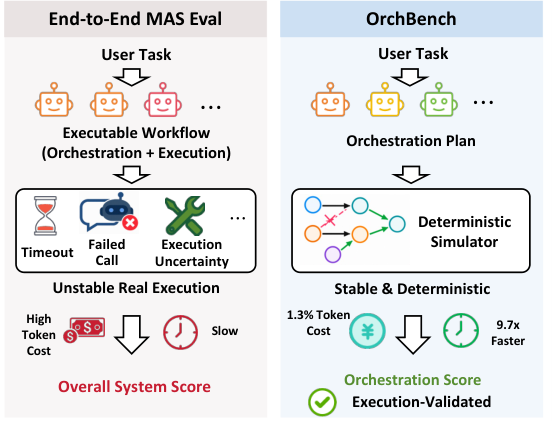
实验结果表明,OrchBench 的仿真得分与在 Claude Code 真实执行环境下的任务质量达到了高达 $r = 0.816$ 的 Pearson 强相关性,而消耗的 Token 仅为真实执行的 $1.3\%$,耗费的物理时间缩减至真实执行的 $10.3\%$。更具颠覆性的发现是,该基准在多达 1000 个任务节点的超大尺度工作流上揭示了一个被传统测试掩盖的架构真相:在多智能体系统中,盲目堆叠 Agent 数量不仅无法带来持续增益,反而会因协调失败而引发性能雪崩;真正决定系统质量上限的核心瓶颈,在于跨 Agent 传递时关键任务信息的无损保留与覆盖率。
拆解黑盒:为什么编排必须与执行彻底解耦?
现有的 Agent 评测基准,无论是关注工具调用的 ToolLLM、面向代码环境的 SWE-bench,还是专门考察多智能体协作的 MultiAgentBench,本质上都是端到端的执行评估。这类方案在评估整体交付能力时固然有效,但在用于指导多智能体系统的顶层设计时,暴露出了严重的归因困境。如果一个多智能体框架在基准测试中得分落后,开发者根本无从得知究竟是任务切分不合理、依赖顺序倒置、上下文压缩损失过大,还是仅仅因为环境网络超时。
此外,真实环境执行的成本随工作流规模呈超线性增长。当一个复杂业务工作流包含几十个甚至上百个具有复杂依赖关系的分支任务时,每次评估都需要耗费数小时甚至数天,消耗数以千万计的 Token。面对如此巨大的计算开销,研究人员几乎不可能对编排超参数进行细致的消融实验或控制变量分析。
以往针对规划(Planning)的评测基准虽然也尝试过轻量化,但主要停留在形式化动作验证(如 PlanBench)或工作流语法树比对(如 WorFBench)上。这些方案仅仅检查了生成图结构的拓扑正确性,完全没有刻画当任务真正被分配给拥有独立上下文窗口的各个 Agent 之后,信息如何传递、窗口溢出时如何压缩、依赖结果何时就绪等动态生命周期。OrchBench 正是填补了这一空白:它保留了任务图的完整执行语义与资源约束,但通过数学建模规避掉了昂贵且嘈杂的 Worker 生成过程。
OrchBench 的工作机制:从真实任务图到六阶段仿真
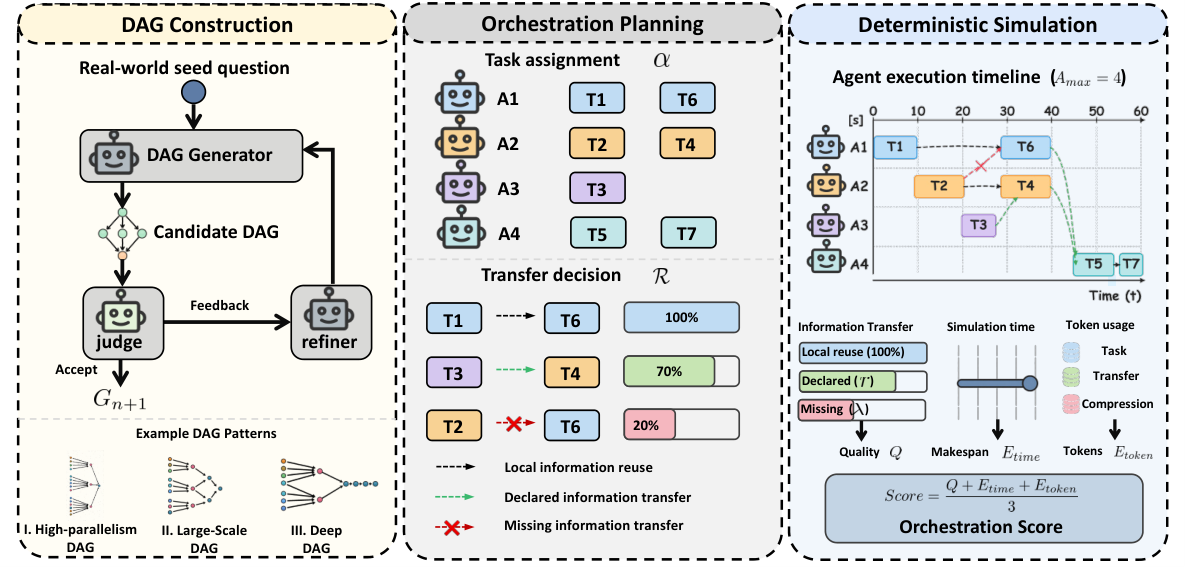
为了在不调用 Worker 的前提下准确刻画多智能体运行状态,OrchBench 构建了一套包含任务有向无环图(DAG)构建、编排计划生成与确定性仿真评估的完整闭环。
真实依赖任务图构建与自然并行度
OrchBench 的任务不是由合成逻辑凭空生成的,而是从包含金融、数据分析、学术文献理解与复杂 SQL 的四个真实数据集(Finance Agent、DS-1000、Qasper、BIRD-SQL)中提取种子任务。研究团队通过双评委过滤与精细调整机制,将种子任务转化为规模严格可控的依赖图。更重要的是,团队提出了“自然并行度”的量化指标 $k_{99}/n$。其中 $k_{99}(G)$ 表示一个任务图 $G$ 在最理想并行情况下,要达到理论最大加速比的 $99\%$ 所需的最少 Worker 数量:
\[k_{99}(G)=\min\{k:\mathrm{ms}_{k}(G)\leq C(G)+0.01(W(G)-C(G))\}\]这里 $W(G)$ 代表全串行运行的总时间,$C(G)$ 代表关键路径(Critical Path)时间,$\mathrm{ms}{k}(G)$ 代表配置 $k$ 个 Worker 时的整体耗时(Makespan)。$k{99}/n$ 的比值越高,意味着任务本身的拓扑结构允许更激进的多 Agent 并行分配。
编排计划的形式化定义
给定一个包含依赖结构的任务图 $G=(V, E)$、每个 Agent 的上下文大小硬上限 $L$ 以及最大 Agent 配额 $A_{\max}$,待评测的 Planner 模型需要输出一份结构化的编排脚本,并解析为数学上的编排计划 $\pi = (\alpha, \mathcal{R})$。
具体而言,$\alpha(v)$ 是任务分配映射函数,决定将子任务 $v$ 分配给哪个具体的 Agent 编号。若两个依赖任务 $u$ 与 $v$ 被分配给同一个 Agent,其输出自动在本地上下文内无损复用;若被分配给不同 Agent,模型必须显式声明跨 Agent 的信息传输映射 $\mathcal{R}(u, v) = e$,其中 $e \in (0, 1]$ 为信息保留率。
这个设计精确击中了真实系统的核心工程权衡:如果为了降低通信量或防止 Agent 上下文窗口打满,Planner 设置了较小的 $e$,下游任务就会面临输入退化的风险;但如果全部设定为 $1.0$ 的无损传递,在上下文上限 $L$ 的压迫下,Agent 内部的内存管理机制就会强制触发激进压缩,同样会导致信息损失。
确定性仿真器的六阶段生命周期
接收到编排计划后,确定性仿真器按照真实多智能体系统的底层调度逻辑,在拓扑序遍历下推进以下六个阶段:
-
依赖解析(Dependency Resolution):严格保证只有当子任务 $v$ 的所有前置父任务 $\text{Parents}(v)$ 全部执行完毕后,$v$ 才能进入可就绪状态。不同分支上无依赖的任务则不受此约束,允许并发。
-
调度时间推进(Agent Scheduling):仿真器为每个 Agent 维护独立的逻辑时钟 $c_a$。子任务 $v$ 在其所属 Agent 上的开始时间 $s_v$ 受到 Agent 空闲状态与最慢父任务完成时间的双重制约:
\[s_{v}=\max\left(c_{\alpha(v)},\,\max_{u\in\operatorname{Parents}(v)}f_{u}\right)\] -
上下文获取与断流惩罚(Context Acquisition):仿真器检查父节点结果如何到达目标 Agent。如果模型在计划中遗漏了必要的跨 Agent 传输,仿真器会记录一次“遗漏传输”(Missing Transfer)事件,并施加惩罚因子 $\lambda \in [0, 1]$,将父任务的有效质量大幅扣减至 $\lambda q$。
-
上下文与内存管理(Context Management):当输入 context 与父节点历史累加超出单个 Agent 上下文容量 $L$ 时,仿真器调用局部记忆压缩机制。压缩时根据子任务本身的抗损失敏感度 $s_v$,动态计算保留的上下文 Token 数与有效质量 $q’v = \max(q{\min}, q_v e_{s_v})$。
-
子任务确定性执行(Subtask Execution):对于非根节点,仿真器提取到达该任务的所有父节点输入的几何平均质量 $\bar{q}$,并根据本任务的压缩情况计算当前任务产出质量 $q_v = \operatorname{clip}{[q{\min}, 1]}(\bar{q} e_{s_v})$。
-
状态与时钟更新(State Updates):计算该任务执行时长 $\tau_v$ 及上下文压缩带来的延迟 $\Delta_v^{\text{post}}$,推进该 Agent 的逻辑时钟 $f_v = s_v + \tau_v + \Delta_v^{\text{post}}$,并及时在内存中释放不再被后续任务需要的废弃依赖包。
经过这套没有模型推理噪声、完全确定且可微分追踪的仿真计算,系统能够输出最终的综合评分,涵盖终端任务质量得分 $Q$、时间调度效率 $E_{\text{time}}$ 以及 Token 消耗效率 $E_{\text{token}}$。
实验发现:多智能体协作的核心短板到底在哪里?
基于包含 10 到 100 个任务节点的标准测试集,以及拓展至 200、500、1000 个节点的超大规模测试集,研究团队对涵盖 GPT-5.5、Gemini-3.1-Pro-Preview、Claude-Opus-4.8、DeepSeek-V4 系列及 GLM-5.1 等国内外主流闭源与开源前沿模型进行了详尽的评测分析。
仿真度跨框架验证:相关系数突破 0.8
为了确认无 Worker 运行的仿真器指标是否具有现实指导意义,研究人员在 MultiAgentBench 基准上将仿真输出与 Claude Code 真实执行进行了逐项行为对齐。无论是在声明的 Subagent 数量、实际启动的 Worker 数量,还是在并行度利用率(PU)和依赖深度(WD)等结构特征上,仿真器均展现出极其紧密的匹配度。
在最终任务质量这一核心指标上,OrchBench 的仿真得分与真实运行质量的 Pearson 相关系数达到了惊人的 $r = 0.816$。不仅如此,当研究人员将 OrchBench 应用于 SWE-mini、OpenHands 与 Crush 等完全不同的开源多智能体执行框架时,仿真得分与真实表现依然保持了稳健的正相关性。这充分证明,拓扑依赖与上下文容量这一底层物理规律是普适的,并不依赖于特定 Agent 框架的代码封装。
核心发现一:信息传递覆盖率远比智能体数量重要
长期以来,多智能体系统的设计倾向于认为“调动的 Agent 越多,专业分工越细,系统能力越强”。然而,OrchBench 的相关性矩阵分析彻底颠覆了这一直觉。
数据统计显示,随着任务规模上升到 $n=100$,Agent 的数量(Agent Count)与最终产出质量的相关系数仅为 $-0.021$,在统计学上几乎完全无关,对综合评分的贡献微乎其微。相反,跨 Agent 信息传输的覆盖率(Transfer Coverage)与输出质量的相关系数在各规模下持续保持在 $0.614$ 至 $0.952$ 的极高区间。
这意味着在实际系统中,决定一个复杂任务能否完成的,根本不是分配了 5 个还是 20 个 Agent 在同时跑,而是当下游 Worker 需要关键数据时,上游 Worker 的执行成果是否被准确、完整地路由了过去。当前多数大语言模型在作为 Planner 时,极其容易发生“只管分派任务,不管结果回传”的悬空错误。一旦关键依赖信息未被声明路由,下游 Worker 就会在严重的信息贫血或幻觉状态下硬扛,导致全局错误不可逆地逐级放大。
核心发现二:超大规模任务下的协调能力两极分化
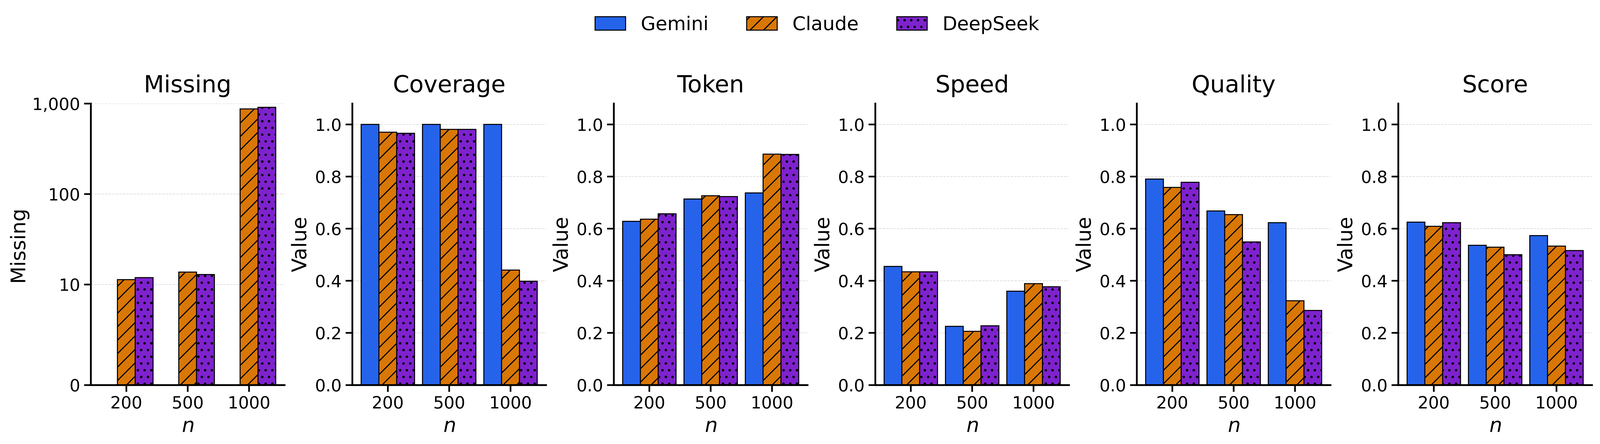
当评测任务进一步扩展到 200、500 和 1000 个节点的极限规模时,大模型在规划层面的协调脆弱性暴露无遗。
在面对 1000 个子任务的超级工作流时,Claude-Opus-4.8 与 DeepSeek-V4-Flash 均出现了严重的编排退化:其信息传递覆盖率从 500 节点时的 $0.981$ 断崖式跌落至 $0.441$ 和 $0.398$,单次规划中遗漏的依赖传递分别高达 $872.3$ 次与 $907.4$ 次。模型似乎完全丧失了维护大规模拓扑全局一致性的注意力,导致生成的整个协作网络千疮百孔。
在这类极限拓扑压力下,Gemini-3.1-Pro-Preview 表现出了极强的鲁棒性,依然维持了接近满分的传递覆盖率与极高的产出质量。这一实验清晰地表明:构建支持超长复杂业务流的 Agent 系统,评估模型在超长序列下的依赖对齐精度,比单纯考核单步代码生成能力要严苛得多。
核心发现三:多智能体并不总是优于单智能体
另一个极具工程指导价值的结论围绕“单 Agent 与多 Agent 的性能分界线”展开。研究团队在不同上下文长度约束 $L \in {16\text{k}, 32\text{k}, 64\text{k}, 128\text{k}}$ 下对比了单 Agent 串行处理与多 Agent 协作方案:
-
当单 Agent 上下文上限极其严苛($L=16\text{k}$)时,多 Agent 方案展现出压倒性优势,其综合输出质量相比单 Agent 提升了 $+0.302$。这是因为单 Agent 必须频繁进行剧烈的自我记忆压缩,关键先验在反复压缩中被抹去;而多 Agent 分散在不同窗口中,有效保全了各分支信息。
-
然而,当单 Agent 上下文扩展到 $128\text{k}$ 时,多 Agent 带来的质量优势急剧收缩至 $+0.007$。甚至在 10、20 和 50 个节点的中小规模任务中,单 Agent 的最终质量直接反超了多 Agent 体系。
这个现象揭示了多智能体协作的固有成本代价:多 Agent 带来的并行加速与上下文隔离并非免费午餐,它引入了繁重的跨进程同步、潜在的通信丢失以及任务等待摩擦。一旦单个模型的上下文空间足以完整吃下当前任务的全部工作状态,多 Agent 协调带来的边际收益便会迅速被通信损耗与协调失败所吞噬。
工业启示:以极低成本闭环优化多智能体工作流
除了作为中立的评测跑道,OrchBench 的确定性仿真机制在实际工业落地中展现出了双重杠杆价值:模型选型的高效筛选与工作流的诊断式自愈。
在评测预算有限的场景下,OrchBench 支持“仿真筛选 + 靶向实测”的组合策略。通过计算各模型在仿真环境下的得分方差(即模型间争议最大的任务),团队只需挑选出分歧最大的前 5 个任务放到真实 Claude Code 环境中进行真实调用,就能以 $0.800$ 的成对准确率和 $0.754$ 的 Spearman 秩相关系数精准复刻全量昂贵评测的排序结果。对于需要频繁迭代 Prompt 或微调主控编排器的研发团队,这种先用仿真漏斗排查、再用真实运行验收的链路,能够将开发成本与耗时压低近两个数量级。
更进一步,仿真器由于精确记录了所有的拓扑执行日志,能够直接给出极具解释性的“诊断处方”。在 MultiAgentBench 的 20 项实操任务改进实验中,系统首先利用仿真器扫描 baseline 工作流中导致性能滑坡的遗漏依赖点,随后仅自动化地为原工作流注入一条被仿真器识别为最关键的跨角色数据传递指令(Handoff),而保持其他所有执行逻辑不变。在真实调用 DeepSeek-V4 运行后,系统的实际任务平均得分直接从 $3.754$ 分提升至 $4.150$ 分(满分 5 分)。
从“盲目堆叠智能体数量”转向“严密保障上下文信息流拓扑的完整性”,OrchBench 不仅给大模型社群提供了一个快、省、准的新型基准,更在工程范式上为下一代复杂多智能体系统的架构设计指明了明确的演进方向。